Mira Murati 領軍的 Thinking Machines Lab 在 2026 年 11 月 20 日開源 Inkling 2 Mini。這是一款總參數 26.4B、每個 token 只用約 3B 唯一權重的迴圈式 MoE 模型。它在 Artificial Analysis 智慧指數拿到 20.1,和 Qwen3.8-27B 打平。跑完一題指數任務的成本是對方的六分之一,時間是四分之一。
授權是 Apache 2.0,支援文字與影像輸入,上下文 1M token。發布當天 vLLM、SGLang、Ollama、Unsloth 都已支援,Mac 也能透過 MLX 執行。CyberQ 本次測試在一台 RTX 5060 Ti 16GB、128GB 記憶體的 Windows 桌機上,用 20 筆公司內部威脅日誌比較兩者的 Q4 版本,結果放在後段的實測。
架構:同一組層重複跑三次
Mini 存了 24 層,但中間 12 層每個 token 會跑三次。不增加權重就能多算一倍以上,等於把部分「思考」搬進模型內部。
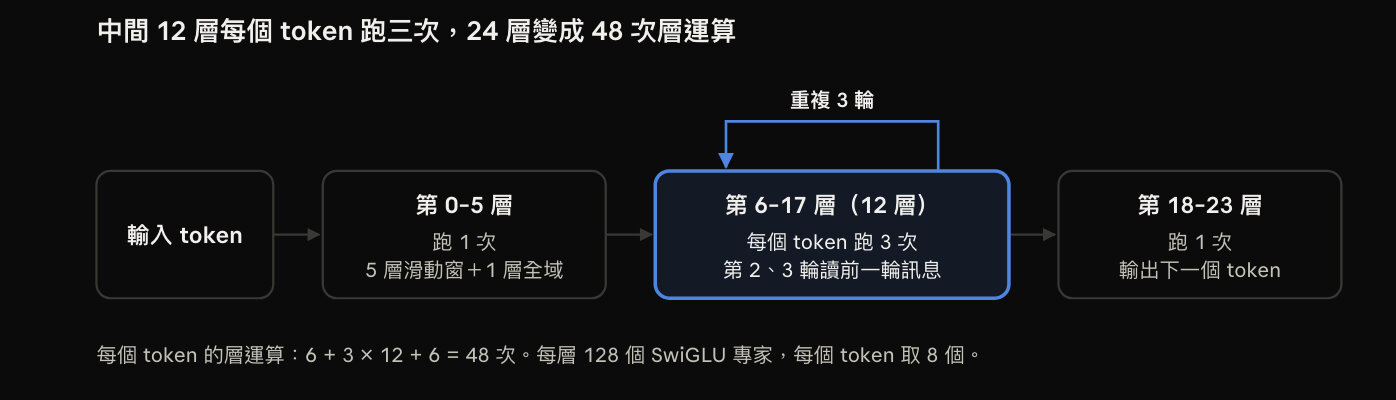
各家對參數量的寫法不同,實際是同一組數字,總參數 26.4B,每個 token 用到的唯一權重約 3.1 至 3.4B,把迴圈三輪都算進去的啟用量是 5.4B。後者是「5B 對上 27B」這個說法的來源。迴圈層每輪各自存 KV cache,記憶體用量會比一般 26B MoE 稍高。
官方另釋出研究版 TML-d24-varloop-research,可把迴圈次數設成 1、2 或 3。從 1 輪到 3 輪,不靠思考鏈能完成的任務時間尺度從 16 秒拉長到 37 秒。
與 Qwen3.8-27B 正面對決:寫程式與搜尋領先,知識與多約束落後
Mini 在程式代理、網路搜尋與長文件上領先,Qwen3.8-27B 在工作自動化、知識準確度與多模態理解上較強。下表數字來自 Thinking Machines 發布資料(經 Unsloth 轉錄),屬廠商自測。
| 基準 | Inkling 2 Mini | Qwen3.8-27B | 領先者 |
|---|---|---|---|
| 啟用 / 總參數(B) | 5 / 26 | 27 / 27 | 不適用 |
| AA Intelligence Index v5.0 | 20.1 | 20.1 | 平手 |
| SWE-bench Verified | 79.2% | 77.8% | Mini |
| DeepSWE v1.1 | 48.2% | 42.2% | Mini |
| SWE-bench Pro(Hard,51 題) | 77.9% | 73.8% | Mini |
| Terminal Bench v2.1 | 71.6% | 73.0% | Qwen |
| BrowseComp(含壓縮) | 79.0% | 61.6% | Mini |
| DeepSearchQA | 85.3% | 79.7% | Mini |
| LongBench v2 | 66.9% | 52.3% | Mini |
| ARC-AGI-2 | 49.3% | 42.4% | Mini |
| AutomationBench-AA | 41.8% | 48.2% | Qwen |
| GDPVal-AA v2.1(Elo) | 1319 | 1427 | Qwen |
| MMMU Pro | 74.9% | 76.3% | Qwen |
| AA-Omniscience 非幻覺率 | 63.4% | 71.4% | Qwen |
官方也承認 Mini 在多輪對話與多條件指令上不如 Qwen3.8-27B。各模型的評測設定不同,例如 BrowseComp 使用上下文壓縮,DeepSWE 使用 mini-swe-agent v2.4.6,細微差距不宜過度解讀。
成本與效率:便宜 6 倍、快 4 倍,但話比較多
同樣拿到 20 分,Mini 每題花 0.59 美元、9.0 分鐘,Qwen3.8-27B 要 3.53 美元、38.2 分鐘(Artificial Analysis)。價格以 Thinking Machines 自家 API 計算:每百萬 token 輸入 0.15 美元、輸出 0.50 美元。
| 每題指數任務 | Inkling 2 Mini | Qwen3.8-27B |
|---|---|---|
| 成本(美元) | 0.59 | 3.53 |
| 耗時(分鐘) | 9.0 | 38.2 |
| 輸出 token(約) | 152,000 | 110,000 |
Mini 的輸出 token 反而多了約 38%。但它每個 token 的啟用參數只有對手的五分之一,整體運算量約少 2.8 倍。對本機使用者來說,這代表解碼快,但要等它把較長的思考寫完。
筆電能不能跑:32GB 沒問題,24GB 只能跑 3-bit
官方原生權重以 NVFP4 為主、最後四層 MXFP8,全量約 20GB。Thinking Machines 建議 Mac 至少 32GB 統一記憶體(Kingy AI 引述發布文)。Unsloth 提供從 1-bit 到 8-bit 的 GGUF,官方推薦 UD-Q4_K_XL。
| 量化(Unsloth GGUF) | 檔案大小 | 與 8-bit 首選 token 一致率 |
|---|---|---|
| UD-Q8_K_XL | 22.87 GB | 基準 |
| UD-Q4_K_XL(推薦) | 17.63 GB | 98.0% |
| UD-Q3_K_XL | 13.63 GB | 96.3% |
| UD-IQ3_XXS | 11.66 GB | 94.7% |
| UD-Q2_K_XL | 9.14 GB | 91.6% |
社群在 Hacker News 回報的解碼速度如下:
- M1 Pro 32GB,Q4:約 10 tok/s(同時開著瀏覽器)
- M1 Max 64GB,4-bit:約 20 tok/s;UD-Q8_K_XL 約 18 tok/s
- Ryzen 395(llama.cpp Vulkan):27 tok/s
- RX 7900 XTX:約 28 tok/s,prefill 約 481 tok/s
- RTX 5090:52 tok/s,prefill 700 tok/s
實測:RTX 5060 Ti 16GB 桌機跑 UD-Q4_K_XL
測試機是 Windows 11 桌機,配備 NVIDIA GeForce RTX 5060 Ti 16GB、Intel Core i5-12400F 與 128GB 系統記憶體。推論引擎用 Unsloth 的 llama.cpp 分支 b12588(上游還不支援迴圈層),兩個模型都用 Unsloth 的 UD-Q4_K_XL(Inkling 17.63 GB、Qwen3.8-27B 17.66 GB),上下文設 16K,temperature 0。
兩個檔案都比 16GB 顯示記憶體大,必須把一部分權重放到系統記憶體。Inkling 是 MoE,用 --n-cpu-moe 6 只把前 6 層的專家權重放到 CPU。這 6 層每個 token 只跑一次,第 6 到 17 層的迴圈核心留在 GPU,所以速度損失小。Qwen3.8-27B 是稠密模型,沒有專家可以挑,只能整層切:65 層中 48 層放 GPU,其餘 17 層由 CPU 計算。
速度:Inkling 解碼快 6 倍
| 項目 | Inkling 2 Mini | Qwen3.8-27B |
|---|---|---|
| 權重放置 | 全部層上 GPU,前 6 層專家放 CPU | 65 層中 48 層上 GPU |
| 顯示記憶體峰值 | 15.4 GB | 14.1 GB |
| 512 token 解碼速度 | 38.2 tok/s | 6.1 tok/s |
| 評測期間 GPU 平均使用率 | 56% | 22% |
| 評測期間 GPU 平均功耗 | 62 W | 40 W |
解碼速度差了 6.3 倍。Qwen 每個 token 都要算完 27B 權重,其中約四分之一在 CPU 上,GPU 大半時間在等;Inkling 每個 token 只動到約 3B 唯一權重,放到 CPU 的又剛好是負擔最輕的層。對照社群回報 RTX 5090 的 52 tok/s,16GB 的中階卡能拿到七成多。
任務:20 筆內部威脅日誌判讀
題目是 20 筆合成的企業日誌片段(Zeek、AD、FortiGate、DLP 等格式,附人員職務備註)。其中 12 筆是威脅,資料外傳、越權目錄、橫向移動、憑證異常、規避控管、離職徵兆六類各 2 筆;另 8 筆是有授權或符合既有模式的正常活動。模型要輸出 JSON,判斷是否為威脅並歸類。思考關閉時上限 400 token 並啟用 JSON 格式限制,思考開啟時上限 4,000 token。
| 設定 | 判定正確 | 類別正確 | 誤報/漏報 | 平均每題秒數 | 平均輸出 token | 未寫出答案 |
|---|---|---|---|---|---|---|
| Inkling,思考關(none) | 13/20 | 11/20 | 0/0 | 9.5 | 332 | 7 題 |
| Inkling,思考開(high) | 19/20 | 16/20 | 0/0 | 31.1 | 1,135 | 1 題 |
| Qwen,思考關 | 20/20 | 17/20 | 0/0 | 5.3 | 24 | 0 題 |
| Qwen,思考開 | 20/20 | 17/20 | 0/0 | 100.9 | 597 | 0 題 |
Inkling 真的關不掉思考
設成 reasoning_effort=none 後,每題仍先寫約 1,000 字的思考,20 題中有 7 題在 400 token 內還沒想完就被截斷,沒有輸出答案,判定正確率因此掉到 13/20。有寫出答案的 13 題判定全對,失分來自答案沒寫出來,不是判斷錯誤。Qwen 關掉思考後每題只輸出約 24 token 的 JSON,5 秒就回來,20 題判定全對。
開啟思考後 Inkling 判定 19/20,唯一失分是一題 QA 人員自行提權存取財務稽核資料的樣本,想了 9,000 多字仍沒有結論,寫滿 4,000 token。Inkling 開思考平均輸出 1,135 token,約是 Qwen 的 1.9 倍,呼應前面 Artificial Analysis 說它話比較多。但因為解碼快 6 倍,Inkling 每題實際只要等 31 秒,Qwen 開思考則要 101 秒,分數和關思考時一樣。
兩個模型錯在同一類地方
把越權複製薪資到 USB、壓縮偽裝後上傳、離職前複製資料到個人雲端,歸成資料外傳(S1)。這幾題同時符合兩個類別,標準答案取的是主要意圖(越權、規避、離職),模型則傾向看到資料出去就選 S1。兩者都沒有誤報或漏報,8 筆正常活動全部判為正常。
這個測試只有 20 題,temperature 0 各跑一次,屬於小樣本的情境測試,不能代表官方基準。兩個模型的 tokenizer 不同,token 數只適合看量級。Qwen 的速度也受限於這台機器要把 17 層放在 CPU,24GB 以上的顯示卡可以全部上 GPU,差距會大幅縮小。
安裝上有一個坑:Unsloth 分支的 Windows cuda12-portable 套件沒有附 CUDA 執行期(cudart64_12、cublas64_12、cublasLt64_12)。在沒裝 CUDA Toolkit 的機器上,llama-server 會靜默改用 CPU,健康檢查照樣回 ok,只能從顯示記憶體沒增加看出異狀。執行 llama-server --list-devices 若顯示 (none),就要另外放入 CUDA 12 執行期 DLL(例如 NVIDIA 在 PyPI 發布的 nvidia-cuda-runtime-cu12 與 nvidia-cublas-cu12),之後才會出現 CUDA0。
先潑冷水:社群與官方自己提到的弱點
最常見的抱怨是想太久。預設推理強度是 high,有使用者回報寫 WordPress 外掛燒了 19,200 個思考 token 仍未完成。迴圈只增加運算、不增加儲存知識,所以小模型的事實幻覺問題仍在。
- 關不掉思考:只能用 reasoning_effort 調整(none 到 max),模型卡說最低檔也不會完全關閉。本文實測設成 none 時,每題仍會先寫約 1,000 字思考。
- 工具呼叫不穩:有人遇到宣告要呼叫工具後卻沒有發出。
- 代理風險:模型卡警告它可能誤報結果,或未經確認就刪除與覆寫檔案,建議在沙箱內執行。
- 基準來源:多數數字是廠商自測。第三方 Vals Index v2.2 給 46.46%,在 43 個模型中排第 38。
- 生態未成熟:發布當下上游 llama.cpp 尚未合併迴圈支援,MLX-Serve 也還跑不起來。Unsloth 分支的 Windows portable 套件也沒有附 CUDA 執行期。
對地端部署的意義
CyberQ 實測 Inkling 2 Mini ,證明 5B 級啟用參數就能打平 27B 稠密模型,關鍵是重複使用中段層。對要在地端放模型的企業,它寫程式與檢索長文件的能力很有吸引力,且 Apache 2.0 沒有商用限制。但多條件指令與知識準確度較弱,重視這兩項的任務仍以 Qwen3.8-27B 較穩。
CyberQ 建議,在硬體門檻上,32GB 的 Mac 或 DGX Spark 可跑官方版,24GB 筆電只能跑 3-bit,結果不能代表官方分數。
本次實測顯示,16GB 中階顯示卡加上大容量系統記憶體就能用 Q4 跑出近 40 tok/s,是同一台機器跑 Qwen3.8-27B 的 6 倍。代價是思考關不掉、輸出長,要求簡短 JSON 的批次判讀任務必須預留足夠的 token 上限。如果任務本身不需要推理,關掉思考的 Qwen3.8-27B 在這次測試裡反而最快也最準。
參考資料
Welcome Inkling 2 Mini — Hugging Face Blog
Inkling 2 Mini – Run Locally Guide — Unsloth
Thinking Machines has released Inkling 2 Mini — Artificial Analysis
Thinking Machines releases Inkling 2 Mini — TestingCatalog
Inkling 2 Mini puts a 26.4B coding model on a 32GB Mac — Kingy AI