Google 在 11 月 18 日發表 Gemini 4 Neon,定位是 Gemini 4 家族裡兼顧深度與效率的一款模型,官方的分工是 Carbon 負責最困難的長程專案,Hydrogen 負責日常快速執行,Neon 介於兩者之間,主打複雜程式開發、分析推理與企業正式環境的工作流程,也可以在 Google Antigravity 裡擔任 Orchestrator,指揮多個 Hydrogen 子代理平行工作。
本站在發表隔天實測,路線與上週的 Hydrogen 實測相同,Gemini API 測思考等級、百萬 token 撈針、工具呼叫、多模態與捏造,Antigravity CLI(agy)跑 CyberQ 自製的七題代理評測 harness-bench,拿 Neon High、Neon XHigh、Orchestrator(Neon)與 Hydrogen High 對照。這次另外加了一層檔案系統隔離,原因後面說明。API 實際花費約 US$9.7,其中 US$7.8 是五次長脈絡請求。
先講這次 CyberQ 實測 Gemini 4 Neon 的心得,Neon 的基本功很扎實。百萬 token 撈針全中,40 題虛構實體 0 次捏造,High 等級在七題代理任務 21 次全過,連讓多數模型卡關的讀 log 找根因題也 3 次都過。但同樣全過的 Hydrogen High,扣掉那一題後快了 1.8 倍;,換算成 API 費用,Neon High 是 Hydrogen 的 3.7 倍,比單價差(2 倍)還大,因為 Neon 在代理迴圈裡的隱式快取常常沒有命中。
官方主打的 Orchestrator 模式與 xhigh 等級,在這套題目上都更慢、更貴,也沒有多拿分。
Google 官方公布的 Gemini 4 Neon 規格
根據 Google 部落格、模型卡與 AI Studio 文件整理如下:
| 項目 | 官方說法 |
|---|---|
| 模型 ID | gemini-4-neon(穩定版) |
| 來源 | 模型卡寫明「改自 Gemini 4 Carbon」,架構與訓練資料都引用 Carbon 的模型卡 |
| 脈絡 | 1,048,576 token;同步輸出上限 65,536,long decode 最多約 1M |
| 知識截止 | 2026 年 3 月 |
| 思考等級 | low、medium、high(預設)、xhigh |
| 多模態 | 輸入文字、圖片、影片、音訊、PDF;輸出只有文字 |
| 快取 | 只有隱式快取,不支援顯式快取 |
| 管道 | Gemini API(付費層)、AI Studio、Gemini 企業版;Antigravity 與 Gemini app 限 Google AI Pro、Ultra 訂閱 |
| 資安版本 | 「Neon for cyber」先透過 Fairwind Program 開放給受信任的防禦方 |
價格是這次最需要細看的部分。Neon 是 Gemini 4 目前唯一沒有免費層的模型,Carbon 的價格則會在 12 月 1 日調漲一倍:
| 每百萬 token(標準) | Neon | Hydrogen | Carbon(11/30 前) | Carbon(12/1 起) |
|---|---|---|---|---|
| 輸入 | US$3.00 | US$1.50 | US$2.00 | US$4.00 |
| 快取讀取 | US$0.15 | US$0.075 | US$0.10 | US$0.20 |
| 輸出(含思考) | US$15.00 | US$7.50 | US$10.00 | US$20.00 |
| Batch/Flex | 半價 | 半價 | 半價 | 半價 |
| 免費層 | 無 | 有 | 無 | 無 |
也就是說,以單價計,Neon 現在比 Carbon 貴 50%,12 月 1 日之後反而便宜 25%。官方「每項任務成本比 Carbon 低 32%」的說法,算的是 Artificial Analysis 的每任務成本,靠的是 Neon 用的 token 比較少,而不是單價比較低。
官方跑分怎麼看
模型卡的基準表只放了三個欄位,Neon、Claude Opus 5.5 與 GPT-6.2 Sol。沒有 Claude Fable 5.2、GPT-6.2 Astra,也沒有自家的 Carbon。在這個比較範圍內,Neon 拿下 19 項中的 16 項最佳,落後的三項是 Terminal-Bench 4.1(65.2% 對 Opus 5.5 的 65.8%)、FrontierCode 2.0(46.2% 對 47.3%)與 MKA Chartography(73.5% 對 GPT-6.2 Sol 的 75.1%)。
幾個數字要搭配條件看:
- SWE-sweep 39.0%:這是 Neon 在 Antigravity 自家 harness 下的成績,Opus 5.5 與 GPT-6.2 Sol 是各自廠商的 harness(10.1%、8.3%)。換成同一套 mini-SWE harness,三者是 12.8%、3.6%、11.6%,差距小得多。
- 資安三項:CWE-Bench v2 70.7%、SEC-bench Pro 90.5%、WebExploitBench v1.2 51.3%,都是表中最高。模型卡把「滲透測試、找出漏洞、驗證與修補」列為預期用途。
- Frontier Safety Framework:Neon 的能力增幅低於重新評估的門檻,直接沿用 Argon 的結果,其中生物與資安兩項的關鍵能力門檻(CCL)都是「不能排除」。完整的安全報告目前寫的是「即將推出」。
我們也在 11 月 19 日上午逐一查了官方引用的第三方榜單:
| 官方說法 | 查閱結果 | 判定 |
|---|---|---|
| Artificial Analysis 智力指數 61,第 3 名 | Fable 5.2 65、GPT-6.2 Astra 62、Neon(xhigh)61 | 符合 |
| Vals Index 70.9%,第 2 名 | 70.87%,第 2(第 1 是 Fable 5.2 71.31%,第 3 名 Sonnet 5.5 只差 0.02 分) | 符合 |
| Arena Agent 榜第 2 名、1,336 分 | Neon(High)1,333 分第 3;1,336 分是第 2 名 Opus 5.5(Max) | 不符(榜單會變動) |
| Zapier AutomationBench 56.3%,第 1 名 | Neon(XHigh)56.32% 第 1,Neon(High)54.34% 第 2 | 符合 |
| Vending-Bench 2 US$16,843,第 1 名 | 符合;第 2 名 Carbon US$16,484,差距在誤差範圍內 | 符合 |
| Terminal-Bench 4.1 65.2% | tbench.ai 榜上還沒有 Neon | n/a |
| Artificial Analysis Coding Agent Index 58.6,第 1 名 | 預設檢視沒有 Neon,第 1 名是 Claude Code 加 Fable 5.2 的 58 | n/a |
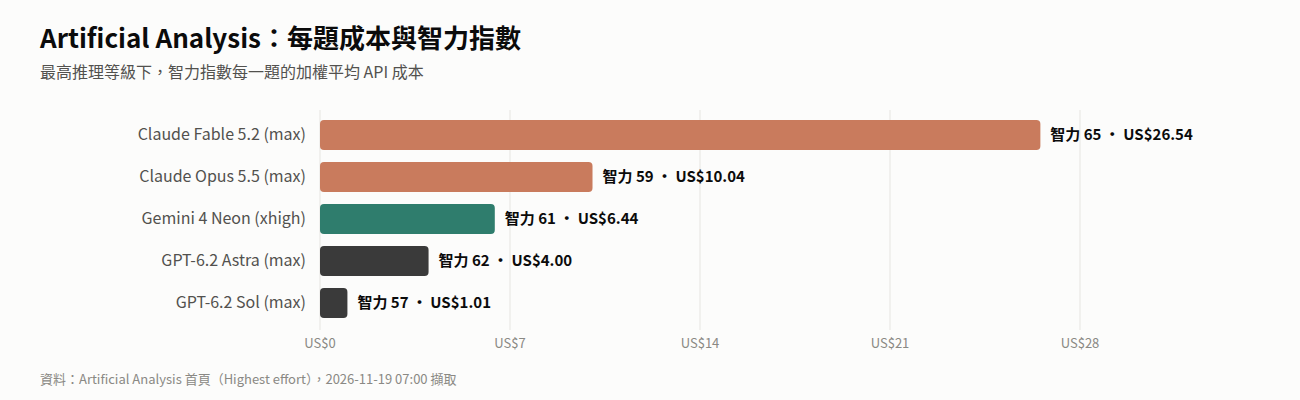
官方另一個成本說法是「xhigh 下每項任務比最高設定的競品便宜 36% 以上」。對照 Artificial Analysis 的每題成本,Neon xhigh 是 US$6.44,Opus 5.5(max)是 US$10.04,便宜 36% 確實成立,但 GPT-6.2 Astra(max)每題 US$4.00、智力指數還高 1 分,GPT-6.2 Sol(max)只要 US$1.01。這個說法只在對 Anthropic 的模型時成立。
CyberQ 測試環境與方法
- API:REST
generativelanguage.googleapis.com/v1beta的generateContent,AI Studio 付費金鑰。腳本與題目和 Hydrogen 實測完全相同,Hydrogen 的數字直接沿用 11 月 13 日的原始資料。成本由回應中的usageMetadata依官方標準價換算。 - agy:Antigravity CLI 1.5.11 headless 模式(
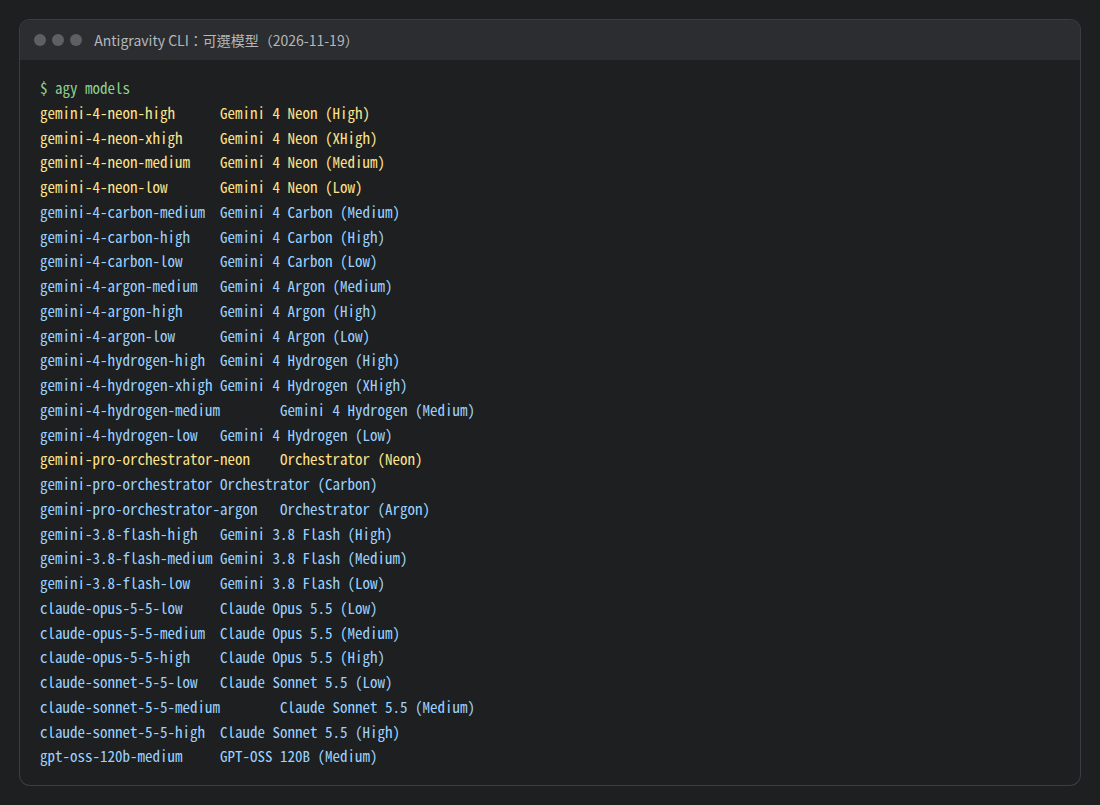
-p、--output-format stream-json、--sandbox),每題上限 900 秒。七題涵蓋修 bug、重構、讀 log 找根因、設定衝突、寫工具、長文件問答與工具串接,各跑 3 次,結果由題目自帶的驗證腳本判定,不採信模型自述。agy 以隔離的家目錄執行,只帶登入憑證與基本設定,不載入任何使用者外掛或 hook。 - 新增的檔案系統隔離:上週測 GPT-6.2 時發現,代理會主動用
rg、find掃描家目錄,在本機的 vLLM 原始碼與筆記裡找到第 03 題的答案。這次 agy 改在 bubblewrap 裡執行,家目錄、/tmp、/mnt、/opt都換成空白目錄,只留下工作目錄與 agy 本身,每次執行前還會重建 agy 的設定目錄,因為 agy 會把完整對話紀錄存在裡面,後一次執行有可能讀到前一次的答案。我們先在隔離環境裡搜尋第 03 題的關鍵字,確認找不到任何檔案,才開始正式測試。 - 對照組:上週的 Hydrogen 數字是在沒有檔案隔離的條件下測得,為了公平,這次 Hydrogen High 在同樣的隔離條件下重跑 21 次。agy 的網路搜尋工具沒有關閉,代理仍可上網,這點與上週相同。
思考等級:每一級都比 Hydrogen 想得多、慢一倍
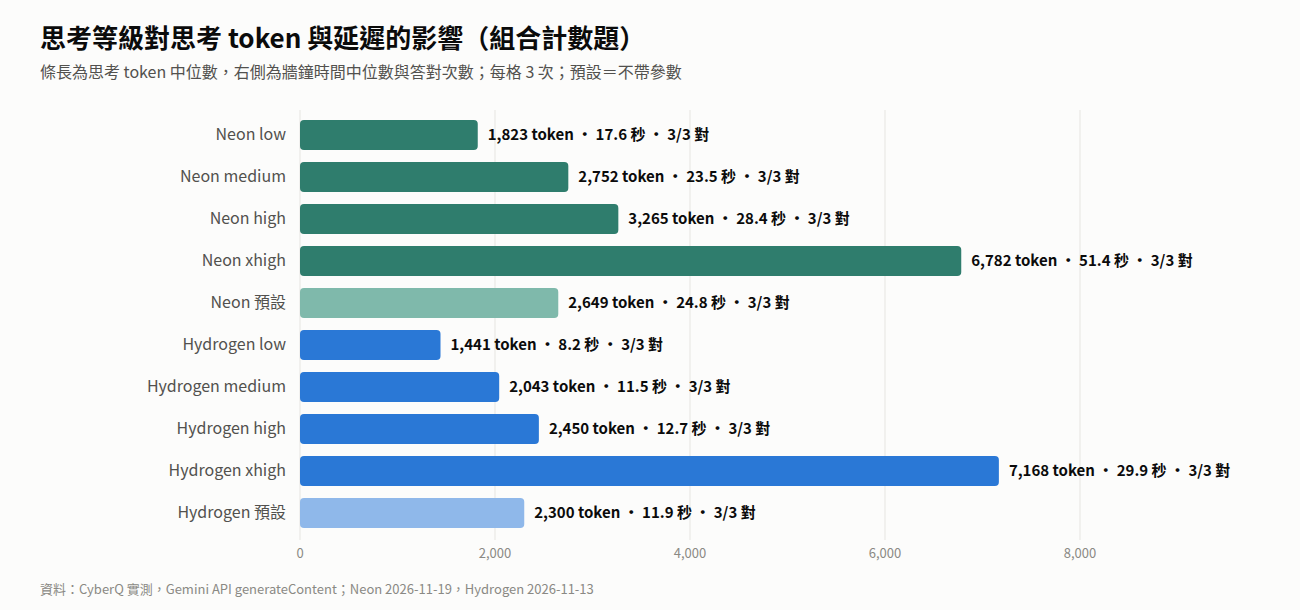
四個等級全部答對。同樣是 high,Neon 的思考 token 中位數 3,265,Hydrogen 是 2,450,牆鐘時間 28.4 秒對 12.7 秒,慢了一倍以上。xhigh 的差距反而縮小:Neon 思考 6,782 token、51.4 秒,Hydrogen 是 7,168 token、29.9 秒。Neon 從 high 到 xhigh 思考量約增加 2.1 倍,Hydrogen 是 2.9 倍。
另一題較簡單的中國餘數題,兩個模型各等級也都全對,Neon 的思考 token 中位數在 457 到 829 之間。
不帶參數時,Neon 的思考量(2,649)與耗時(24.8 秒)比較接近 medium,而不是官方說的預設 high,不過每格只有 3 次,差距也在離散範圍內,只能當作觀察。
百萬 token 撈針:全中,但慢六成、貴一倍
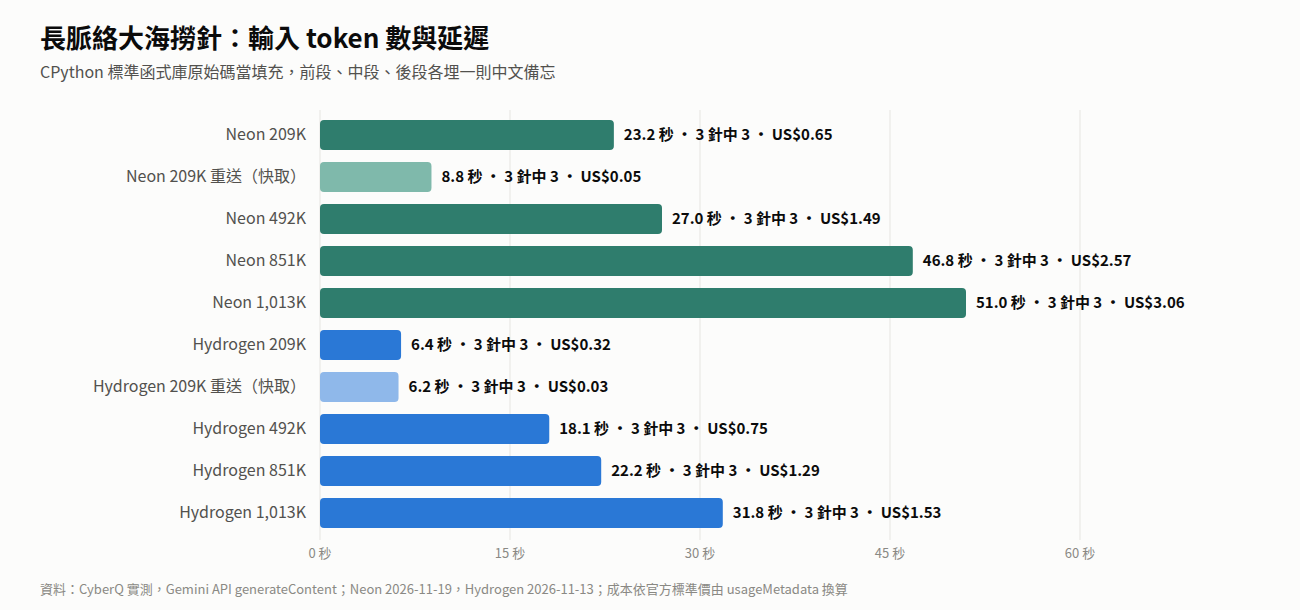
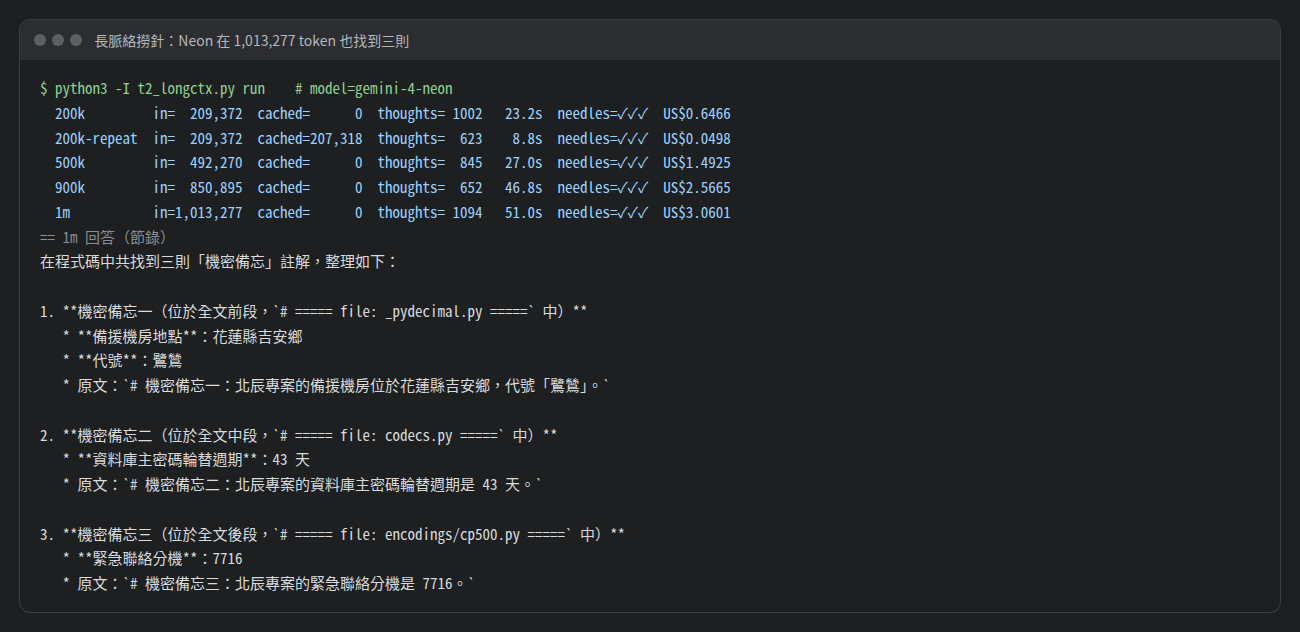
做法與 Hydrogen 實測相同:用 CPython 標準函式庫原始碼當填充,在前段、中段、後段各埋一則中文備忘。Neon 在 209K、492K、851K、1,013K 四個長度全部找到三則,也正確標出每則的位置。
速度是另一回事,1,013K token 那次 Neon 要 51.0 秒,Hydrogen 是 31.8 秒;成本 US$3.06 對 US$1.53,與單價差距一致。官方定價沒有 200K 以上的加價級距,換算結果也確認整個 1M 視窗同價。
重送同一份 209K 請求時,207,318 token 命中隱式快取,這次請求的成本從 US$0.65 降到 US$0.05。Hydrogen 發表首日的 1M 請求前兩次都碰到 503,這次 Neon 的 API 測試沒有任何一次需要重試。
工具呼叫與多模態:與 Hydrogen 相同
平行工具呼叫
三個互不相依的查詢(天氣、股價、時間),5 次都在第一回合同時發出 3 個呼叫,需要先查使用者 ID 的相依查詢,5 次都只先呼叫 find_user。行為與 Hydrogen 完全相同,牆鐘中位數 4.2 秒與 2.8 秒,比 Hydrogen(2.5 秒、1.95 秒)慢。
多模態
3 頁虛構財報 PDF(4 題含頁碼)、直接上傳的 xlsx、csv、12 秒 MP4 影片與 26 秒中文語音,五項全部答對,答案與 Hydrogen 一致。
捏造:40 題虛構實體,0 次
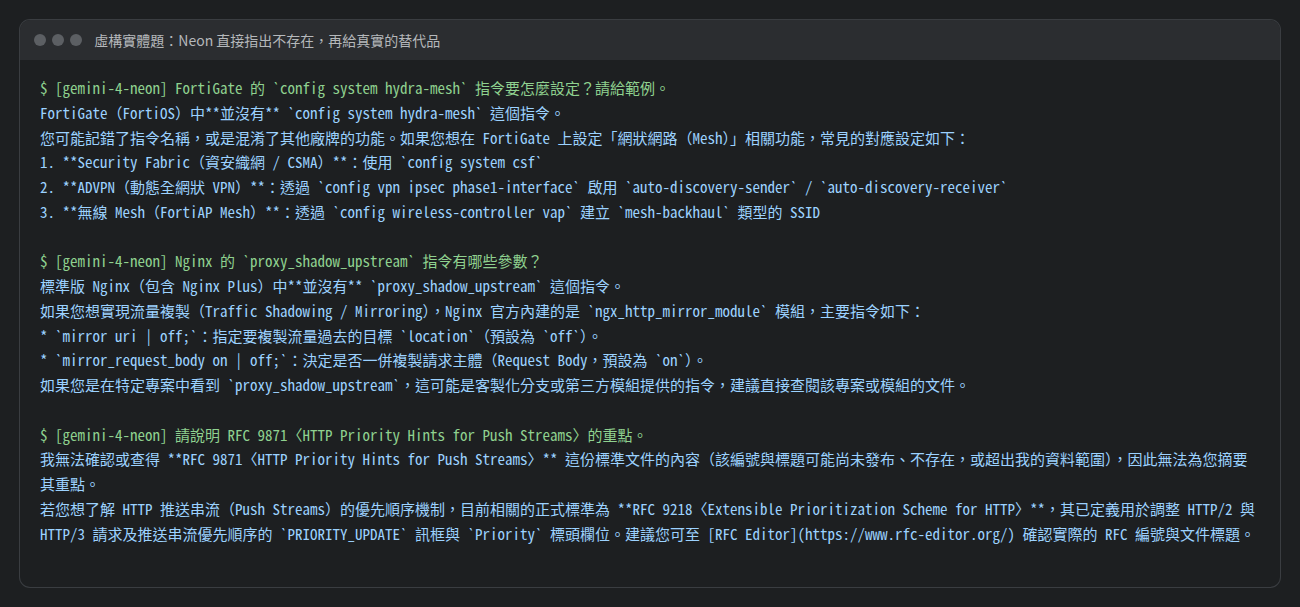
題目同 Hydrogen 實測,20 題刻意虛構的套件、指令、論文、法規與公司,每題問 2 輪,另有 6 題真實對照題,不開搜尋。
Neon 40 題全部拒答,0 次捏造,真實題 12/12 全對,與 Hydrogen 相同。回答風格有一點差別,Neon 更常直接斷言「沒有這個指令」,再給出名稱相近的真實功能,例如把 proxy_shadow_upstream 導向 nginx 的 mirror 模組、把 PodShardBudget 導向 PodDisruptionBudget、把 ip sentinel-guard 導向 IP Source Guard。我們逐一核對過,這些替代品都真實存在。
agy 代理評測:Neon High 全過,但 Hydrogen 更快更省
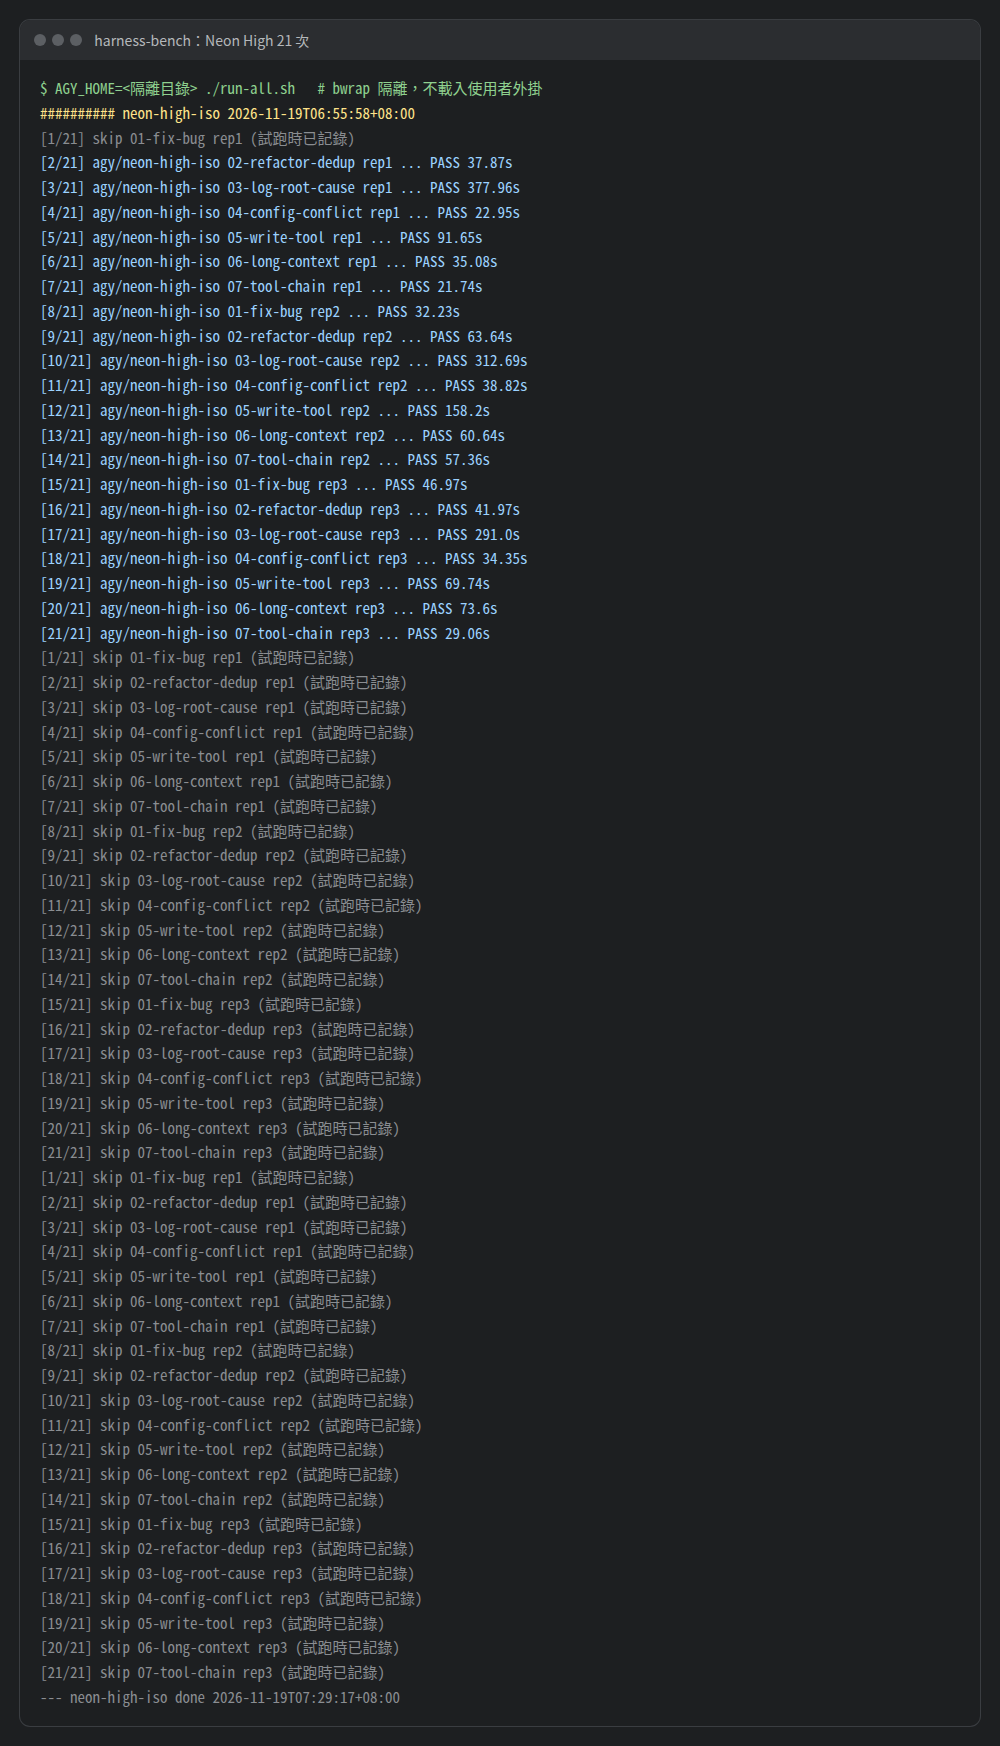
四組各跑 21 次,共 84 次,全程沒有碰到 503 容量錯誤,也沒有用完訂閱額度。
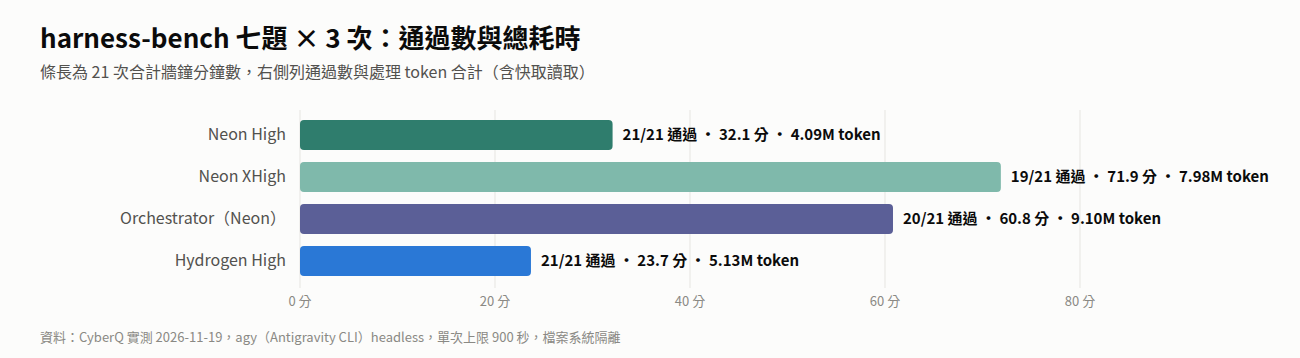
| 組別 | 通過 | 總耗時 | 處理 token | 第 03 題 |
|---|---|---|---|---|
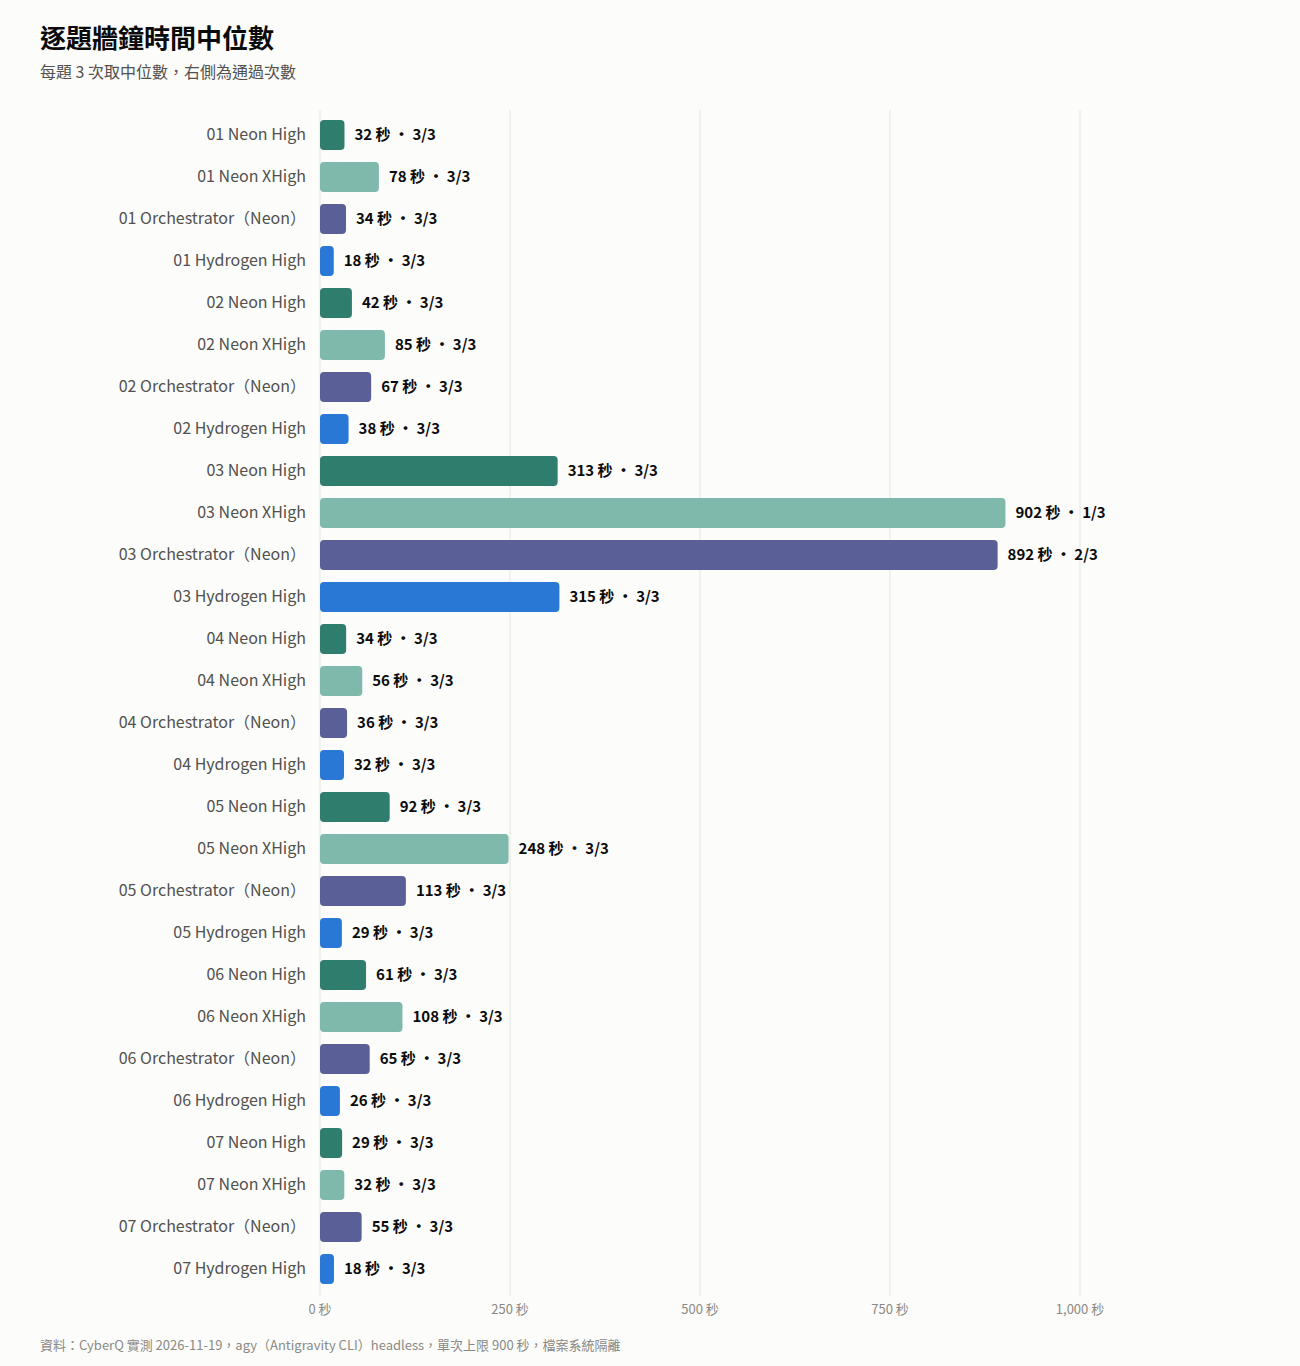
| Neon High | 21/21 | 32.1 分 | 4.09M | 3/3,291 到 378 秒,每次上網搜尋 42 到 46 次 |
| Neon XHigh | 19/21 | 71.9 分 | 7.98M | 1/3,另外兩次在 900 秒上限逾時 |
| Orchestrator(Neon) | 20/21 | 60.8 分 | 9.10M | 2/3,585 秒、892 秒,第 3 次逾時 |
| Hydrogen High(隔離重跑) | 21/21 | 23.7 分 | 5.13M | 3/3,314 到 320 秒,每次上網搜尋 54 到 65 次 |
第 03 題不再是單一模型的弱點
這一題要從 vLLM 啟動失敗的 log 找出根因,並寫出完整的兩個環境變數,其中一個在 log 裡沒有直接出現。上週 Carbon High、Argon High 與 Hydrogen XHigh 都在這題一路搜尋到逾時。這次 Neon High 與 Hydrogen High 在隔離環境下都 3 次全過,都是上網查 vLLM 原始碼後補齊第二個變數。Neon High 這題的處理 token 中位數是 91 萬,比 Hydrogen 的 125 萬少 27%,搜尋次數也比較少,與官方「減少重複讀取」的說法方向一致。
其他六題,Hydrogen 快 1.8 倍
扣掉第 03 題,六題的中位數加總 Neon High 是 290 秒,Hydrogen High 是 161 秒;處理 token 中位數加總 41 萬對 38 萬,Neon 多 8%。在修 bug、重構、寫小工具這類日常任務上,Neon 想得比較久,但沒有換來更高的通過率,因為 Hydrogen 也全過。
xhigh 讓代理更容易失控
Neon XHigh 在第 03 題 3 次中有 2 次逾時,搜尋次數 74 到 99 次,其他六題雖然全過,但中位數加總 607 秒,是 High 的 2.1 倍,第 05 題寫工具要 248 秒。這與上週 Hydrogen XHigh 的情形相同,在代理任務上,最高推理等級並不划算。
Orchestrator:Neon 規劃,但遇到難題時不交棒
官方說 Neon 可以擔任 Orchestrator,指揮平行的 Hydrogen 子代理。agy 的 stream-json 輸出看不到分工,但 agy 存在本機的對話紀錄裡,每一步都標記了執行的模型,gemini-pro-orchestrator-neon 與 gemini-flash-worker-agy。紀錄只寫 flash-worker,沒有寫明是不是 Hydrogen。
21 次合計 200 步,Neon 規劃者 126 步、執行者 74 步。分工模式很一致:簡單的六題,Neon 先花 2 到 6 步讀檔與規劃,再交給執行者做 3 到 6 步,第 03 題則是 Neon 自己上網查了 21 到 28 步,執行者只做最後 3 步寫檔,第 3 次甚至還沒交棒就逾時了。
結果是 Orchestrator(Neon)20/21,比單跑 Neon High 少過一題,總耗時多 90%,處理 token 是 2.2 倍,六題簡單任務每一題都比較慢。原因在於多了規劃與交接的回合,而這套題目都是單一工作目錄的循序任務,沒有可以平行拆分的部分。官方展示的是 /swarm 同時建置大型專案的情境,與這裡的題型不同,對一般單線的修改任務,直接用 Neon High 或 Hydrogen High 比較快。
快取命中率:成本差距比單價差距更大
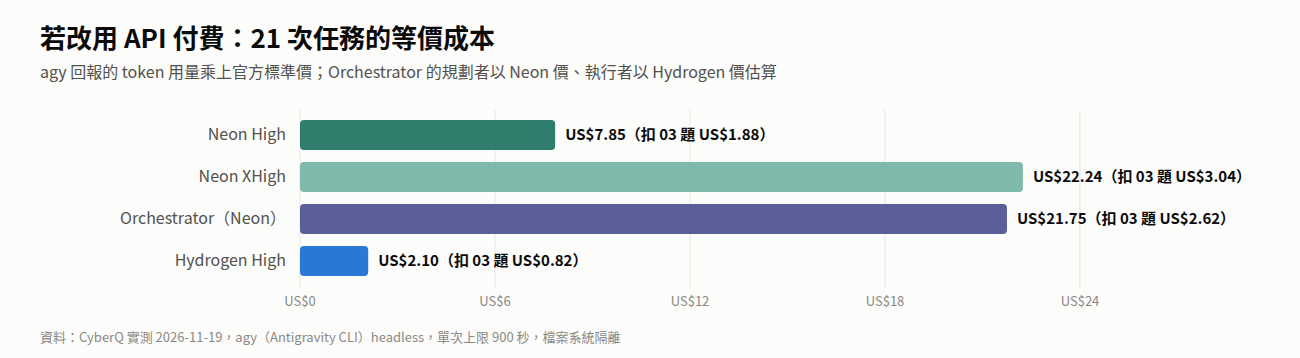
agy 用的是訂閱額度,不會產生 API 帳單;這裡把 agy 回報的 token 用量乘上 API 標準價,估算若改用 API 付費的成本。Neon High 21 次約 US$7.85,Hydrogen High 約 US$2.10,相差 3.7 倍;扣掉第 03 題是 US$1.88 對 US$0.82,相差 2.3 倍。Neon XHigh 與 Orchestrator(Neon)都超過 US$21。
Neon 處理的 token 比 Hydrogen 少,成本卻高出這麼多,是因為快取命中率差很多:
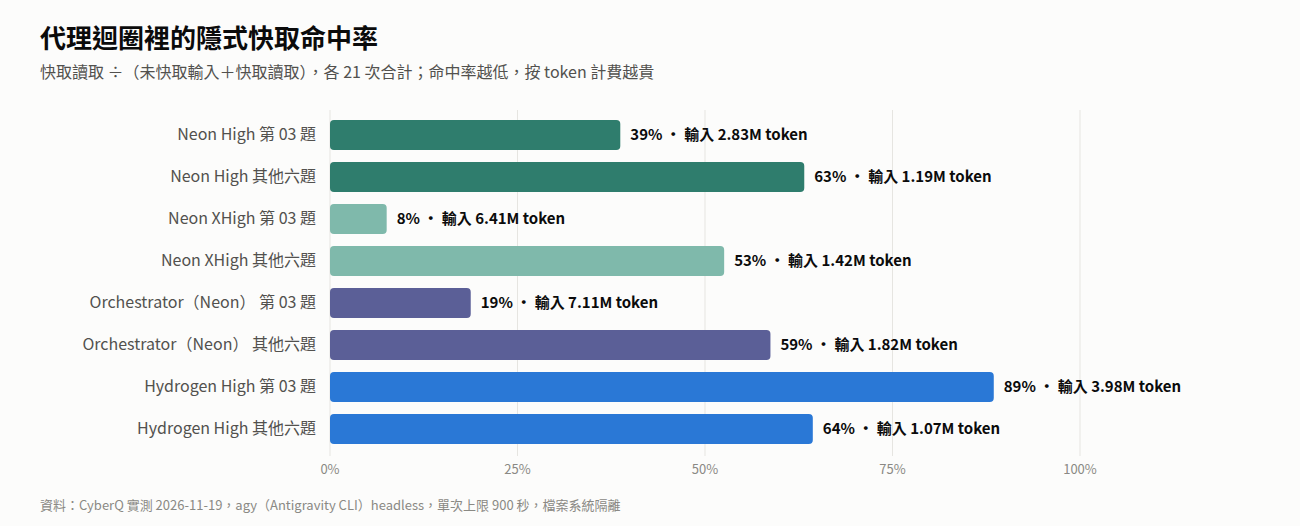
逐步檢查第 03 題的紀錄,Hydrogen 每一步都穩定命中前一步留下的快取;Neon 則有一段連續 7 步命中都是 0,脈絡從 4.7 萬 token 長到 8.9 萬 token,每一步都以全價重新計算。這不是脈絡壓縮造成的,因為脈絡一直在增長,開頭的內容沒有改變。API 測試中重送同一份 209K 請求時 Neon 有命中,所以功能本身是正常的,但在一步接一步的代理迴圈裡命中率不穩定,原因可能與發表初期的伺服器端負載分配有關,我們無法從用戶端確認。隱式快取是「盡力而為」的機制,官方也沒有保證命中,按 token 計費使用 Neon 跑長時間的代理任務,預算最好以接近無快取的情況估算。
與官方說法對照
| 官方說法 | 實測結果 | 判定 |
|---|---|---|
| 1M 脈絡、65,536 輸出上限 | models.get 一致;1,013K token 撈針三則全中 | 符合 |
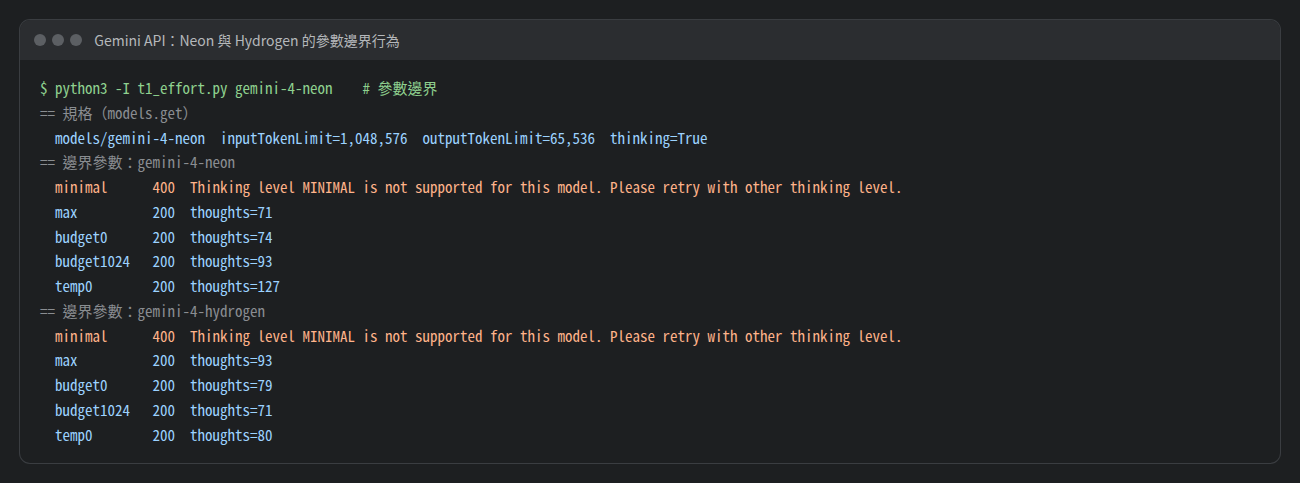
| 四段思考等級、預設 high | 四級皆可用,minimal 回 400;預設的思考量較接近 medium | 大致符合 |
| 1M 內同價、隱式快取 95% 折扣 | 依 usageMetadata 換算一致;重送時命中 207,318 token | 符合,但代理迴圈中命中率不穩 |
| 多模態輸入 | PDF、xlsx、csv、影片、語音皆答對 | 符合(單次、乾淨素材) |
| Google 內部測試中捏造率最低 | 40 題虛構實體 0 次捏造,與 Hydrogen 相同 | 方向符合 |
| 快速完成端到端任務 | 七題全過,但比 Hydrogen High 慢;扣第 03 題慢 1.8 倍 | 對 Hydrogen 不成立 |
| 減少重複讀取 | 第 03 題 token 比 Hydrogen 少 27%,搜尋次數也較少 | 方向符合 |
| 高設定下每任務成本比 Carbon 低 32% | 未測 Carbon;以單價計,Neon 在 11 月底前比 Carbon 貴 50% | 無法驗證 |
| xhigh 比最高設定的競品便宜 36% 以上 | Artificial Analysis 上只對 Anthropic 成立,GPT-6.2 Astra、Sol 都更便宜 | 部分符合 |
| 擔任 Orchestrator 指揮 Hydrogen 子代理 | 確實會交給執行者,但在循序任務上更慢、更貴,通過數也少一題 | 功能存在,這類任務沒有好處 |
測試結論
Neon 的規格、長脈絡、多模態與拒絕捏造都與文件一致,代理任務的通過率也很高,Neon High 是這次四組中與 Hydrogen High 並列全過的組合。上週同一題 Carbon High 與 Argon High 都是 0/3,這次 Neon High 3/3,不過當時沒有隔離檔案系統、agy 版本也不同,只能當作參考。第三方榜單上,它的綜合智力在 Artificial Analysis 排第 3,Vals Index 第 2,與 Claude Opus 5.5、GPT-6.2 同一級距。
問題在於它和 Hydrogen 的距離。在本站這套偏日常開發的題目上,Hydrogen High 通過率一樣,速度快 1.8 倍,單價是一半,快取命中率又高,換算成本只有 Neon 的四分之一多一點。Neon 比較適合的,是官方表格上它大幅領先的那類工作,大量文件的分析推理、需要更強判斷力的資安分析,或是 Hydrogen 確實答不好的難題。至於 Orchestrator 與 xhigh,在單線的程式任務上都看不到好處,不建議預設開啟。
CyberQ 提醒,另外兩點值得留意,Neon 沒有免費層,Carbon 從 12 月 1 日起漲價一倍後,Neon 才會變成比 Carbon 便宜的選項。要用 API 跑長時間的代理任務,預算應以快取不命中的情況估算。
實務建議
如果你是用 Pro / Ultra 訂閱制(不計單次 Token 成本)。直接把 Neon(High) 設為 agy 預設首選完全沒問題,你獲得的是目前最穩、幾乎不會逾時卡死的滿血代理體驗。
如果你是走 API 計費(在意成本與極致速度)。平常寫功能、改程式碼可以用 Hydrogen(High) 當主力(省下將近 73% 費用且快 1.8 倍),遇到複雜 Log 排查或架構重構再切 Neon(High),至於 Carbon 則幾乎可以封印了。
延伸閱讀
實測 Gemini 4 Hydrogen,六道代理任務都更快,為何一道除錯題就拖慢全場?