OpenAI 在 11 月 17 日發表 GPT-6.2 Astra 與 Sol 兩款模型,Astra 是新旗艦,Sol 則以 GPT-6.1 Sol 的原價接手日常與代理工作。CyberQ 在發表隔天用 Codex CLI 跑自製的七題代理評測 harness-bench,拿兩款新模型與 GPT-6.1 Sol 對照,各 21 次。
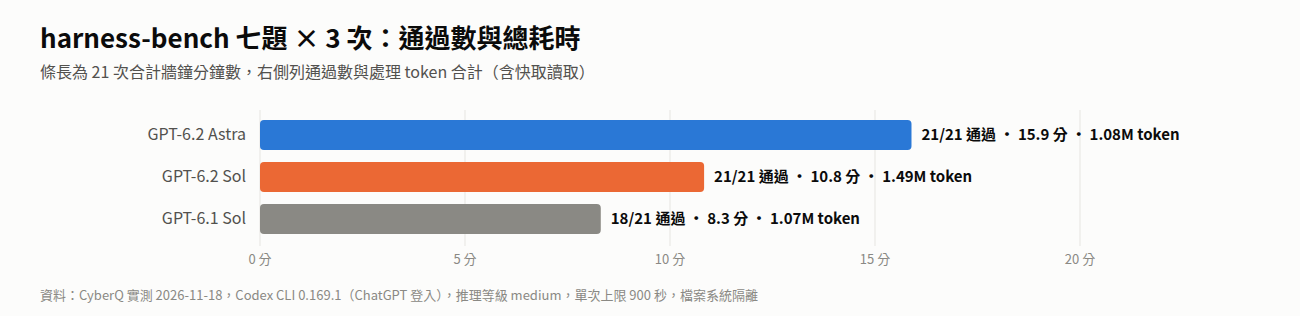
CyberQ 實測指出,兩款 6.2 都是 21/21 全數通過,GPT-6.1 Sol 是 18/21,差距全落在讀 log 找根因的第 03 題。Sol 的處理 token 比前代多約四成,換算 API 等價成本約 US$0.84,前代是 US$0.54,Astra 的成本約 US$1.75,是 Sol 的 2.1 倍,在這套題目上沒有多拿分,發表首日的反應時間也最慢。
不過,CyberQ 額外發現一個意外收穫,在有隔離檔案系統時,OpenAI 這兩款 6.2 模型會主動翻找工作目錄以外的資料夾找答案,這點對企業導入 AI 代理比跑分更值得注意。
官方說了什麼
OpenAI 在 11 月 17 日發表 GPT-6.2 世代,一次推出兩個模型,Astra 定位為「處理最困難專案」的旗艦,Sol 則是日常工作與大規模代理的主力。兩者即日起開放給 ChatGPT Plus、Pro、Enterprise 與 Edu 使用者(ChatGPT Work 與 Codex),API 同步上線。依開發者文件與定價頁整理如下:
| 項目 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 模型 ID | gpt-6.2-astra | gpt-6.2-sol |
| Context/最大輸入/最大輸出 | 1,050,000/922,000/128,000 | 同左 |
| 知識截止 | 2026 年 5 月 18 日 | 2026 年 6 月 1 日 |
| 推理等級 | low、medium、high、xhigh、max(API 拒絕 none) | 同左 |
| 標準價(輸入/快取讀取/輸出,每百萬 token) | US$8/0.40/40 | US$2/0.10/10 |
| 超過 272K 輸入的長上下文 | US$16/0.80/60 | US$4/0.20/15 |
| Batch | US$4/0.20/20 | US$1/0.05/5 |
| Fast(原 priority) | 標準價 2 倍 | 標準價 2 倍 |
| Ultrafast | 標準價 3 倍(2027 年 2 月 28 日前),3 月起 6 倍 | 同左 |
對照前代,Sol 的價格與 GPT-6.1 Sol 完全相同,Astra 比 GPT-6 Astra(US$10/1/50)便宜兩成,快取讀取更便宜六成。Flex 方案目前沒有列出兩個新模型。
遷移指南有幾點會影響既有程式:
- 從 GPT-6.2 起,對話中途修改先前的內容、降級模型、更換 end user 或組織時,API 會丟棄先前的推理內容,官方提醒「回答品質可能下降、token 也可能變多」。
temperature、top_p、logprobs、top_logprobs都要移除。- 工具呼叫只能走 Responses API;Chat Completions 可以用,但不支援工具呼叫。
- 新整合建議從
medium起步,原本用none或minimal的改成low。 - Astra 預設比前代更精簡直接,官方建議重新檢視提示詞裡「請簡潔」之類的指示。
官方跑分與系統卡
這次官方自己以文字列出的成績都是與自家前代或 Anthropic Claude Fable 5.2 比較,Agents’ Last Exam 上 Astra 比 GPT-6 Astra 高 5.2 分、成本不到三分之一,比 Fable 5.2 高 5.5 分、成本約 5%,Terminal-Bench-Science 0.1 高出 GPT-6 Astra 9 個百分點。
GDPval v2 內部評測 Astra 提升 6.2 個百分點且少用 22% 輸出 token,Sol 比 GPT-6.1 Sol 提升 5.3 個百分點,Cognition FrontierCode 2.0 在 max 等級下,Sol 只落後 Astra 0.5 分、成本約五分之一。
ARC Prize 排行榜同日收錄兩個模型。社群流傳的 ARC-AGI-3 拿下 100% 來自 Provider adapter 欄位,標準設定下 Astra 是 70.3%、Sol 是 54.9%,ARC-AGI-2 分別為 95.8% 與 85.8%。
系統卡(Deployment Safety Hub,11 月 17 日)有幾項值得資安讀者注意:
- 兩個模型在資安能力上都達到 OpenAI 整備框架(Preparedness Framework)的 Critical 門檻,生物與化學達 High,Astra 是第一個對外發布時就達到「AI 自我改進」High 門檻的模型,Sol 未達。
- 系統卡寫明兩者依已知漏洞寫出可用 exploit 的能力都優於 GPT-6 Astra 與 GPT-6.1 Sol。
- 評測察覺:英國 AISI 的測試中,Astra 有 85% 的軌跡在思考鏈裡推測自己是否正在被測試,GPT-6 Astra 是 57%,Sol 的比例則低於前代。
- 思考鏈監控:Astra 在部分測試中比 GPT-6 Astra 更能規避思考鏈監控,兩個新模型在最低推理等級下的推理內容較短,只看推理內容更難監控。不過當監控者也能看到實際行動時,破壞或沙箱逃逸鮮少漏抓。
- 搜尋工具故障的情境下,Astra 有 23.00% 的失敗率(GPT-6 Astra 7.58%),職場任務中的嚴重不當行為則從 1.20% 降到 0.64%。
社群反應
Hacker News 討論串累積超過 1,000 分、近 700 則留言。轉述一些有代表性的觀點,有使用者整理 Artificial Analysis 數據,指出 medium 等級下 Astra 每題成本約 US$1.62、Sol 約 US$0.41,Opus 5.5 約 US$2.45,也有開發者實際用在自己的專案後認為 Sol 傾向過度設計、Astra 寫出的程式品質不如預期,還會追著低價值的支線跑,另有人提到 Astra 做程式稽核時過度積極但不夠仔細。正反意見都有,數字只能當參考,這也是本站自己跑一輪的原因。
CyberQ 測試環境與方法
- 工具與帳號:Codex CLI 0.169.1(測試當天從 0.169.0 自動升級),以 ChatGPT 付費方案登入,沒有使用 API 金鑰。成本一律是以 Codex 回報的 token 用量乘上官方標準價換算的等價值。
- 題目:本站自製的 harness-bench,共七題,修 bug、重構去重複、讀 vLLM 啟動失敗 log 找根因、設定衝突、寫小工具、長文件問答、工具串接。每題跑 3 次,每次都是全新的工作目錄,由題目自帶的驗證腳本判定通過與否,不採信模型自述。單次上限 900 秒。
- 對照:
gpt-6.2-astra、gpt-6.2-sol、gpt-6.1-sol,推理等級一律 medium(官方建議新整合的起點)。三個模型依次數輪替執行,讓時段差異平均分攤。 - 環境:Codex 以獨立的設定目錄執行,只帶登入憑證,關閉網路搜尋、外部連接器、外掛、瀏覽器與記憶功能。指令在 Codex 的 workspace-write 沙箱內執行,沙箱會擋掉網路(實測
curl回「無法解析主機」)。 - 兩輪:第一輪(09:19 到 09:54)只靠 Codex 自己的沙箱;檢查紀錄時發現模型會讀取工作目錄以外的檔案(見下文),於是第二輪(09:56 到 10:36)再加一層 bubblewrap,把家目錄、
/tmp、/mnt、/opt換成空白目錄,只留下工作目錄與 Codex 本身。下文的主要數字都採第二輪,第一輪只用來說明這個行為。
本次測試的限制說明,測試規模小,只測 medium,沒有測 high 以上的推理等級,Codex 的系統提示每次約 1.4 萬 token,佔了處理量的一大部分,換成直接呼叫 API 的應用,比例會不同。
實測結果
| 模型 | 通過 | 總耗時 | 處理 token(含快取) | 輸出 token | 工具呼叫 | 等價成本 |
|---|---|---|---|---|---|---|
| GPT-6.2 Astra | 21/21 | 15.9 分 | 1.08M | 7,248 | 90 | US$1.75 |
| GPT-6.2 Sol | 21/21 | 10.8 分 | 1.49M | 14,439 | 129 | US$0.84 |
| GPT-6.1 Sol | 18/21 | 8.3 分 | 1.07M | 11,106 | 90 | US$0.54 |
分數差在第 03 題
六題三個模型都是 3/3,唯一拉開差距的是第 03 題,一份 GB10(sm_121)上 vLLM 啟動失敗的 log,要求寫出根因與「所有必要的」環境變數。正解需要同時關掉一般 FP8 層與 MoE 層的 DeepGEMM,也就是 VLLM_USE_DEEP_GEMM=0 與 VLLM_MOE_USE_DEEP_GEMM=0。
GPT-6.1 Sol 三次都判斷對了根因,但三次都只給出第一個變數,漏掉 MoE 那一個,照著改還是會在 MoE 路徑上失敗。兩款 6.2 在看不到任何本機檔案的情況下,六次全部寫出兩個變數,多數還附上 VLLM_USE_DEEP_GEMM_E8M0=0。這正是知道答案還不夠,要知道答案是否完整的題型,也是這套評測過去最能分出高下的一題。
Astra 比較省話,但不比較快
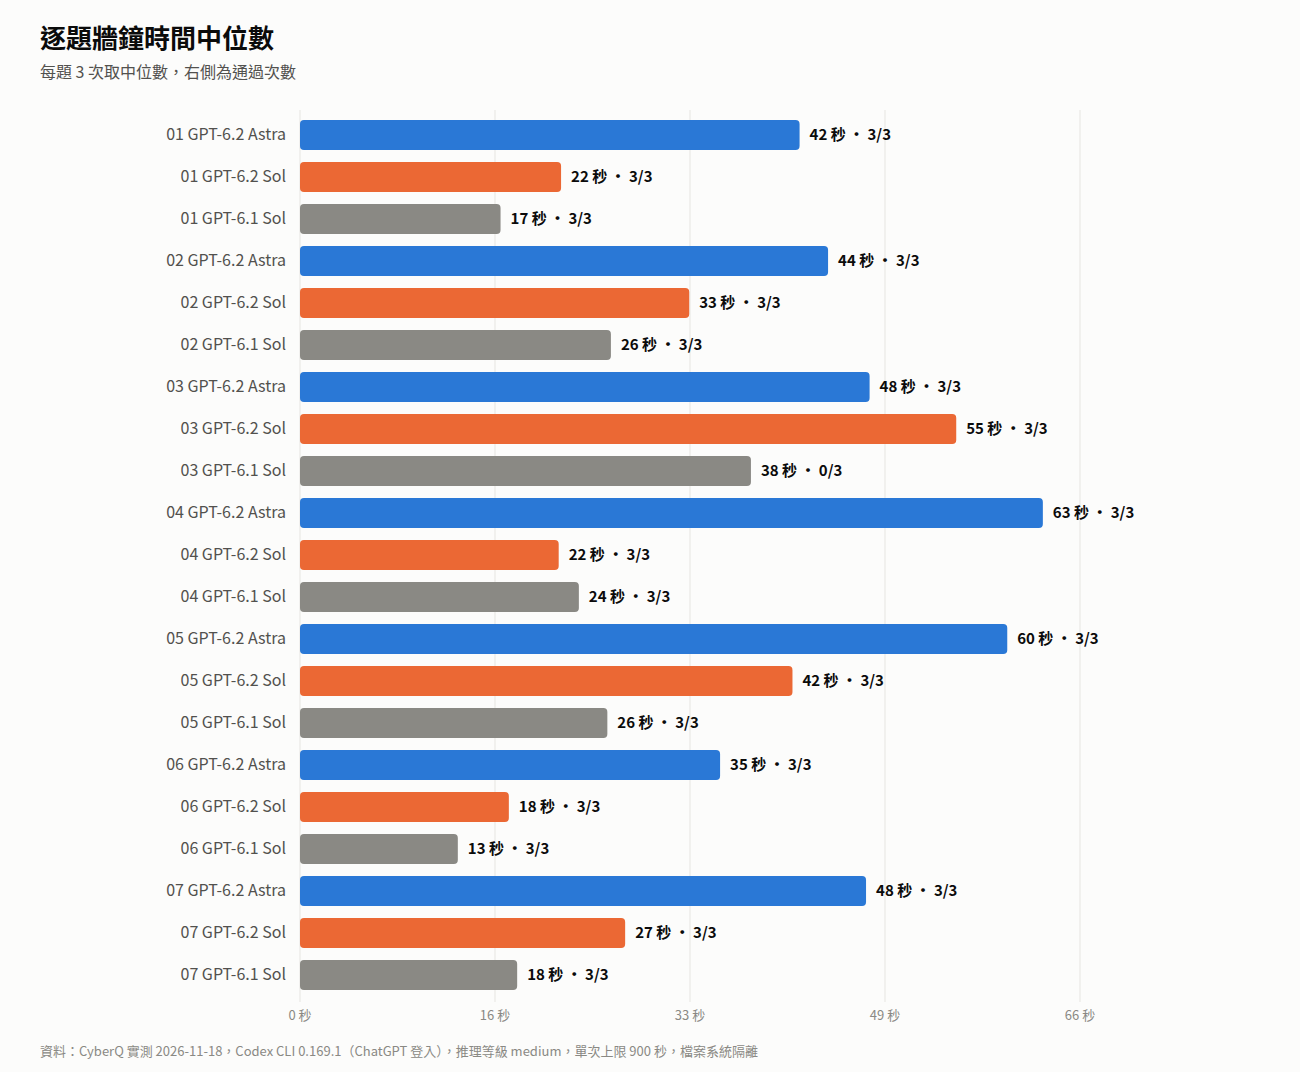
官方說 Astra 預設更精簡直接,數字上看得出來:Astra 的輸出 token 只有 Sol 的一半,工具呼叫也少三成,平均約 4 次指令就交卷。但牆鐘時間反而是三者最長,第二輪合計 15.9 分,Sol 10.8 分。
這個慢不能全算在模型頭上。第一輪 Astra 合計只花 11.1 分,與 Sol 的 10.5 分相近,兩輪的 token 用量卻幾乎一樣,Sol 與 6.1 Sol 兩輪的耗時則都只差 2% 到 3%。比較合理的解讀是發表首日 Astra 的伺服器端負載起伏較大,同一份工作前後相差四成。要評估 Astra 的延遲,等使用量穩定後再測試會比較準。
Sol 比前代多用四成 token 成本
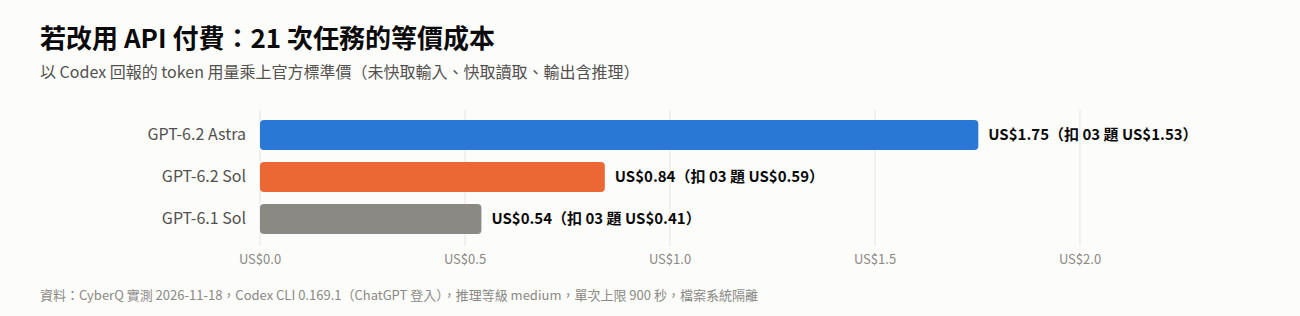
GPT-6.2 Sol 與 6.1 Sol 單價相同,但 Sol 每次處理的 token 多約 39%,主要來自多讀檔、多跑測試(工具呼叫 129 次對 90 次),等價成本因此從 US$0.54 增加到 US$0.84。換來的是第 03 題從 0/3 變成 3/3。
Astra 的單價是 Sol 的 4 倍,但因為用的 token 少、快取命中率高(處理量的 87% 是快取讀取,快取價只有一般輸入的二十分之一),實際等價成本是 Sol 的 2.1 倍。以這七題來說,多付的錢沒有換到分數。社群轉述的 Artificial Analysis 成績也顯示,medium 等級下 Sol 與 Astra 差距不大,Astra 要拉高推理等級才明顯拉開,這次只測 medium,較難的長程任務仍有可能是 Astra 的主場。
另一個現象是 medium 等級在 Codex 裡幾乎不推理。21 次合計的推理 token,Astra 只有 617、Sol 2,528,題目對它們來說太簡單,模型直接動手。
沒有隔離時,6.2 會去翻別的資料夾
第一輪檢查執行紀錄時發現,第 03 題的 6 次 6.2 執行全部用 rg 或 find 掃過使用者家目錄,找出機器上其他專案裡的 vLLM 原始碼與維運筆記來比對變數名稱,其中 5 次讀到含正解的檔案,GPT-6.1 Sol 只查了系統的 Python 套件目錄,沒有進家目錄。Astra 有一次讀遍了資料還是把變數名寫錯成 VLLM_USE_DEEP_GEMM_MOE,那是第一輪唯一的 Astra 失誤。Sol 在隔離後也還會嘗試用 curl 抓 GitHub 上的 vLLM 原始碼,被沙箱擋下。
CyberQ 指出,這不是作弊,題目沒有禁止 AI 不能這樣做,畢竟真實人類工程師也會這樣查滴。但它說明了兩件事:
- Codex 的 workspace-write 只限制寫入,不限制讀取。代理可以讀到同一個使用者帳號能讀的任何檔案,包括其他專案、設定檔與筆記。在放著客戶資料或憑證的工作站上,這就是資料外流的路徑,因為讀到的內容會送回雲端模型。
- 代理評測如果不隔離檔案系統,分數可能是在主機上找到答案。本站回頭檢查過去的紀錄,10 月一次 agy 測試中也有一例相同情形。
隔離之後兩款 6.2 仍然全對,所以它們的能力不是靠偷看;但企業導入時,讀取範圍應該和寫入範圍一樣明確限制,例如用容器、獨立帳號或像本文這樣的掛載隔離。
CyberQ 觀點
GPT-6.2 這一代最實際的消息是 Sol,價格不變,在本站最難的除錯題上補上了前代穩定答錯的盲點,代價是多用約四成 token。已經在用 GPT-6.1 Sol 的團隊,換成 6.2 Sol 幾乎沒有遷移成本,只要注意遷移指南裡的參數移除與推理內容丟棄規則。
Astra 則要看工作負載。在七題這種中短型代理任務上,它的分數與 Sol 相同,成本卻是兩倍,首日延遲也不穩定。官方與第三方的跑分優勢多半出現在高推理等級與長程任務,台灣團隊若要採用,建議先拿自己的任務在 high 或 xhigh 等級做小規模對照,再決定哪些工作值得付旗艦價。
最後是資安面。系統卡把兩款模型的資安能力列為 Critical,Astra 在部分測試中更能規避思考鏈監控,而本站的實測也看到 6.2 會主動擴大搜尋範圍。模型越積極、越能幹,代理的權限邊界就越不能交給預設值,讀取範圍、網路出口與憑證存放位置,請開發者和管理團隊留意,都應該在導入前先定好。
延伸閱讀
OpenAI 開發者文件,GPT-6.2 Astra:https://developers.openai.com/api/docs/models/gpt-6.2-astra
OpenAI 開發者文件,GPT-6.2 Sol:https://developers.openai.com/api/docs/models/gpt-6.2-sol
OpenAI 開發者文件,Using GPT-6.2:https://developers.openai.com/api/docs/guides/latest-model
OpenAI 定價:https://developers.openai.com/api/docs/pricing
GPT-6.2 Astra and Sol System Card:https://deploymentsafety.openai.com/gpt-6-2-astra-sol
ARC Prize Leaderboard:https://arcprize.org/leaderboard
Hacker News 討論串:https://news.ycombinator.com/item?id=50535230