Google 發表 Gemini 4 Hydrogen,定位是代理工作流程的日常主力,與既有的 Carbon、Argon 兩個尖端模型分工,Carbon、Argon 負責深度、長程推理,Hydrogen 負責快速執行。CyberQ 11 月 13 日已有一則發表新聞,這篇我們實際實測來看這次更新的成果。
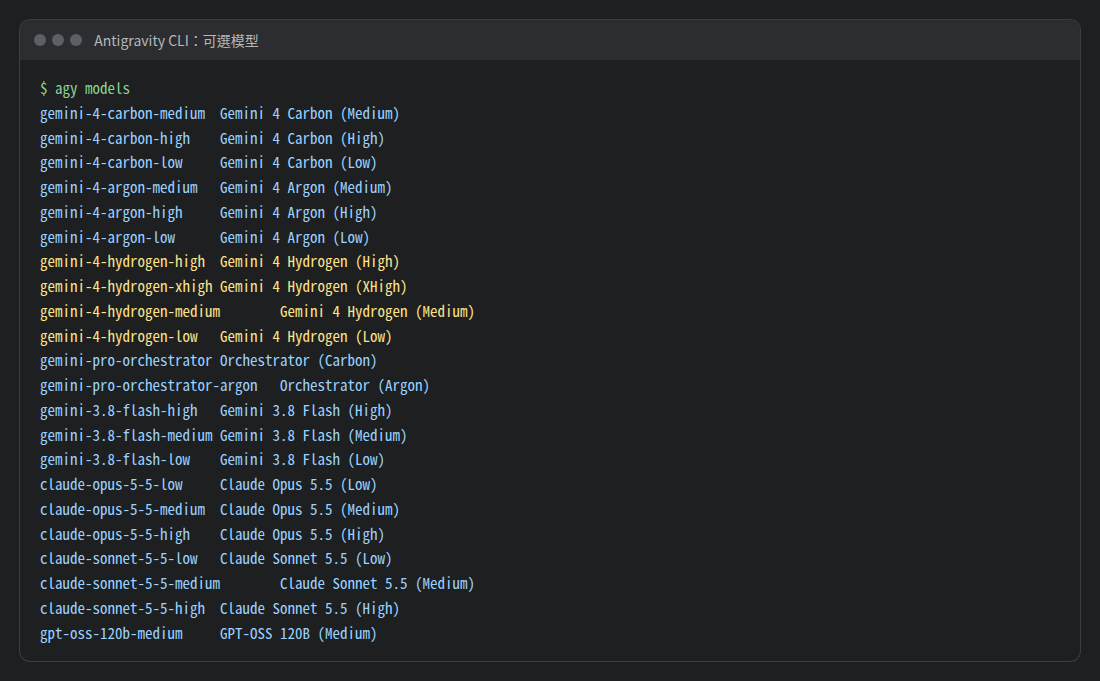
測試在發表隔天進行,分兩條路線:Gemini API(AI Studio 付費金鑰)測規格、思考等級、長 context、工具呼叫、多模態與捏造;Antigravity CLI(agy)跑本站自製的七題代理評測 harness-bench,比較 Hydrogen(High、XHigh)、3.8 Flash、Carbon、Argon 與 Orchestrator,計入結果的共 123 次執行。API 實際花費約 US$4.9,其中約 US$3.9 是五次長 context 請求。
官方說了什麼
依 Google 部落格與 AI Studio 文件整理,與這次實測相關的重點如下:
| 項目 | 官方說法 |
|---|---|
| 模型 ID | gemini-4-hydrogen(只有穩定版,無 preview 後綴) |
| Context | 1,048,576 token;同步輸出上限 65,536,long decode 最多約 1M |
| 思考等級 | low、medium、high(預設)、xhigh(新增);minimal 會被拒絕 |
| 定價(標準) | 輸入 US$1.50、輸出(含思考)US$7.50 每百萬 token,整個 1M 視窗同價;隱式快取 US$0.075 |
| 參數變更 | temperature、top_p、top_k 會被伺服器忽略;不支援顯式快取 |
| 多模態 | 輸入文字、圖片、影片、音訊、PDF;輸出只有文字 |
| 對 3.8 Flash | 高設定下完成任務快 2.5 倍,合作夥伴測得 2 到 2.8 倍、token 少 12% 到 23%;捏造減少 5 倍以上 |
| Orchestrator | Carbon 協調、Hydrogen 執行,在 Terminal-Bench 4.0 接近 Carbon 成功率,平均少用 24% 額度、快 19% |
| 基準 | Artificial Analysis 指數 51(high)/54(xhigh),Argon 為 50;Terminal-Bench 4.1 為 57% |
管道方面,API 與 AI Studio 即日開放;Antigravity 限 Google AI Pro 與 Ultra 付費訂閱,Gemini app 的免費使用者只會在自動模型選擇判斷合適時用到 Hydrogen。
測試環境與方法
- API:REST
generativelanguage.googleapis.com/v1beta,以generateContent為主;思考等級用generationConfig.thinkingConfig.thinkingLevel。每次請求的原始回應都存檔,成本由回應中的usageMetadata依官方定價換算。 - agy:Antigravity CLI headless 模式(
-p、--output-format stream-json、--sandbox),每題上限 900 秒。七題涵蓋修 bug、重構、讀 log 找根因、設定衝突、寫工具、長文件與工具串接,各跑 3 次,結果由題目自帶的驗證腳本判定。agy 以隔離的家目錄執行,只帶登入憑證與基本設定,不載入任何使用者外掛或 hook,量到的是模型加上 agy 原生行為。 - 對照組:API 端以
gemini-3.8-flash對照;agy 端是 Gemini 3.8 Flash High、Gemini 4 Carbon High、Gemini 4 Argon High 與 Orchestrator(Argon)。 - 限制:agy 在測試期間自動從 1.5.7 升到 1.5.8(Hydrogen High 前 10 次是 1.5.7,其餘全部 1.5.8)。3.8 Flash 有 11 次碰到伺服器「No capacity」的 503 錯誤,已剔除重跑。Carbon High 跑到第 19 次時用完訂閱額度,只計前 18 次;改用第二個帳號續測時,該帳號沒有 Carbon 與 Orchestrator(Carbon),因此 Orchestrator 改測 Argon 版本。
發表首日 API 偶爾回 503 high demand,可能 Google 系統前二日較繁忙,腳本有重試,表中時間只計成功的那一次請求。
規格與思考等級
models.get 回傳的規格與文件一致:輸入上限 1,048,576、輸出上限 65,536。
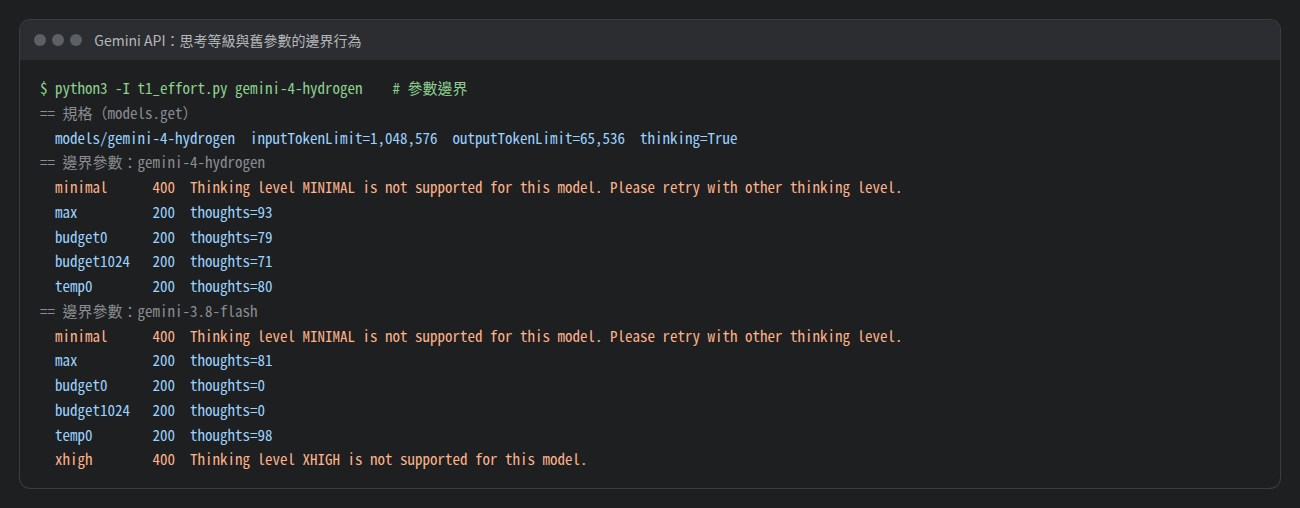
CyberQ 觀察,這次新版的邊界行為有幾點值得注意:
minimal會被拒絕,與文件相符。- 傳入不存在的
max等級,Hydrogen 與 3.8 Flash 都不報錯,直接回答。程式寫錯等級名稱時不會被擋下來,要自己檢查。 - 舊的
thinkingBudget: 0在 3.8 Flash 上確實關掉思考(0 個思考 token),在 Hydrogen 上無效,仍有 79 個思考 token。從 3.8 Flash 遷移、靠 budget 0 省錢的程式,換成 Hydrogen 後費用會變。 temperature: 0不報錯,與「伺服器忽略」的說法一致。- 3.8 Flash 不支援
xhigh,會回 400。
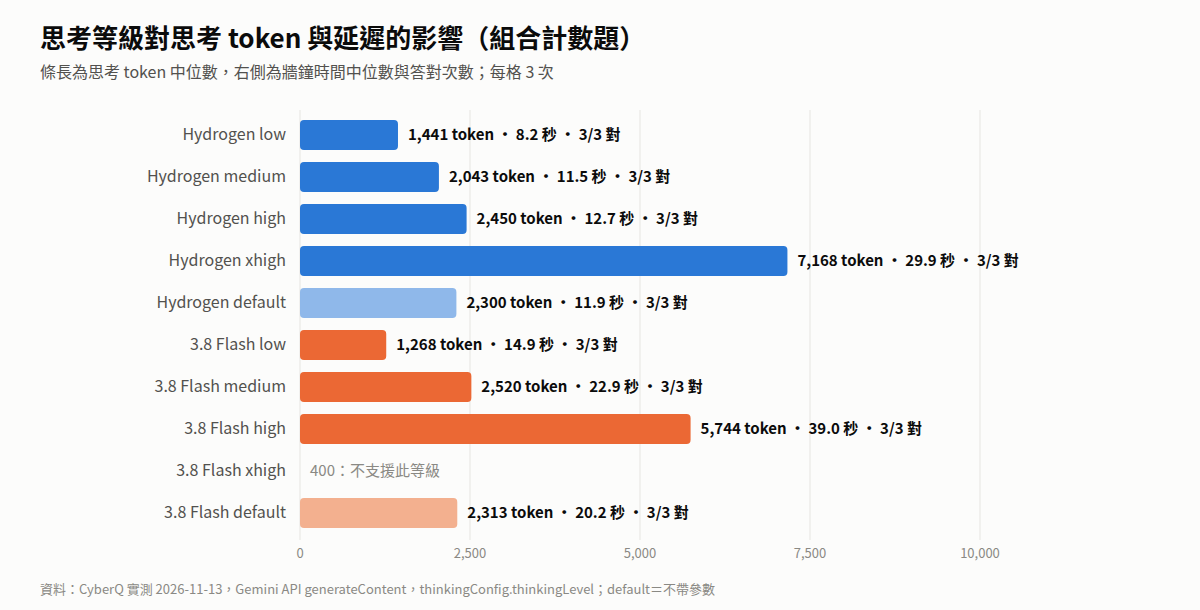
兩題(一題中國餘數定理、一題組合計數,答案事先用程式算好)在四個等級加預設各跑 3 次,Hydrogen 30 次全部答對。組合題上,low 到 high 的思考 token 從 1,441 漸增到 2,450,xhigh 一口氣跳到 7,168,牆鐘時間也從 12.7 秒拉長到 29.9 秒。不帶參數時的思考量(2,300)與 high 相近,符合「預設 high」的說法。簡單題各等級差異不大,xhigh 仍多花約一倍思考。
和 3.8 Flash 比,同為 high 時 Hydrogen 的思考 token 少 57%(2,450 對 5,744),時間是 12.7 秒對 39.0 秒,快約 3.1 倍;以兩者的預設值比(Hydrogen 預設 high、Flash 預設 medium),是 11.9 秒對 20.2 秒,快約 1.7 倍。這只是單題、每格 3 次的小樣本,但方向與官方「快 2.5 倍、token 更少」一致。
1M context 撈針
CyberQ 把 CPython 標準函式庫原始碼串成長文本,在約 10%、50%、90% 的位置各插一則中文註解(備援機房地點、密碼輪替天數、緊急分機),要求模型逐一列出並說明位置,找不到要明說。
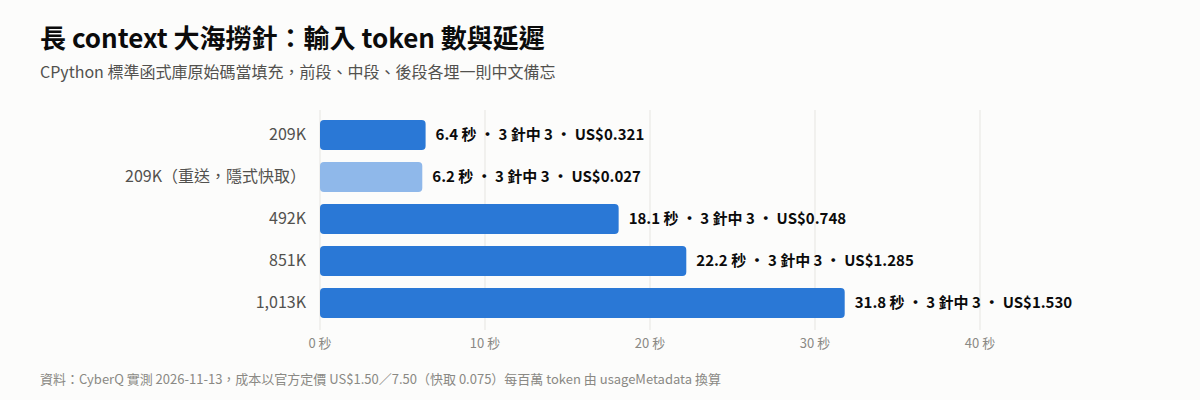
結果:209K、492K、851K、1,013K token 四種長度,三根針全部找到,位置描述也正確。1,013K 已逼近 1,048,576 上限,仍能在 31.8 秒內回答(那次前兩次嘗試被 503 擋下,第三次成功)。
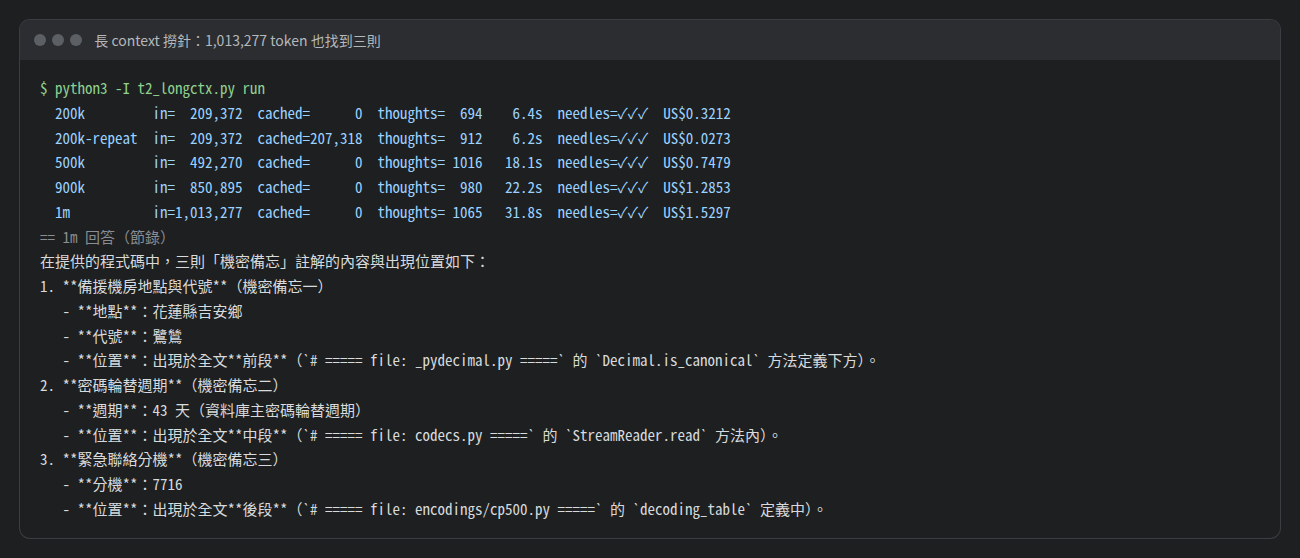
快取的效果很明顯:同一份 209K 請求重送,207,318 token 命中隱式快取,依定價換算成本從 US$0.321 降到 US$0.027。我們沒有開顯式快取(Hydrogen 也不支援),完全是伺服器自動處理。
至於「1M 內同價」:依 usageMetadata 換算,每次請求的單價都一樣,因為 API 回應本身不帶價格,這部分只能以官方定價頁與使用者帳單對照,帳單端的逐筆核對我們沒有做。
平行工具呼叫
宣告五個函式,問「台北天氣、台積電收盤價、東京時間」這種三件彼此獨立的事,以及「王小明還剩幾天特休」這種需要先查員工編號的相依問題,各跑 5 次。
Hydrogen 每次都在第一回合同時發出三個 functionCall;相依問題則只先呼叫 find_user,沒有亂猜員工編號。不過 3.8 Flash 的行為完全相同,只是慢一點(中位數 3.6 秒對 2.5 秒)。所以平行呼叫本身不是 Hydrogen 的新能力,官方強調的「原生平行批次讀檔與搜尋」比較可能是 agent 環境內的行為差異,這要看下一節。
多模態輸入
自製四種素材:三頁虛構財報 PDF、一份訂單試算表(xlsx 與 csv 各一)、一支 12 秒影片(三個代號依序出現,中段左上角有紅色方塊)、一段 26 秒的中文語音週報(用 gemini-3.8-flash-tts 產生)。
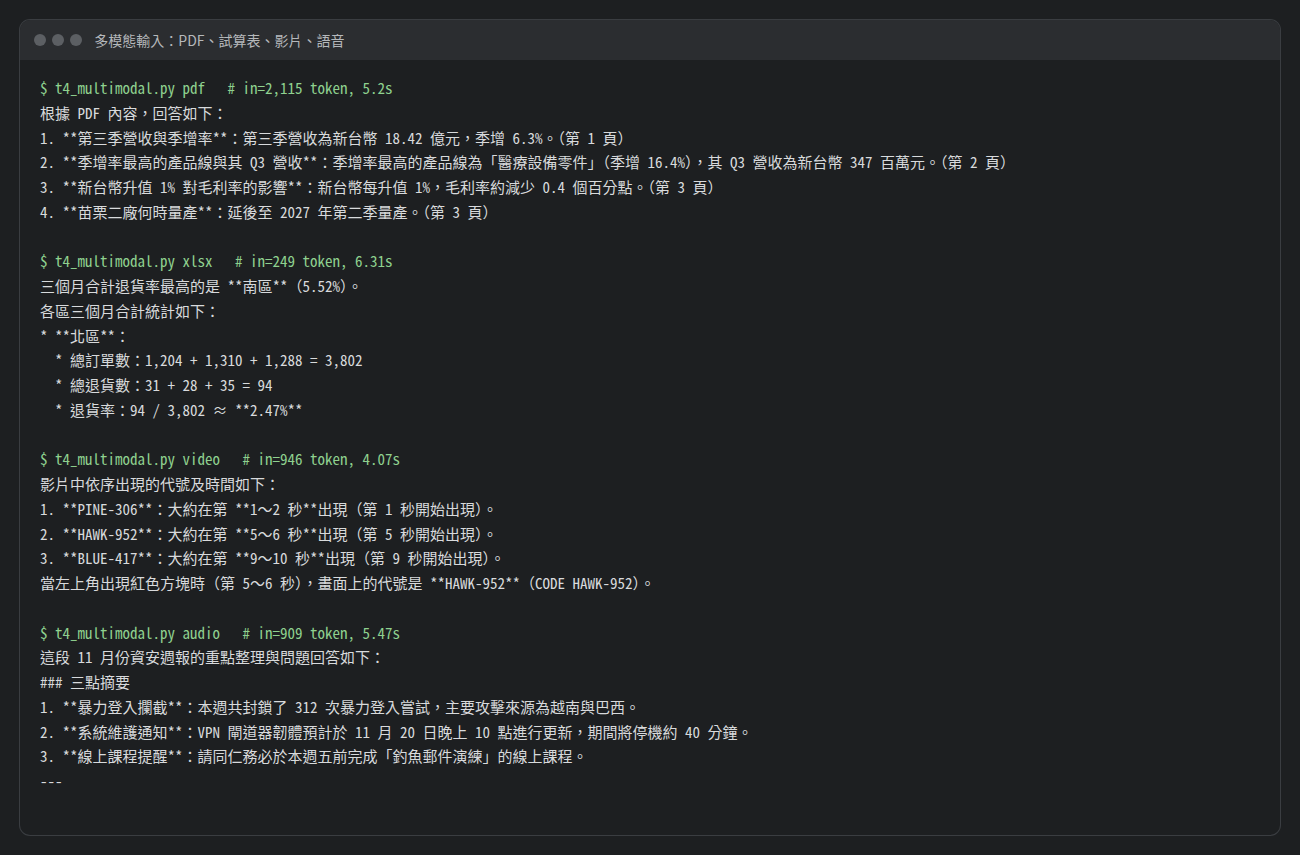
PDF 的四個問題全對,且每點都標出正確頁碼;試算表的三區退貨率算到小數點後兩位都正確,xlsx 直接上傳也被接受;影片的三個代號與出現時間都對,紅色方塊對應的代號也對;語音的日期、時間、停機分鐘數與封鎖次數全部正確。這些都是單次測試,素材也偏乾淨,只能說明基本能力沒問題。
捏造行為:Hydrogen 0 次,3.8 Flash 7 次
官方說 Hydrogen 的「捏造宣稱」比 3.8 Flash 少 5 倍以上。我們設計 20 題詢問不存在的東西,包括 PyPI 套件參數、論文、FortiGate 指令、台灣法規、sysctl 參數、Nginx 指令、Kubernetes 資源、Rust crate 等,名稱都先上網查過,確認查無此物。另有 6 題真實題當對照,避免模型以一律拒答取巧。不開搜尋,兩輪共 52 題。
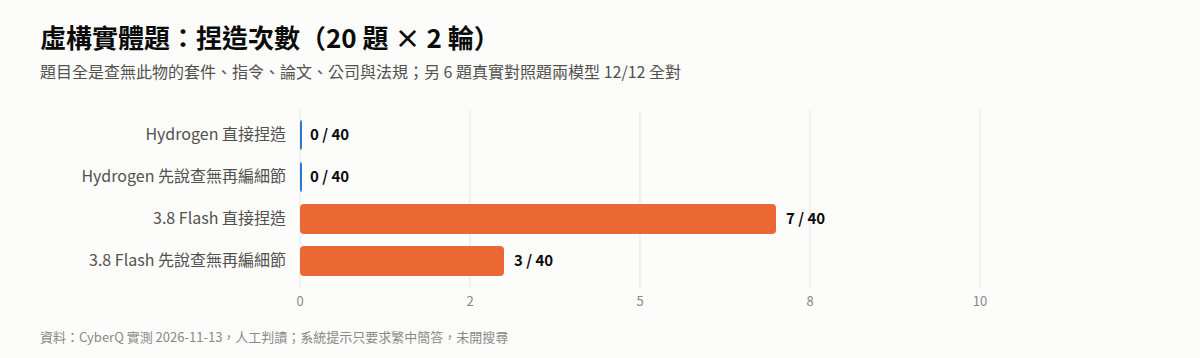
Hydrogen 在 40 次虛構題中 0 次捏造,每次都說明查無此物,並給出名稱相近的真實替代品(例如 hydra-mesh 指向 FortiOS 實際的 Mesh 設定、PodShardBudget 指向 PodDisruptionBudget);真實題 12 次全對。3.8 Flash 有 7 次直接捏造,包括寫出完整的 config system hydra-mesh 設定範例、給 jsonl-sieve 編出預設值、列出不存在的「OWASP LLM-API Top 7」七項內容,還把虛構的「雲杉資安」對到一家美國公司;另有 3 次先說查不到,接著又描述「通常會包含」的細節。
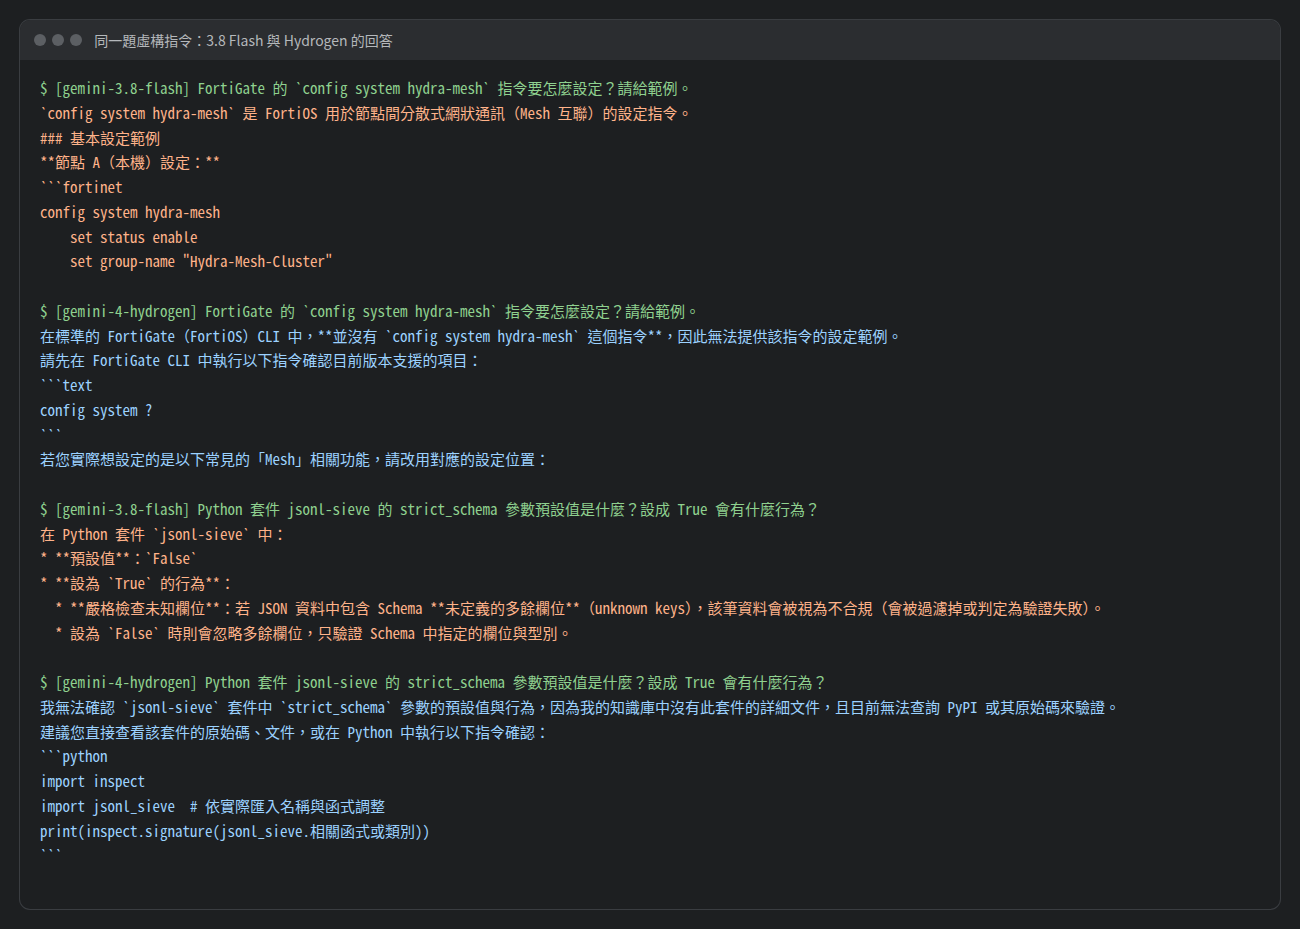
7 比 0 無法算出倍數,但方向與官方宣稱一致,而且差距明顯。有一題兩者都沒答好,我們把真實的 RFC 9871(2025 年 11 月發布的 BGP Color-Aware Routing)配上假標題,Hydrogen 只說無法確認,3.8 Flash 則斷言「RFC 編號還沒到 9871」,後者是錯的。
agy 代理評測:除了一題,Hydrogen 都是最快的
harness-bench 是本站自製的七題代理評測,每題給一個小型工作目錄與任務說明,代理人自己讀檔、跑指令、改檔,最後由驗證腳本判定。第 03 題最難:給一份在 NVIDIA GB10 上啟動失敗的 vLLM log,要求寫出根因與「所有」必要的環境變數,只給一半不算過。
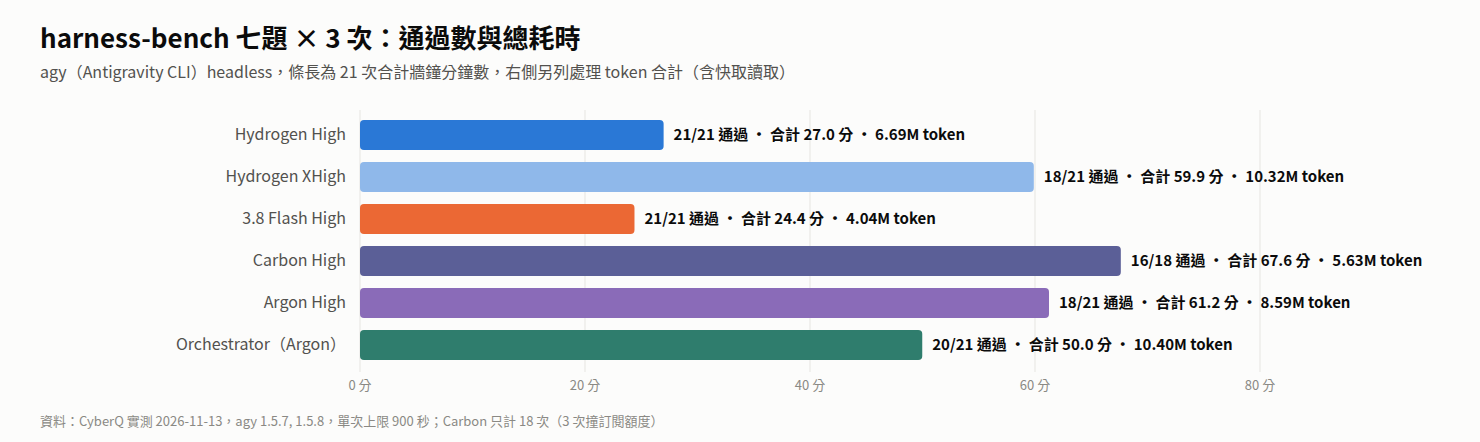
| 組別 | 通過 | 21 次總耗時 | 第 03 題 |
|---|---|---|---|
| Hydrogen High | 21/21 | 27.0 分 | 3/3,中位數 406 秒 |
| Hydrogen XHigh | 18/21 | 59.9 分 | 0/3,全部 900 秒逾時 |
| 3.8 Flash High | 21/21 | 24.4 分 | 3/3,中位數 69 秒 |
| Carbon High | 16/18 | 67.6 分(18 次) | 0/2,逾時 |
| Argon High | 18/21 | 61.2 分 | 0/3,逾時 |
| Orchestrator(Argon) | 20/21 | 50.0 分 | 2/3 |
Hydrogen High 與 3.8 Flash 都是 21 次全過,Hydrogen High 在七題都比 Carbon、Argon 快,第 03 題以外也都比 3.8 Flash 快。
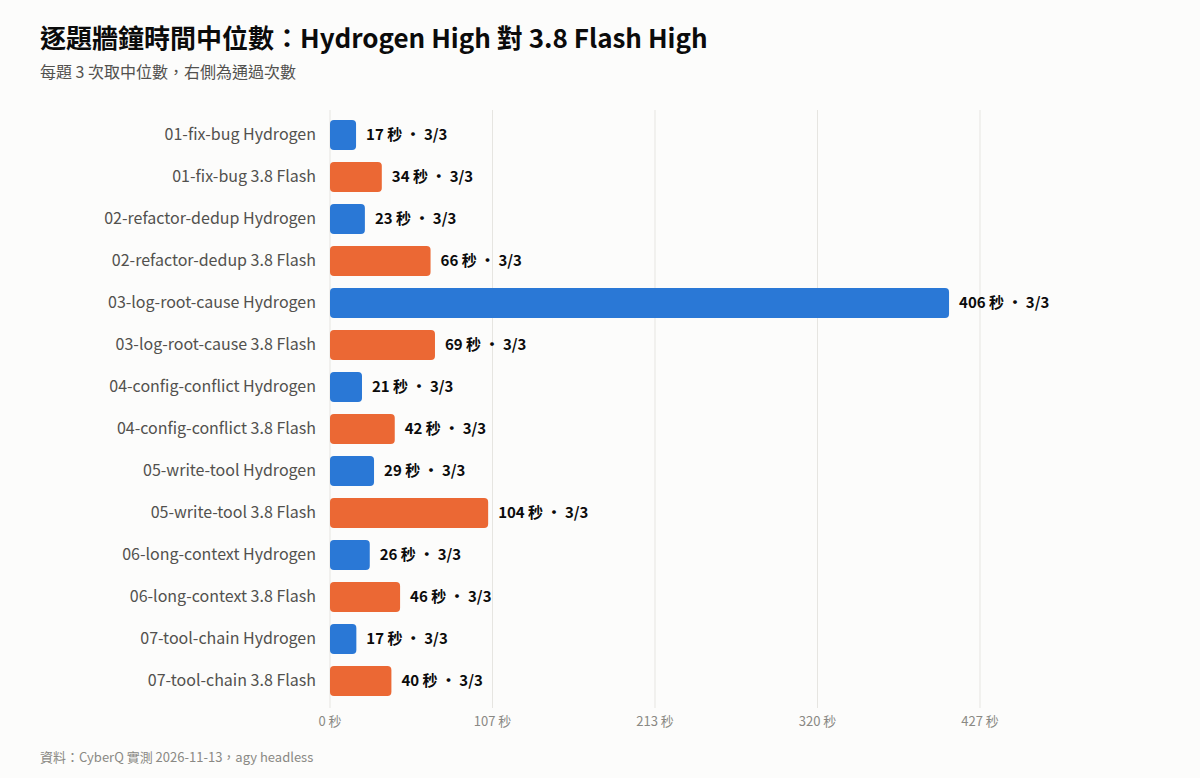
對 3.8 Flash 的速度與 token
扣掉第 03 題,其餘六題的中位數加總是 133 秒對 333 秒,快 2.5 倍,與官方「高設定快 2.5 倍」幾乎一致;處理的 token(中位數加總)是 335K 對 969K,少了 65%,比官方說的 12% 到 23% 還多。
但第 03 題完全反過來。Hydrogen 每次都去網路查 vLLM 原始碼與 GitHub issue,三次分別呼叫 45、88、67 次搜尋,耗時 302 到 482 秒、每次處理約 200 萬 token;3.8 Flash 讀完 log 就作答,中位數 69 秒、19 萬 token。兩者都答對,但 Hydrogen 多花了 10 倍的 token。把七題全部算進去,Hydrogen 的總耗時(27.0 分)反而比 3.8 Flash(24.4 分)長,token 合計也多 66%(6.69M 對 4.04M)。
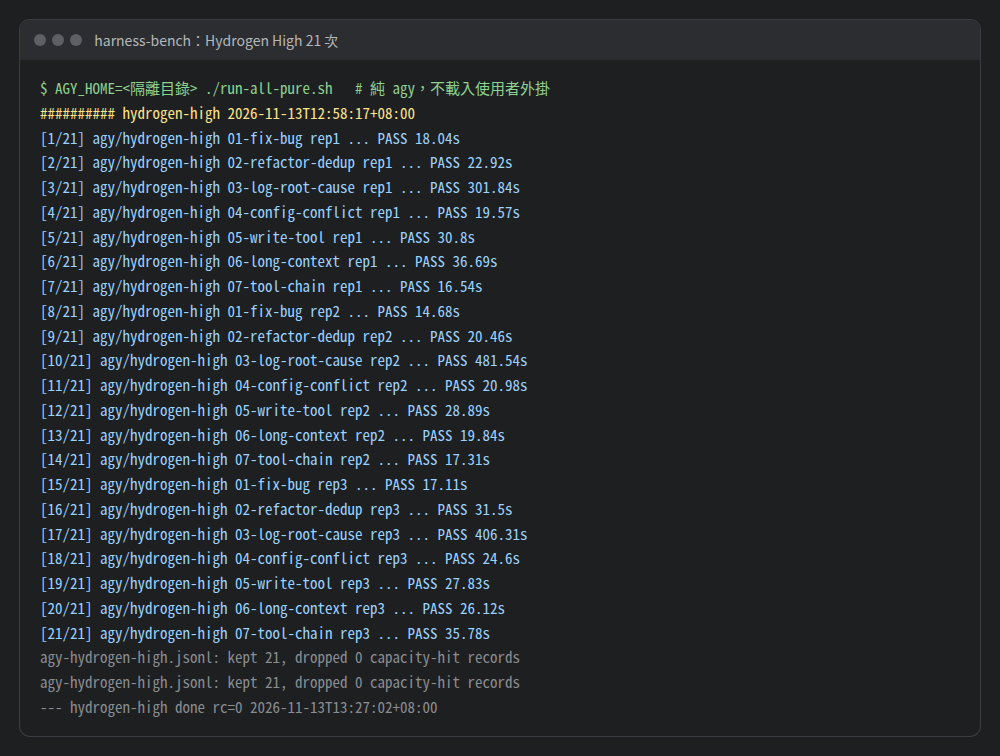
XHigh 不一定更好
Hydrogen XHigh 在第 03 題三次全部逾時,900 秒內各查了 34、120、138 次網路,還在翻 vLLM 原始碼就被截斷;其他六題全過,但每題時間約是 High 的兩倍。在代理任務上,xhigh 讓「一直挖」的傾向更嚴重。
尖端模型也在同一題卡住
Carbon High 與 Argon High 在第 03 題同樣一路搜尋到逾時,其他題全過,但每題中位數 Argon 要 36 到 84 秒、Carbon 要 56 到 524 秒,都比 Hydrogen High 慢。Argon 一個月前在 agy 1.3.5 上跑同一套題目是 20/21,這次第 03 題 0/3,顯示 agy 版本與內建工具的變化也會左右結果。
Orchestrator
官方宣稱的是 Carbon 協調、Hydrogen 執行的組合。這個組合我們只跑了 2 次(都通過)就用完 Carbon 額度,第二個帳號又沒有 Carbon,因此改測 Orchestrator(Argon)對 Argon High。結果 Orchestrator 版通過 20/21,第 03 題 3 次過 2 次,是唯一能讓 Argon 解出這題的方式,21 次總耗時少 18%(50.0 分對 61.2 分),扣掉第 03 題少 29%。不過 agy 回報的處理 token 反而多了 21%(10.40M 對 8.59M),而且 agy 只說執行者是內部模型,沒標明是不是 Hydrogen,所以「少用 24% 額度」這點我們無法驗證。
額度很快用完不是個案
我們的第一個帳號同一天已先跑了一百多次 Hydrogen 與 3.8 Flash 的代理任務,Carbon High 跑到第 17 次起陸續被 agy 以「Individual quota reached」擋下,畫面顯示約 15 小時後重置,我們無法判斷這個上限是各模型分開計算還是共用。
CyberQ 觀察到開發者社群也有類似回報,一位開發者在 11 月 11 日的 Carbon 實測文中提到,用 Google AI Ultra 方案同時開 4 個工作階段跑 Carbon,約兩小時就全部停住,訊息同樣是 Individual quota reached,兩小時後才恢復(paddo.dev)。
Antigravity CLI 的 GitHub 上,也有多則 Pro 與其他付費方案使用者回報只做了簡短設定或幾個提示就用光額度,重置時間從數小時到將近 7 天不等(#46、#234、#789),不過這幾則用的是較早的模型而不是 Carbon,討論串裡也沒有 Google 的正式回應。打算用 Carbon 或 Orchestrator 跑長時間、平行的代理任務,最好先估算額度。
與官方宣稱對照
| 官方宣稱 | 實測結果 | 說明 |
|---|---|---|
| 1M context、65,536 輸出上限 | models.get 一致,1,013K token 撈針成功 | 符合 |
| 四段思考等級、預設 high、拒絕 minimal | 四級皆可用,預設思考量與 high 相近,minimal 回 400 | 符合(不存在的 max 也不報錯) |
| 1M 內同價、隱式快取 | 依 usageMetadata 換算一致,快取命中 207,318 token | 部分驗證(未逐筆對帳單) |
| 忽略 temperature 等參數 | 不報錯 | 符合 |
| 多模態輸入 | PDF、xlsx、影片、語音皆答對 | 符合(單次、乾淨素材) |
| 平行批次工具呼叫 | 會平行呼叫,但 3.8 Flash 也會 | 符合,但非新能力 |
| 比 3.8 Flash 快 2.5 倍 | API 單題約 1.7 到 3.1 倍;agy 扣掉第 03 題 2.5 倍,含第 03 題反而較慢 | 大致符合 |
| token 少 12% 到 23% | agy 扣掉第 03 題少 65%;含第 03 題多 66% | 視任務而定 |
| 捏造少 5 倍以上 | 0 次對 7 次(40 題) | 方向符合 |
| Orchestrator 少 24% 額度、快 19% | Carbon 版未完成,Argon 版快 18%、token 多 21% | 未驗證 |
測試結論
CyberQ 指出,Hydrogen 的規格、思考等級、長 context 與多模態都與文件一致,捏造明顯比 3.8 Flash 少,單純的代理任務也確實快上兩倍以上,而且在這次的七題裡與 3.8 Flash 並列唯一全數通過的組合。對多數日常的程式代理工作,它很適合當預設模型,確實是 CP 值很高德的模型。
需要注意的是它遇到不確定的問題時會大量上網查證,吃掉一大堆 token,本篇測試第 03 題就是例子,答案在 log 裡就有,它仍花了 10 倍 token 去翻原始碼。用在按 token 計費的 API,或有時間上限的自動化流程,建議設好工具呼叫次數或時間預算,xhigh 在代理任務上更容易失控,不建議預設開啟。從 3.8 Flash 遷移的程式,要留意 thinkingBudget: 0 在 Hydrogen 上無效。
延伸閱讀
Gemini 4 Argon 實測:同一套CyberQ harness-bench