Anthropic 日前由 Claude 官方帳號發布了一份模型選擇指引 Claude 官方貼文:如何選擇 Claude 模型,內容不長,但把選型的邏輯講得很清楚。這篇文章把那份指引整理成可以實際操作的流程,補上官方規格表的價格與延遲資料,再用實際情境算一次成本,最後給出一段可以直接執行的 Haiku 5.5 API 範例,並附上 CyberQ 實跑的結果。
CyberQ 實測心得是,選模型的本質不是挑最強的那一款,而是讓能力、延遲與成本對上任務的需求。官方原文也特別註明,這些方向只是粗略建議,而非規則,最好的模型,其實是符合你工作方式的那一個才對喔。
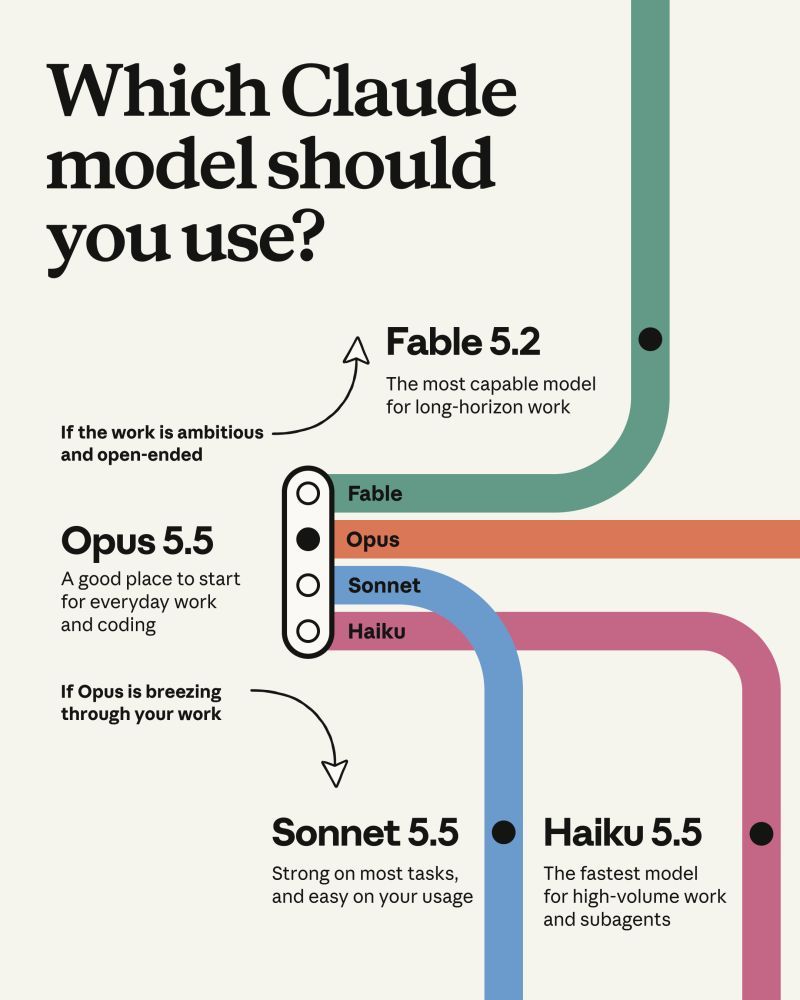
官方指引怎麼說
官方貼文把使用情境分成四種,並給出對應的起點。日常的程式開發與知識工作從 Opus 5.5 開始。需要更快回覆、更多用量空間時改用 Sonnet 5.5。最雄心壯志、開放式的技術與研究工作交給 Fable 5.2。若是在 API 上建構服務,Haiku 5.5 是速度最快、負擔最輕的模型,適合放在背後處理高流量工作。
官方文件另外補充了一條判斷條件,值得和貼文一起看。模型總覽頁寫明,不確定時多數工作從 Opus 5.5 開始,需要高強度推理與長時程代理工作,或是在 Opus 5.5 上提高 effort 之後 eval 成績仍然達不到要求,才建議改用 Fable 5.2。也就是說,升級要有量測依據,而不是遇到難題就直接換最貴的模型。
四款模型的規格與價格
以下數字來自 Anthropic 官方模型總覽,價格為每百萬 token 的美元單價。
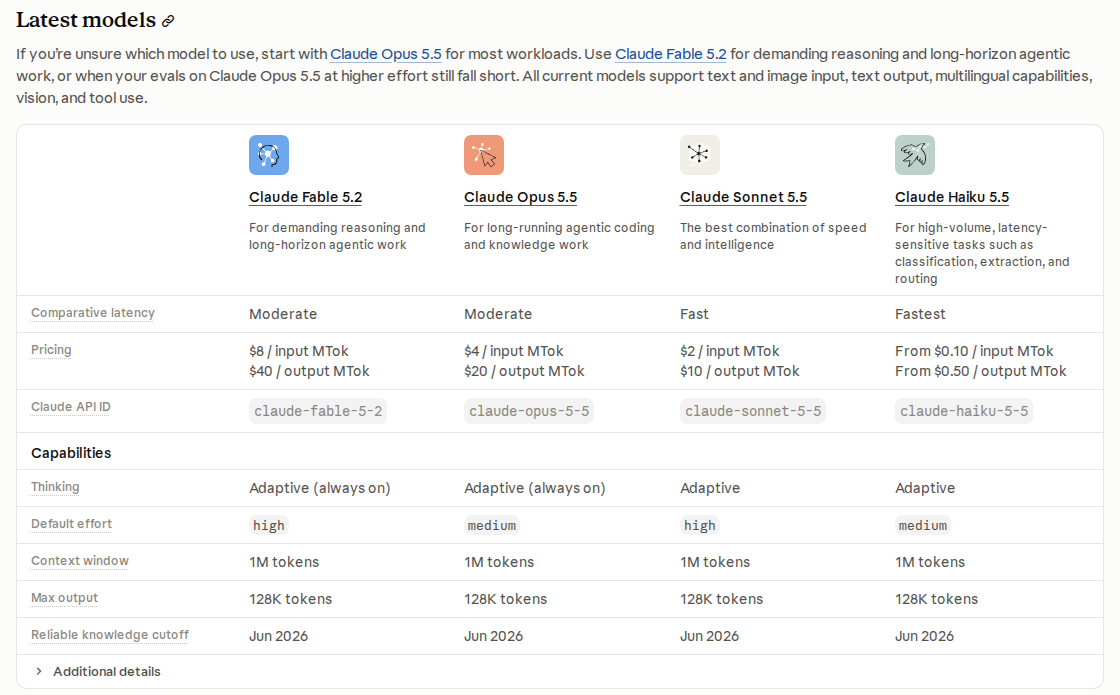
- Claude Fable 5.2:模型 ID
claude-fable-5-2,輸入 8 美元、輸出 40 美元,延遲中等,預設 effort 為 high。定位是高強度推理與長時程代理工作。 - Claude Opus 5.5:模型 ID
claude-opus-5-5,輸入 4 美元、輸出 20 美元,延遲中等,預設 effort 為 medium。定位是長時間執行的代理式程式開發與知識工作。 - Claude Sonnet 5.5:模型 ID
claude-sonnet-5-5,輸入 2 美元、輸出 10 美元,延遲快,預設 effort 為 high。官方描述是速度與智慧的平衡點。 - Claude Haiku 5.5:模型 ID
claude-haiku-5-5,輸入 0.10 美元起、輸出 0.50 美元起,延遲最快,預設 effort 為 medium。定位是高流量、延遲敏感的分類、抽取與路由。
Haiku 5.5 的價格寫「起」是因為分級計價,單次請求的提示(含快取讀寫)在 10 萬 token 以下時是 0.10/0.50 美元,超過 10 萬 token 整筆改收 0.50/2.50 美元。CyberQ 在 10 月的 Haiku 5.5 實測中以 Console 帳單對帳確認過這個門檻。分類、抽取這類短請求通常落在低價區,但如果把整份長文件丟給 Haiku,單價會變成五倍。
四款模型的上下文視窗都是 100 萬 token,最大輸出 128K token,都支援文字與圖片輸入、工具使用與多語言。思考模式方面,Fable 5.2 與 Opus 5.5 的 adaptive thinking 永遠開啟,Sonnet 5.5 與 Haiku 5.5 同為 adaptive 模式。在 Amazon Bedrock 上,Opus 5.5、Sonnet 5.5 與 Haiku 5.5 使用 anthropic. 前綴,例如 anthropic.claude-opus-5-5。
Fable 5.2 目前只在 bedrock-runtime 端點提供,要使用推論設定檔 ID global.anthropic.claude-fable-5-2。Microsoft Foundry、Claude Platform on AWS 與 Google Cloud 則沿用原本的模型 ID。
Batch API 的請求價格是標準價的五折。提示快取的讀取價格是基準輸入價的一成,Fable 5.2 只要 2.5%,Opus 5.5 與 Sonnet 5.5 是 5%。對固定 system prompt 很長、請求量又大的服務,快取的影響常常比換模型還大。
成本試算:選錯模型會差 80 倍成本
先看一個每月用量的情境。假設每月處理 2 億輸入 token 與 2000 萬輸出 token,四款模型的帳單分別是:
- Fable 5.2:2,400 美元
- Opus 5.5:1,200 美元
- Sonnet 5.5:600 美元
- Haiku 5.5:30 美元
同樣的 token 量,Fable 5.2 的成本是 Haiku 5.5 的 80 倍。再看一個更貼近產品的情境。假設客服工單分類每天 10 萬次,每次輸入 3,000 token、輸出 500 token,一個月 30 天:
- Fable 5.2:約 132,000 美元,每次請求 0.044 美元
- Opus 5.5:約 66,000 美元,每次請求 0.022 美元
- Sonnet 5.5:約 33,000 美元,每次請求 0.011 美元
- Haiku 5.5:約 1,650 美元,每次請求 0.0006 美元
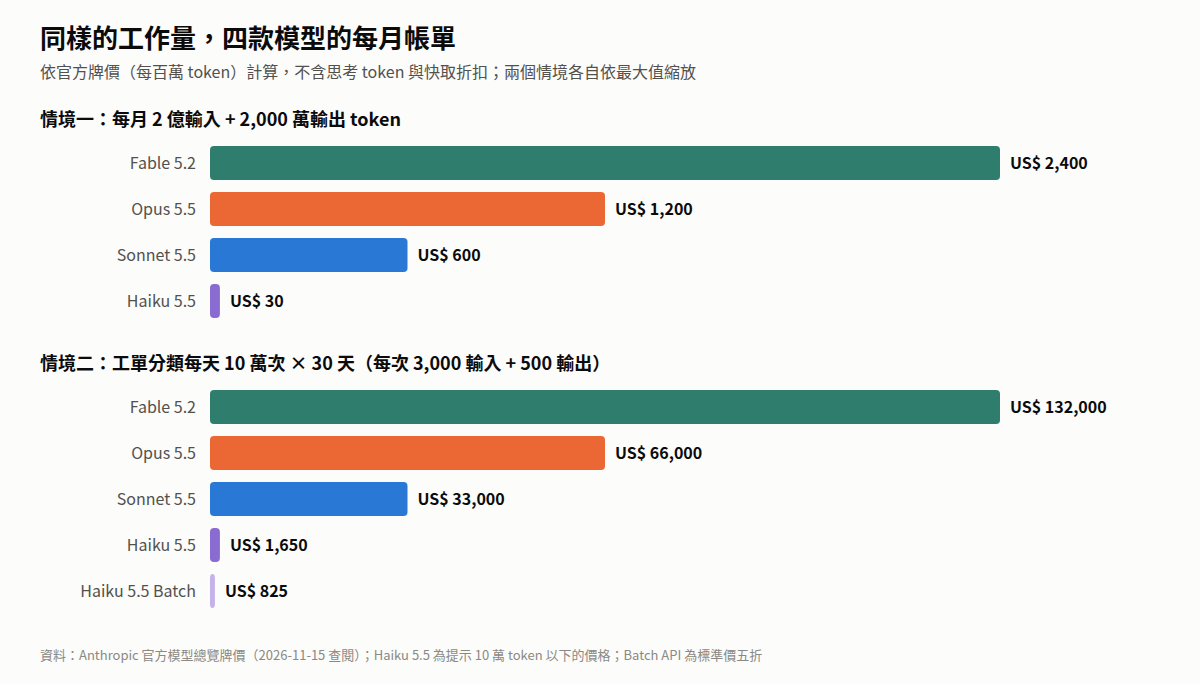
若這批分類工作改用 Batch API,Haiku 5.5 的月成本會降到約 825 美元。反過來說,把一個只要判斷帳單或技術問題的請求送給 Fable 5.2,等於用研究預算做關鍵字比對。這就是選型最常見的浪費。
要提醒的是,上面的試算只算了看得見的輸出。四款模型預設都會思考,思考 token 以輸出價計費,effort 越高思考越多,實際帳單會高於純文字估算。CyberQ 先前實測 Haiku 5.5 時,預設 effort 下的費用約是關閉思考時的 3.5 倍,因此試算時要用實際 usage 數字校正,而不是只看回覆長度。
決策流程:先問四個問題
把官方指引轉成流程,順序如下。
- 任務是否開放式、需要長時間推理與數十個步驟?是的話用 Fable 5.2,並且只在 Opus 5.5 提高 effort 後成績仍不足時才啟用。
- 是否為每天都要做的知識工作或程式開發?是的話從 Opus 5.5 起步,先建立 eval 題庫,再決定是否需要升級。
- 瓶頸是否在回覆速度或方案用量?是的話改用 Sonnet 5.5,它對多數任務仍有不錯表現,但用量負擔明顯較低。
- 是否是後端自動化、請求量大、每題只需要判斷或抽取?是的話用 Haiku 5.5。
實務上不要從最強模型往下砍,而是從最低成本的模型往上試。先定義可接受的品質線,再用 eval 確認每一階是否達標。這樣每一次升級都有資料依據,帳單也能對應到具體功能。
effort 是比換模型更細的控制項
官方提供 Effort 參數說明,透過 output_config.effort 設定,等級包含 low、medium、high、xhigh 與 max。Opus 5.5 與 Haiku 5.5 的預設值是 medium,Fable 5.2 與 Sonnet 5.5 的預設值是 high。
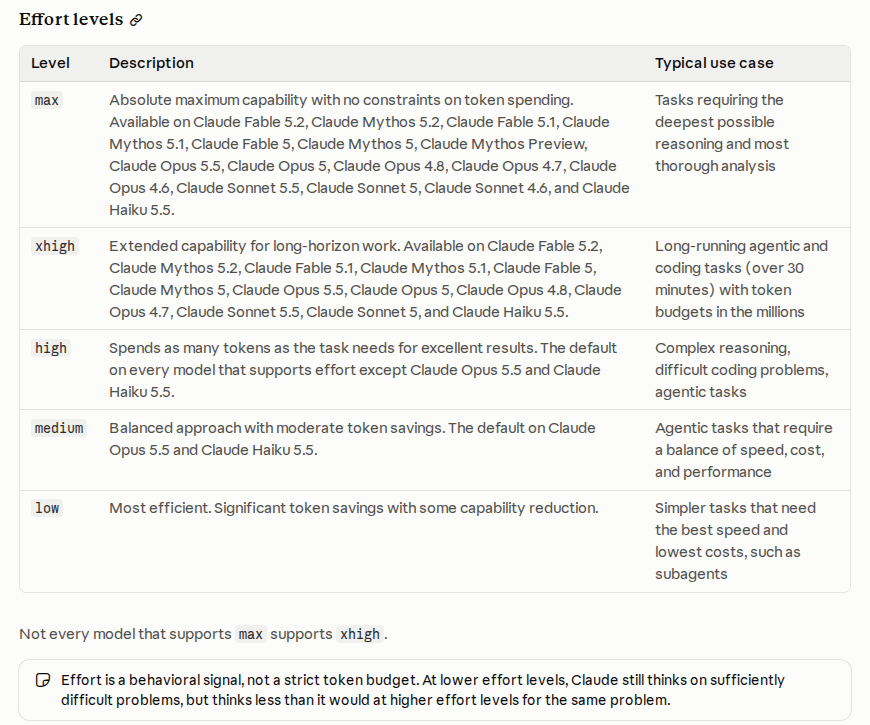
Fable 5.2 的 adaptive thinking 永遠開啟,不能送出 disabled 關閉,effort 因此成為控制思考深度、延遲與成本的主要手段。官方建議先從 high 開始,只有在實測確認有增益時才升到 xhigh,時間與 token 都不設限的少數任務才用 max。Opus 5.5 同樣不能關閉思考,要省成本就調低 effort。
Haiku 5.5 做高流量短請求時建議用 low,需要嚴格遵循指令或處理較長的代理任務時才升到 high。要注意 thinking 的 token 會計入 max_tokens,設定上限時必須留給思考的空間。此外,effort 是行為訊號,不是嚴格的 token 預算,低 effort 不代表模型不會思考。
API 串接實作:用 Haiku 5.5 做分類與路由
以下範例使用官方 Python SDK,先安裝套件並設定金鑰。
pip install anthropic
export ANTHROPIC_API_KEY="你的金鑰"
完整程式如下,存成 ticket_router.py。和直接請模型「只輸出 JSON」再用 json.loads 解析相比,這裡有三個做法值得大家借鏡。第一,用 output_config.format 的結構化輸出指定 JSON Schema,category 與 urgency 用 enum 限定,API 保證回傳合法 JSON,不會出現模型把 JSON 包在程式碼區塊裡導致解析失敗的情況。第二,effort 與 format 都放在同一個 output_config 裡。第三,先檢查 stop_reason,遇到 refusal(安全分類器拒答)或 max_tokens(輸出被截斷)時不去解析內容,直接交給下一階處理。
import json
import anthropic

client = anthropic.Anthropic()

SYSTEM = (
    "你是客服工單分類器。依工單內容判斷類別與急迫程度。"
    "category:billing 帳單付款、technical 技術故障、account 帳號登入與權限、other 其他。"
    "urgency:high 服務中斷或金錢損失、normal 影響使用但有替代方案、low 一般詢問。"
    "confidence 是 0 到 1 的數字,代表你對 category 的把握。"
)

SCHEMA = {
    "type": "object",
    "properties": {
        "category": {"type": "string", "enum": ["billing", "technical", "account", "other"]},
        "urgency": {"type": "string", "enum": ["low", "normal", "high"]},
        "confidence": {"type": "number"},
    },
    "required": ["category", "urgency", "confidence"],
    "additionalProperties": False,
}

# 每百萬 token 美元單價(輸入, 輸出);Haiku 5.5 為 10 萬 token 以下的價格
PRICE = {
    "claude-haiku-5-5": (0.10, 0.50),
    "claude-sonnet-5-5": (2.00, 10.00),
    "claude-opus-5-5": (4.00, 20.00),
}


def run_classifier(model, effort, ticket_text):
    resp = client.messages.create(
        model=model,
        max_tokens=4096,
        system=SYSTEM,
        messages=[{"role": "user", "content": ticket_text}],
        output_config={
            "effort": effort,
            "format": {"type": "json_schema", "schema": SCHEMA},
        },
    )
    usage = resp.usage
    p_in, p_out = PRICE[model]
    cost = (usage.input_tokens * p_in + usage.output_tokens * p_out) / 1e6
    meta = {"model": model, "effort": effort, "stop_reason": resp.stop_reason,
            "input_tokens": usage.input_tokens, "output_tokens": usage.output_tokens,
            "cost_usd": cost}
    if resp.stop_reason != "end_turn":
        # refusal 或 max_tokens:沒有可用的 JSON,交給下一階或人工
        return None, meta
    text = next(b.text for b in resp.content if b.type == "text")
    return json.loads(text), meta


MODEL_LADDER = [
    ("claude-haiku-5-5", "low"),
    ("claude-sonnet-5-5", "medium"),
    ("claude-opus-5-5", "high"),
]


def classify(ticket_text, min_confidence=0.8):
    trail = []
    for model, effort in MODEL_LADDER:
        result, meta = run_classifier(model, effort, ticket_text)
        trail.append(meta)
        if result and result["confidence"] >= min_confidence:
            return {"route": model, "result": result, "trail": trail}
    return {"route": "human_review", "result": result, "trail": trail}
run_classifier 負責單次分類並依 usage 換算成本,classify 是升級階梯,低成本的模型先處理,只有在信心不足時才往上升,每一階都記錄模型、effort 與 token 用量,方便日後核帳。三階都過不了門檻的工單交給人工,而不是再丟給 Fable 5.2;分類這種答案空間只有四個選項的任務,問題通常出在工單本身資訊不足,換更強的模型也猜不出來。
CyberQ 實跑結果
我們用 8 筆自擬的中文工單實際執行上面的程式(2026 年 11 月 15 日,Claude API,anthropic Python SDK 0.85.0)。先只用 Haiku 5.5 搭配 effort low 分類:
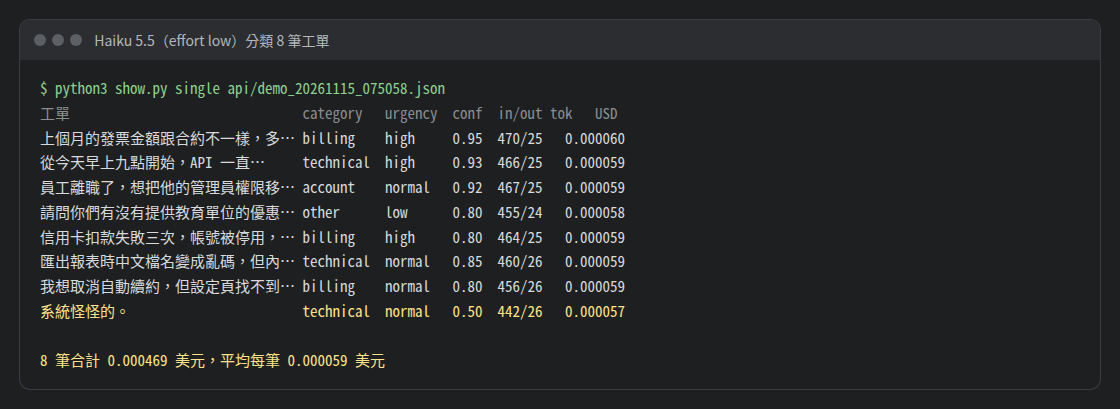
8 筆全部回傳合法 JSON,分類結果與我們的人工判斷相符;其中「扣款失敗導致帳號停用」同時涉及帳單與帳號,模型歸為 billing 並只給 0.80 的信心。每筆約 460 個輸入 token、25 個輸出 token,平均每筆 0.000059 美元。effort low 下這批短工單的輸出 token 幾乎都是 JSON 本身。唯一資訊不足的「系統怪怪的。」,Haiku 5.5 自己給出 0.50 的低信心,這正是升級階梯要攔下的個案。
接著用同一批工單跑升級階梯,門檻設為 0.8:
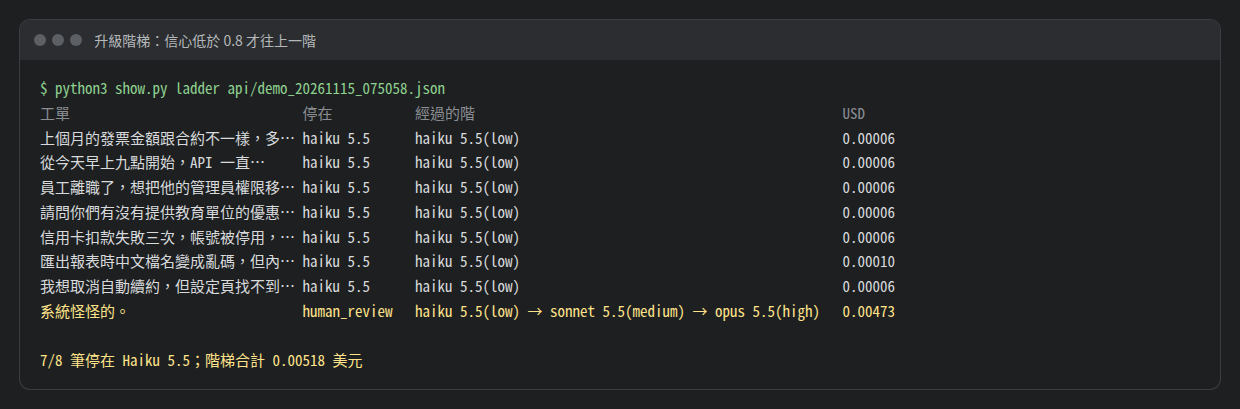
7 筆停在 Haiku 5.5,每筆約 0.00006 美元;「系統怪怪的。」依序經過 Sonnet 5.5 與 Opus 5.5 仍然拿不到 0.8 以上的信心,最後轉人工,這一筆就花了 0.00473 美元,約是其他工單的 80 倍。整批 16 次呼叫(單階加階梯)總共不到 0.006 美元。
這個結果也暴露了階梯設計的弱點:模型自己報的 confidence 並沒有經過校準。這批工單有 3 筆的信心剛好是 0.80,門檻寫成 >= 時 7 筆停在 Haiku,改成 > 就只剩 4 筆,另外 3 筆都會往上升,而以這次實跑的用量計,Sonnet 5.5 一次約是 Haiku 5.5 的 20 倍,Opus 5.5 又是 Sonnet 5.5 的 3 倍。
CyberQ 指出,門檻不能憑感覺設,要用有正確答案的 eval 題庫去量:在不同門檻下統計正確率與升級比例,再挑一個兩者都能接受的值。停在第一階的比例也完全取決於你的工單組成,這 8 筆的 7/8 只是示範,不能直接當成產品的估算基礎。
拒答備援:Sonnet 5.5 與 Opus 5.5 可以開,Haiku 5.5 沒有
本文的四款模型都有安全分類器,可能拒絕某些請求。拒答不會以錯誤回報,API 回 HTTP 200,但 stop_reason 是 refusal。一般客服工單幾乎碰不到,但資安、生醫相關的內容偶爾會被誤判。Sonnet 5.5 與 Opus 5.5 可以開啟伺服器端備援(server-side fallbacks),請求被拒時,API 會在同一次呼叫內改用備援模型重跑,程式不必自己重送。
開法是改走 beta 端點,加上 server-side-fallback-2026-07-01 標頭並設定 fallbacks: "default",由官方依拒答類別挑選備援模型,不必自己維護清單。每款模型能退到哪裡,可以帶同一個 beta 標頭向 Models API 查詢 allowed_fallback_models:
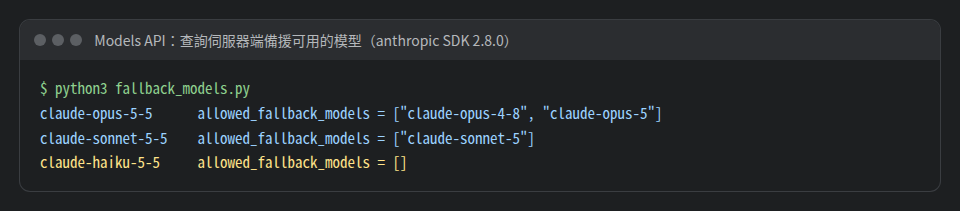
Haiku 5.5 的清單是空的。實測時對它送出 fallbacks 參數不會報錯,但沒有模型可以接手,等於沒有作用。所以 Haiku 5.5 被拒答時只能靠自己的程式處理,這正是前面升級階梯在做的事:第一階拿不到結果,就往 Sonnet 5.5 送。
要讓階梯的第二、三階也有備援,把 ticket_router.py 裡的 run_classifier 換成下面的版本,classify 與其他部分不用改:
PRICE.update({
    "claude-sonnet-5": (2.00, 10.00),
    "claude-opus-5": (5.00, 25.00),
    "claude-opus-4-8": (5.00, 25.00),
})


def run_classifier(model, effort, ticket_text):
    extra = {}
    if model != "claude-haiku-5-5":  # Haiku 5.5 沒有可用的備援模型
        extra = {"betas": ["server-side-fallback-2026-07-01"], "fallbacks": "default"}
    resp = client.beta.messages.create(
        model=model,
        max_tokens=4096,
        system=SYSTEM,
        messages=[{"role": "user", "content": ticket_text}],
        output_config={
            "effort": effort,
            "format": {"type": "json_schema", "schema": SCHEMA},
        },
        **extra,
    )
    # 發生備援時,每一次嘗試的用量分列在 usage.iterations,各依實際執行的模型計價
    iterations = resp.usage.iterations or [resp.usage]
    cost = 0.0
    for it in iterations:
        p_in, p_out = PRICE[getattr(it, "model", None) or model]
        cost += (it.input_tokens * p_in + it.output_tokens * p_out) / 1e6
    fallback_ran = any(getattr(it, "type", "") == "fallback_message" for it in iterations)
    meta = {"model": model, "served_by": resp.model, "fallback": fallback_ran,
            "effort": effort, "stop_reason": resp.stop_reason, "cost_usd": cost}
    if resp.stop_reason != "end_turn":
        # 整條備援鏈都拒答,或輸出被截斷:交給下一階或人工
        return None, meta
    text = next(b.text for b in resp.content if b.type == "text")
    return json.loads(text), meta
這段程式有幾個細節要注意:
- SDK 版本:要用較新的 anthropic SDK。我們原本使用的 0.85.0 不認得
fallbacks參數,換成 2.8.0 才測試通過。 - 計價:回應最上層的
usage只算最後產出結果的那一次。發生備援時,每一次嘗試的用量分列在usage.iterations,要依實際執行的模型逐筆計價。Opus 4.8 與 Opus 5 的牌價是輸入 5、輸出 25 美元,比 Opus 5.5 貴。被拒答、尚未輸出的那次嘗試是否計費,以官方〈How refusals are billed〉說明為準。 - 判斷是否走了備援:看
usage.iterations裡有沒有fallback_message,回應的model欄位則是實際提供結果的模型。日誌要記下這兩項,否則帳單和品質都對不上。 - 適用範圍:Batch API 不接受這個參數。Amazon Bedrock、Vertex AI 與 Microsoft Foundry 沒有伺服器端備援,要改用 SDK 的用戶端中介層
BetaRefusalFallbackMiddleware。 - 整條鏈都拒答:備援模型本身也可能拒答。最後仍然是
refusal,代表整條鏈都拒絕,程式會回傳None,交給下一階或人工。
我們把這個版本換進階梯,用 SDK 2.8.0 重跑兩筆工單:「API 一直回 502」停在 Haiku 5.5,「系統怪怪的。」走完三階後轉人工,結果與原版一致,Sonnet 5.5 與 Opus 5.5 都正常接受備援參數。要說明的是,一般工單不會觸發拒答,所以這次沒有實際走到備援模型。我們驗證的是參數可用、階梯照常運作,以及沒有發生備援時成本計算與原版相同。
上線前的檢查清單
- 為每個任務建立自己的 eval 題庫,記錄正確率,不要用通用 benchmark 決定模型。升級階梯的信心門檻也要用同一份題庫校正。
- 高流量且可延遲的批次工作改用 Batch API,價格直接砍半。
- 固定不變的 system prompt 與工具定義可搭配 prompt caching 降低重複輸入成本。要注意快取有最小前綴長度,像本文範例這樣只有幾百 token 的 system prompt 不會被快取,要等提示變長之後才有效果。
- 明確設定 effort,不要依賴預設值,並在日誌記錄模型 ID、effort 與
usage。 - 處理
stop_reason:refusal與max_tokens都不能當成正常結果解析。Sonnet 5.5 與 Opus 5.5 可再開伺服器端備援,Haiku 5.5 只能靠自己的程式升級或轉人工。 - 升級路徑要有人工覆核或 fallback,避免單一模型的判斷直接送到使用者。
- Haiku 5.5 的提示超過 10 萬 token 會整筆改收高價,長文件任務要先估算提示長度。
- 追蹤官方退役時間。依官方模型淘汰頁,四款的退役時間都「不早於」2027 年:Opus 5.5 為 2027 年 9 月 22 日、Sonnet 5.5 為 2027 年 9 月 28 日、Haiku 5.5 為 2027 年 10 月 7 日、Fable 5.2 為 2027 年 11 月 9 日,提前安排遷移測試。
可驗證的流程
CyberQ 提醒,官方指引的價值不在於背下四個名字,而在於把它變成可驗證的流程。先用 eval 定義品質線,從最低成本的模型開始,只有在實測結果顯示不足時才升級。這樣每一個升級都有依據,成本也看得見,模型選擇才不會變成一場憑感覺的猜謎。