NVIDIA Sync 這次更新(0.148.0-153)在設定視窗加入兩個新分頁,Clusters(Cluster Assistant 叢集精靈)與 Models(Beta)。前者把 2 到 4 台 DGX Spark 或 GB10 裝置透過 ConnectX-7(CX-7)串成叢集的流程做成精靈,後者則在叢集上直接下載並啟動 NVIDIA 驗證過的模型配方,最後再幫使用者把 OpenCode 接到這個模型上,不少開發者注意到 NVIDIA 這次的更新,協助讓更多人佈署叢集的能更簡單,並預設給了 NVIDIA 官方認證過可以順跑的 Qweb 3.8 27B NVFP4 模型。
CyberQ 以實驗室裡兩台已用 200GbE 線材直連的 DGX Spark 完整走過一遍,並在部署完成後測試 API 相容性、效能、OpenCode 實作、區網開放與 API 金鑰功能,同時拆解 Sync 實際在主機上做了哪些事。
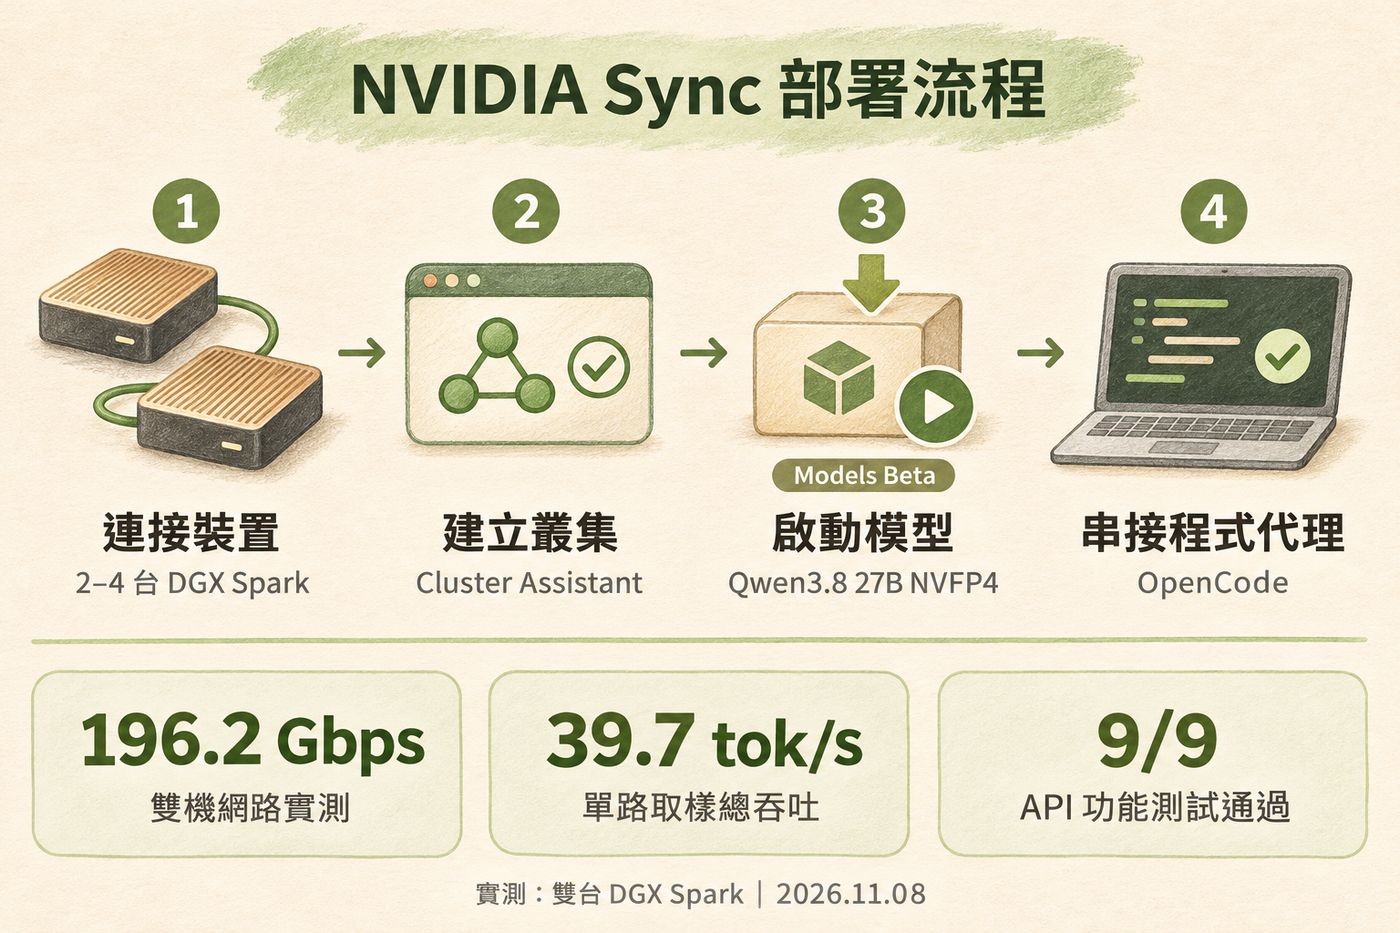
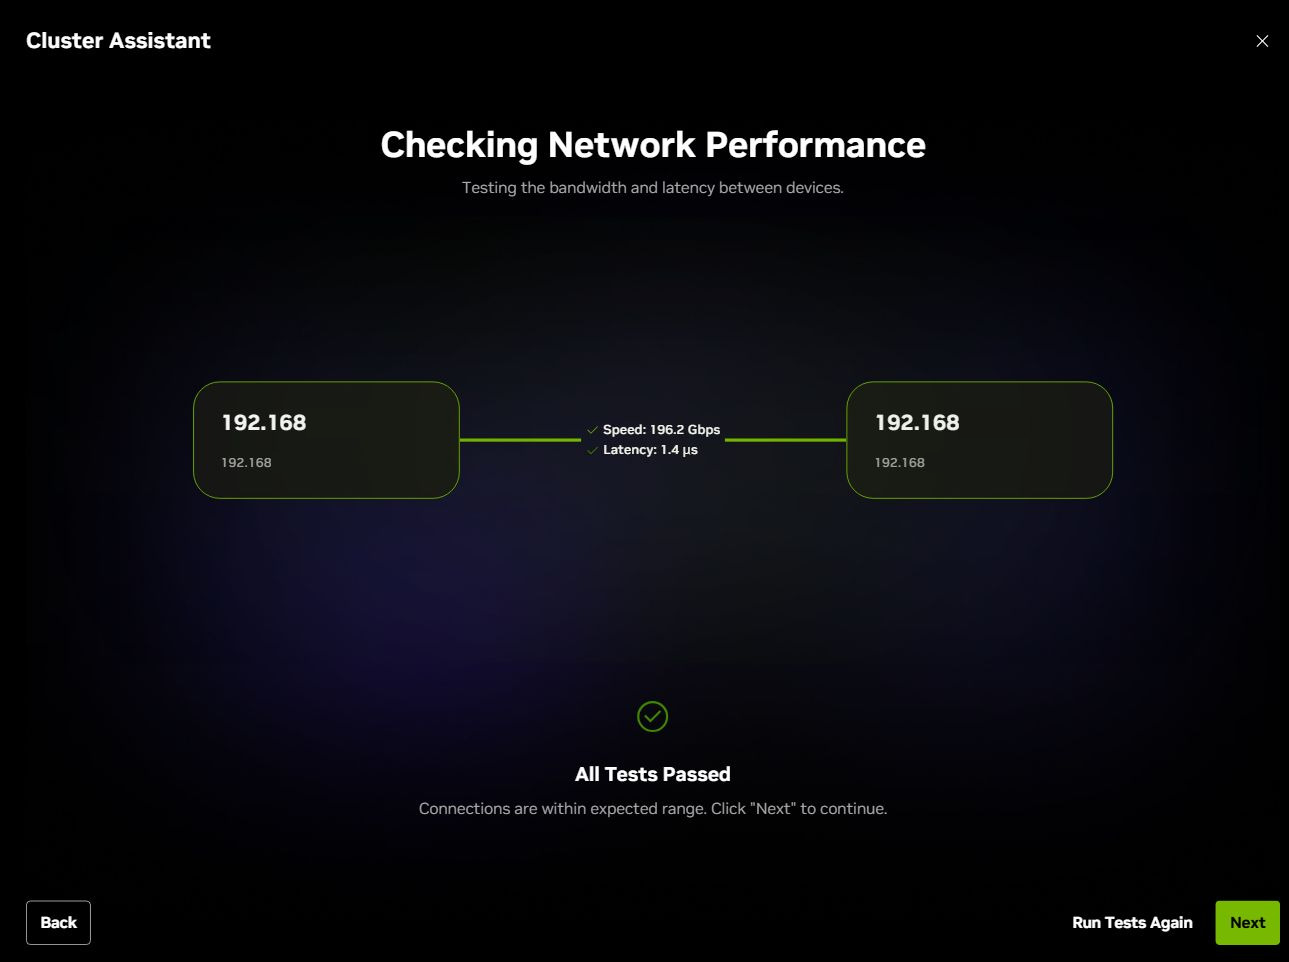
CyberQ 測試了網路設定、頻寬測試與節點間 SSH 互信。既有的 CX-7 設定正確時不會變更網路,實測鏈路 196.2 Gbps、延遲 1.4 µs。針對兩台 128 GB 叢集推薦 Qwen3.8 27B NVFP4,以 vLLM 張量平行(TP=2)跨兩台執行,並搭配 DFlash2 投機解碼與 262,144 token 上下文。
實測效能為單一請求貪婪解碼 48.0 tok/s、取樣 39.7 tok/s,8 路平行處理總吞吐效能則分別來到 172.2 tok/s與 142.5 tok/s。
一、Cluster Assistant:九個步驟組好叢集
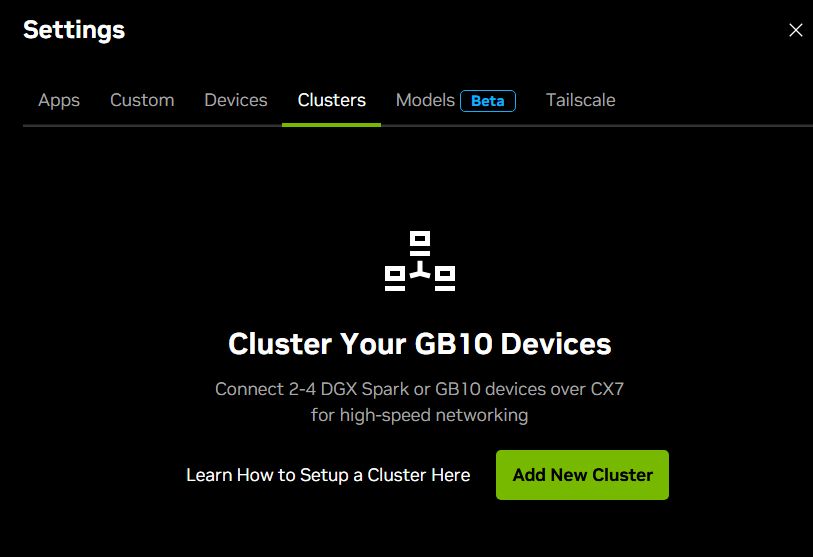
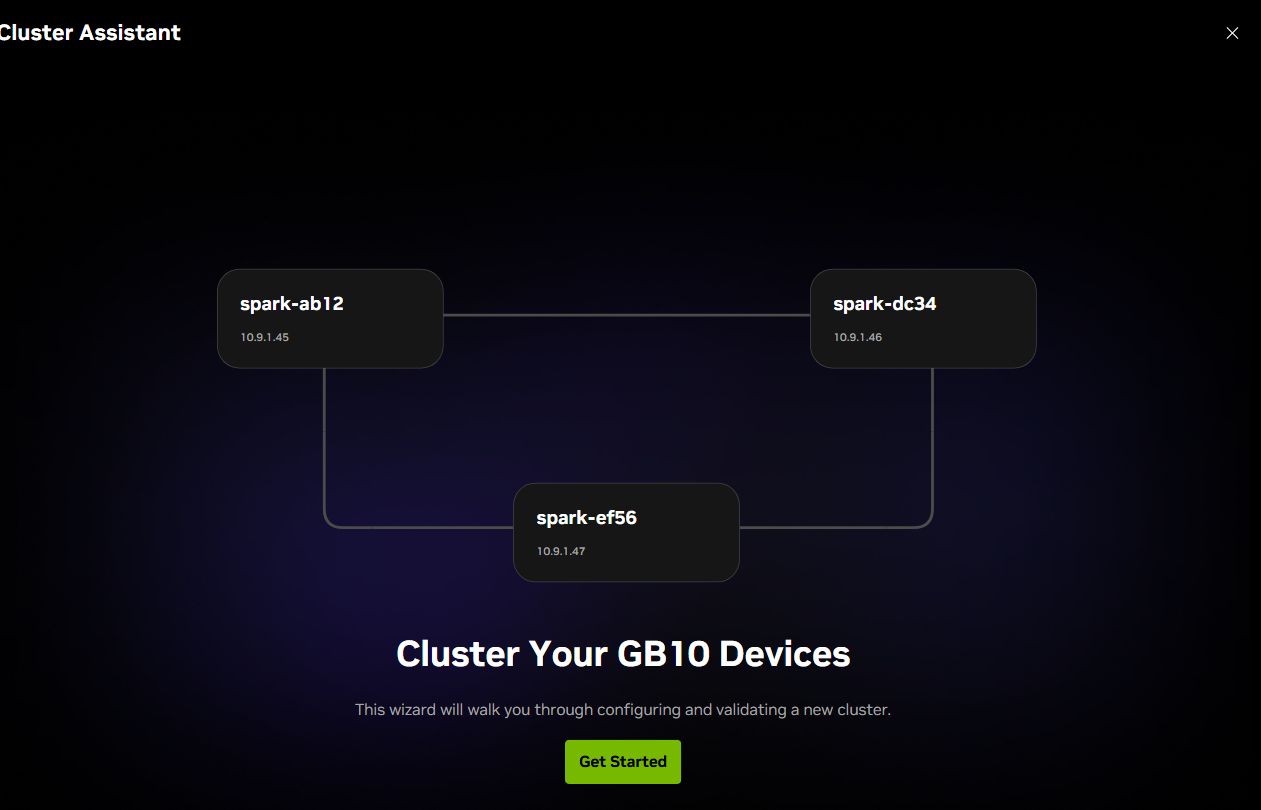
CyberQ 實測在 Sync 的 Settings 視窗中,新的 Clusters 分頁說明可以把 2 到 4 台 DGX Spark 或 GB10 裝置透過 CX-7 連成叢集,按下 Add New Cluster 即進入精靈。
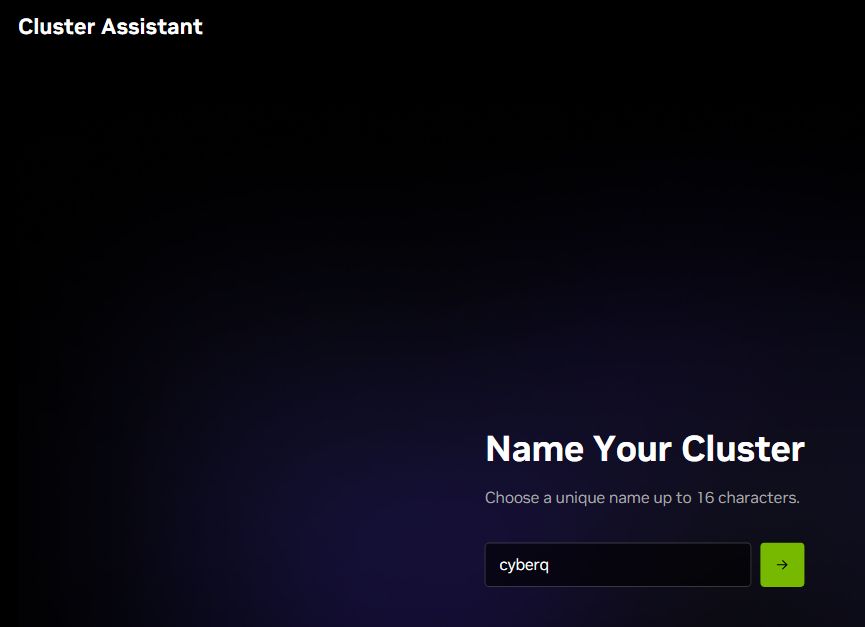
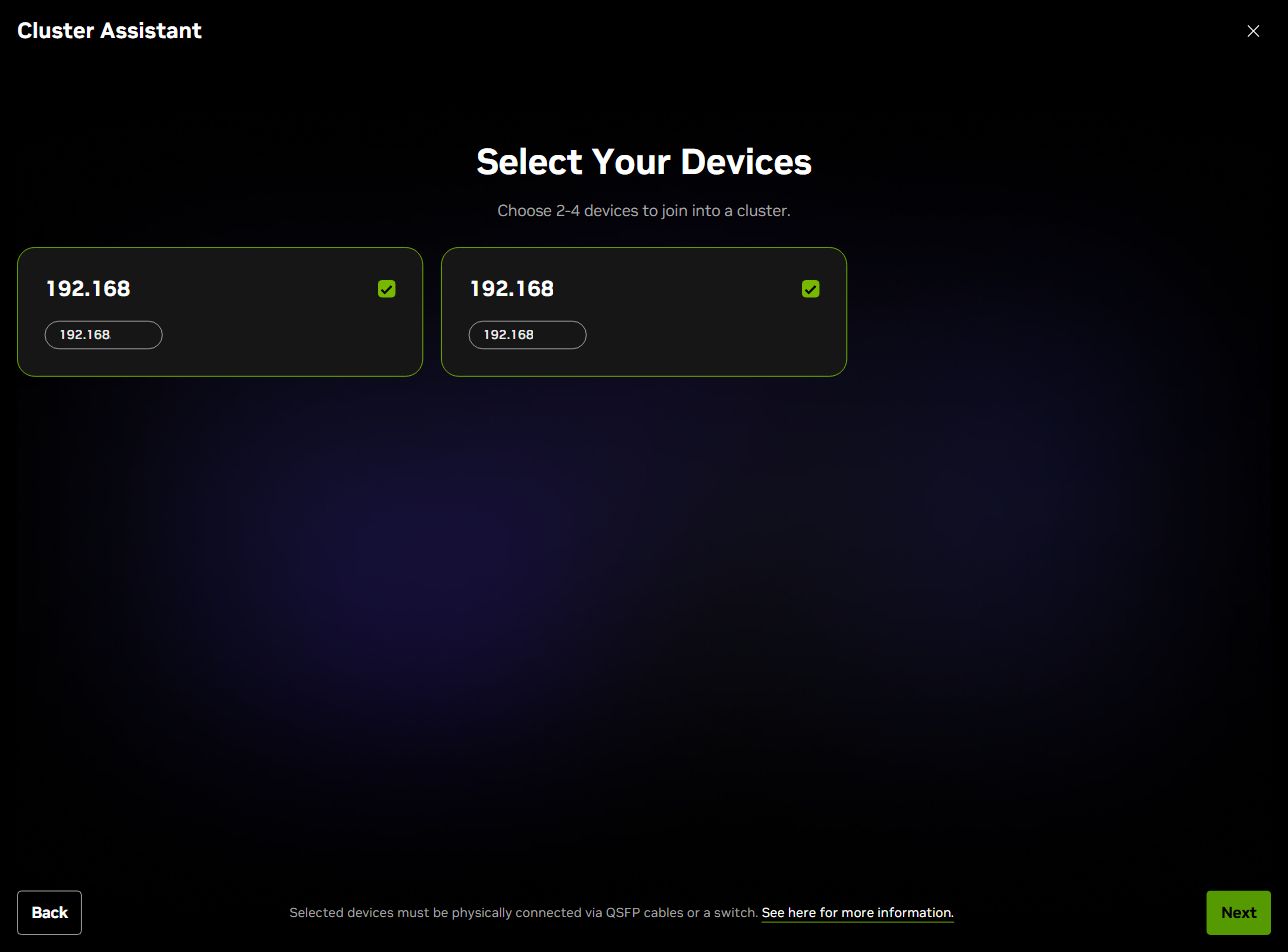
第一步是替叢集命名(16 個字元以內),接著勾選要加入的裝置。
存取檢查與 sudo
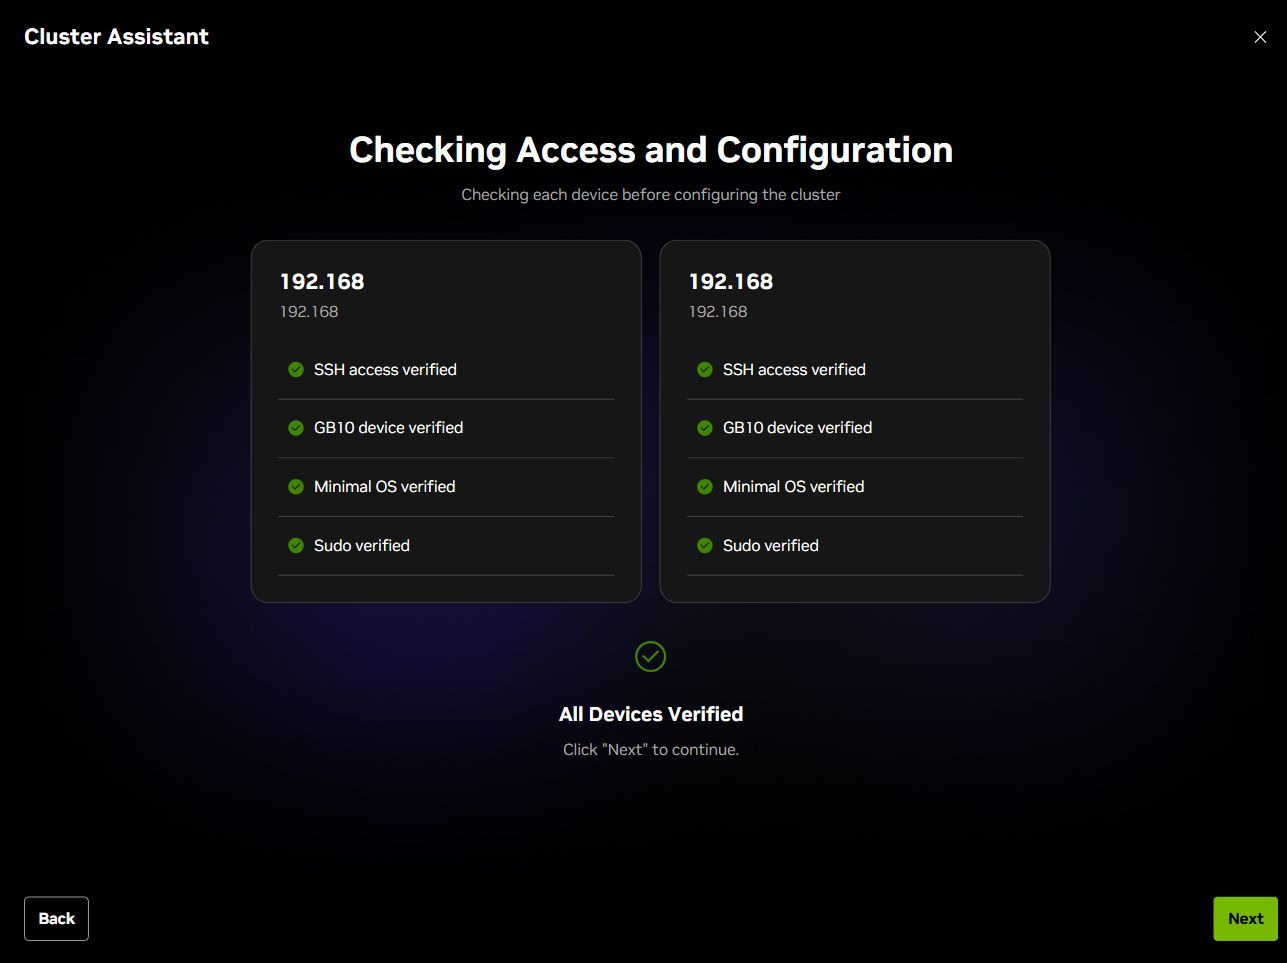
精靈會逐台確認 SSH、GB10 硬體、作業系統與 sudo 權限。我們第一次執行時兩台都卡在 Sudo access,按下 Fix It 輸入密碼後即通過。
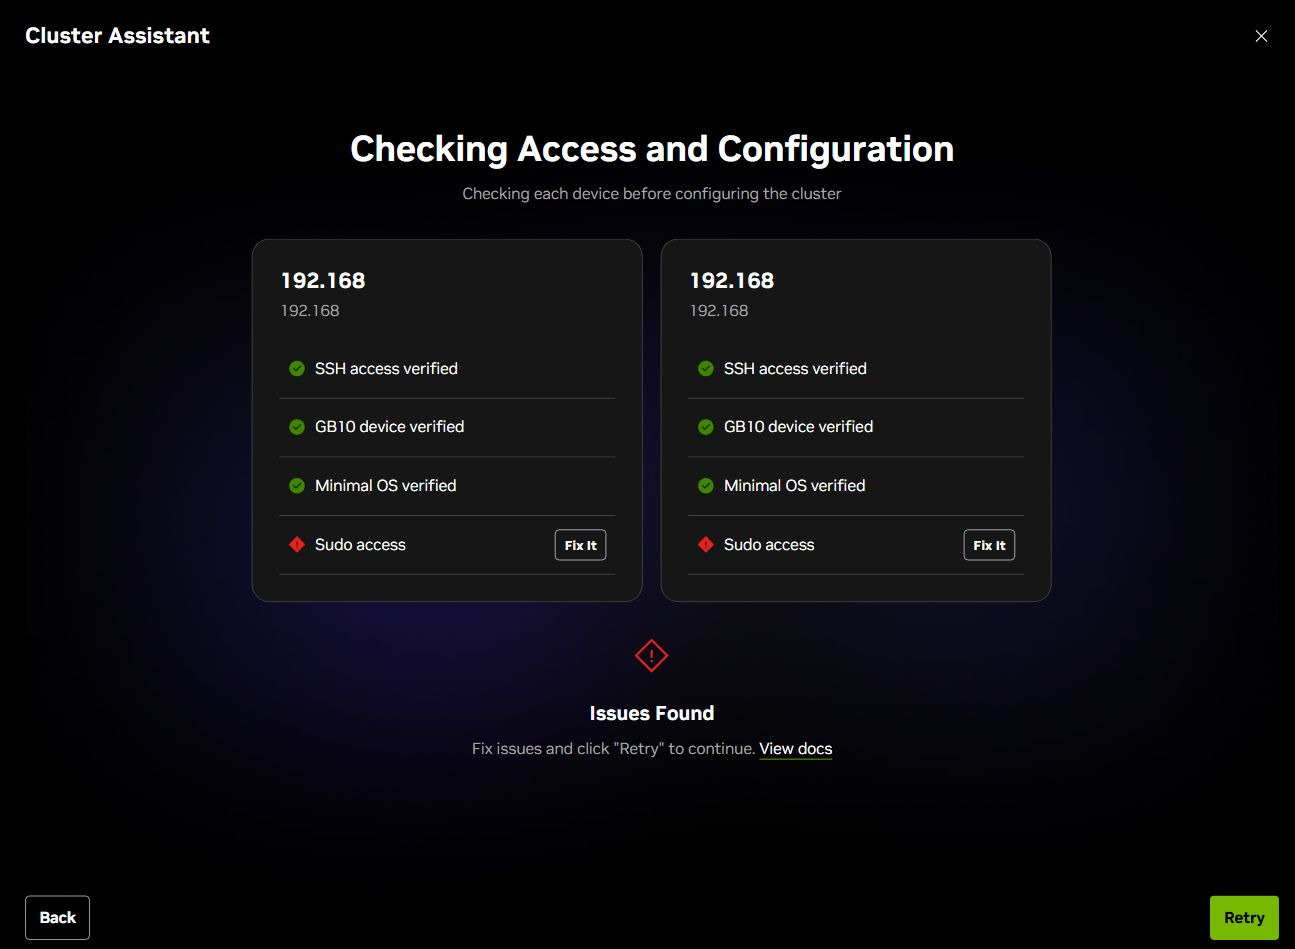
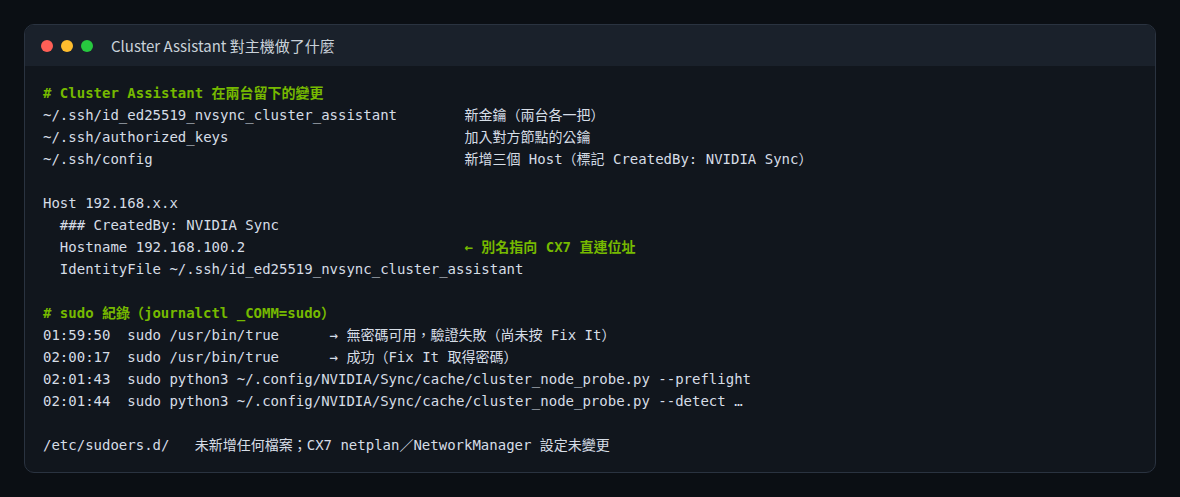
我們事後在兩台主機上比對系統紀錄,確認 Fix It 並沒有寫入任何 sudoers 規則,/etc/sudoers.d/ 也沒有新增檔案。Sync 只是在設定期間暫時使用這組密碼,以 root 身分執行它複製到 ~/.config/NVIDIA/Sync/cache/ 的 cluster_node_probe.py(Apache 2.0 授權,約 3,200 行),分別跑 --preflight 與 --detect 兩個模式,後者會以 LLDP 封包在 CX-7 介面上探測對端。這與 Sync 內附文件「sudo 密碼僅暫時使用、不保存也不記錄」的說法一致。
使用者一致性、網路設定與效能測試
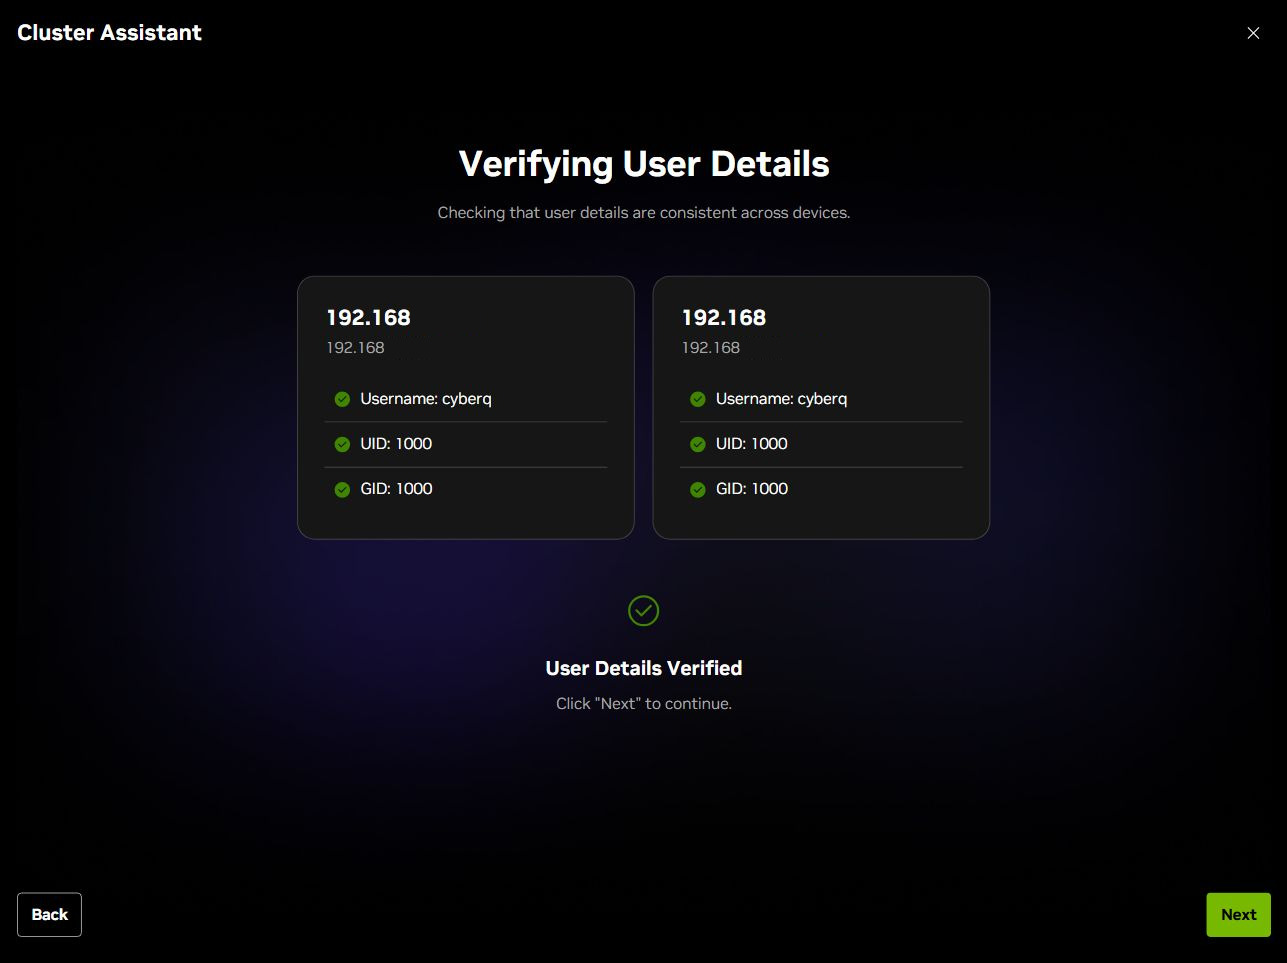
下一步檢查兩台的使用者名稱、UID 與 GID 是否一致。依 Sync 內附文件,這不是硬性條件,但不一致時共用檔案的路徑與權限會比較麻煩。
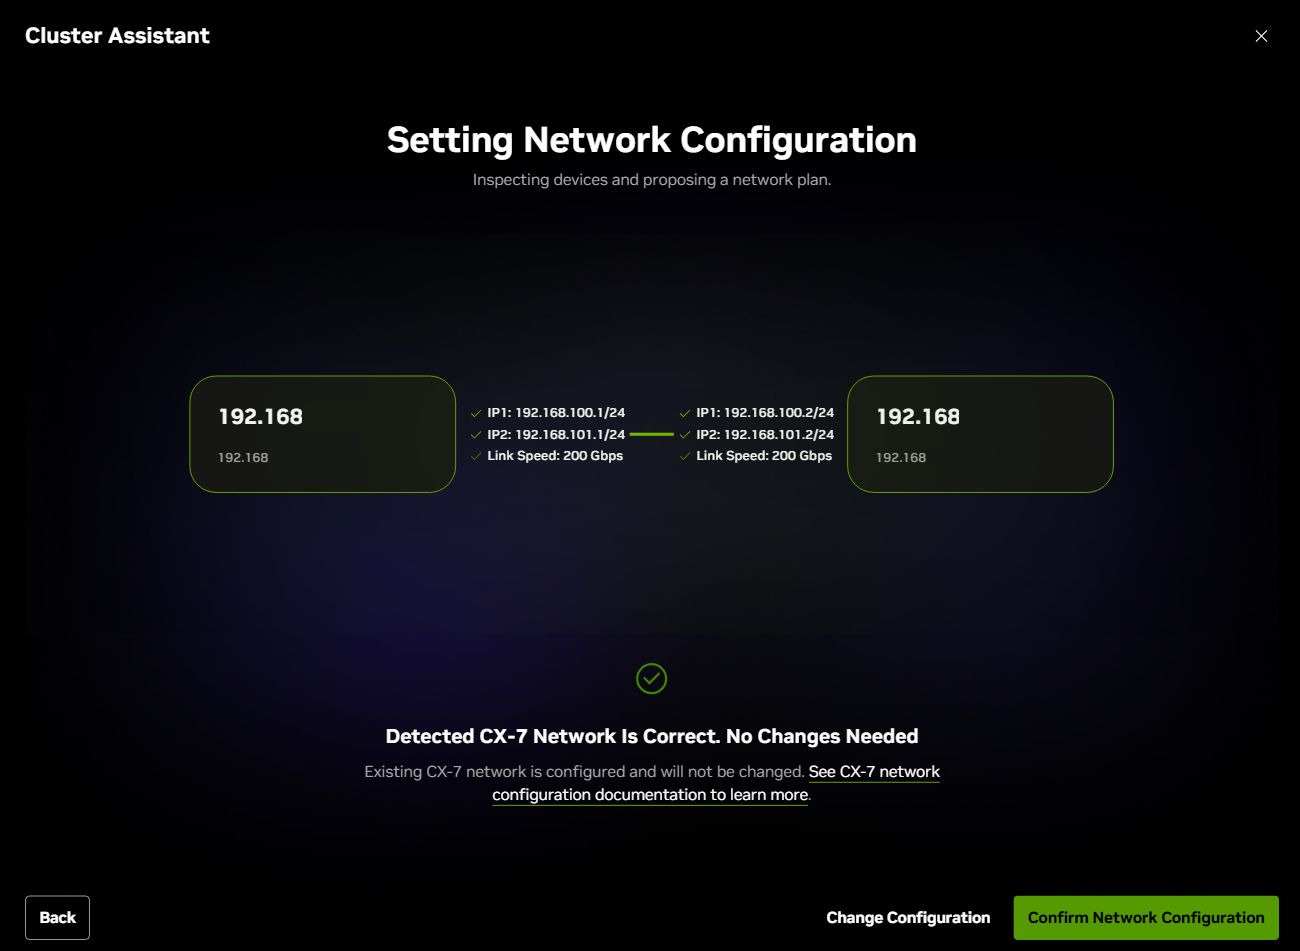
網路設定頁會偵測現況並提出設定計畫。我們的兩台早已把 CX-7 的兩個半部分別設在 192.168.100.0/24 與 192.168.101.0/24,精靈判斷「Detected CX-7 Network Is Correct. No Changes Needed」,沒有改動任何設定。事後檢查 NetworkManager 設定檔也確實沒有變動。
接著是頻寬與延遲測試,實測 196.2 Gbps、1.4 µs,與我們先前手動以 RDMA 量到的 196.1 Gb/s 幾乎相同。
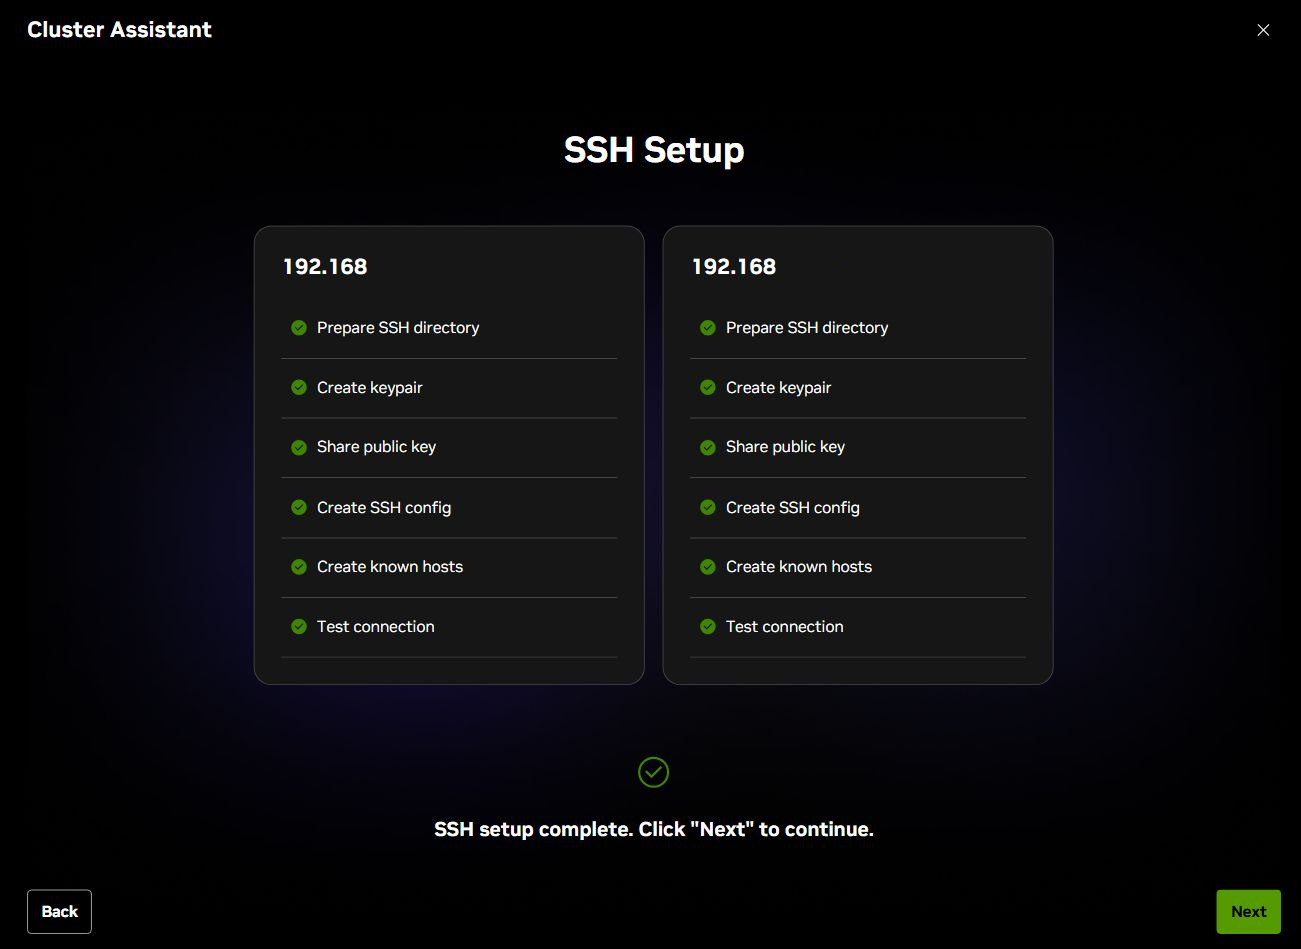
最後一步建立節點之間的 SSH 互信,產生金鑰、交換公鑰、寫入 SSH 設定與 known_hosts,並實際測試連線。完成畫面列出拓樸、裝置與兩個 CX-7 介面的位址,可以按 Save Details 存檔。
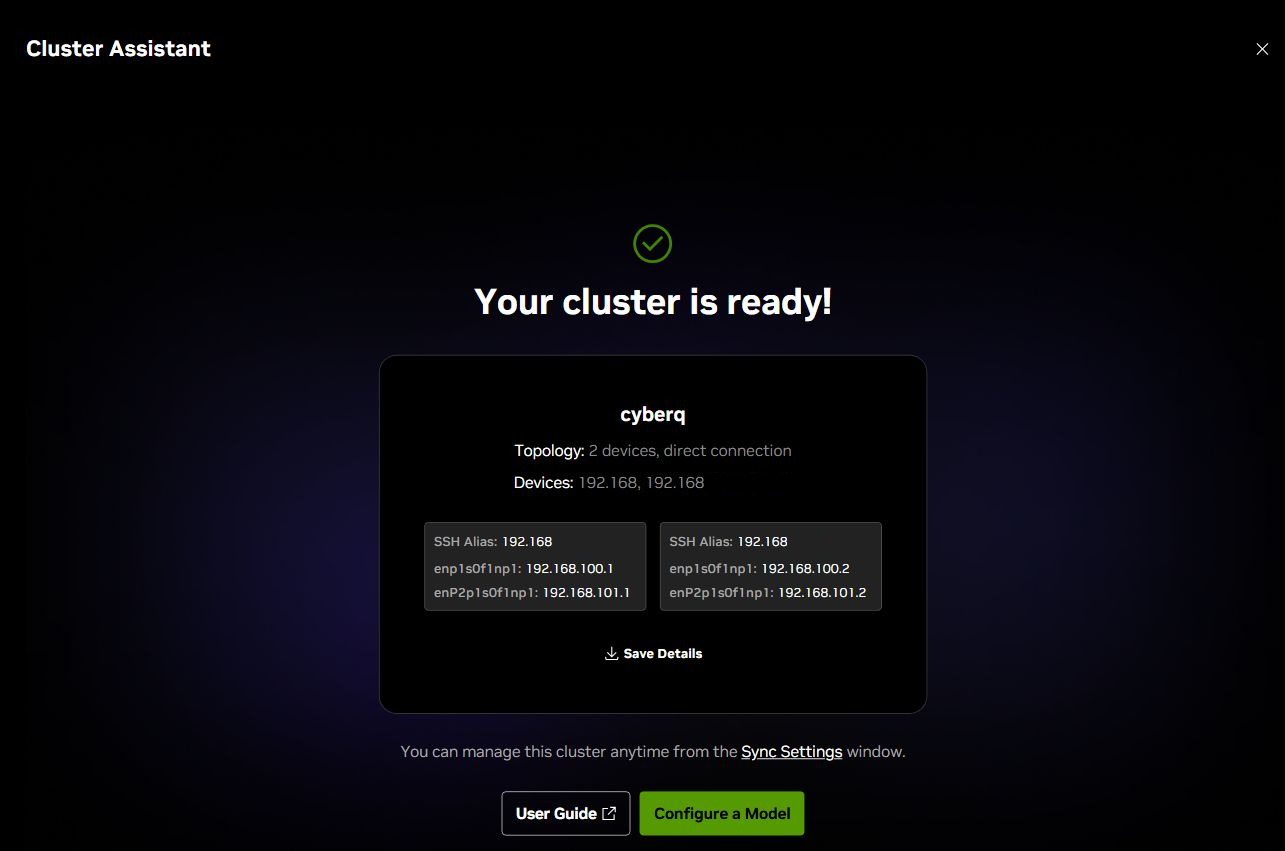
值得注意的是,Sync 寫進 ~/.ssh/config 的別名 192.168.x.x 實際指向 CX-7 直連位址 192.168.100.2。別名與目的地不同,日後排查時若只看指令很容易誤會連線走的是辦公室網段。
二、Models(Beta):一鍵部署 Qwen3.8 27B
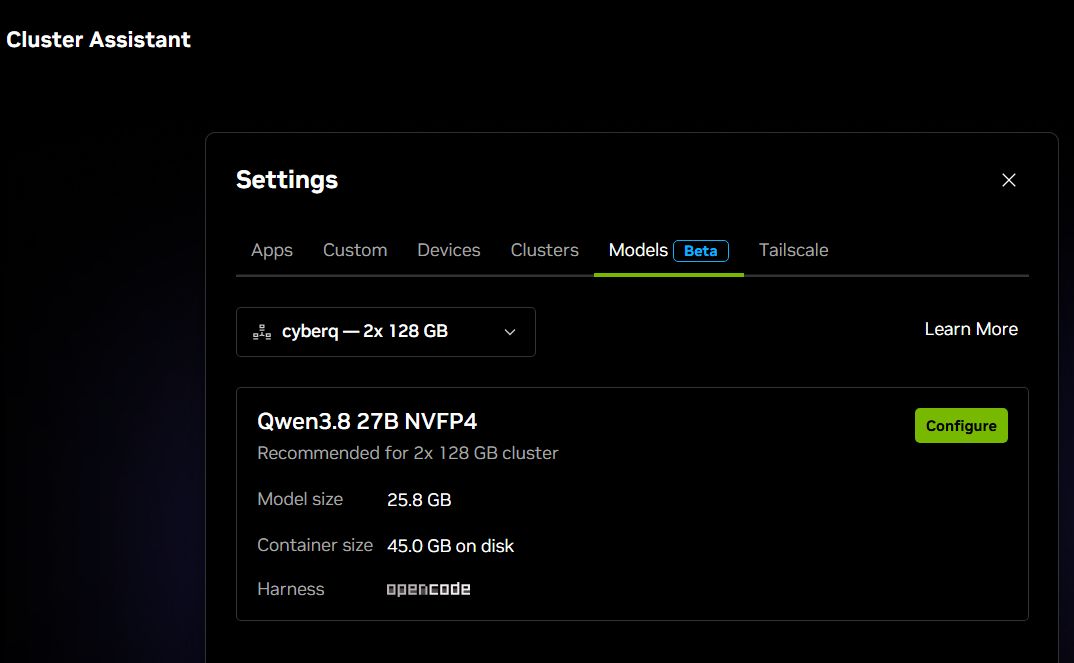
叢集完成後按 Configure a Model,Models 分頁會依叢集規模推薦模型。兩台 128 GB 的組合推薦 Qwen3.8 27B NVFP4,模型 25.8 GB、容器 45.0 GB,搭配的程式代理工具是 OpenCode。
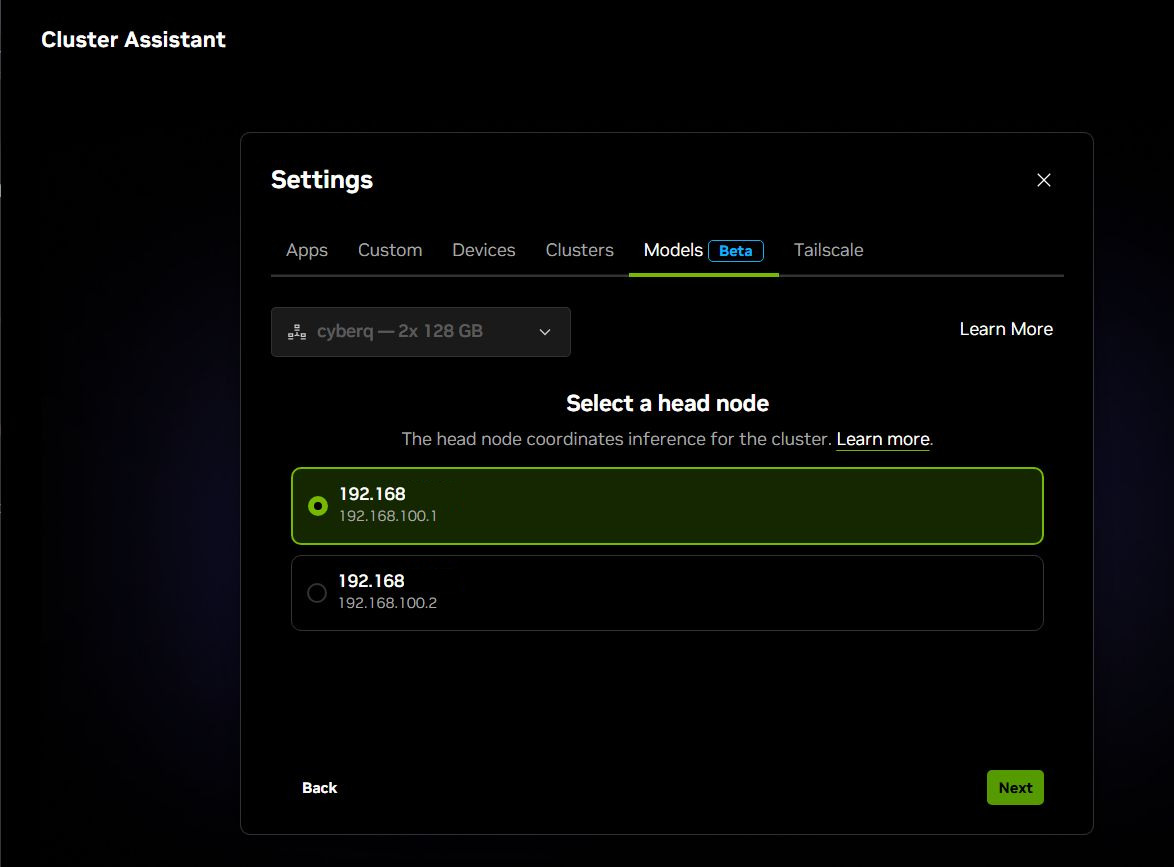
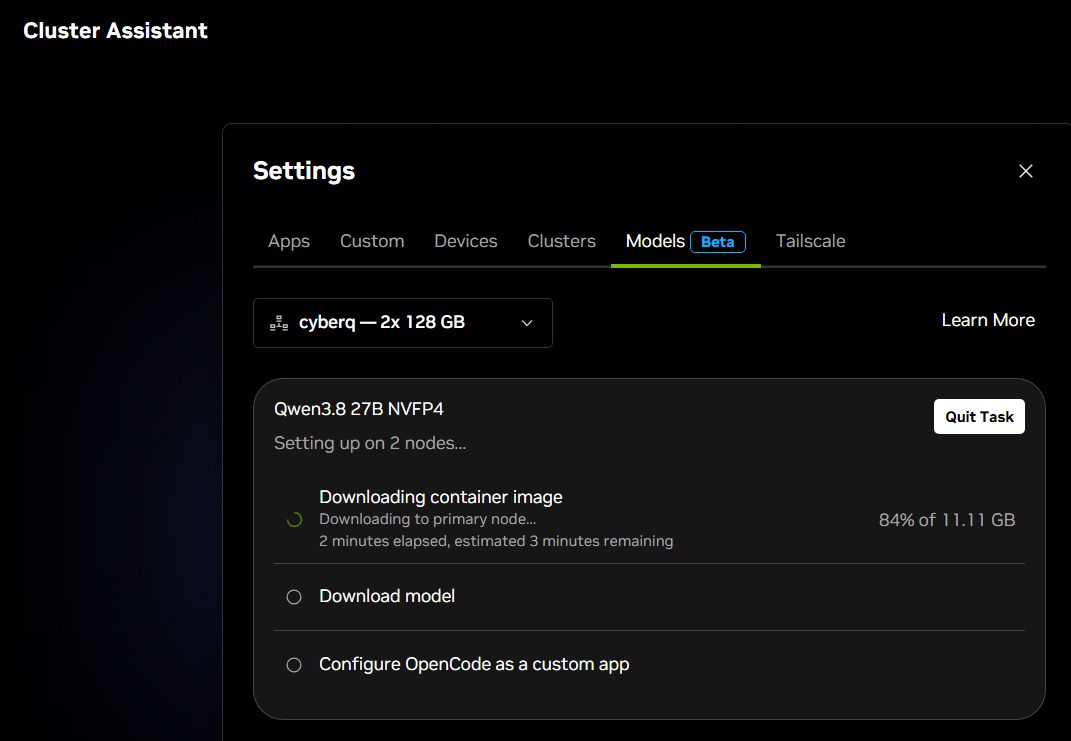
部署分三個階段,下載容器映像(11.11 GB)、下載模型,以及把 OpenCode 設定成 Sync 的自訂應用程式。完成後依畫面指示,從系統匣啟動模型,狀態由 Starting 轉為 Running,Endpoint 顯示為 http://127.0.0.1:18765/v1。
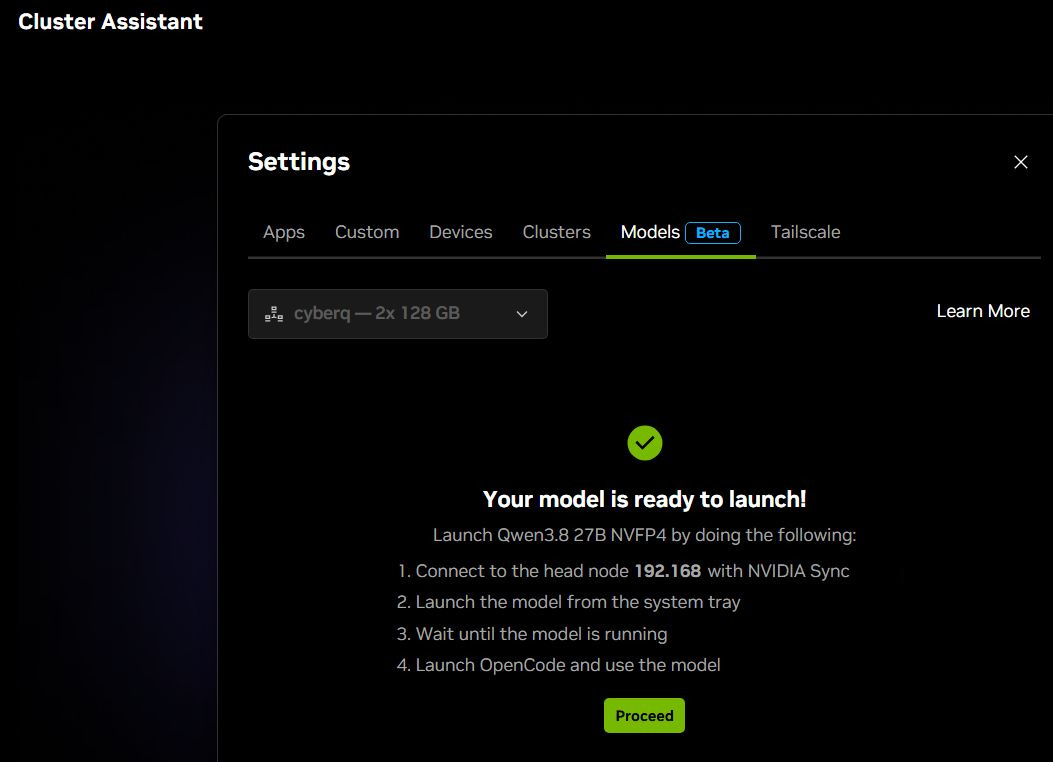
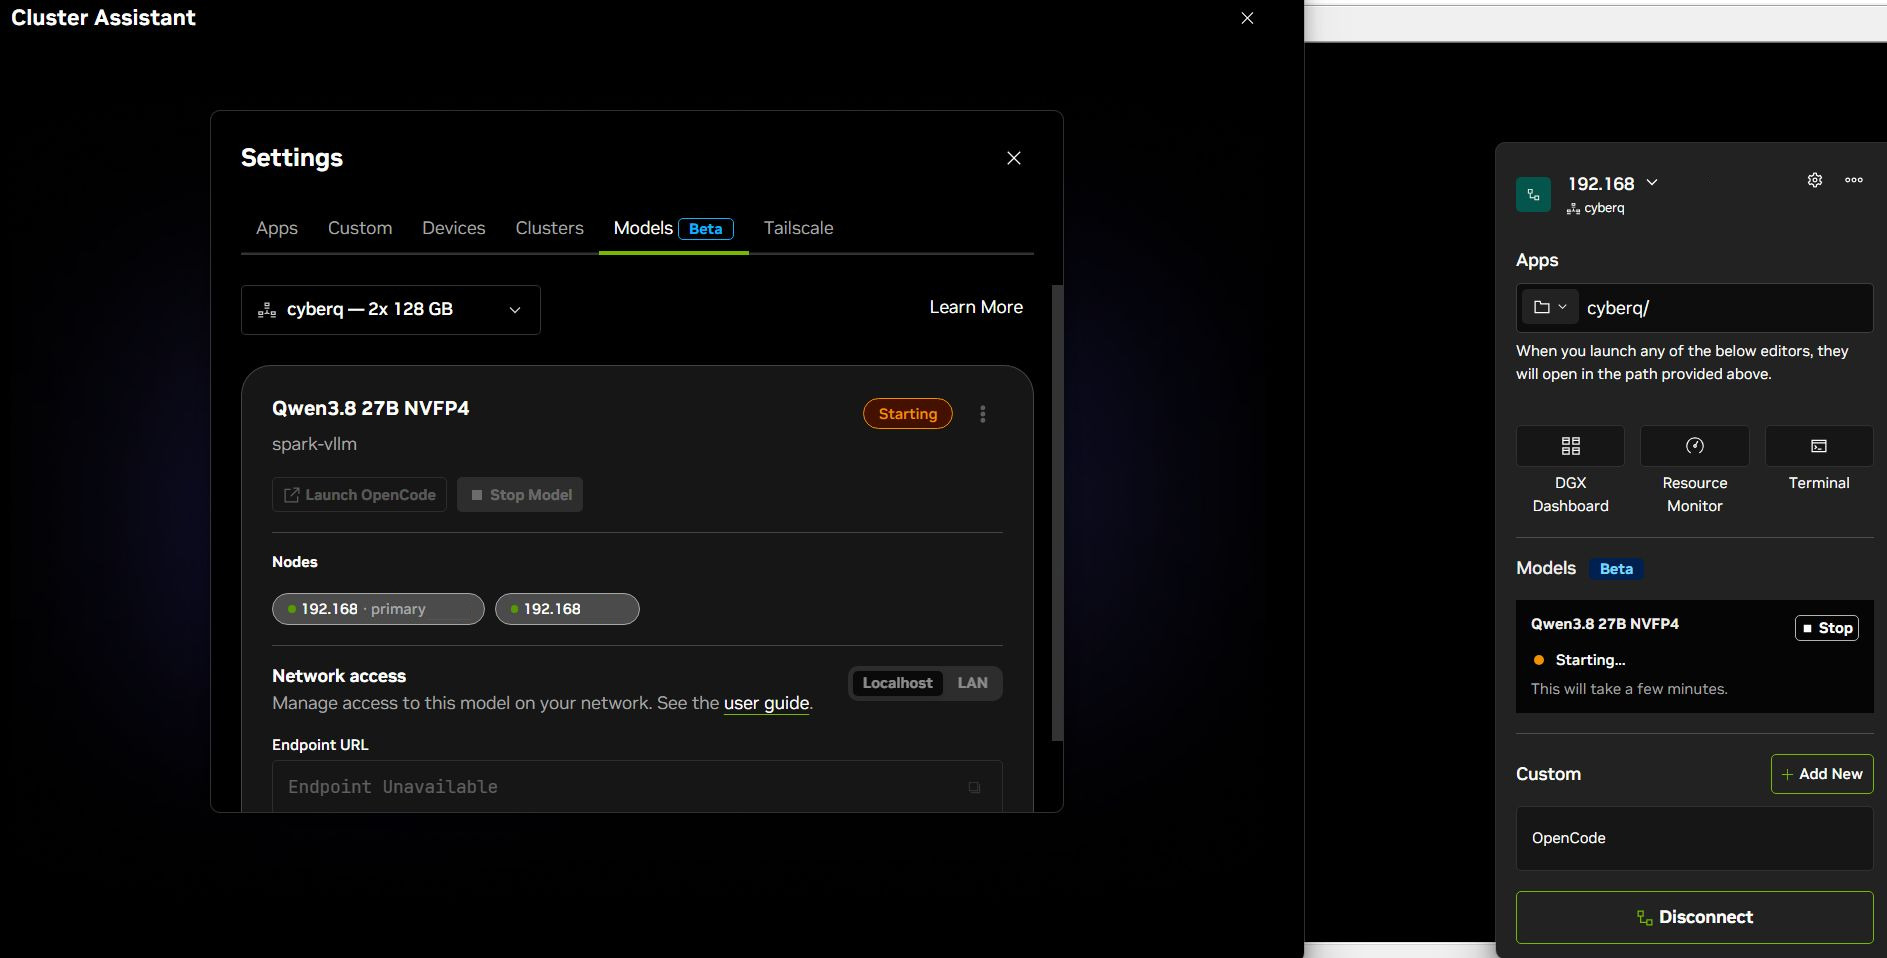
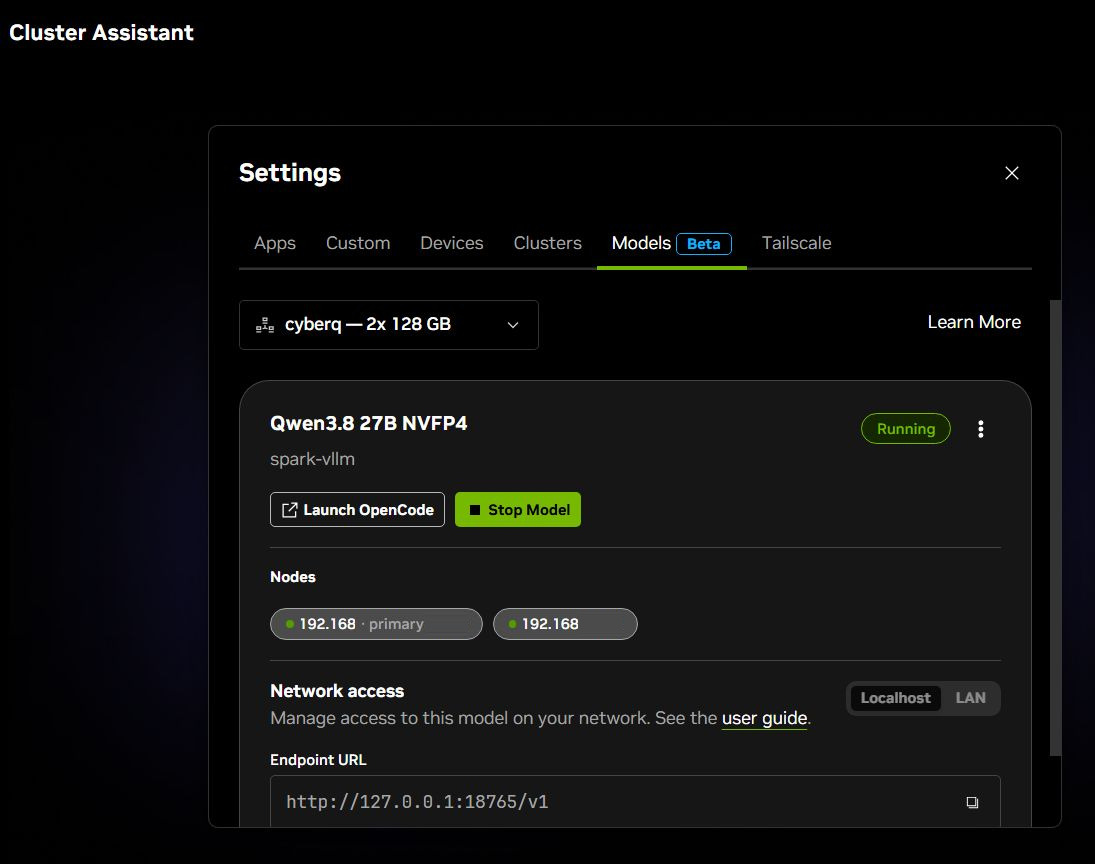
第一次啟動從容器建立到 API 可用約 12 分鐘,主要花在 FlashInfer 即時編譯與 torch.compile,之後因為編譯快取已存在,重啟只要約 2 分 35 秒。
拆解 Sync 實際跑起來的配方
Sync 把每次部署放在 ~/.config/NVIDIA/Sync/model-launcher/deployments/<部署 ID>/,裡面有配方 recipe.yaml、主節點與工作節點的啟動腳本、部署計畫與狀態檔。兩台各跑一個容器,分別是 rank 0 與 rank 1。
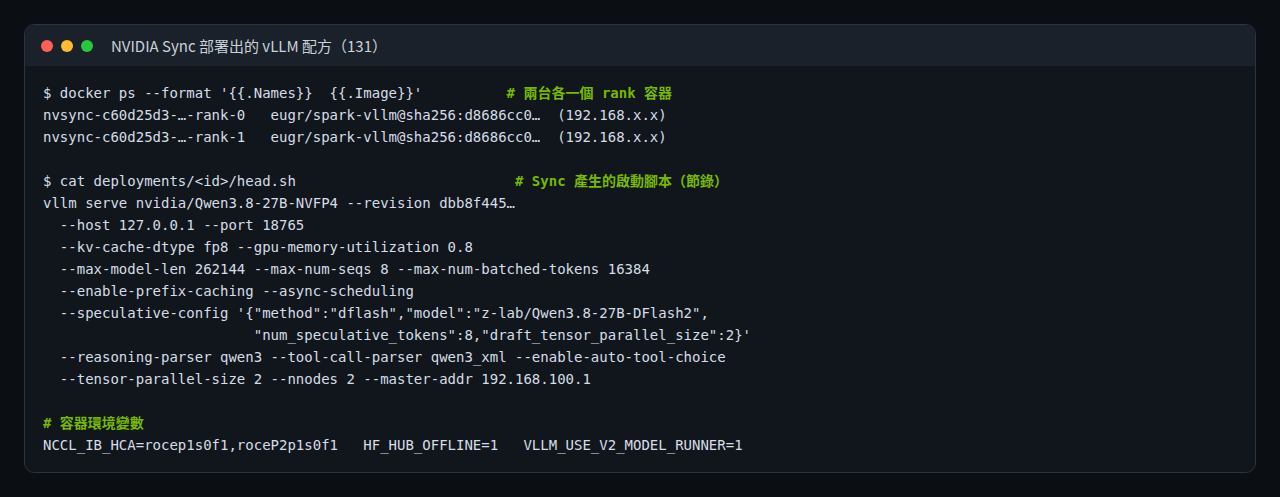
幾個值得注意的地方:
容器映像來自社群
配方使用的是 Docker Hub 上的 eugr/spark-vllm(nightly-20261002 版本,vLLM 0.30.1rc1),以 digest 固定版本,配方狀態標示為 qualified。映像、模型與草稿模型的版本都有固定,執行時也設定 HF_HUB_OFFLINE=1,不會在啟動時偷偷更新。
投機解碼採用 DFlash2
草稿模型是 z-lab/Qwen3.8-27B-DFlash2,一次猜 8 個 token,草稿模型本身也跨兩台做張量平行。
兩個 CX-7 半部都有用上
NCCL_IB_HCA 同時列出兩個 RoCE 裝置,這是吃滿 200G 的必要條件,我們先前手動設定時也是在這裡踩過雷。
記憶體幾乎全包
--gpu-memory-utilization 0.8 加上 FP8 KV cache,啟動後 KV cache 容量為 326 萬 token,可同時容納 12 條 262K 長度的請求,代價是每台約 97 GB 被佔用,模型執行期間不適合再跑其他 GPU 工作。Sync 寫給 OpenCode 的 AGENTS.md 也明確提醒這一點。
容器以特權模式執行(--privileged、host 網路、host IPC)
不過容器內的行程是以 UID 1000 而非 root 身分執行,算是有做一層緩解。
三、API 功能測試
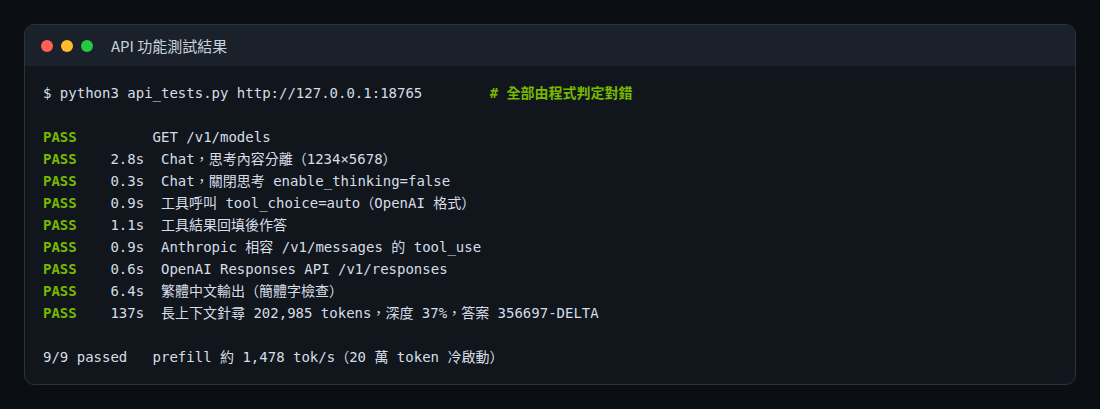
我們用一支 Python 腳本對 Endpoint 做九項測試,每一項都由程式比對答案判定對錯,不以「有回應、沒當掉」當作通過。原因是這個模型使用的 GDN 架構 CyberQ 之前實測過,在投機解碼下曾有輸出靜默損壞的上游問題,只看有沒有錯誤訊息並不足夠。
思考內容分離
預設開啟思考,reasoning_content 與正式回答分開輸出;以 chat_template_kwargs 關閉思考後,簡單問題 0.3 秒就回答。
工具呼叫
OpenAI 格式的 tool_calls 參數正確,回填工具結果後能正確引用數值;Anthropic 相容的 /v1/messages 也正確輸出 tool_use 區塊。這代表 Claude Code 這類使用 Anthropic API 的工具也能直接接上。
Responses API:/v1/responses 正常,輸出含 reasoning 與 message 兩段。
長上下文
在 202,985 token 的文本中第 37% 處放一組密碼,模型準確找回,冷啟動 prefill 耗時 137 秒,約每秒 1,479 token。
繁體中文
在系統提示要求台灣用語下,輸出沒有簡體字,但仍出現「數據平行」這類對岸用語(台灣慣用「資料平行」),正式產出仍需多留意。
四、效能實測
量測方法沿用 CyberQ 8 月建立的 CyberQ bench 協定,/v1/completions、不套聊天模板、輸出固定 800 token(忽略 EOS)、先暖機一次再量三次取中位數,每個請求前加隨機字串避免 prefix cache 影響首字延遲。投機解碼的接受率取自 vLLM /metrics 在量測區間的差值。每組量測前等 GPU 降到 60°C 以下。
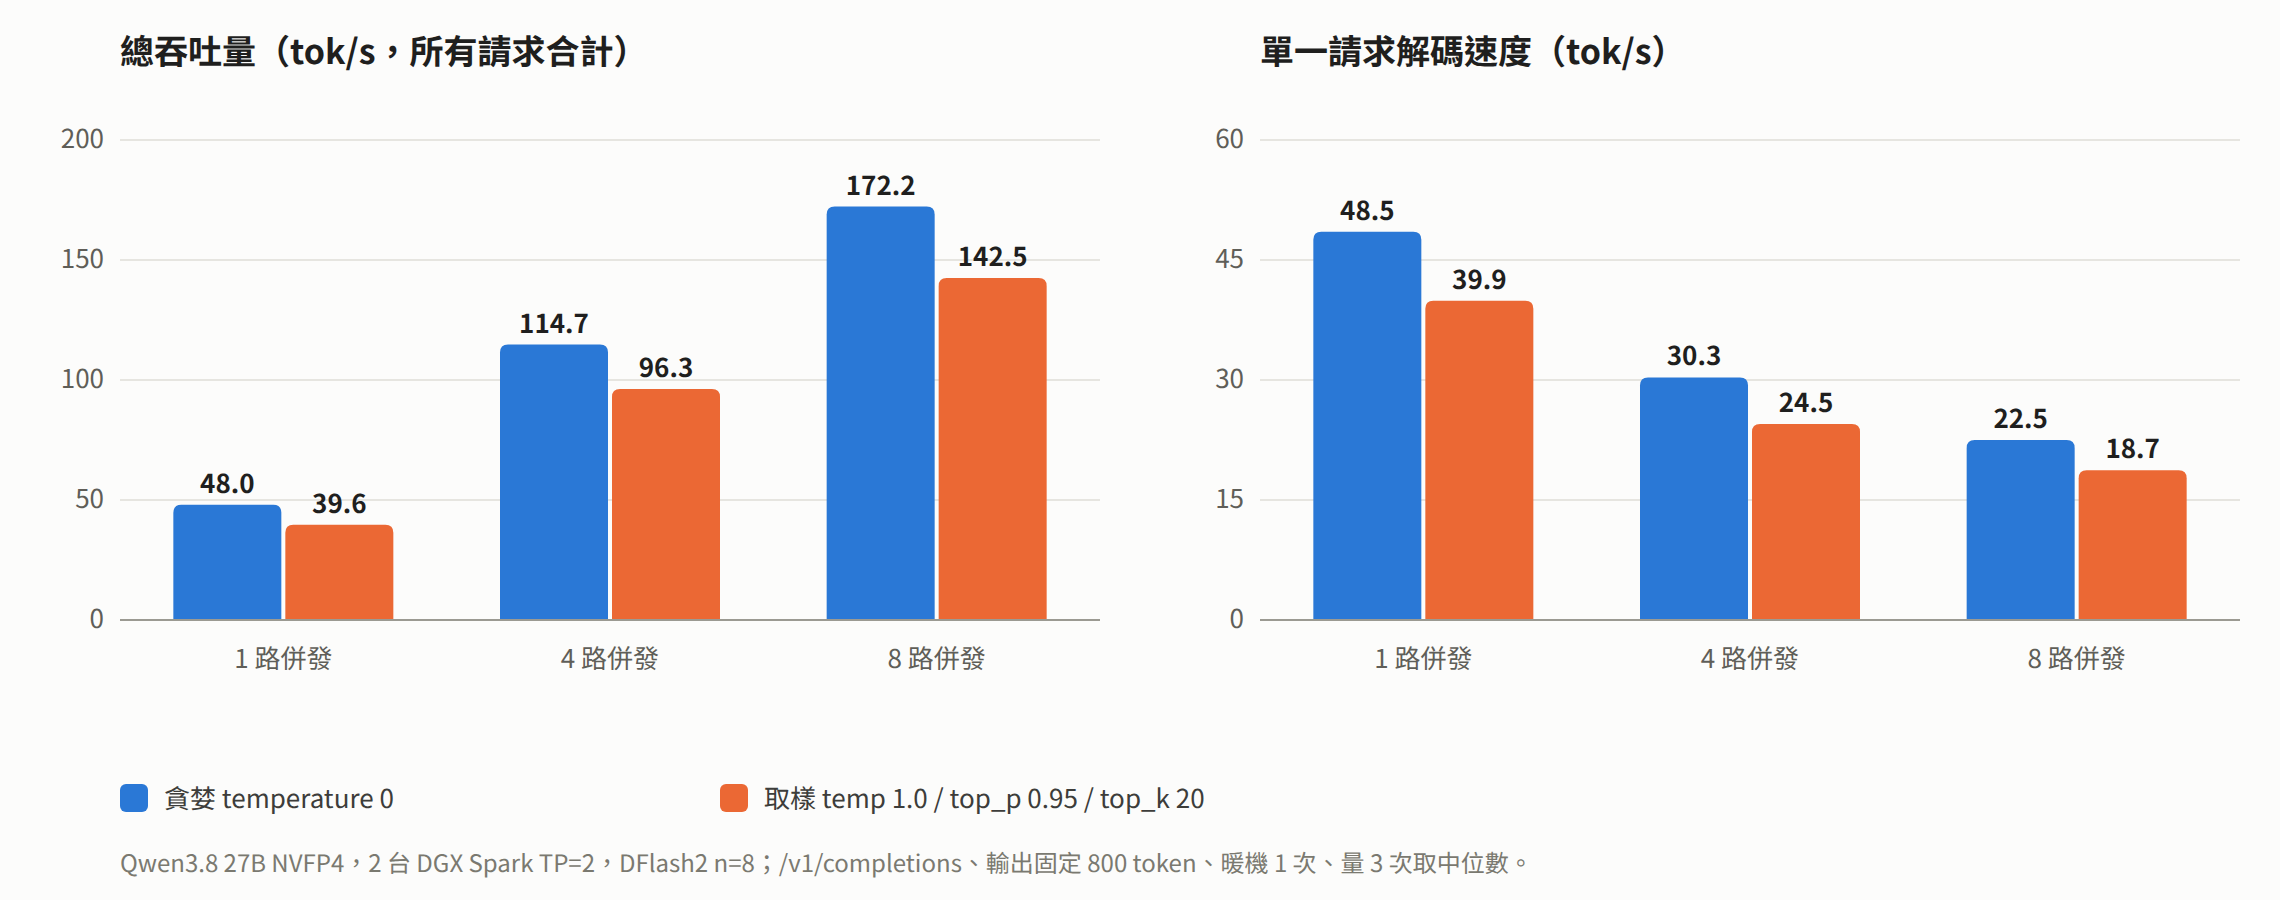
| 情境 | 總吞吐(tok/s) | 每請求解碼(tok/s) | 首字延遲 | 接受率 | 平均接受長度 |
|---|---|---|---|---|---|
| 1 路,貪婪 | 48.0 | 48.5 | 0.21 秒 | 31.3% | 3.51 |
| 1 路,取樣 | 39.7 | 39.9 | 0.15 秒 | 20.9% | 2.68 |
| 4 路,貪婪 | 114.7 | 30.3 | 0.20 秒 | 26.6% | 3.12 |
| 4 路,取樣 | 96.3 | 24.5 | 0.21 秒 | 20.8% | 2.66 |
| 8 路,貪婪 | 172.2 | 22.5 | 0.26 秒 | 27.0% | 3.16 |
| 8 路,取樣 | 142.5 | 18.7 | 0.41 秒 | 20.2% | 2.62 |
投機解碼的數字一定要連取樣條件一起看。改用模型預設的取樣參數(temperature 1.0、top_p 0.95、top_k 20)後,單路速度保留貪婪的 82.7%,平均每步接受長度從 3.51 降到 2.68;實際使用多半是取樣模式,因此 40 tok/s 左右才是比較貼近日常的數字。
和我們先前手動部署時的測試結果對照(同一套 CyberQ bench 量測協定,但映像檔、量化來源與投機解碼設定不同,這部分僅供參考):
8 月以 FP8 權重、兩台 TP=2、不開投機解碼,單路貪婪 14.80 tok/s。Sync 這套配方是它的 3.2 倍。
8 月單機以第三方 NVFP4 權重加 DFlash2(每次猜 7 個 token),貪婪 26.29、取樣 24.91 tok/s。Sync 的雙機配方分別快 1.8 倍與 1.6 倍。
也就是說,Sync 這套「NVFP4 加 DFlash2 加雙機 TP=2」的組合,已經比我們過去花好幾天手動調出來的最佳結果更快,而使用者只需要按幾個按鈕,難怪開發者社群有人說 NVIDIA 這次的最佳化和選用的模型配方很不錯。
NVIDIA 他們有這麼多優秀的工程師,搭配優良社群的成果,自然要比一般團隊要強大。
五、OpenCode:Sync 幫你接好的程式代理
Sync 會把 OpenCode 1.18.31 的獨立執行檔下載到部署目錄,以 web 模式在主節點的 127.0.0.1:4096 啟動,再透過 Sync 的連線轉到使用者的電腦上開啟。它同時在 ~/opencode/ 寫入一份 AGENTS.md,並安裝帶簽章的 dgx-spark-skills,內容涵蓋 Sync 使用說明、Cluster Assistant、診斷與已知問題。AGENTS.md 明確要求代理不得索取 sudo 密碼,遇到需要釋放記憶體的工作要先交代清楚再請使用者停掉模型,這幾條規則寫得相當周到。
我們請 OpenCode 用 Python 標準函式庫寫一支 CIDR 網段切分工具並附上單元測試。模型在 63 秒內完成,過程中呼叫 4 次工具(列目錄、寫兩個檔案、執行測試),四項測試全部通過,我們事後重跑測試與命令列也都正確。
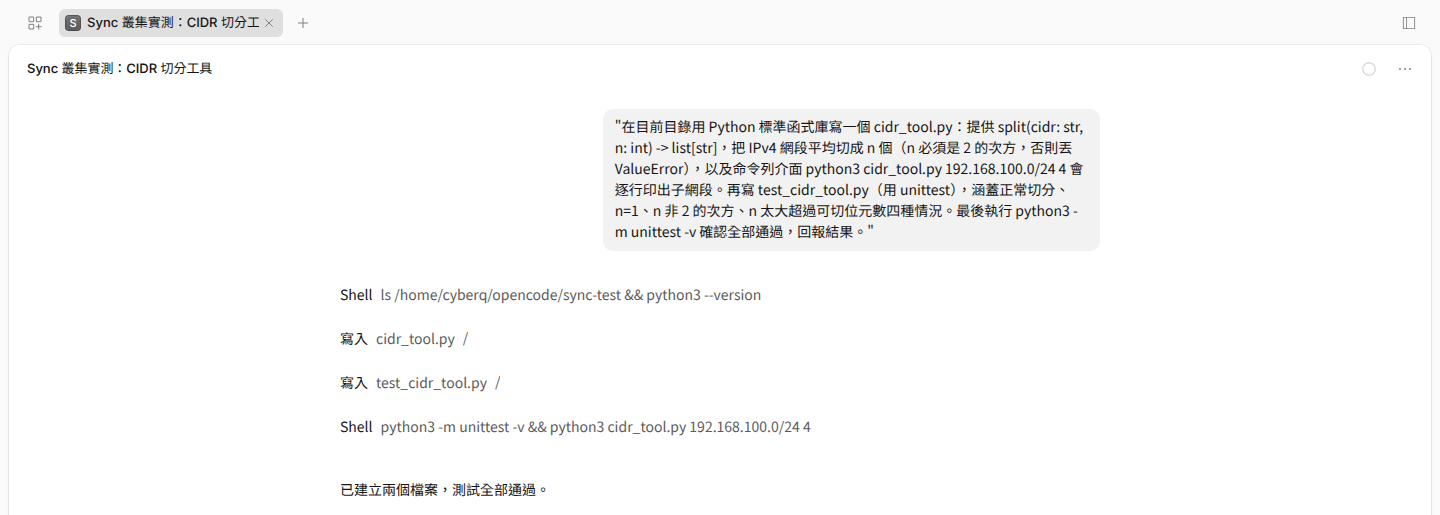
有兩點需要留意。第一,OpenCode 的 web 服務沒有設定密碼,雖然只綁本機位址,但任何能登入主節點的帳號都能透過它以使用者身分執行指令。第二,它與主機上既有的 OpenCode 共用工作階段資料庫,我們在清單中看得到其他專案過去的工作階段。
六、Network access:LAN 模式與 API 金鑰
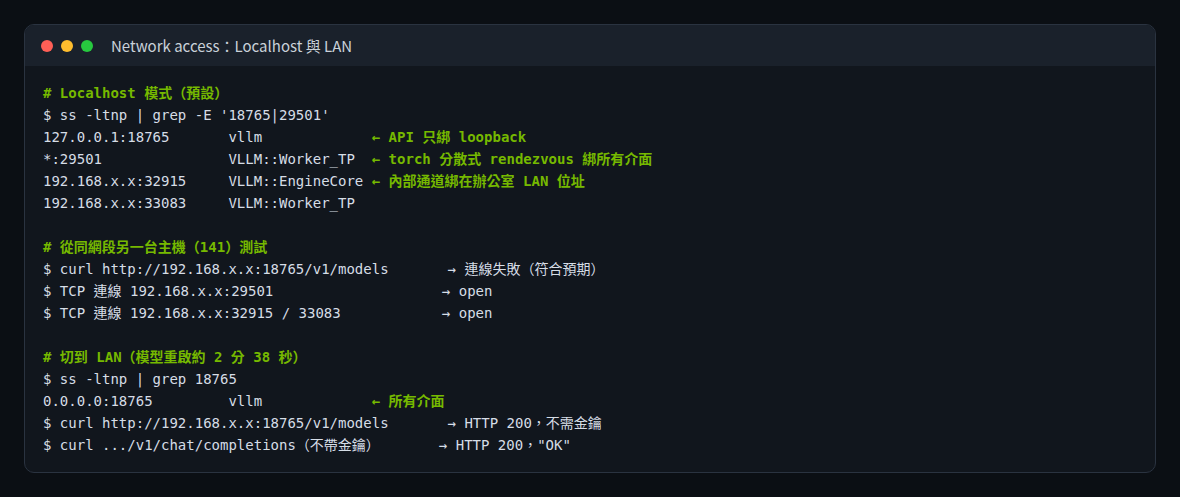
模型卡片下方的 Network access 可在 Localhost 與 LAN 之間切換。切到 LAN 時 Sync 會跳出警告,清楚說明三件事:模型會在裝置連上的每個網路(包括 VPN)上開放、Sync 不限制誰能連線,以及包含 API 金鑰在內的流量都沒有加密。
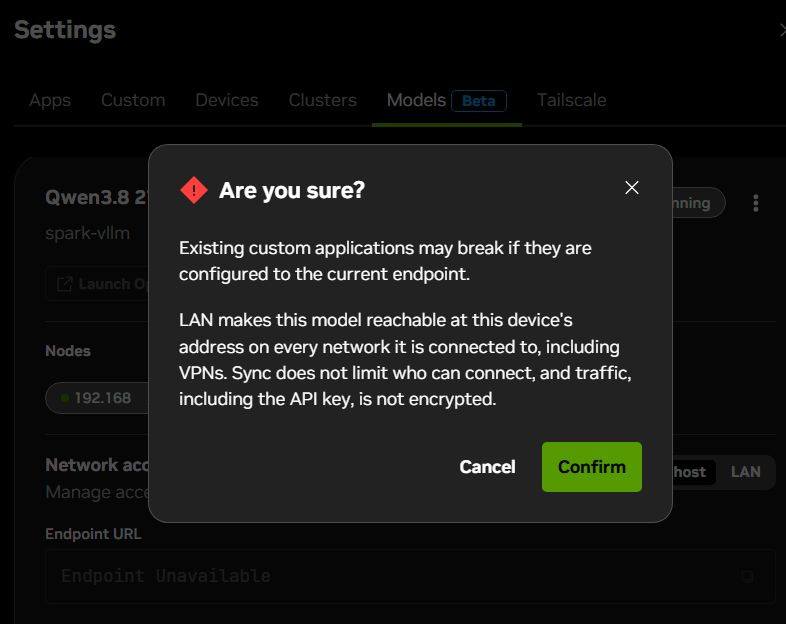
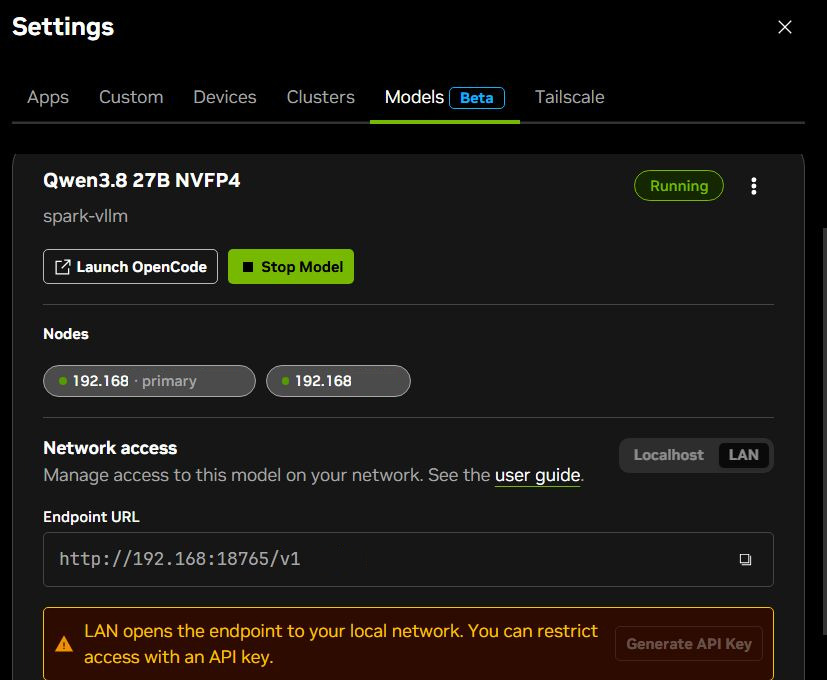
實測結果如下:
切換會重啟模型
容器會以新的 --host 0.0.0.0 參數重新啟動,約 2 分 38 秒無法服務,進行中的請求會中斷。
LAN 模式預設沒有驗證
從同網段的另一台主機不帶任何金鑰就能列出模型並完成對話。
產生金鑰會再重啟一次模型
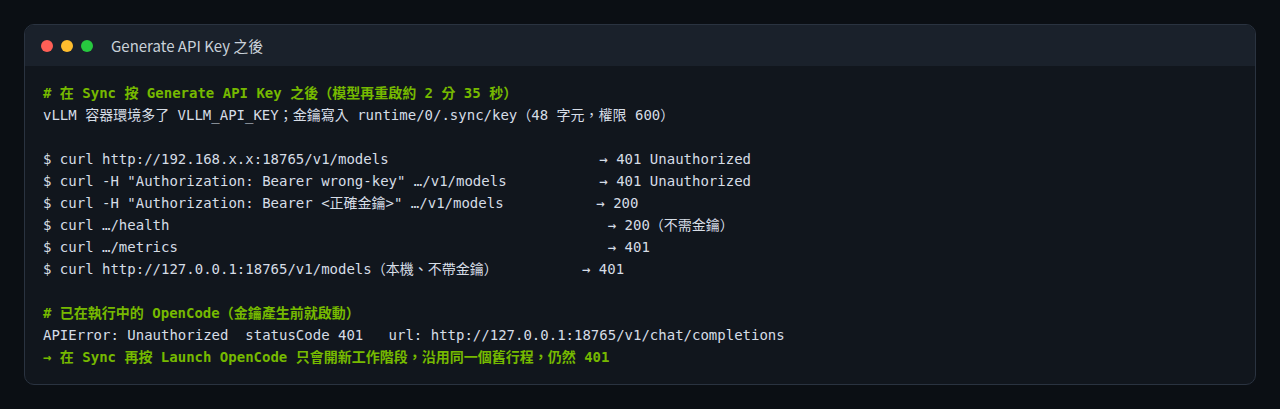
之後未帶金鑰或帶錯金鑰都回 401;/health 仍然開放,/metrics 也需要金鑰。連主節點本機呼叫都必須帶金鑰。
已開啟的 OpenCode 會失效
OpenCode 的設定是以檔案參照的方式讀取金鑰,但從結果看來它只在啟動時讀取一次。產生金鑰前就開著的 OpenCode 之後每個請求都回 401 Unauthorized。我們在 Sync 再按一次 Launch OpenCode,Sync 只是在同一個舊行程上開了新工作階段,並沒有重啟它,所以問題依舊。
CyberQ 在 Sync 介面上再操作一輪之後重測,連到 4096 埠的仍是金鑰產生前啟動的同一個 OpenCode 行程,請求依然回 401。目前可行的解法是在主節點上手動結束這個舊行程,再從 Sync 重新按 Launch OpenCode,讓它以新金鑰啟動。另外,opencode run 遇到 401 時仍以結束碼 0 離開,若用腳本自動化呼叫 OpenCode,不能只看結束碼判斷成功與否。
Localhost 模式也有埠開在辦公室網段
這是 CyberQ 在檢視監聽埠時額外發現的,不論 Localhost 或 LAN 模式,PyTorch 分散式的 29501 埠都綁在所有介面上,另外 vLLM 引擎與工作行程各有一個內部通道埠綁在主節點的辦公室網段位址,而不是 CX-7 直連網段。我們從同網段另一台主機確認這些埠都能建立 TCP 連線。這些是 vLLM 跨機協調用的內部通道,本身沒有驗證機制,Sync 的 Network access 開關並不管它們。
七、結論與建議
CyberQ 實測認為,NVIDIA Cluster Assistant 把過去要對照文件、手動設定兩個 CX-7 半部、交換金鑰與量測頻寬的工作,濃縮成幾分鐘的精靈,而且偵測到既有設定正確時不會亂改,對已經手動組過叢集的使用者也很友善。Models(Beta)更進一步把版本固定的 vLLM 配方、DFlash2 投機解碼與 OpenCode 整合在一起,效能比我們過去手動調出的最佳結果還好,API 相容性也完整,對想要「把兩台、三台或四台 DGX Spark 變成一台本地程式助理伺服器」的團隊來說,門檻大幅降低,且二、三、四台的叢集組成方式是現在市場的主流,又有官方設定精靈加持,可省不少自己的時間。
如果你想是想要自己打磨,設定方式和教學大致上差不多,也就是說你自己設定的內容和控制項,NVIDIA 也實作好了一份公版給大家參考,不妨試試看。
CyberQ 建議,部署前後留意以下幾點:
共用環境請維持 Localhost
需要讓其他電腦使用時,再切到 LAN 並立刻產生 API 金鑰。LAN 流量是明文,跨網段或經 VPN 使用時,建議前面加一層 TLS 反向代理或改用 Tailscale 這類加密通道。
主機防火牆把 vLLM 內部埠限制在 CX-7 網段
29501 與引擎的動態埠只需要兩台之間互通,用 ufw 或 nftables 只允許 192.168.100.0/24 與 192.168.101.0/24 即可,這一點不論是否使用 Sync 都適用。
產生或更換金鑰後,手動重啟 OpenCode
並請記得預留模型兩次重啟的停機時間。
模型執行時每台約佔用 97 GB 記憶體
原本在同一台上跑的其他 GPU 服務要先停掉。
映像來自社群維護者
雖然以 digest 固定版本,企業環境仍建議納入自己的映像掃描與核准流程。
Models 目前仍標示為 Beta,NVIDIA 推薦清單也只有一個模型,期待後續加入更多模型與自訂配方。
八、加碼:與 DeepSeek V4.1 Flash 同題對照
測完 Sync 之後,我們停掉 Qwen,把兩台換回實驗室平常在用的 DeepSeek V4.1 Flash 1017 去審查版(社群 2.8 bpw 量化、TensorFold Zig 引擎,同樣兩台跨機執行,內建 MTP 投機解碼,引擎設定最多同時處理 4 路),用同一組腳本、題目與量測協定再跑一次,看看 Sync 這套官方配方在同一組硬體上的相對位置。
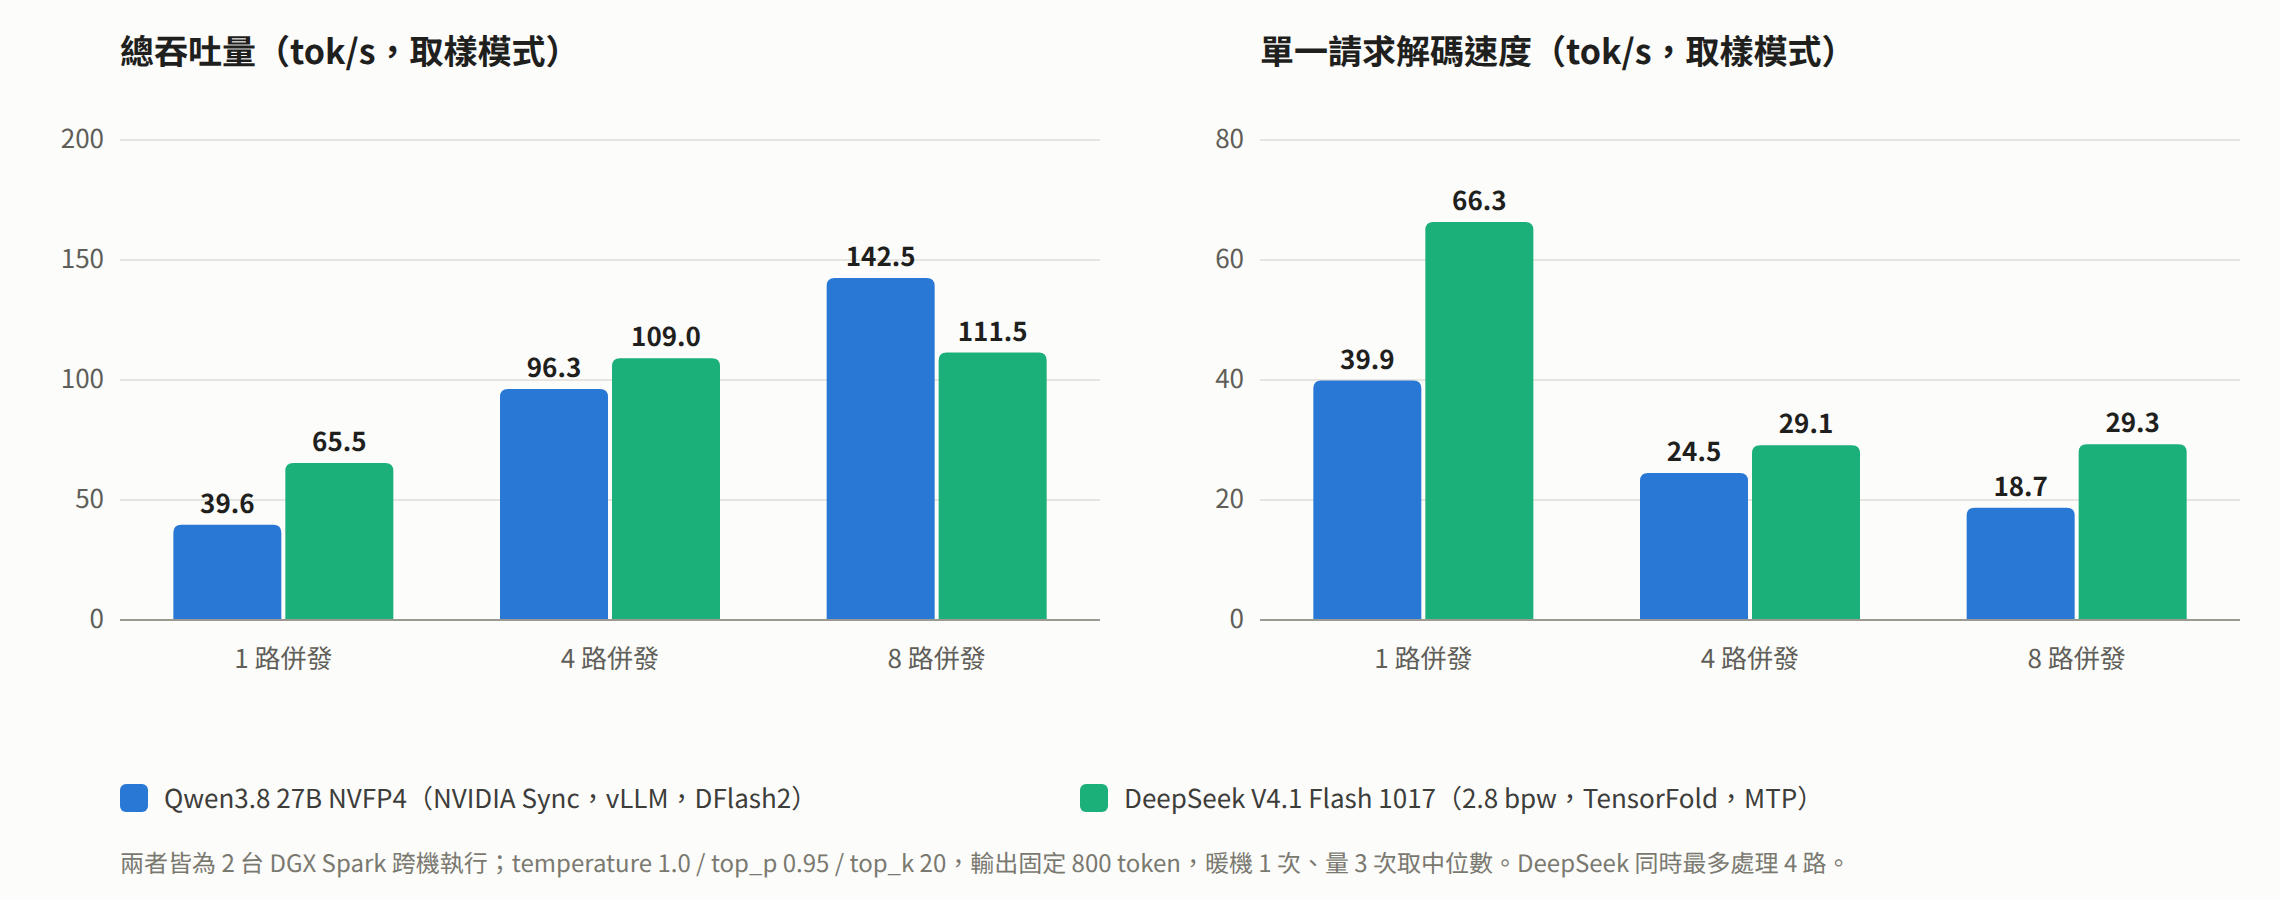
| 項目 | Qwen3.8 27B(Sync) | DeepSeek V4.1 Flash |
|---|---|---|
| 單一請求,取樣 | 39.7 tok/s | 65.5 tok/s |
| 單一請求,貪婪 | 48.0 tok/s | 64.7 tok/s |
| 4 路總吞吐,取樣 | 96.3 tok/s | 109.0 tok/s |
| 8 路總吞吐,取樣 | 142.5 tok/s | 111.5 tok/s |
| 8 路首字延遲,取樣 | 0.41 秒 | 8.6 秒 |
| 20 萬 token 取針 | 通過,137 秒(約 1,479 tok/s) | 通過,97 秒(約 2,070 tok/s) |
| API 功能 9 項 | 全數通過 | 全數通過(思考題需指定思考強度) |
| OpenCode 同一題 | 63 秒,4 次工具呼叫,測試 4/4 | 18 秒,3 次工具呼叫,測試 4/4 |
| 繁中用語抽樣 | 「數據平行」 | 「資料平行」 |
幾個觀察:
單一使用者時 DeepSeek 明顯較快
它的 MTP 在取樣模式下接受率仍有六成以上,速度幾乎不受取樣影響;Qwen 的 DFlash2 在取樣下只剩貪婪速度的 83%,兩者差距因此拉大到約 65%。長提示讀取 DeepSeek 也快約四成。
多人同時使用時 Qwen 反超
DeepSeek 的引擎設定同時只處理 4 路,第 5 到第 8 個請求要排隊,總吞吐停在約 110 到 120 tok/s,第一個字要等 8 到 12 秒;Sync 的配方允許 8 路,8 路時總吞吐 142.5 tok/s,首字仍在半秒內。
OpenCode 那題的差距有一部分來自思考設定
Sync 的 Qwen 預設開啟思考,這題多花了 2,682 個思考 token,DeepSeek 引擎預設不思考。
讀數上的限制也要稍微說明 下,這兩款模型的分詞器不同,tok/s 不完全等於每秒寫出的中文字數,取樣參數兩邊都用 Qwen 的預設值(temperature 1.0、top_p 0.95、top_k 20),這次只比較功能正確性與速度,沒有比較推理與知識能力。
CyberQ 認為,以單人或少數人使用的本地助理來說,經過調校的 DeepSeek V4.1 Flash 仍然比較快,但它需要自己追社群引擎、處理量化與記憶體邊界,而 Sync 的 Qwen 配方開箱就能撐 8 路併發,維運成本低得多。對多數團隊來說,先用 Sync 的官方配方上線,再依實際使用情境決定是否投入自行調校,是比較務實的路徑。
測試環境:兩台 DGX Spark(GB10,128 GB),以 200GbE QSFP 線材直連,NVIDIA 官方驅動 580.178.04,NVIDIA Sync 0.148.0-153,測試日期 2026 年 11 月 8 日。