微軟 Microsoft 365 於美東時間 11 月 12 日下午 1 時 26 分發生全球性服務中斷,影響 Outlook、Exchange Online、Teams、SharePoint、OneDrive、Copilot 與 Defender XDR 等多項服務。截至台灣時間 11 月 13 日上午,中斷已持續超過八小時,微軟表示已看到正面結果,但服務仍未完全恢復。官方強調,目前沒有跡象顯示這是網路攻擊。
一、事件規模與影響範圍
根據斷線追蹤網站 Downdetector 的資料,Outlook 相關問題回報在格林威治時間 11 月 12 日傍晚 6 時左右達到近 14 萬筆的高峰。Guardian 報導的數字約為 13 萬筆,BleepingComputer 則記錄微軟 365 系統於下午 1 時 26 分進入事故狀態,編號 MO1550821。
受影響最重的是電子郵件。微軟後續說明,目前多數障礙集中在連接 Exchange 的服務,使用者可能無法透過 Outlook 存取收件匣。Teams 的聊天與線上會議大致仍可使用,但會議排程與建立新聊天可能受 Exchange 問題牽連。其他受影響的還包括 Word、Excel、PowerPoint、SharePoint、OneDrive 與 Copilot。OpenAI 與 Anthropic 也分別表示,其 Microsoft 365 連接器出現上遊問題。
影響不限於企業。澳洲塔斯馬尼亞、西澳、新南威爾斯與北領地州政府電子郵件受阻,坎培拉數位政府服務也受波及,學校與法院同樣傳出無法收發郵件。澳洲競爭與消費者委員會委員 Tony Burke 表示,微軟認為這不是網路事件。
二、原因是什麼
微軟最初的說法是部分基礎設施在多個區域出現負載升高,可能導致連線錯誤。這個描述容易讓人以為是流量暴增,但微軟隨後修正,指負載升高並非來自流量增加,而是有相當數量的伺服器意外無法使用,使剩餘基礎設施承受額外壓力。
更關鍵的是,微軟找到一個負責處理伺服器健康狀態的特定元件發生故障。這個元件用於自動健康檢查,當它失效時,大量伺服器被判定為不健康而退出服務,形成第一波容量流失。微軟在最新更新中進一步說明,受影響伺服器上負責建立安全連線的處理程序被壓垮,導致伺服器停止處理請求。
換句話說,這不是單純的流量洪水,而是控制平面的連鎖失效。健康檢查失準讓伺服器被大量移出輪值,剩下來的伺服器承受更高負載,於是更多伺服器無法回應,形成惡性循環。微軟表示,已暫停所有部署、把連線流量分散到全球基礎設施、並重新啟動受影響伺服器。部分伺服器在流量回流後再度失去回應,這也是恢復速度緩慢的原因。
微軟同時指出,一項近期的設定變更與這起中斷的起點在時間上吻合,目前正在回滾該變更,並觀察是否有助於恢復。這句話目前仍是相關性描述,還不是完整的最終根因結論。微軟尚未公布正式的事後調查報告,因此現階段最準確的說法是,設定變更與健康檢查元件失效共同導致大規模伺服器退出服務。
三、為什麼這類事件會擴散到全球
微軟 365 的架構把身分驗證、郵件路由、健康檢查與流量調度集中在少數控制平面上。當健康檢查這種「判斷伺服器能不能服務」的機制失準,影響會以倍數放大,因為它決定流量要往哪裡送。這也是為什麼單一元件故障可以同時影響多個區域與多項產品,而不是只限於某個資料中心。
另一個放大因素是產品耦合。Outlook 依賴 Exchange,Teams 的會議排程也依賴 Exchange,Copilot 與第三方 AI 連接器同樣需要通過 Microsoft 365 的授權與連接層。當 Exchange 受阻,表面上不同的產品會一起出現症狀,讓使用者感覺「整個微軟都掛了」。
四、與 2024 年 CrowdStrike 事件的差異
CyberQ 觀察,這起事件容易被拿來與 2024 年 7 月的 CrowdStrike 全球當機相比,但兩者性質不同。CrowdStrike 是資安廠商的內容更新缺陷,導致 Windows 裝置出現藍白當機畫面,問題發生在端點。這次則是微軟自家雲端服務的健康檢查與連線處理元件失效,問題發生在雲端控制平面,使用者裝置本身沒有壞掉。
兩者的共同教訓是,現代 IT 的單點依賴程度極高。一個看似內部的檢查機制或設定變更,就能讓全球電子郵件停擺數小時。對企業而言,真正的風險不是「微軟會不會出錯」,而是「當微軟出錯時,我們有沒有替代通訊與作業路徑」。
五、企業因應該注意什麼
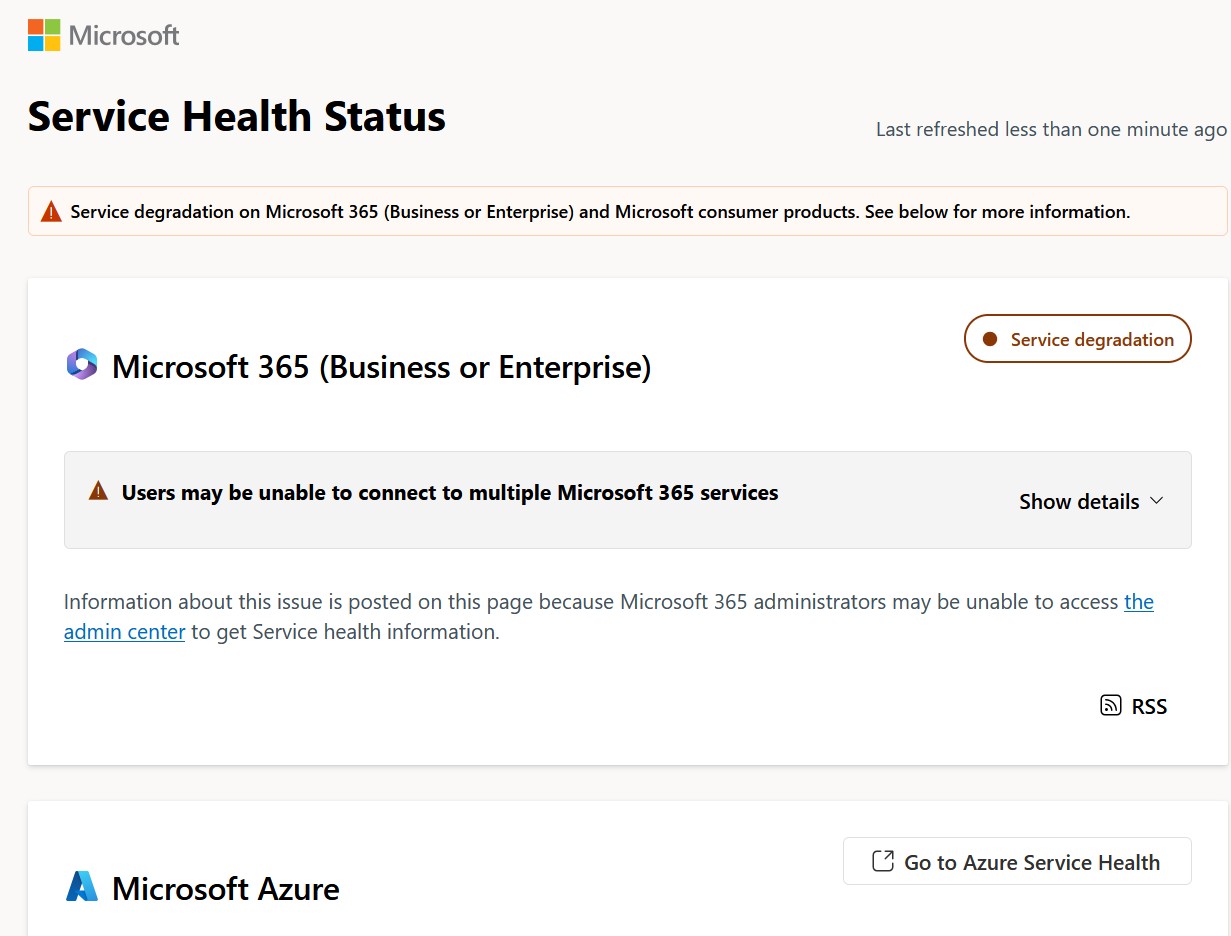
CyberQ 認為,第一,不要把電子郵件當成唯一的作業通道。這次事件中,Teams 聊天與會議大致可用,簡訊與電話成為澳洲政府與企業的替代路徑。第二,檢視對單一雲端供應商的依賴程度,特別是身分驗證與郵件路由是否集中在同一家。第三,把供應商的事故公告納入監控,微軟這次因為系統管理員可能無法進入系統管理中心,改在公開狀態頁發布資訊,企業應訂閱該頁面的 RSS 或通知。
第四,實作漸進式復原預案。微軟這次採用暫停部署、分流、重啟與回滾設定變更的組合,企業在自身系統也應具備類似能力,尤其是設定變更要有快速回滾機制。第五,針對關鍵流程建立離線或替代方案,例如重要聯絡資訊與審批流程不要只存在雲端信箱中。
六、目前狀態與後續觀察
CyberQ 觀察,微軟表示重啟受影響系統的努力出現正面結果,並持續監控效能。不過公開的微軟服務健康狀態頁仍顯示 Microsoft 365 為服務降級狀態,使用者可能仍會遇到連線問題,恢復過程可能呈現逐步改善,而不是一次全面復原。
後續應觀察三件事。第一,微軟是否公布完整根因報告,說明是哪一項設定變更、哪個健康檢查元件,以及為何會連鎖失效。第二,回滾後服務是否穩定,會不會再度出現伺服器在流量回流後失去回應的情況。第三,這起事件是否促使微軟調整部署流程,例如對健康檢查元件採取更嚴格的漸進式發布與隔離設計。
CyberQ 觀點
這起事件再次證明,雲端服務的可靠性不是靠沒有故達成,而是靠故障發生時的隔離與降級能力。
微軟這次的問題並非流量,主要是判斷伺服器是否健康的機制本身,這是最難防的一類故障,因為它會讓自動化系統做出錯誤的移除決策。對台灣企業而言,該問的問題不是微軟何時修好,而是自家在信件停擺的八小時內,能不能照常出貨、照常核准、照常聯絡客戶。答案如果是否定的,就該補上替代路徑,儘早未雨綢繆。