微軟 Microsoft 365 從台灣時間 11 月 13 日凌晨 2 時 26 分開始的大規模中斷,到了當晚仍未結束。微軟 19 時 04 分公告,亞太區部分受影響設備已完成復原,信箱存取與延遲郵件處理都有改善,20 時的公告則說歐洲恢復進展明顯,日本相對穩定,北美也在改善,郵件逾時時限維持延長為 48 小時。
不過 CyberQ 在台灣三度實地探測,18 時前後 Outlook 前端節點持續回傳 HTTP 500,標頭直接寫著「The network is busy」,19 時 25 分再測時,台北的前端節點本身已能正常回應,但 DNS 卻把台灣使用者導向境外的另一批節點,而那批節點完全不接受連線,Outlook 仍然打不開。20 時 30 分第三次測試,情況完全沒有改變。同一時間 Teams、SharePoint、登入服務與 Graph 都正常。
本文接續 CyberQ 早上的首篇報導〈微軟 365 全球大當機逾八小時〉,整理白天之後的官方更新、台灣端的實測數據,以及這次故障在架構與資安上的意義。
一、白天之後的官方更新
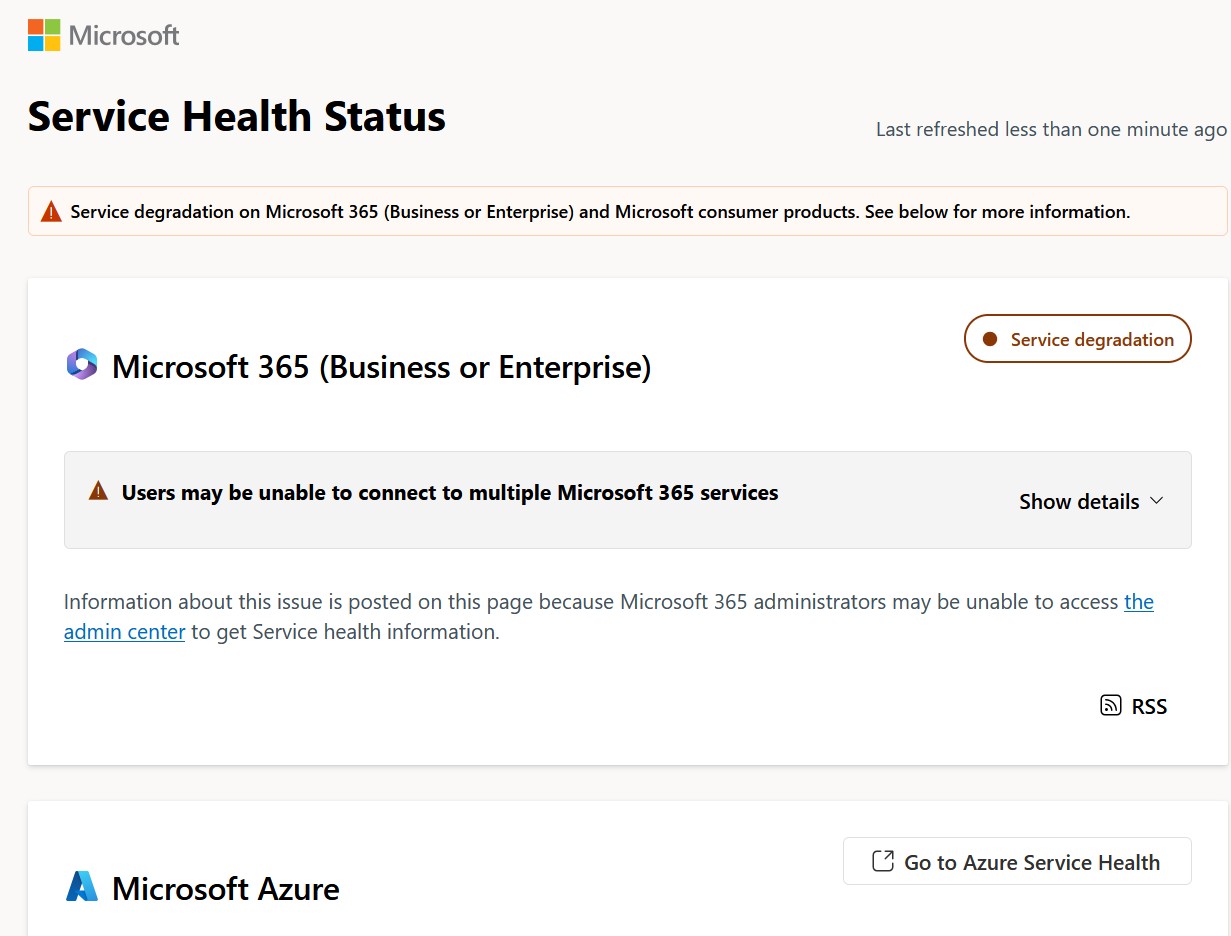
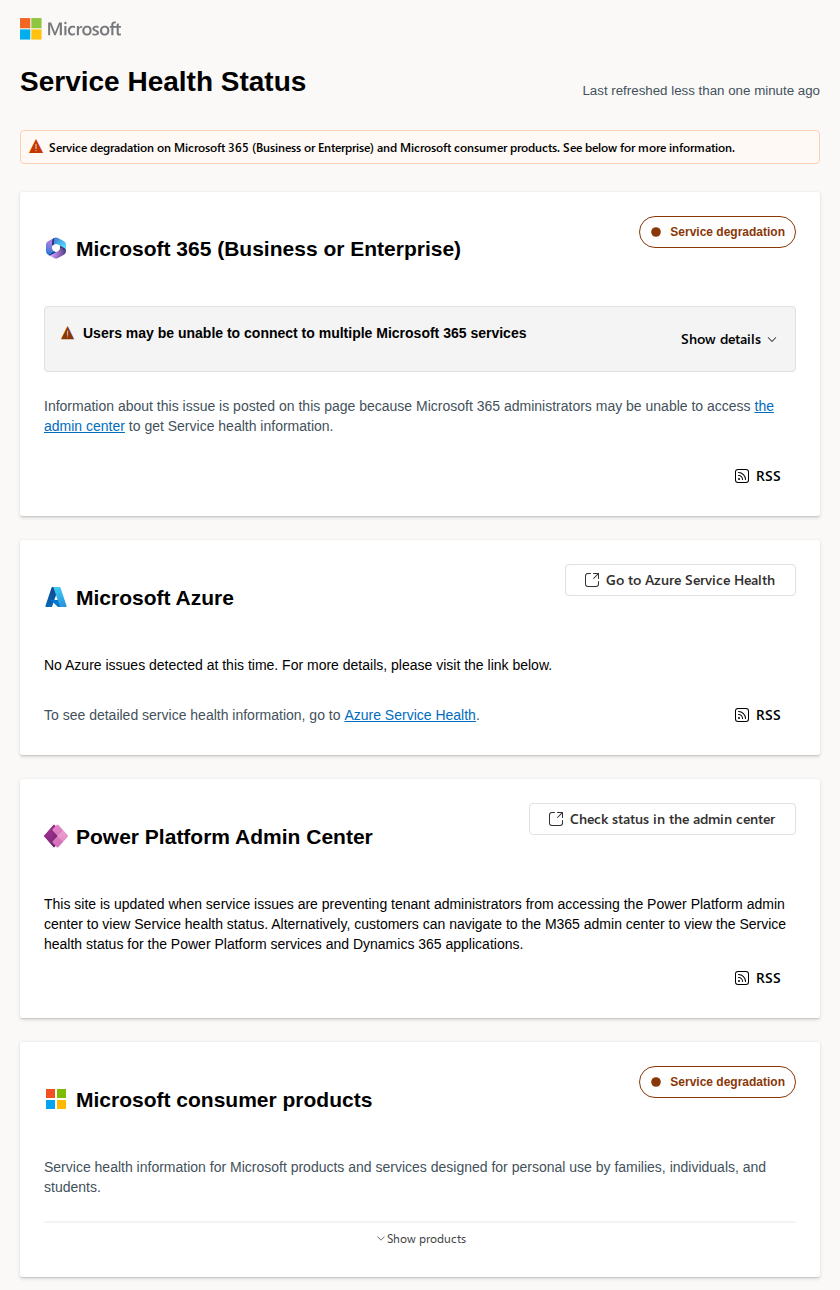
微軟這次同時開了兩個事件編號:Exchange Online 的 EX1550543 與 Microsoft 365 整體的 MO1550821。由於管理員可能連不上 Microsoft 365 系統管理中心,微軟把公告同步放在不需登入的 status.cloud.microsoft。以下時間軸依官方公告與 CyberQ 自行抓取的狀態頁資料整理,時間一律為台灣時間。
| 時間 | 事件 |
|---|---|
| 11/13 02:26 | 事件開始(美東 11/12 13:26),初步說法是多個區域部分基礎設施負載升高 |
| 13 日中午前後 | @MSFT365Status 連發三則:暫停所有部署並重啟受影響伺服器;負載升高「不是流量增加造成」,而是一批伺服器意外失去服務能力,壓垮其餘設備;正在測試一項組態變更,處理伺服器無法通過自動健康檢查的問題 |
| 13:52 | 一則韓文推文截圖上述官方貼文,稱「暫停所有部署」等於按下緊急鈴,數小時內累積超過 28 萬次瀏覽 |
| 14:24 | 消費者版公告更新,承諾 16:30 前再更新,實際到 19:21 才更新 |
| 17:14 | 企業版公告:出現初步穩定跡象,但容量未恢復;受影響設備輪流執行「排空流量、重啟、修復、分批恢復服務」;郵件逾時時限延長為 48 小時;未發現惡意活動 |
| 18:01 | 企業版公告:分階段復原,多項服務逐步改善,但健康狀態仍不穩定;網路與流量管理措施持續中 |
| 19:04 | 企業版公告:亞太區部分受影響設備已完成復原,流量逐步恢復,信箱存取與延遲郵件處理改善,但部分使用者仍會間歇性遇到問題;下一步把復原措施擴及其他區域並增加容量;下次更新 20:00 |
| 19:21 | 消費者版公告更新,內容仍是「持續多方調查以找出問題來源」 |
| 19:55 | 消費者版公告:整體環境的復原工作持續進展,同時仍在找出問題來源;下次更新 22:30 |
| 20:00 | 企業版公告:歐洲恢復進展令人鼓舞,服務可用性與郵件遞送改善;日本相對較穩定,北美也在改善,但部分使用者仍會遇到間歇性問題;受影響服務仍為 20 項;下次更新 21:00 |
截至本文擷取時間(20:33),兩個狀態頁都仍是 Service degradation,微軟也還沒有給出預估的完全恢復時間。官方明確表示,完全緩解後會發布含根本原因與「縱深防禦」改善措施的事後報告(Post-Incident Report, PIR)。
二、影響範圍:不只收不到信
首篇報導時,外界的焦點主要放在 Outlook 與 Teams。白天之後,企業版公告列出的受影響服務清單已經增加到 20 項,共同點是「只要功能需要跟 Exchange Online 互動就會受影響,不依賴 Exchange 的部分仍可運作」。對資安與 IT 管理員來說,比較需要注意的是下面這幾項:
- Microsoft Defender for Office 365:Safe Links、Safe Attachments、隔離區、Threat Explorer 與郵件補救事件都可能失敗。被 Safe Links 改寫過的網址會「無法導向」;能進入隔離區的使用者,也可能放不出被隔離的郵件。租用戶允許/封鎖清單的變更會延遲生效。
- Microsoft Purview:資料外洩防護(DLP)、敏感度標籤與自動標記、通訊合規、稽核搜尋、eDiscovery 的搜尋與匯出都在受影響清單內,部分使用者無法開啟受保護的內容。
- Microsoft Intune:裝置註冊、裝置簽入與合規政策「可能曾間歇性受影響」。
- Microsoft Defender XDR:Defender 入口網站的頁面或分頁可能載入不了。
- Windows 365:使用 Purview Customer Key 的雲端電腦,使用者可能無法連線。
- Microsoft Graph:存取郵件、行事曆、聯絡人的 API 請求可能逾時,連帶影響透過 Graph 管理 Teams 團隊、頻道與成員的自動化流程。
- Teams:通話、會議、群組聊天與頻道訊息大致正常,但行事曆排程、邀請、直播與虛擬活動建立、私人與共用頻道的建立刪除會失敗。
換句話說,這次中斷影響的不只是「能不能收信」,還包含郵件防護、資料保護與裝置管理這幾條企業資安控制線。
三、台灣端實測:從「網路忙碌」到「被導離台北」
CyberQ 從台灣的固網線路,對 12 個 Microsoft 365 公開端點做了三個時段的連線探測。第一個時段在 18:00 到 18:07(兩輪,每輪每個端點連 3 次),第二個時段在微軟宣布亞太區部分復原之後的 19:25 到 19:33,第三個時段在微軟 20:00 公告之後的 20:30 到 20:33。全程不帶任何帳號憑證,也不碰登入流程,只記錄 DNS 解析、TCP 連線、TLS 交握與首位元組的時間,以及 HTTP 狀態碼。
| 端點 | 結果(共 6 次) | TCP 連線耗時 |
|---|---|---|
| outlook.office365.com | 6 次中 6 次 HTTP 500 | 4 次 15 到 17.5 秒,另 2 次 9 毫秒;18:08 加測一次達 35 秒 |
| outlook.office.com | 6 次中 5 次 HTTP 500,1 次 20 秒逾時 | 多數 15 到 19 秒 |
| outlook.live.com(消費者版) | 6 次中 6 次 HTTP 500 | 5 次 10 到 19 秒,1 次 9 毫秒 |
| login.microsoftonline.com | 正常(302) | 約 40 毫秒 |
| teams.microsoft.com | 正常(302) | 10 毫秒以內 |
| graph.microsoft.com | 正常(301) | 約 30 毫秒 |
| microsoft.sharepoint.com | 正常(401,未登入的預期結果) | 20 毫秒以內 |
| onedrive.live.com | 正常(403,未登入的預期結果) | 約 40 毫秒 |
| www.office.com、admin.microsoft.com、security.microsoft.com、status.cloud.microsoft | 正常 | 80 毫秒以內 |
註:即使 TCP 連線很快建立,Outlook 系列 3 個主機仍一律回 HTTP 500;18:05 那一輪的 9 次請求全部要等 15 秒以上才連上。
18 時這一輪的幾個觀察:
第一,問題集中在 Exchange 前端,其他服務的入口都健康。 Teams 與 SharePoint 的 TCP 連線只要幾毫秒,同一條線路連 Outlook 卻要 15 秒以上,可以排除是本地網路或台灣對外線路的問題。狀態頁上 Azure 欄位也顯示沒有異常,這次故障應是 Microsoft 365 自身服務層的問題,不是 Azure 底層網路全面出狀況。
第二,前端代理在主動拒絕請求。 Outlook 網頁版、OWA 與 EWS(Exchange Web Services)回傳的 500 回應沒有內容,但標頭寫得很清楚:
x-proxyerrorlabel: Microsoft::M365::RoutingPlane::NanoProxy::HttpProxy::OnHttpRequest

x-proxyerrormessage: The network is busy.

x-proxyerrorhresult: 0x80070036

x-feserver: TP0P295CA0017
錯誤來自 Microsoft 365 路由層(RoutingPlane)的 NanoProxy 元件,HRESULT 0x80070036 對應 Windows 的 ERROR_NETWORK_BUSY。回應的前端伺服器代號以 TP 開頭,另一個請求的標頭也顯示第一跳在台北(x-firsthopcafeefz: TPE),代表台灣使用者是連到在地的前端節點,被擋下的地方也在這裡。
第三,同一個前端並非全部擋下。 同一時段對 Autodiscover 端點的請求就穿過了前端,由位於台灣的 Exchange 後端(標頭 x-calculatedbetarget 指向 TWNP295 機房的信箱伺服器)回應正常的參數錯誤訊息。這個現象與微軟「流量正在謹慎地重新導入」的說法一致:路由層看來是依協定或路徑分批放行,讓部分輕量請求先通過,把 OWA、EWS 這類較重的連線擋在門外。這只是單一時段的取樣,不代表微軟實際的放行規則。
第四,TCP 建線本身就很慢。 一般從台灣連到在地節點的 TCP 交握在 10 毫秒內完成,這次卻常常要 15 到 35 秒,型態上像是連線請求(SYN)被丟棄後,用戶端依指數退避一再重送。這與首篇引述的官方說法「建立安全連線的處理程序被壓垮」相呼應:前端連線處理能力不足時,連線在最前面的階段就會排隊或被丟棄。
19 時 25 分再測:台北節點好了,使用者卻被導走
微軟 19:04 宣布亞太區部分設備完成復原後,CyberQ 在 19:25 到 19:28 再跑一輪,結果反而更差:三個 Outlook 主機 9 次請求全部在 20 秒內連不上,放寬到 70 秒也一樣。其他 9 個端點仍然正常。
進一步檢查發現,Outlook 的 DNS 解析結果已經換了。outlook.office365.com 經由 CNAME 指向微軟的流量調度名稱 atm.outlook.mira.tm.svc.cloud.microsoft,18 時解析到的主要是兩個台北節點位址,19 時半則換成另一批位址(四次查詢合計 11 個,每次回 8 個),TTL 只有 1 到 10 秒。CyberQ 用 Cloudflare(1.1.1.1)、Google(8.8.8.8)與中華電信(168.95.1.1)三個公開解析器交叉查詢,答案一致,可以排除本地 DNS 快取的問題。
| 對象 | ICMP 往返時間 | TCP 443 連線 | 直接送 OWA 請求 |
|---|---|---|---|
| DNS 新導向的位址 | 測 5 個,都約 32 毫秒、無掉包 | 測 8 個,全部失敗(8 秒逾時) | 測 1 個,30 秒逾時 |
| 18 時使用的台北節點(2 個位址) | 約 4 毫秒 | 6 毫秒內成功 | 正常回應 HTTP 302,前端代號仍是 TP 開頭 |
這組數據說明了幾件事:DNS 新導向的節點離台灣較遠(往返約 32 毫秒,應在台灣以外),主機本身活著,但在 443 埠完全不接受新連線,看起來是過載或正在限流;台北節點則已經能正常處理 OWA 請求,只是沒有被 DNS 分配到流量。比較合理的解讀是,台北節點正處於微軟所說「排空流量、重啟、修復、分批恢復服務」流程中的某個階段,暫時被流量調度排除;而接手的境外節點同時承擔多地流量,撐不住。對台灣使用者來說,結果就是官方說亞太區已經改善,自己的 Outlook 卻比一個半小時前更難連上。
20 時 30 分第三次測試:情況沒有改變
微軟 20:00 的公告點名歐洲、日本、北美的恢復進度,沒有再提到台灣或亞太其他地區。CyberQ 在 20:30 到 20:33 再測一次,結果與 19 時半相同:
- Outlook 三個主機共 9 次請求,全部在 20 秒內逾時;其他 9 個端點全部正常。
- 三個公開解析器仍然把 outlook.office365.com 解析到同一批境外位址,實測其中 8 個,443 埠全部連不上。
- 直接連 18 時使用的台北節點,TCP 3 毫秒建立,OWA 正常回應 HTTP 302。
換句話說,台北節點看起來至少已經恢復了一個半小時,但流量調度還沒把台灣使用者導回去。
這批境外主機 ping 得到,同一條線路連其他 Microsoft 365 服務也都正常,本地網路造成的可能性不高。
四、為什麼一個健康檢查元件能拖垮全球服務
把微軟目前公開的資訊串起來,大致是這樣的連鎖:
- 負責判斷伺服器健康狀態的元件出錯,自動健康檢查把大量其實還能運作的伺服器判為不健康,移出服務。
- 剩下的伺服器承接全部流量,負載暴增。微軟也特別澄清,這不是使用者突然湧入造成的。
- 過載的伺服器上,負責建立安全連線的處理程序撐不住,開始無法處理請求,於是也被健康檢查判為不健康而移出。
- 重啟後的伺服器一接回流量,又因為積壓的重試與重新連線一起湧入而再度失去回應,復原因此一再反覆。
這是分散式系統文獻裡所說的「亞穩態故障」(metastable failure)的典型樣貌,觸發事件可能很小,但系統一旦進入過載,重試、重新連線與健康檢查摘除會形成正回饋,即使觸發原因已經排除,系統也無法自己回到正常狀態。要脫離這種狀態,通常得像微軟現在這樣,主動限流、分批放回容量,再慢慢把流量導回去,而不是把所有伺服器同時重啟。
TLS 交握在這種情境下特別吃重。大量的 Outlook 桌面版、行動裝置與 ActiveSync 用戶端在斷線後都會自動重連,重新建立連線時需要完整的交握計算,等於整個用戶端群體一起對剛恢復的伺服器發動重連風暴。這也解釋了為什麼伺服器重啟後又倒。
至於根本原因,目前仍有兩個說法需要分開看待。微軟官方 X 帳號說的是正在測試一項組態變更,處理伺服器無法通過自動健康檢查的問題,這是緩解手段;首篇引述的媒體報導則指出,有一項近期的組態變更在時間上與故障開始吻合,微軟正在回復。前者是修補措施,後者是時間上的相關性,都不是已經確認的根因,仍要等事後報告。
五、溝通面的觀察
一則韓文推文在幾小時內累積超過 28 萬次瀏覽,引起關注的不是故障本身,而是官方用語。作者截圖了 @MSFT365Status 的公告:我們正積極動用所有途徑降低影響,已暫停所有部署」,並說美國工程師看了都很驚訝,因為大企業的公告通常只會寫部分服務延遲。
凍結部署是大型雲端業者在重大事件中的標準動作,目的是避免新的變更干擾復原、也方便鎖定原因,但這麼直白地公開說出來確實少見。從這次的表現看,微軟在企業版公告上的透明度相對高,受影響功能列得很細,也主動說明不是流量增加與未發現惡意活動。
消費者版公告則是另一回事。消費者版的 Microsoft 365 公告從 14:24 之後就沒有更新,說好 16:30 前更新,直到 19:21 才補上,內容仍是持續多方調查以找出問題來源,19:55 的版本才加上復原工作持續進展一句,與企業版已經在談各區域復原進度的落差明顯。同一頁上 Outlook.com、OneDrive 等個別產品則一直顯示「正常運作」,但 CyberQ 18 時連 outlook.live.com 得到的是 HTTP 500,19 時半與 20 時半則完全連不上。個人用戶如果只看產品燈號,會得到錯誤的結論。
六、企業現在可以做的事
事件進行中:
- 用公開的狀態資料做監控。 status.cloud.microsoft 不需登入,背後有公開的 RSS(
https://status.cloud.microsoft/api/feed/mac)可以直接接進監控系統或通訊軟體的通知頻道,系統管理中心連不上時仍然可用。 - 提醒使用者小心「復原」主題的釣魚信。 大規模服務中斷後,常見攻擊者寄送假的「重新驗證帳號」「郵件已暫停,請點此恢復」通知。官方狀態資訊只會出現在 status.cloud.microsoft 與系統管理中心。
- Safe Links 改寫網址打不開是預期狀況。 建議告知使用者不要為了開連結而改用個人信箱轉寄,或把網址貼到其他裝置繞過防護。
- 不要急著重設 Outlook 設定檔或重新安裝。 這次是服務端問題,重設帳號只會在恢復後增加同步負擔。
- 不要自行修改 hosts 檔把 Outlook 指向特定 IP。 本文實測雖然發現台北節點可以直接連上,但那可能正是微軟刻意排空、尚未正式恢復服務的節點。把用戶端寫死到特定位址,等於繞過微軟的流量調度,恢復後也容易被遺忘而造成下一次故障。
事件結束後:
- 檢查郵件延遲與退信。 微軟把郵件逾時延長為 48 小時,但寄件方的郵件伺服器有自己的重試時限,對外重要往來信件仍要確認是否收到退信。
- 回頭檢視這段期間的郵件防護紀錄。 Safe Attachments、DLP 與敏感度標籤在中斷期間可能未正常執行,恢復後應查看訊息追蹤與稽核紀錄,確認是否有本該攔下卻放行的郵件,或本該加上標籤卻沒有加的文件。
- 確認 Intune 合規狀態與條件式存取。 裝置簽入受影響時,合規狀態可能過期,若條件式存取依賴合規判定,可能出現誤擋或誤放。
- 盤點對 Exchange Online 的隱性依賴。 這次 Teams 行事曆、Planner、Copilot、Power Apps 登入都因為依賴 Exchange 而受影響。企業的營運持續計畫裡,若把「郵件中斷」當成單一事件處理,可能低估了實際衝擊範圍。
CyberQ 觀點
這起事件已經持續超過 18 個小時。從實測看,台灣使用者的 Outlook 在晚間仍無法正常使用,而且復原過程本身也會造成新的不穩定:節點被排空、流量被導往他處,接手的節點又可能撐不住。官方說「亞太區已改善」與使用者實際感受之間,可能還會有一段落差。值得注意的是,這次沒有駭客、沒有流量暴增,引爆點是負責「判斷誰健康」的自動化元件。自動健康檢查本來是為了提高可用性而設計,但它一旦誤判,就成了最有效率的故障擴大器。
對企業來說,這次事件再次說明雲端服務的單一供應商風險不只是「信箱掛了」,而是郵件防護、資料外洩防護與裝置合規這幾條防線會同時失效。這些防線失效期間發生了什麼,恢復後要逐項回頭檢查。
後續追蹤重點:
- 台灣使用者何時被流量調度導回在地的台北節點,Outlook 何時恢復正常連線。
- 微軟何時宣告完全緩解,以及 EX1550543、MO1550821 的事後報告內容,特別是健康檢查元件出錯的原因與那項組態變更的角色。
- 健康檢查是否會加上「一次最多摘除多少比例伺服器」這類防護,避免自動化再次放大故障。
- 中斷期間 Defender for Office 365 與 Purview 未執行的政策,微軟是否補做,或需要客戶自行處理。
CyberQ 會持續追蹤,事後報告公布時再更新本文。
本文資料擷取時間:台灣時間 2026 年 11 月 13 日 20:33。實測於同日 18:00 至 18:08、19:25 至 19:33 與 20:30 至 20:33 三個時段進行。
延伸閱讀
BleepingComputer:Massive Microsoft 365 outage disrupts Outlook, Teams, Copilot worldwide