DeepSeek 在 10 月 17 日釋出 DeepSeek-V4.1-Flash-1017,官方定位是 V4.1-Flash 的小改版,但 agent 相關的分數拉得不少:Terminal-Bench 4.0 從 31.2 到 42.3、DeepSWE v1.1 從 74.2 到 77.0、Automation-Bench 從 54.8 到 60.5,輸出也變短。權重隔天就有社群做好兩台 DGX Spark 能放得下的 EXL3 量化版,於是我把它下載下來,用兩套雙機配方各跑一輪同樣的測試,一套是以 vLLM 為基礎的 Mia kit,另一套是專為 1017 寫的 TensorFold 配方。
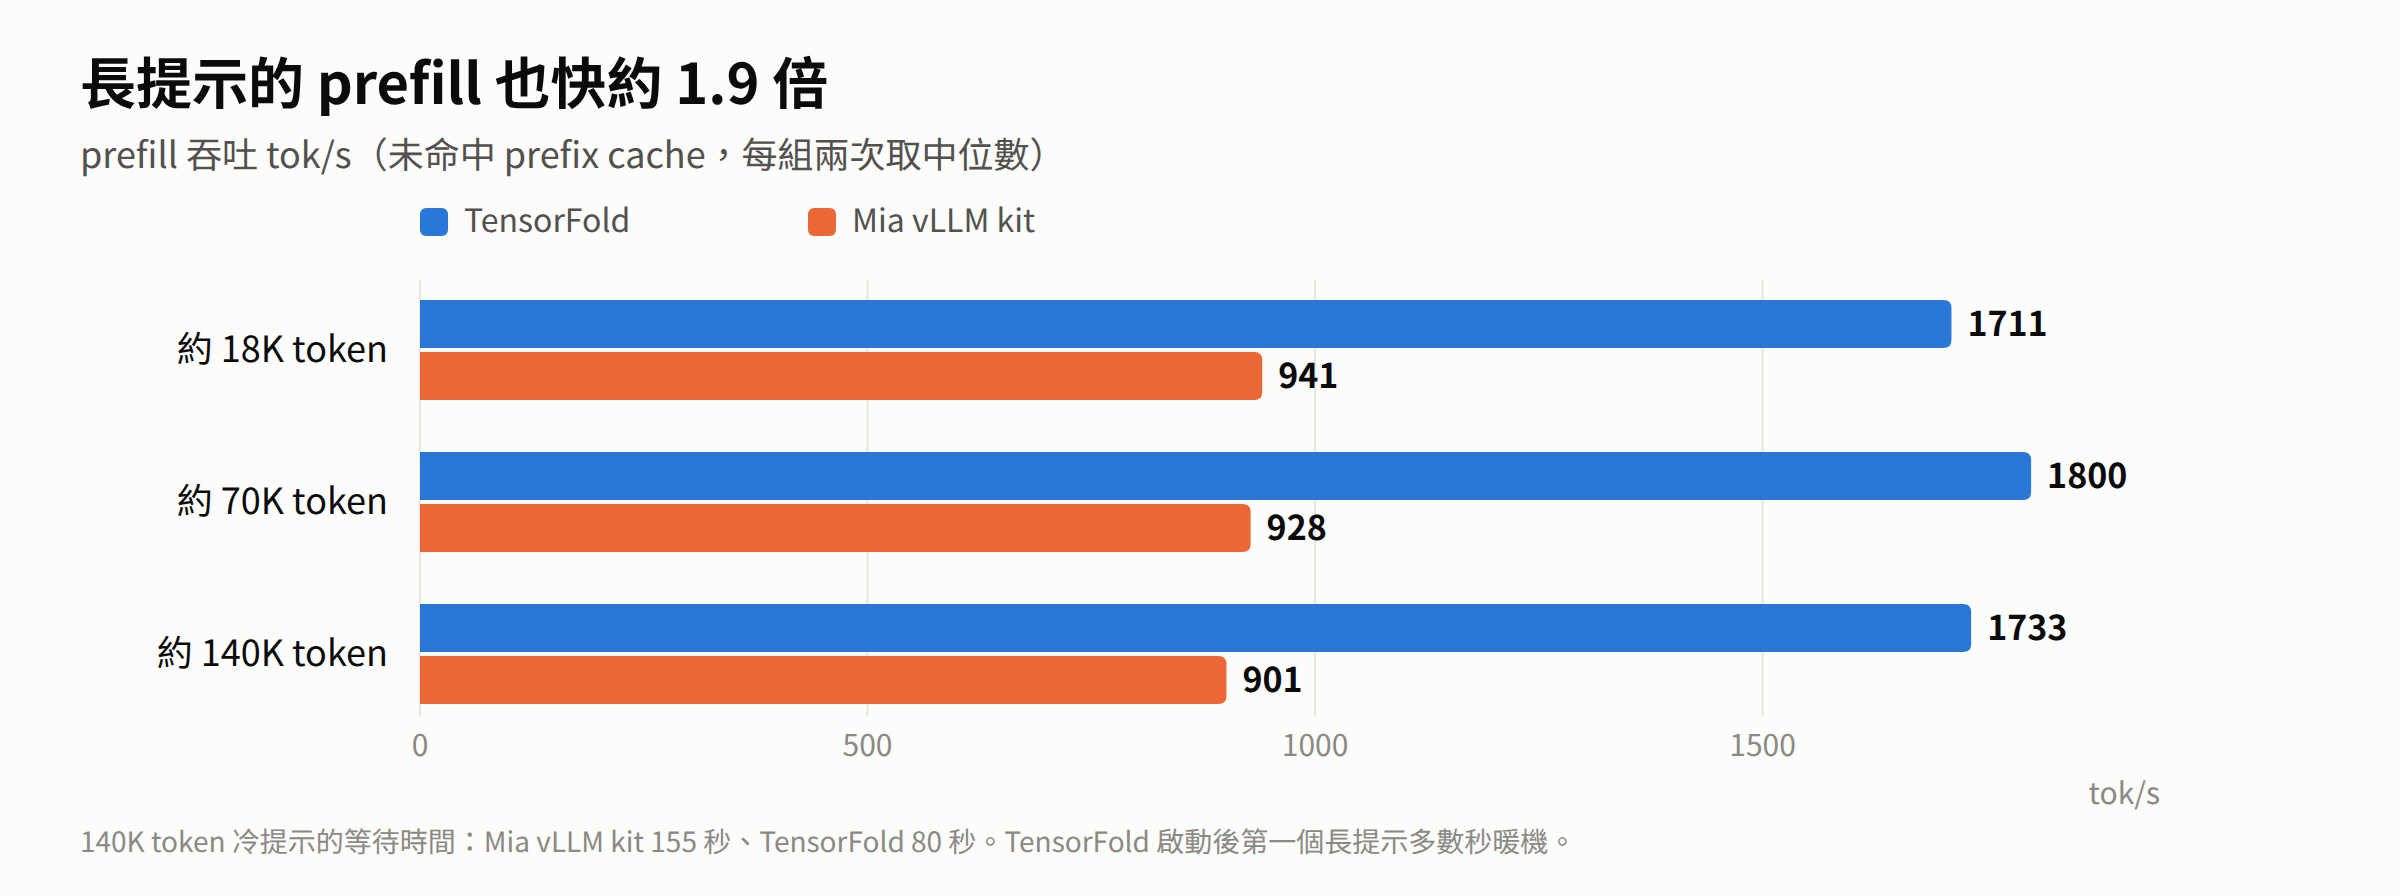
CyberQ 測試結果,同一份權重,TensorFold 的單路解碼是 vLLM kit 的 2.2 倍(57.5 對 26.1 tok/s),prefill 快約 1.9 倍,還能開到 4 路平行處理。正確性方面兩者打平,工具呼叫、長文取針、hermes 型長對話都沒有問題。這也讓 1017 成為目前 CyberQ 在這對機器上跑過最快的 V4.1,所以手邊的 hermes 助理後端已經換成 TensorFold 上的 1017。
一、1017 改了什麼
官方模型卡的說法是「minor update」,架構、config.json、tokenizer 與提示格式都沒有變,我也實際比對過兩版的 config.json,內容完全相同。但有兩件事會影響部署:
| 項目 | 說明 |
|---|---|
| 權重 | 48 個 shard 全部換新 |
| Engram 表 | 第 47、48 號 shard(各約 101.5 GB)也是新的,不能沿用舊版的 Engram |
| 提示編碼 | 官方同時修了 encoding/ 裡工具結果回合的處理,vLLM 對應的修正 PR(#62196、#62199、#62200)在我測試時還沒合併 |
| 建議取樣 | temperature 1.0、top_p 1.0 |
上游 vLLM 並沒有為 1017 推出新版本。vLLM 官方的部署配方已經把預設模型改成 1017,最低版本寫的是 0.31.0,原因就是架構沒變。不過原版 vLLM 讀不了 EXL3,而原生的 FP8/MXFP4 權重約 510 GB,兩台 DGX Spark 放不下,所以雙機只能走社群的量化版加社群引擎。
二、測試環境與權重
| 項目 | 內容 |
|---|---|
| 硬體 | 兩台 NVIDIA DGX Spark(GB10,各 128 GB 統一記憶體) |
| 互連 | ConnectX-7 直連,200GbE 線材,RoCE v2 |
| 平行方式 | TP=2,每台一個 rank |
| 權重 | LibertAIDAI/DeepSeek-V4.1-Flash-1017-EXL3-2.9bpw(43 個 shard,210.7 GB) |
| Engram | 官方 1017 repo 的第 47、48 號 shard(合計約 203 GB) |
這份 2.9 bpw 量化的張量配置與先前 Mia-AiLab 的 V4.1 2.9 bpw 逐張相同,作者公布的困惑度是程式碼 +1.8%、散文 +0.4%(相對未量化)。兩套配方用的是同一份檔案,用 TensorFold 配方附的 53 個 sha256 逐檔驗過兩台的副本,權重與 Engram 全數相符。TensorFold 作者實測時用的權重 revision 與我下載的版本只差 README,權重檔完全相同。
兩套配方:
| Mia vLLM kit | TensorFold | |
|---|---|---|
| 版本 | MiaAI-Lab kit 6f7d159 | Elevatormusic 配方 b97ee60,引擎 fd2365042f56 |
| 引擎 | vLLM(deepseekv41-flash-0909 特製基底)加 EXL3 外掛 | TensorFold(Python 引擎,bertholomus 的 V4.1 實作) |
| 投機解碼 | DSpark,k=3 | DSpark,5 個草稿 |
| 併發 | 2 路 | 4 路 |
三、下載與佈署:踩到的四個坑
整包約 414 GB,因此先把權重下載到 NAS 再拷到兩台本機,Engram 則由兩台各下載一個 shard,最後透過 CX7 互相補齊,從開始下載到兩台檔案全部就位約 2.5 小時。測試時留意到 TensorFold 的思考模式預設是開的。它的文件寫「Thinking is off by default」,但沒加參數時,只要聊天模板支援就會開思考,問「17×19 等於多少」,16 個 token 全花在推理上,content 是空的。伺服器端加上 --no-thinking 才會和文件說的一樣。這點對接 LiteLLM 這類代理特別重要,代理常會把 reasoning_effort 丟掉,後端的預設值就是實際行為。
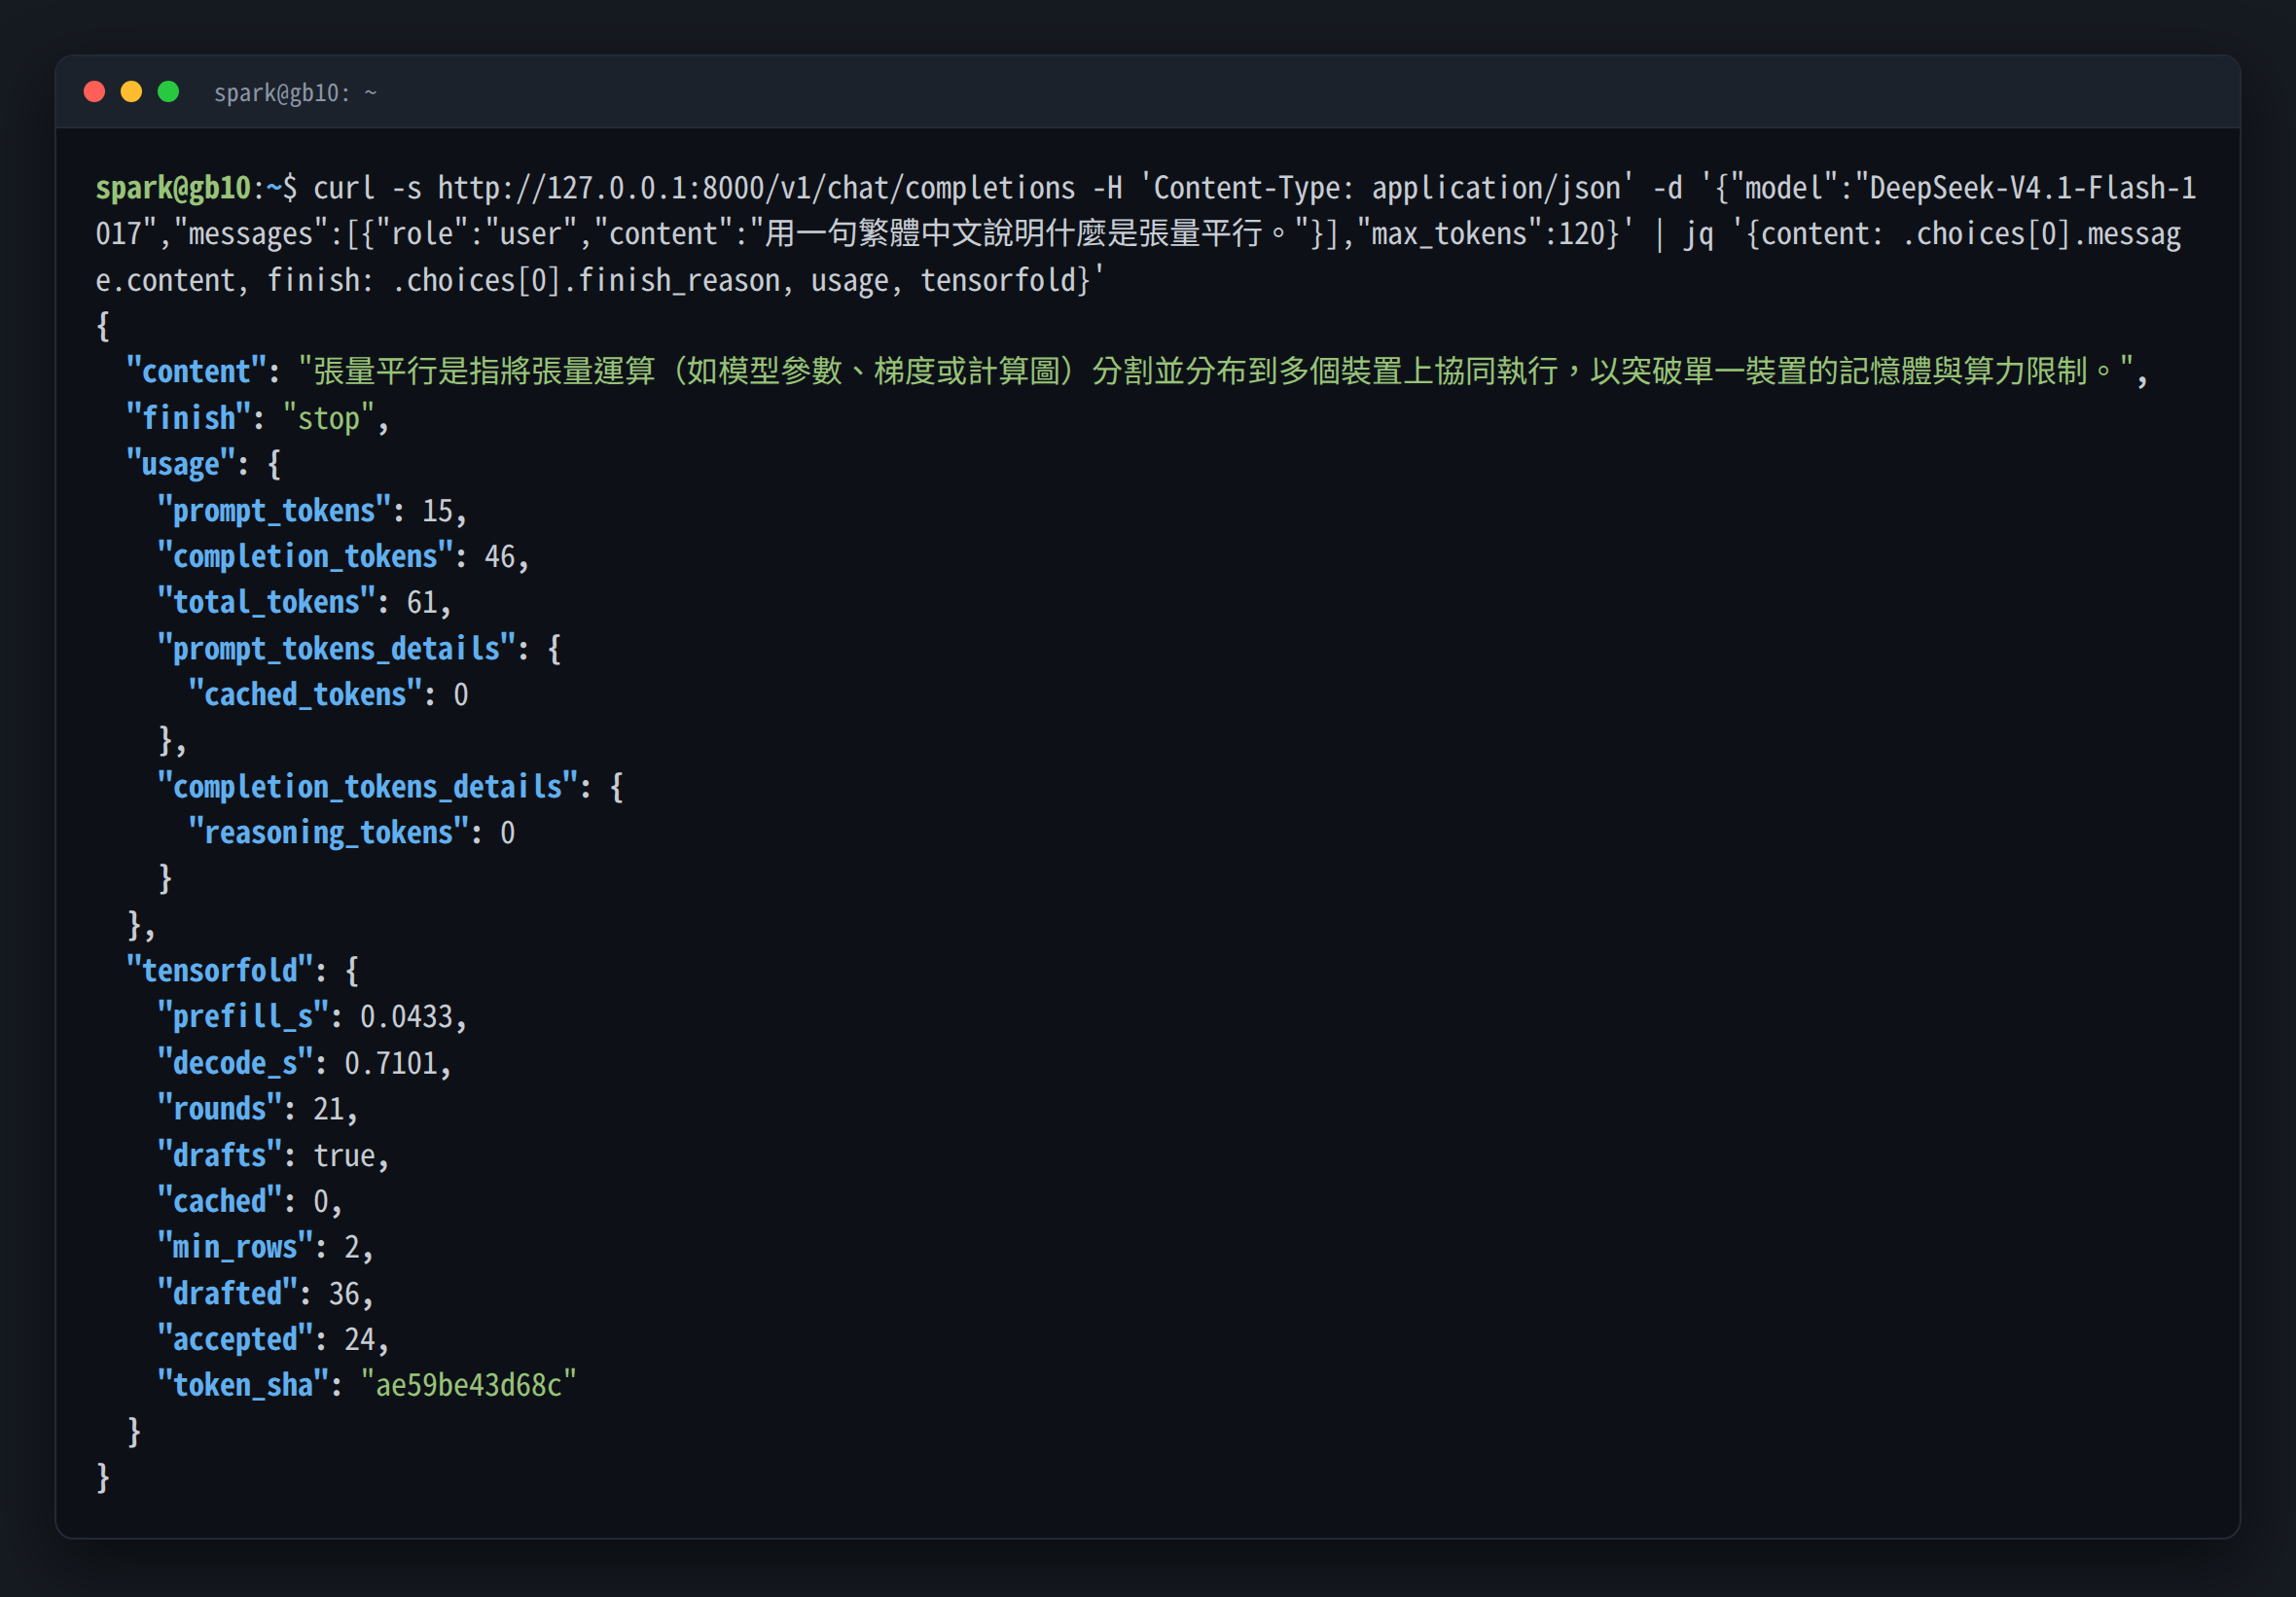
--no-thinking 後,reasoning_tokens 是 0,content 直接就是答案。TensorFold 會在回應裡附上 tensorfold 欄位,這一筆投機解碼草稿了 36 個 token、接受 24 個。權重放在本機 NVMe 之後,啟動時間也很可觀,Mia kit 從起跑到就緒 8 分鐘,TensorFold 第一次啟動要寫入 rank 快取,花 8 分鐘,之後重啟只要 2 分鐘左右。
四、速度
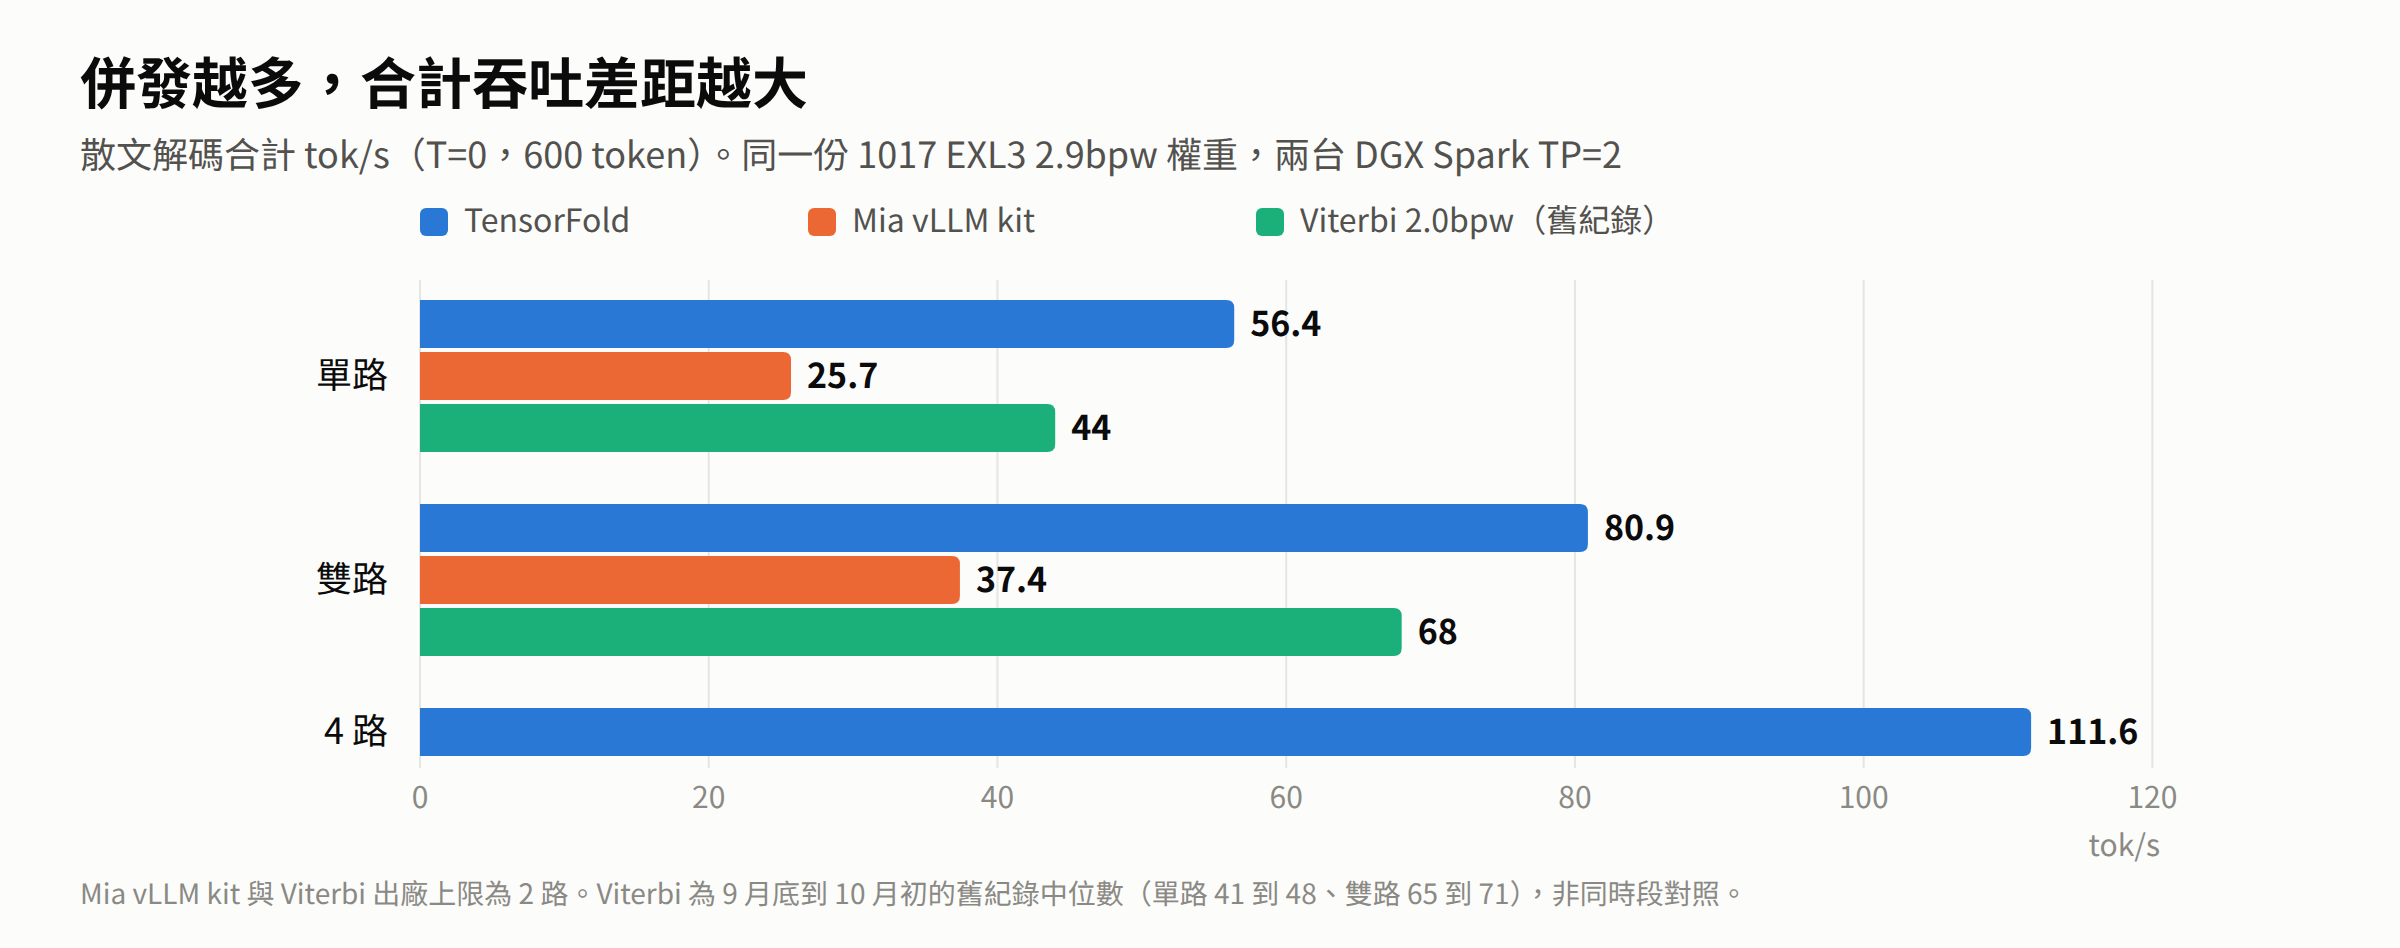
散文解碼(600 token,中位數)
| 溫度 | 併發 | Mia vLLM kit 每路 | Mia 合計 | TensorFold 每路 | TensorFold 合計 |
|---|---|---|---|---|---|
| 0.0 | 1 | 26.1 | 25.7 | 57.5 | 56.4 |
| 0.0 | 2 | 19.7 | 37.4 | 41.6 | 80.9 |
| 0.0 | 4 | 不支援 | 30.1 | 111.6 | |
| 0.7 | 1 | 25.1 | 24.7 | 52.0 | 51.2 |
| 0.7 | 2 | 18.9 | 37.3 | 41.7 | 79.7 |
| 0.7 | 4 | 不支援 | 29.2 | 108.4 | |
| 1.0(官方建議) | 1 | 23.6 | 23.3 | 49.8 | 48.8 |
| 1.0(官方建議) | 2 | 19.3 | 36.5 | 38.8 | 72.9 |
| 1.0(官方建議) | 4 | 不支援 | 29.8 | 102.8 |
單位都是 tok/s。投機解碼的速度一定要看取樣設定,所以三種溫度都測試了。從貪婪換到官方建議的 temperature 1.0,Mia 單路掉約 10%、TensorFold 掉約 13%,兩者的差距大致維持在 2 倍。
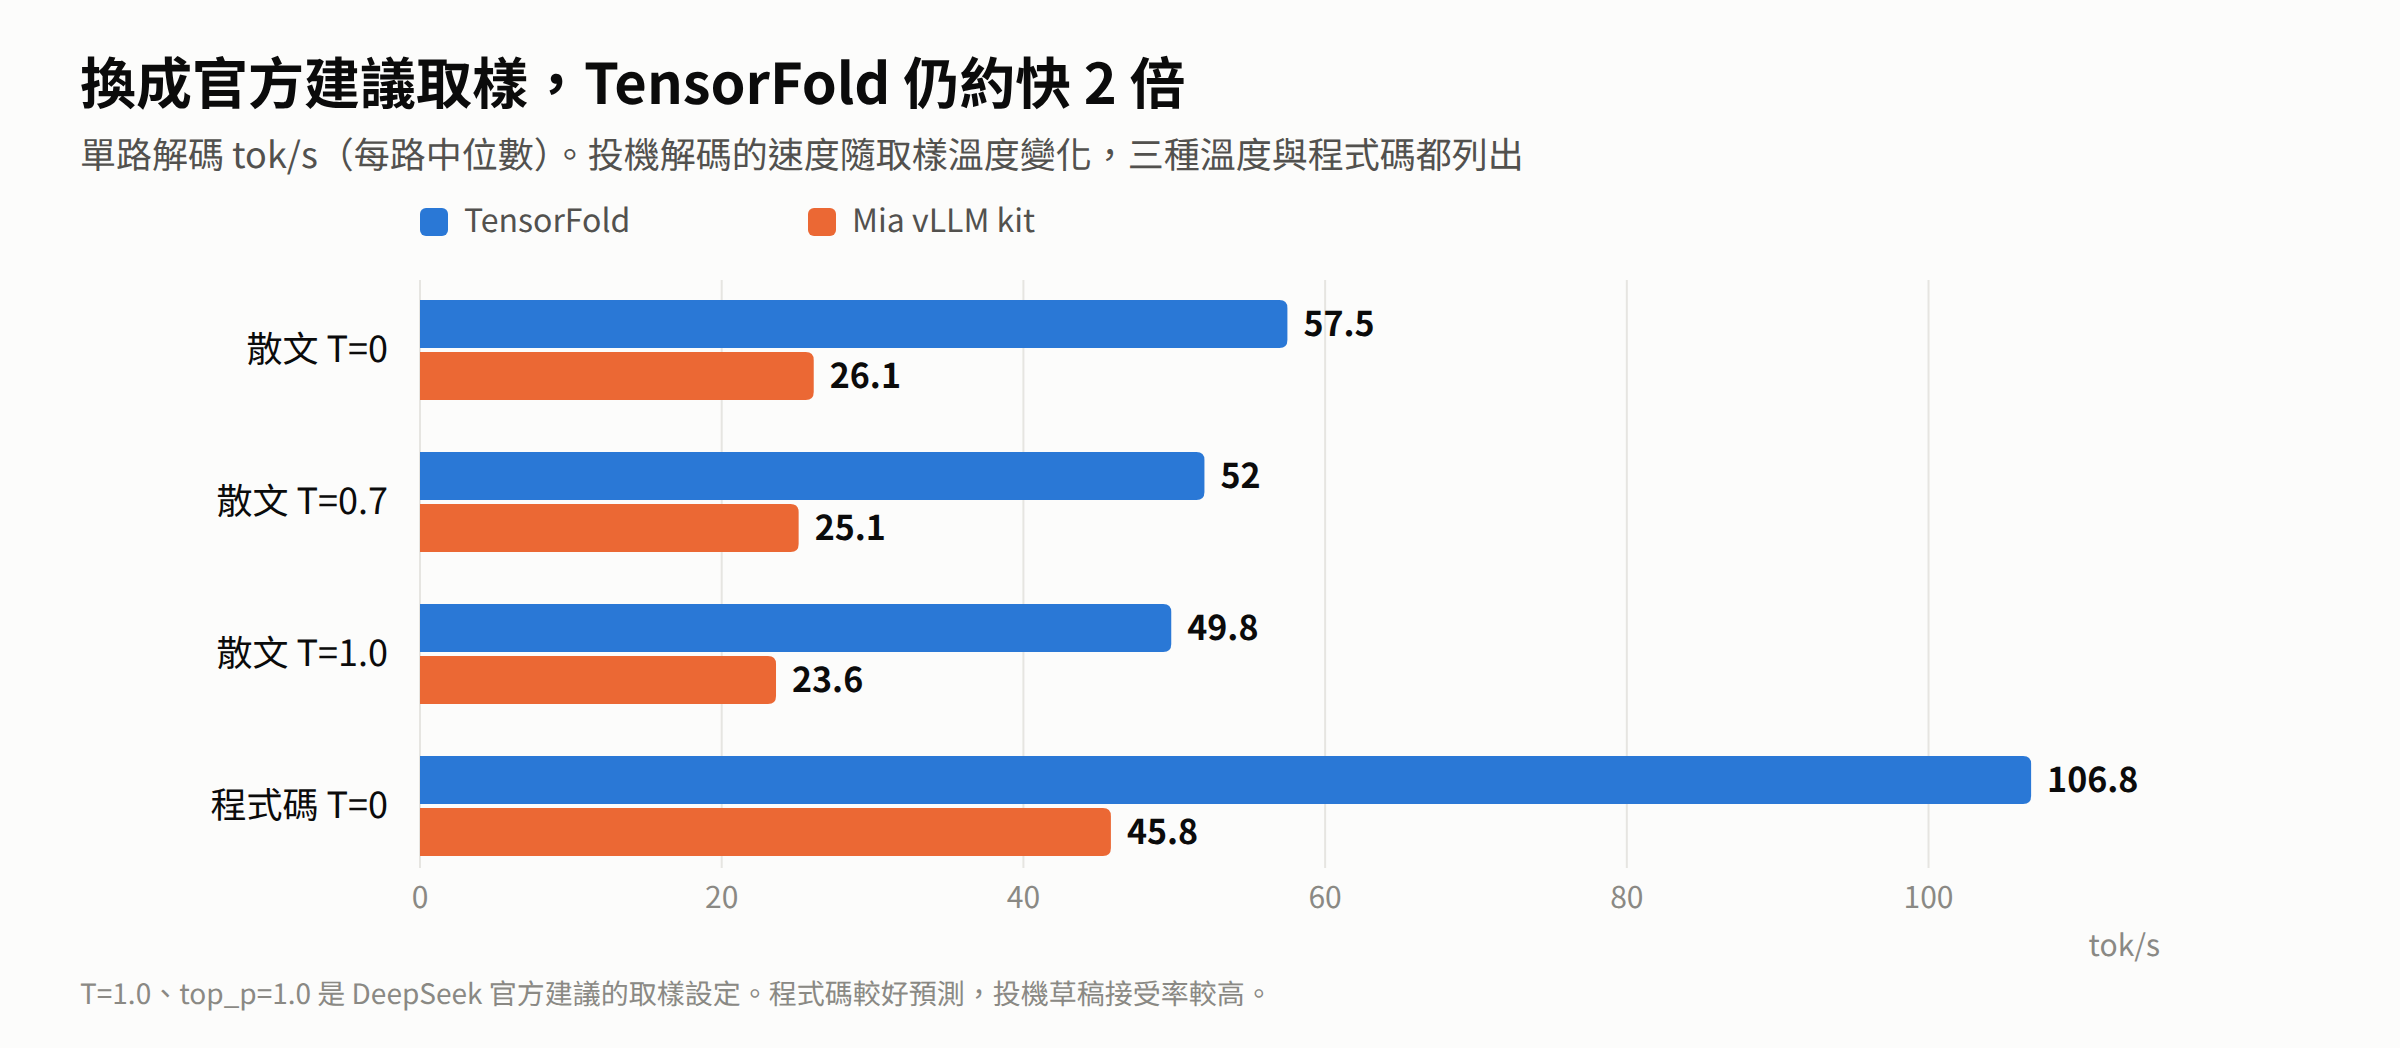
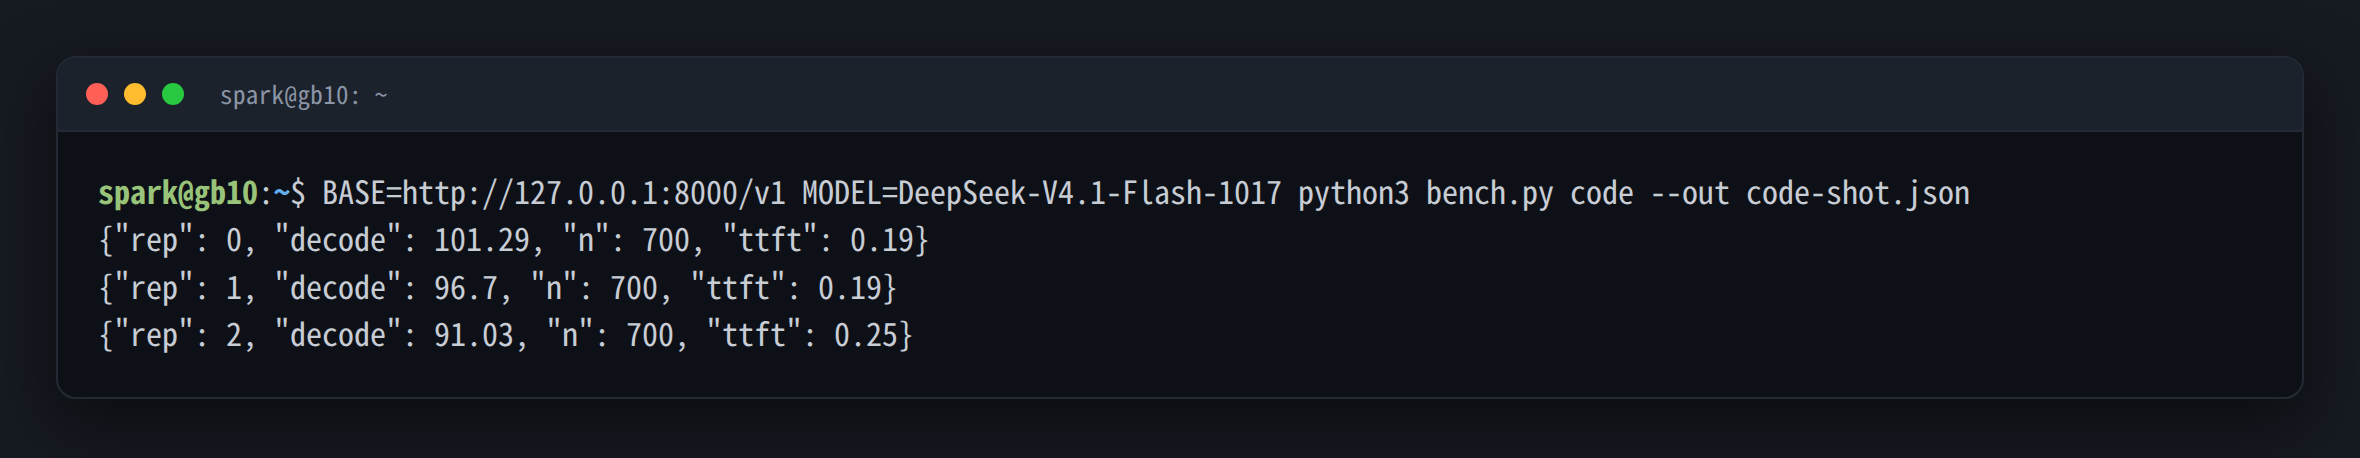
程式碼解碼(700 token,T=0)
| 中位數 | |
|---|---|
| Mia vLLM kit | 45.8 tok/s |
| TensorFold | 106.8 tok/s |
程式碼比散文好預測,投機草稿被接受得多,所以兩邊都比散文快,TensorFold 的優勢也拉大到 2.3 倍。這和 TensorFold 配方卡片上公布的倍數(文字 2.1 倍、程式碼 2.3 倍)一致。
prefill(沒有命中 prefix cache)
| 提示長度 | Mia vLLM kit | TensorFold |
|---|---|---|
| 約 18K token | 941 tok/s | 1,711 tok/s |
| 約 70K token | 928 tok/s | 1,800 tok/s |
| 約 140K token | 901 tok/s | 1,733 tok/s |
換成等待時間,140K token 的冷提示,Mia 要 155 秒,TensorFold 是 80 秒。TensorFold 啟動後第一個長提示會多花幾秒暖機,所以 18K 那組的兩次分別是 1,498 與 1,923 tok/s,表中取中位數。
仿 hermes 的長對話
這組題目模擬 hermes 助理的真實負載,system prompt 約 2.5 萬字,對話歷史 6 萬到 11.7 萬字,換算成 39K 到 70K token,最後要求整理對話裡文件的內容。
| Mia vLLM kit | TensorFold | |
|---|---|---|
| 長上下文下的解碼 | 32 到 39 tok/s | 57 到 77 tok/s |
| 冷啟動 TTFT(39K token) | 47 秒 | 22 秒 |
| 命中 prefix cache 後的 TTFT | 0.6 到 5.6 秒 | 0.45 到 1.9 秒 |
多輪對話會重送大量相同的前綴,兩個引擎的 prefix cache 都有正確命中,這對 agent 類應用的體感影響最大。
五、正確性
速度快不代表能用,所以每一項都同時檢查輸出。
| 項目 | Mia vLLM kit | TensorFold |
|---|---|---|
| 長文取針(31K 與 86.5K token,三個深度) | 3/3 | 3/3 |
| 工具呼叫(單一、選工具、平行、工具結果後續、思考模式後續、強制指定) | 6/6 | 6/6 |
| 10 題有標準答案的數學推理,關思考 | 9/10 | 9/10 |
| 同上,開思考 | 10/10 | 10/10 |
| 長對話輸出的簡體字 | 0 | 0 |
幾個細節:
- 強制指定工具:兩邊都正確呼叫了指定的工具,但 Mia kit 的
finish_reason回stop,TensorFold 回規範的tool_calls。只看finish_reason判斷有沒有工具呼叫的客戶端,接 Mia kit 可能會漏接。這也是 TensorFold 配方作者說自己修過的地方。 - 關思考時各錯一題,錯的題目不同,Mia kit 在「2026 有幾種連續正整數和的寫法」推理正確,卻反覆驗算到 1,500 token 上限被截斷,TensorFold 在中國剩餘定理那題改用逐項列舉,同樣被截斷。兩邊權重相同,差別在 kernel 的數值細節讓貪婪解碼走上不同路徑。開思考之後兩邊都 10/10。
- 開思考的成本很低:10 題開思考的總輸出是 2,845 與 3,547 token,和關思考時(2,642 與 2,658)差不多。這和官方說 1017 輸出變短的方向一致。
- 長對話不亂碼:我先前在舊版 V4.1 的 2.0 bpw 量化上遇過長對話後半夾雜簡體字與不相干詞的問題。這次 12 組長對話(兩個引擎合計 24 次)輸出的簡體字都是 0,回答也都正確指出文件只有 TP 的資料、沒有 PP,沒有硬編數字。
另外請 Gemini 4 Argon 當評審,對兩個引擎各 4 篇的短文做盲評(隨機標成 A、B,不告知來源)。結果 TensorFold 3 勝、Mia kit 1 勝,總分 34 比 28,評審還抓到 Mia kit 一篇裡出現了簡體字「万一」,是我自己的簡體偵測字表漏掉的字。不過評審只有一位、每題只取樣一次,兩邊權重又相同,這個差距大半是取樣雜訊,只能當參考。
六、溫度與記憶體
| 引擎 | 節點 | 最低可用記憶體 | GPU 最高溫 | 整機功耗最高 | 機殼熱區最高/平均 |
|---|---|---|---|---|---|
| Mia vLLM kit | head | 5 GiB | 87°C | 75.7 W | 94/83.5°C |
| Mia vLLM kit | worker | 7 GiB | 85°C | 74.0 W | 91/79.5°C |
| TensorFold | head | 5 GiB | 86°C | 78.8 W | 94/85.5°C |
| TensorFold | worker | 5 GiB | 85°C | 76.5 W | 94/82.8°C |
兩個引擎在滿載量測下的溫度與記憶體餘裕幾乎一樣,都是把 128 GB 用到只剩約 5 GiB。我先前遇過 GB10 在熱區長時間停在 91 度以上時無預警斷電,所以這次測試在每一項之間都加了冷卻閘門,兩台 GPU 降到 60 度、熱區降到 78 度以下才開始下一項。降溫通常只要一兩分鐘,代價很小。日常的助理負載遠低於這種連續壓測,不會長時間停在高溫區。
七、跟先前的後端比
在這次測試之前,hermes 跑的是 sfxnz 的 V4.1 Viterbi 2.0 bpw(vLLM 雙機)。它的權重已經移到 NAS 備份,這次沒有在同一套題目上重跑,以下是它 9 月底到 10 月初的實測紀錄,不是同時段的對照:
| Viterbi 2.0 bpw(舊紀錄) | 1017 on TensorFold(本次) | |
|---|---|---|
| 單路解碼 | 約 41 到 48 tok/s | 57.5 tok/s(T=0) |
| 雙路合計 | 65 到 71 tok/s | 80.9 tok/s |
| 最大併發 | 2 路 | 4 路 |
| 70K prefill | 約 805 到 821 tok/s | 1,800 tok/s |
| 量化位元 | 2.0 bpw | 2.9 bpw |
| 模型版本 | V4.1-Flash(9 月版) | V4.1-Flash-1017 |
八、決定 hermes 改接 1017 on TensorFold
綜合起來,把手邊 hermes 助理的後端換成 TensorFold 上的 1017。理由有四個:
- 最快:單路 57.5 tok/s,比先前的 Viterbi 快約三成,prefill 快一倍以上。
- 能併發:4 路。hermes 在背景跑排程摘要時,前景對話不必再排隊。
- 模型與量化都更好:1017 本身強化了 agent 任務,量化也從 2.0 bpw 提高到 2.9 bpw。
- 工具呼叫格式最標準:強制指定工具的回應格式也正確。
接法很簡單,TensorFold 綁在原本的連接埠,加一個舊的服務名稱當別名,前面的 LiteLLM 代理與 hermes 的設定都不用改。上線後經代理實測,繁中回答與工具呼叫都正常,思考模式維持關閉。
風險也要講清楚:
- TensorFold 是年輕的 fork,不是 vLLM。遇到裝置錯誤時兩個 rank 會一起結束,不會自動重啟,要手動重新啟動。
- 閒置後的第一筆請求較慢:服務閒置約 20 分鐘後,一筆只有 15 個 token 的短提示,prefill 花了 6.4 秒;緊接著再送同一筆只要 0.04 秒。對互動式對話的影響是偶爾第一句回得慢。
- 記憶體只剩約 5 GiB,碰上過度配置一樣可能整台卡死,同機不能再放別的模型。
- 提示編碼還差一個修正:兩個引擎都沿用 Mia kit 的聊天模板,1017 參考實作對「思考模式下工具結果回合」的修正,上游 vLLM 還沒合併。hermes 預設不開思考,影響不大,之後會追蹤。
- 只測了一天:長時間穩定性要靠接下來的觀察。舊的 Viterbi 權重保留在 NAS,回退約需 20 到 30 分鐘。
至於這次 DeepSeek V4.1 Flash 1017 的影像輸入、超過 140K token 的上下文與 GSM8K 測試資料集全集,已在接下來的第二篇測試中呈現。
採用模型與相關資料
DeepSeek:DeepSeek-V4.1-Flash-1017 與 Engram 表(MIT)。
LibertAIDAI:EXL3 2.9 bpw 量化權重(MIT)。
MiaAI-Lab:vLLM 雙機 kit 與聊天模板(AGPL-3.0)。
Elevatormusic:TensorFold 雙機配方(Apache-2.0)。bertholomus:V4.1 的 TensorFold 引擎實作。ashhart 與 TensorFold 的貢獻者。
turboderp:ExLlamaV3 與 EXL3 格式(MIT)。