一本厚書大小的地端 AI 主機,2026 年下半年該怎麼買
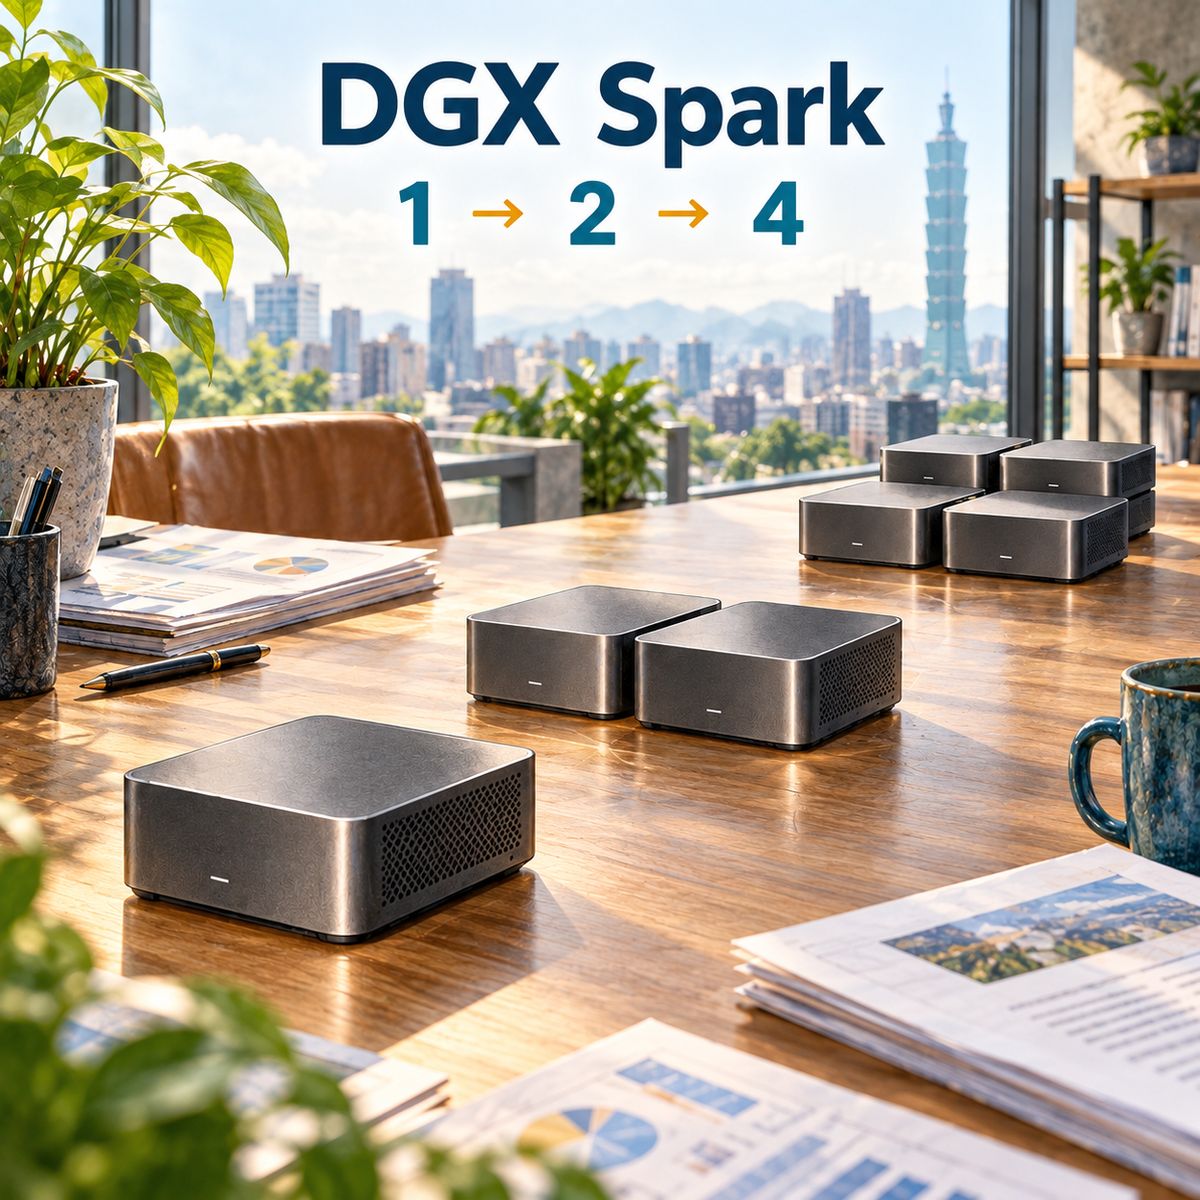
一台 DGX Spark 能穩定跑 30B 級的日常模型,兩台能撐起 500B 級的 MoE 旗艦模型,四台則進入 750B 級與百萬 token 長文本的領域。這是社群過去一年在 GB10 平台上累積出來的實測結論,也是本文要替中小企業整理的採購依據。
NVIDIA DGX Spark 自 2025 年 10 月開賣至今將近一年,記憶體缺貨讓建議售價從 3,999 美元調到 4,699 美元,但開源模型的進步速度遠快於漲價幅度。2026 年 4 月的 Qwen3.6-35B-A3B、8 月的 GLM-5.3-Flash 與 Qwen3.8-Flash-Next、9 月的 DeepSeek-V4.1-Flash,都是為稀疏啟動與低 KV Cache 而設計的模型,正好落在 128GB 統一記憶體的甜蜜點上。
本文以 CyberQ 自有的雙機 DGX Spark 叢集為基準,再交叉比對 NVIDIA 官方 Playbook 與社群公開的三機、四機配方,分成 1 台、2 台、4 台三種方案,各自給出可以實際部署的模型組合。原始參考資料中部分模型名稱與規格與公開資訊不符,文末勘誤說明會逐條列出。
先看清楚 GB10 的硬體真相,容量大但頻寬有限
DGX Spark 的價值在 128GB 統一記憶體與內建的 ConnectX-7 網卡,弱點則是 273 GB/s 的記憶體頻寬。這個數字約為 H100 的十二分之一,決定了它適合跑「總參數大、啟動參數小」的 MoE 模型,而不適合硬跑 70B 以上的稠密模型。
| 項目 | 規格 | 對中小企業的意義 |
|---|---|---|
| 晶片 | GB10 Grace Blackwell,20 核 Arm CPU + Blackwell GPU,FP4 約 1 PFLOP | 原生支援 NVFP4 量化格式,模型體積可壓到 BF16 的四分之一 |
| 記憶體 | 128GB LPDDR5x 統一記憶體,273 GB/s | 單機可載入約 200B 參數的 FP4 模型,解碼速度受頻寬限制 |
| 網路 | 2 個 QSFP 埠(ConnectX-7,每埠 200GbE)+ 10GbE RJ-45 + Wi-Fi 7 | 兩台直連免交換器,三台可接成環狀,四台以上需要 200G 交換器 |
| 儲存 | 1TB 或 4TB 自加密 NVMe | 4TB 版才放得下多個 200GB 級的量化模型 |
| 供電與體積 | 240W 外接變壓器,150 × 150 × 50.5 mm,1.2 kg | 一般辦公室插座即可,建議環境溫度 5 至 30°C |
規格來源為 NVIDIA DGX Spark 官方硬體文件,頻寬對比引自 GPUSmith。
串接方式決定了採購上限
依據 NVIDIA Playbook,兩台用一條 QSFP 直連線即可,三台用三條線接成環狀拓樸,每台都用到兩個埠。第四台開始必須加購 200G 交換器,Petronella 的公開實測採用 MikroTik CRS812 搭配分接線,直連與經交換器的 RDMA 頻寬都量到約 196 Gb/s。ServeTheHome 的拆解則指出 ConnectX-7 走 PCIe Gen5 x4 通道,一般 TCP 傳輸實測約 100 Gbps,規劃時不宜以標稱值推估。
台灣售價目前浮動大,採購前務必重新詢價
麗臺代理的創始版原始建議售價為新台幣 15.9 萬元,2026 年 3 月 NVIDIA 全球調漲後,9 月通路報價已來到 19.6 萬元至 21.9 萬元起。華碩 Ascent GX10 1TB 版在電商平台約 17.5 萬元。本文速查表以每台 16 萬至 22 萬元估算,實際成交價會有些微不同。
方案 A,1 台 DGX Spark,128GB記憶體把 30B 級模型跑到極致
單機的最佳解是 Qwen3.6-35B-A3B,以 BF16 無損格式部署只占約 70GB,剩下的記憶體足以撐起 256K 上下文與多人併發。這台機器不該拿來硬跑 70B 稠密模型,GPUSmith 整理的實測顯示 Llama 3.1 70B 在單機只剩 2.7 tok/s,而 8B 模型在批次 32 時可達 368 tok/s,差距完全來自記憶體頻寬。
| 模型 | 規模與授權 | 建議格式與占用 | 適合的工作 |
|---|---|---|---|
| Qwen3.6-35B-A3B | 35B 總參數,3B 啟動,Apache 2.0,原生 262K 上下文,支援圖片與影片輸入 | BF16 約 70GB,Q8 約 33GB | 日常助理、程式代理、RAG 問答。SWE-bench Verified 73.4% |
| Qwen3.6-27B | 27B 稠密模型,Qwen3.6 家族的稠密版本 | BF16 約 54GB | 對輸出穩定度要求高、可接受較低吞吐的文件審閱 |
| Step 3.5 Flash | 196B 總參數,11B 啟動,Apache 2.0,256K 上下文 | NVFP4 約 100GB,單機上限 | 需要更強推理深度的單機部署,SWE-bench Verified 74.4% |
| Qwen3.8-Flash-Next | 125B 主體 + 51B N-gram 表,6B 啟動,Qwen4 架構預覽 | NVFP4 主體約 65GB,N-gram 表可卸載至 CPU 記憶體 | 高流量工具呼叫與辦公自動化,Spark 實測吞吐待查 |
單機的分工建議是一機一模型。 Qwen3.6-35B-A3B 當主力,繁體中文與工具呼叫表現穩定,3B 啟動參數讓解碼速度不受頻寬拖累。若團隊需要更深的推理能力,Step 3.5 Flash 在 NVFP4 下剛好塞進單機,但記憶體幾乎用滿,上下文要壓在 64K 以內。
上下文不是單機的瓶頸。 原始參考資料建議單機把上下文壓在 8K 至 16K,這是稠密模型時代的經驗。MoE 模型的 KV Cache 占用遠低於同級稠密模型,Qwen3.6-35B-A3B 在 128GB 環境下開到 128K 上下文仍有餘裕,實際上限視併發人數而定。
適用場景。 5 至 15 人的團隊,需要私有知識庫問答、內部文件摘要、程式碼輔助,資料不能離開公司網段。單機每月電費以 240W 滿載估算約 175 度,是所有方案中最容易通過總務審核的一種。
方案 B,2 台 DGX Spark,256GB 記憶體加一條線換來 500B 級模型
雙機是目前社群配方最成熟、性價比最高的配置,一條 0.5 公尺 QSFP 直連線就能把兩台合併成 256GB 記憶體池。最具代表性的成果是 DeepSeek-V4-Flash-0731 在兩台上以 NVFP4 KV Cache 開到 100 萬 token 上下文,tonyd2wild 的公開配方量到單串流典型 55 tok/s、峰值 78 tok/s。
| 模型 | 規模與授權 | 雙機部署方式 | 社群實測 |
|---|---|---|---|
| DeepSeek-V4-Flash-0731 | 前代 Flash,MIT | FP8 權重約 149GB 分片至兩台,TP=2,DSpark 投機解碼 | FP8 單串流約 41 tok/s,併發總和約 350 tok/s,200K 上下文 |
| DeepSeek-V4.1-Flash | 552B 主體 + 196B Engram 記憶,8B/16B 啟動,MIT,2026 年 9 月 10 日發布 | 社群主流配方為三至四台,兩台屬實驗性質 | CyberQ 在兩台 GB10 完成 vLLM 補丁移植,紀錄見鐵人賽 Day 10,吞吐數據待補 |
| Qwen3.5-397B-A17B | 397B 總參數,17B 啟動,Apache 2.0 | Intel int4 AutoRound 版,每台占約 112GB,其餘服務都要關閉 | 單人 26 至 30 tok/s,兩人併發總和 42 至 46 tok/s,262K 上下文 |
| Step 3.5 Flash | 196B 總參數,11B 啟動,Apache 2.0 | FP8 約 200GB 分片,可保留完整 256K 上下文 | Spark 雙機數據待查,API 端 100 至 300 tok/s |
| GLM-5.3-Flash | 320B 總參數,18B 啟動,MIT,原生多模態,1M 上下文 | 官方 FP8 版 328GB 超過雙機容量,需 NVFP4 版 | Spark 雙機數據待查 |
| MiMo-V2.5 | 310B 總參數,15B 啟動,MIT,支援圖片、影片、音訊 | NVFP4 約 160GB 分片 | Spark 雙機數據待查 |
DeepSeek V4.1 Flash 的 KV Cache 縮減是雙機最大的紅利
依據 DeepSeek 官方模型卡,V4.1-Flash 採用因果編碼器解碼器架構,全域 KV Cache 壓到每 token 890 bytes,約為前代 V4-Flash 的四分之一。這代表同樣 256GB 的記憶體,可以留給更多併發請求或更長的文件。不過 552B 主體加上 196B Engram 表,以 4-bit 量化估算仍超過 276GB,兩台要跑得起來必須把 Engram 表放到 NVMe 並使用 MXFP4 專家權重,MiaAI-Lab 的配方因此以三台為起點。
不串接的分工策略同樣有價值
NVIDIA 開發者論壇上有使用者指出,Qwen3.5-122B-A10B FP8 在單機約 31 tok/s,兩台各跑一個 122B 模型的總吞吐與擴充彈性,反而優於串接跑一個 397B 的 int4 版。中小企業若主要負載是客服與程式生成,建議一台跑 Qwen3.6-35B-A3B 處理高頻請求,另一台跑 Step 3.5 Flash 負責需要深度推理的合約審閱與資料分析,兩台各自獨立,任一台維護時另一台不受影響。
適用場景
15 至 50 人的公司,已有內部工作流程需要 AI 代理人串接多個系統,或必須在地端處理整份合約、財報與程式庫。雙機的軟體門檻明顯高於單機,需要一位能維護 vLLM 或 SGLang 容器、處理 RoCE 網路設定的工程師。
方案 C,3 至 4 台 DGX Spark,384GB 至 512GB 記憶體換來更好的上下文與平行處理能力
三台是免交換器的上限,也是 750B 級模型不必剪枝就能載入的門檻,四台則把 DeepSeek 與 GLM 旗艦模型的上下文推到 100 萬 token。要先說清楚的是,四台叢集的 512GB 記憶體仍然放不下 DeepSeek-V4.1-Flash 的 BF16 版本,552B 主體以 BF16 計算就超過 1.1TB,即使 FP8 也有 552GB。四台 GB10 換來的不是無損精度,而是更長的上下文、更高的平行處理與投機解碼的空間。
| 配置 | 代表模型與格式 | 社群實測 | 來源 |
|---|---|---|---|
| 3 台,環狀直連 | DeepSeek-V4.1-Flash,MXFP4 專家 + FP8 稠密權重,Engram 表放 NVMe,SGLang | 單串流 87.7 tok/s,5 路併發總和 342.7 tok/s,驗證通過 101 萬 token 的大海撈針 | MiaAI-Lab |
| 3 台,環狀直連 | GLM-5.2 剪枝至 469B,NVFP4,vLLM 管線平行 | 256K 上下文,約 4.4 tok/s | bird/GLM-spark |
| 4 台,經 200G 交換器 | GLM-5.2 完整 753B,NVFP4,4 路 KV 分片 + DSpark 投機解碼 | 1M 上下文,約 24.7 tok/s,較三台版快 5.6 倍 | bird/GLM-spark 4x 配方 |
| 4 台,經 CRS312 交換器 | GLM-5.2-Int4,模型檔放在 NAS 以 NFS 共享 | 單路 20.16 tok/s | OpenZeka |
| 4 台 | Qwen3.5-397B-A17B,NVFP4,張量平行 | 3 台 ASUS GX10 + 1 台 Dell GB10 混搭成功 | Level1Techs |
| 4 台以上 | MiniMax M2.5,張量平行 | NVIDIA 官方 Playbook 列為四台以上的建議模型 | NVIDIA Playbook |
交換器是四台方案的隱藏成本
每台只有兩個 QSFP 埠,NVIDIA 官方指引支援三台以內直連,四台以上必須加購 200G 交換器。社群常見選擇是 MikroTik CRS812 系列交換器搭配 QSFP56-DD 分接線。另有玩家以 200GBASE-SR4 光模組加 MPO 分接線做出免交換器的四台全網狀接法,但屬個人實驗,不建議企業直接採用,要用就真的要測穩才實作。
四台 GB10 的在記憶容量與功率,但頻寬輸半座 4×H100 不少
四台 Spark 的記憶體頻寬合計約 1.09 TB/s,仍低於單顆 H100 的 3.35 TB/s。四台的優勢在 512GB 容量與每台標示最大 240W 的功耗 (實際上單台的全負載均不到 200 瓦,約莫 180 瓦以內),算力並不是四台 GB10 的優勢,對照一下 NVIDIA 其他 DGX 伺服器大台的如 B200,每台就吃掉最高 14.3 kW 的電,算力則是上百倍的差距。實際解碼速度以 bird/GLM-spark 的 24.7 tok/s 為參考,適合少數人跑長文本分析,不適合對外提供高平行處理 API。
共享儲存要一起規劃
三台以上的叢集,每個節點都要讀同一份 200GB 以上的模型檔,OpenZeka 的做法是用 NAS 開 NFS 共享,兩個 10GbE 埠做 LACP。CyberQ 先前測試 NVMe 與 NAS 載入模型的差異,結論是首次載入走 NAS、之後靠本機快取,可以省下每台重複下載的時間與磁碟空間。
適用場景
50 人以上或有法遵要求的企業,需要在完全離線的網段內審閱數十萬字的法規、合約或整個程式庫,且願意配置專職維運人力。若只是要更多人同時使用,兩組雙機各跑一套模型,通常比一組四機更務實。
採購與模型選擇速查表
硬體估價以 2026 年 9 月台灣通路每台 16 萬至 22 萬元計算,直連線以 Resilient Tec 報價的 84 至 174 美元換算,台灣市場透過電商購買職連接從 775 元到 3000 多元不等,交換器與 NAS 則另計。
| 配置 | 記憶體池 | 硬體估價(新台幣) | 額外配件 | 建議模型組合 | 核心應用場景 |
|---|---|---|---|---|---|
| 1 台 | 128GB | 16 至 22 萬 | 無 | Qwen3.6-35B-A3B(BF16)為主,Step 3.5 Flash(NVFP4)為輔 | 私有知識庫 RAG、程式輔助、文件摘要,5 至 15 人 |
| 2 台,各自獨立 | 128GB × 2 | 32 至 44 萬 | 無 | 一台 Qwen3.6-35B-A3B,一台 Step 3.5 Flash 或 Qwen3.5-122B-A10B(FP8) | 雙代理人分工,客服與推理分流,維護不停機 |
| 2 台,串接 | 256GB | 32 至 44 萬 | 1 條 0.5 m QSFP 直連線 | DeepSeek-V4-Flash-0731(FP8 或 NVFP4 KV,1M 上下文)或 Qwen3.5-397B-A17B(int4) | 跨部門 AI 代理人、整份合約與程式庫分析,15 至 50 人 |
| 3 台,環狀 | 384GB | 48 至 66 萬 | 3 條 QSFP 直連線 | DeepSeek-V4.1-Flash(MXFP4 + FP8,SGLang) | 最新旗艦模型的最低硬體門檻,免交換器 |
| 4 台,交換器 | 512GB | 64 至 88 萬 + 交換器 | 200G 交換器、分接線、NFS 共享儲存 | GLM-5.2 753B(NVFP4,1M 上下文)或 DeepSeek-V4.1-Flash 高併發配置 | 完全離線的法遵審閱、萬行原始碼重構,50 人以上 |
採購前的五個提醒
量化格式決定能不能跑,不只是跑多快
GB10 原生支援 NVFP4,社群配方多以 NVFP4 或 MXFP4 為主。官方只發 FP8 的模型(例如 GLM-5.3-Flash)要等社群量化版,採購前先到 Hugging Face 確認目標模型有沒有 GB10 驗證過的檢查點。
軟體堆疊每月都在變
DeepSeek V4 系列在 Spark 上的配方,從 12 tok/s 進步到 78 tok/s 只花了三個月,靠的是 vLLM patch 與投機解碼。這代表要有人持續追蹤上游版本,並用固定的容器映像檔鎖定生產環境,NVIDIA 官方開發者論壇的 DGX Spark 版是最直接的情報來源。
兩台以上就要規劃 RoCE 網路
直連線的兩端要設定 link-local IP、免密碼 SSH、NCCL 介面名稱,多數失敗案例來自網路設定而不是模型本身。三台以上請先跑 NVIDIA Playbook 的 NCCL 頻寬測試再載入模型。
記憶體是共享的,桌面環境會吃掉容量
雙機跑 Qwen3.5-397B int4 時每台占 112GB,論壇回報連 VS Code 遠端伺服器都會導致載入失敗。生產用的節點建議關閉圖形介面,只留 SSH。
先租後買
本文列出的模型多數在 OpenRouter 或原廠 API 都能以每百萬 token 0.15 至 1.2 美元的價格試用。先用 API 驗證模型能否勝任公司的實際任務,再決定買幾台。硬體採購的決策點在資料主權與法遵,不在單價。
延伸閱讀
NVIDIA DGX Spark Hardware Overview
NVIDIA Playbook,Connect Three DGX Spark in a Ring Topology
NVIDIA Playbook,vLLM Multi Sparks through switch
GPUSmith,DGX Spark Review 2026
Exxact,Build a 4x NVIDIA DGX Spark Cluster
tonyd2wild,DeepSeek V4 Flash 0731 on 2x DGX Spark
MiaAI-Lab,DeepSeek-V4.1-Flash on 3-4x DGX Sparks
OpenZeka,Building a High-Speed AI Cluster with 4 DGX Spark Systems