微軟研究院、Microsoft Security 與加州大學柏克萊分校的團隊在 10 月中旬開源了 TokenEconomizer,主打「不換模型、不改代理程式,就能降低 coding agent 在常用 repo 裡的花費」。論文(arXiv:2610.22732)在 SWE-Bench 277 題上回報五組代理與模型組合的成本降低 18.4% 到 30.9%。專案上架兩週多就累積兩千多顆星。
我們在自己的環境實際跑了 288 次 Claude Code 工作階段,涵蓋 Sonnet 5.5、Opus 5.5 與 Fable 5.1 三個主模型,想回答一個簡單的問題,這個裝上去,真的會比較省嗎?
重點摘要
- 預設設定(工具修剪+迴圈防護)在 Claude Code+Sonnet 5.5 上每輪 12 題平均省 6.2%,學習期過後的穩態省 10.8%,四輪結果全部低於未安裝組,完成率不變(48/48)。
- 省下的錢幾乎全部來自工具修剪:第 6 個工作階段起,工具從 100 個減為 12 個,每個請求的提示詞從約 24,300 token 降到約 17,300 token。
- 打開 micro-skills 後,主工作階段再省一截,穩態省到 17%。但在我們的 Claude Code 2.1.314 上,外掛預設呼叫的
haiku別名實際跑的是 Sonnet 5.5,提案者的附加費用把節省全部吃掉,合計反而多花 2.9%。 - 把附加呼叫的模型明確指定為
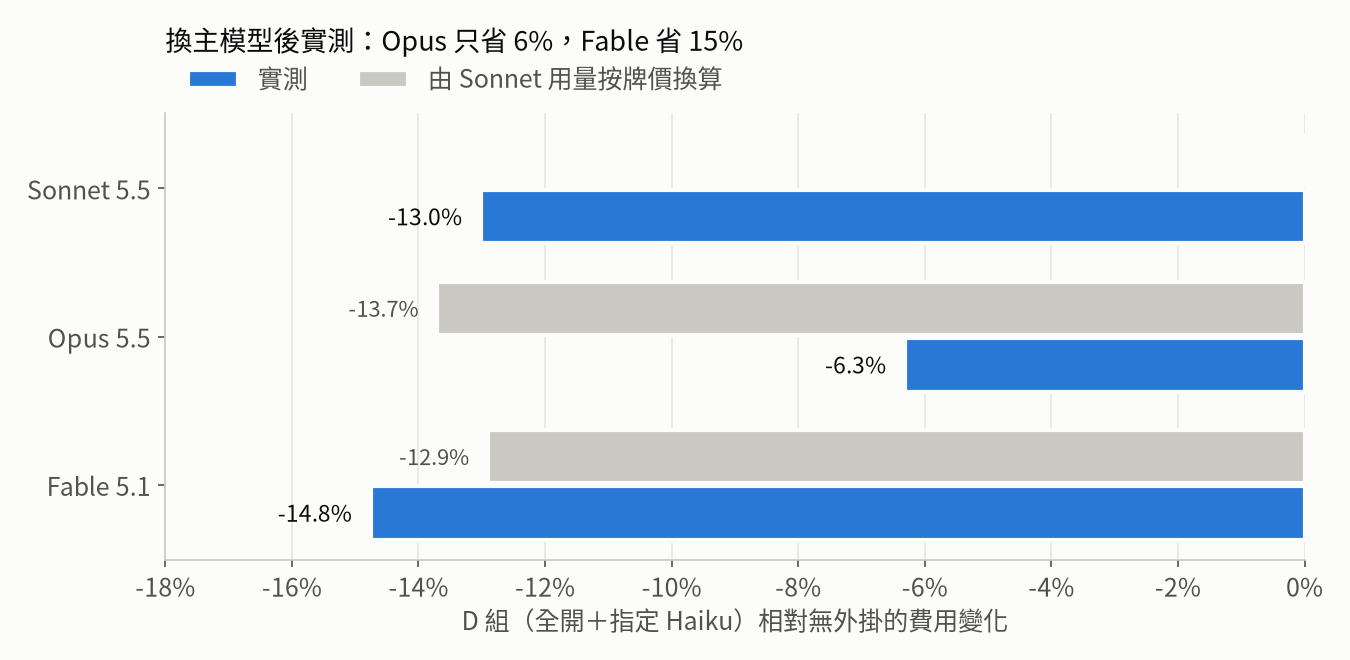
claude-haiku-5-5之後,全開組合計省 13.0%,穩態省 22.4%,是四組中最省的。 - 換成其他主模型實測,同樣的修正後全開設定在 Opus 5.5 省 6.3%、Fable 5.1 省 14.8%。Opus 的實測只有用 Sonnet 用量按牌價換算的一半,單靠換算會高估。
- 迴圈防護在 Sonnet 的 192 次工作階段中只叫醒裁判一次、轉向零次。我們的題目對 Sonnet 5.5 來說太順,這個機制的效益沒有被測到。
TokenEconomizer 是什麼
TokenEconomizer 是一個裝在代理程式外面的外掛,支援 Claude Code、Codex、GitHub Copilot CLI、Pi,opencode 為實驗性支援。它不改模型、不改提示詞框架,只靠 hook 讀取每次工作階段的紀錄,從同一個 repo 的歷史中學習,再改變之後的工作階段要付出的東西。三個機制可以各自開關:
| 機制 | 做什麼 | 預設 |
|---|---|---|
| 工具修剪(tool pruning) | 某個工具在同一 repo 連續 5 個工作階段(或跨 2 個工作階段、10 個提示)都沒用到,就把它寫進該 repo 的 .claude/settings.local.json deny 清單,之後的工作階段不再載入 | 開 |
| 迴圈防護(loop guard) | 代理出現重複失敗等跡象時,請裁判模型判斷是否卡住;信心 0.7 以上就插入一段轉向提示,每回合最多一次,不會強制中止 | 開 |
| Micro-skills | 從過去失敗與工作階段摘要中整理 repo 的操作事實(例如正確的測試指令),經多次確認後在工作階段開始時注入 | 關(因為提案者要額外呼叫模型) |
裁判、轉向撰寫與提案者這三種附加呼叫都透過使用者自己的代理 CLI 執行,在 Claude Code 上就是 claude -p --model haiku,不需要另外的 API 金鑰,費用算在使用者原本的方案上。學到的狀態全部放在本機 ~/.tokeneconomizer。
官方論文的五組數字如下(取自 README):
| 組合 | 成本變化 | Pass@1 變化 |
|---|---|---|
| Claude Code+Sonnet 5 | -23.6% | +1.3 |
| Claude Code+Opus 4.8 | -30.9% | -1.0 |
| Codex+GPT-5.6 Terra | -24.7% | +0.9 |
| Codex+GPT-5.6 Sol | -26.1% | +1.6 |
| Copilot CLI+Sonnet 5 | -18.4% | +2.6 |
測試設計
環境。 NVIDIA DGX Spark(ARM64)、Claude Code 2.1.314、主模型 Sonnet 5.5、TokenEconomizer main 分支 commit e428fc9(10/30,外掛版本 0.1.0)。外掛的離線測試在本機 424 項通過、4 項略過(需要 Codex、Windows 或 aider)。
這裡有兩個先說清楚的限制:
- 官方實驗腳本要在 x86_64 上跑 SWE-Bench 的 Docker 映像,ARM64 無法照原樣重現,所以我們改用自建的小型基準。
- 官方驗證過的 Claude Code 範圍是 2.1.300 到 2.1.310,我們的 2.1.314 稍微超出。外掛在這個版本上的 hook 全部正常觸發,但這仍屬未經官方驗證的組合。
工作負載
一個約 700 行的 Python 發票工具套件(含 37 個可見測試),刻意埋了三個新人第一次會踩到的地雷,系統沒有 pytest、只能用 .venv/bin/python -m pytest,測試必須設 APP_ENV=test,否則只丟出一行 RuntimeError: invkit settings not configured,有一個被 gitignore 的產生檔,每次都要先跑 scripts/gen_rates.py。這三件事只寫在 CONTRIBUTING.md,README 不提。
在這個 repo 上依序做 12 個任務,修四進位錯誤、CSV 跳脫、時區、加折扣碼、JSON 報表、免稅客戶、CLI 錯誤處理、重構、滯納金等,其中第 9、11 題刻意設計成錯誤訊息會誤導方向的題目,用來觸發迴圈防護。每題以隱藏測試加上該題起始版本的原始可見測試評分,代理改動 repo 內的測試不影響判定,所以刪改測試無法作弊。評分腳本先做雙向自測,未解時必為 FAIL、參考解必為 PASS、削弱測試的作弊必為 FAIL,12 題全數符合。
四組對照
每組各跑 4 輪,每輪從乾淨的 repo 複本與空白的學習狀態開始,依序做完 12 題,共 192 次工作階段。各組分兩批並行執行,降低時段差異。
| 組別 | 設定 |
|---|---|
| A 無外掛 | 不載入 TokenEconomizer |
| B 預設 | 工具修剪+迴圈防護(外掛預設值) |
| C 全開 | B+microskills=on,附加呼叫用外掛預設的 haiku 別名 |
| D 全開(修正) | C+paid_model=claude-haiku-5-5 |
為了讓實驗能連續跑,B、C、D 把 toolprune_quiet_minutes 從 60 改成 0。預設值的用意是等 repo 閒置超過提示詞快取的存活時間才寫入 deny 清單,避免讓正在進行的對話快取失效,實際使用時,修剪會比本實驗晚一點生效,但生效後的效果相同。
主工作階段的費用取 Claude Code 回報的 total_cost_usd,並用逐模型的 token 數乘以官方牌價重算,兩者誤差為零。外掛的附加呼叫使用 --no-session-persistence,不會出現在工作階段紀錄裡,所以我們在 PATH 前面放一個轉接程式,把每一次附加呼叫的輸出原樣存下來,獨立加總費用與模型。測試環境保留了帳號上的 Google Drive、Canva 等連接器與一個 Analytics MCP 伺服器,加上內建工具共 100 個,這也是工具修剪在真實環境中會面對的狀況。
一個值得其他人注意的坑,第一次正式跑時用 --permission-mode acceptEdits,結果在 headless 模式下幾乎所有 Bash 指令都被拒絕,代理根本跑不了測試,只能靠讀檔猜答案。那一批資料整批作廢,改加 --allowedTools Bash 後重跑。用 claude -p 做評測時,記得先檢查結果裡的 permission_denials。
結果:預設省 6%,修正後的全開省 13%
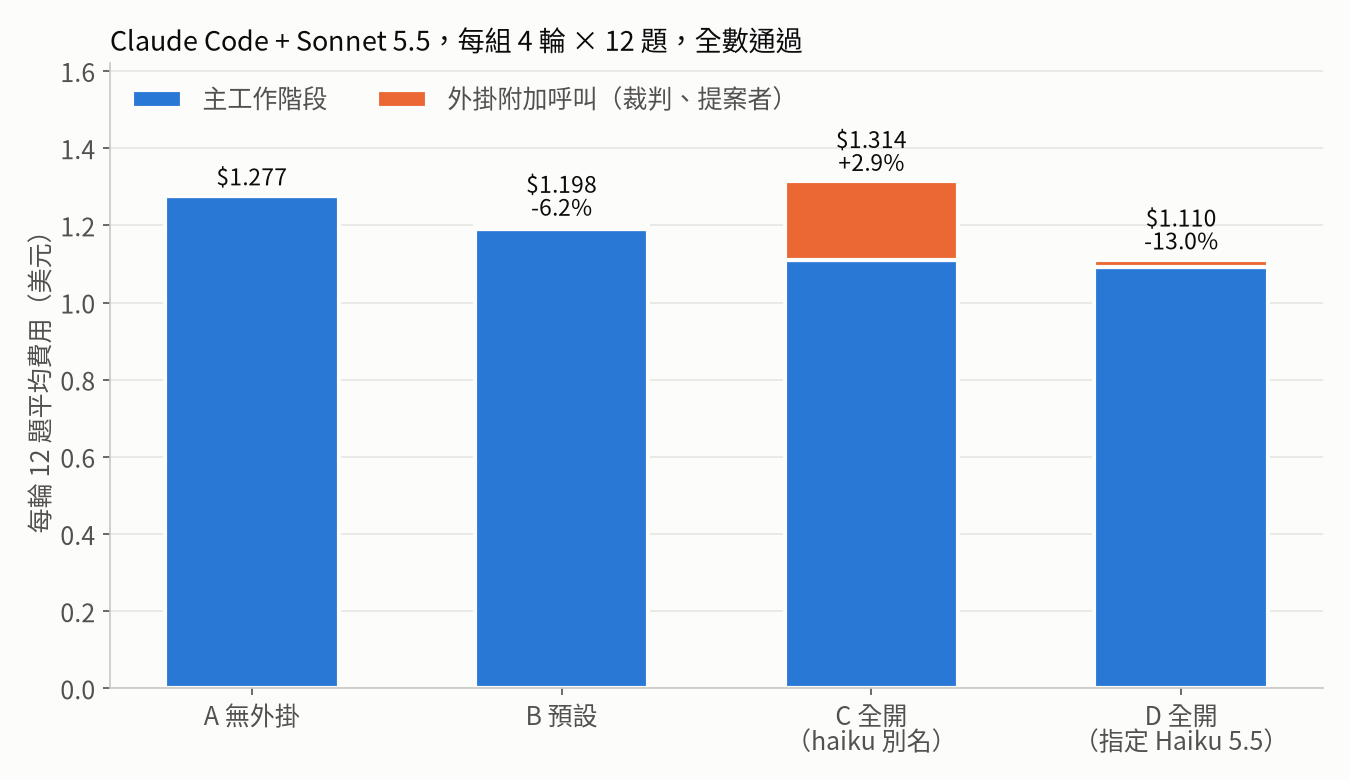
| 組別 | 主工作階段 | 附加呼叫 | 合計 | 相對 A | 穩態主工作階段(第 5 到 12 題) | 相對 A |
|---|---|---|---|---|---|---|
| A 無外掛 | $1.277 | $0.000 | $1.277 | 基準 | $0.875 | 基準 |
| B 預設 | $1.191 | $0.006 | $1.198 | -6.2% | $0.780 | -10.8% |
| C 全開 | $1.111 | $0.203 | $1.314 | +2.9% | $0.726 | -17.0% |
| D 全開(修正) | $1.092 | $0.018 | $1.110 | -13.0% | $0.679 | -22.4% |
四組都是 48/48 全數通過,省錢沒有犧牲完成率。逐輪合計如下,B、D 的每一輪都低於 A 的最低一輪,C 則有三輪高於 A 的最高一輪:
| 組別 | 第 1 輪 | 第 2 輪 | 第 3 輪 | 第 4 輪 |
|---|---|---|---|---|
| A | $1.274 | $1.265 | $1.272 | $1.296 |
| B | $1.221 | $1.191 | $1.158 | $1.221 |
| C | $1.272 | $1.327 | $1.332 | $1.325 |
| D | $1.153 | $1.073 | $1.072 | $1.143 |
學習期(前 4 題)各組幾乎沒有差別(A $0.402、B $0.411、C $0.385、D $0.413),外掛的 hook 還會在每個請求多帶約 330 token。差距是在學到東西之後才拉開的,這也符合它「越常用的 repo 越省」的設計。
工具修剪是最穩定的部分
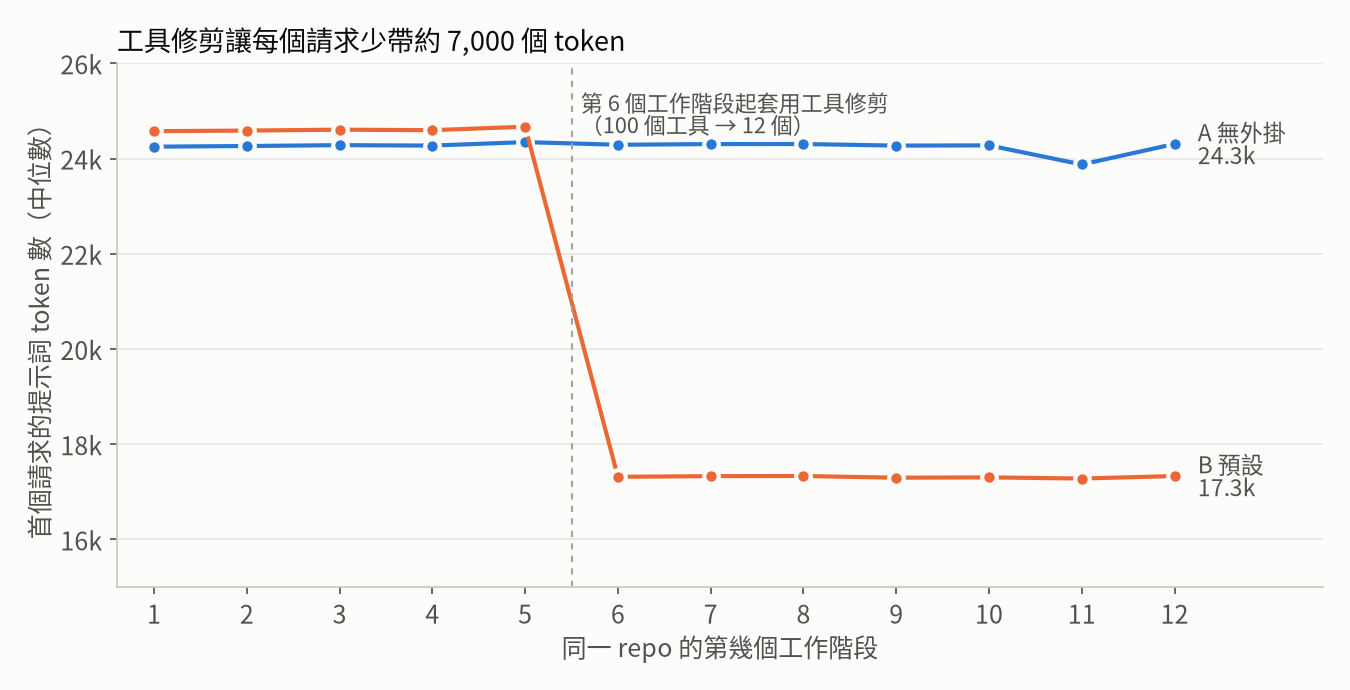
第 5 個工作階段結束後,外掛把 88 個從未用過的工具寫進 deny 清單,包括全部 70 個 MCP 連接器工具,以及 Cron、Worktree、Workflow、SendMessage 等內建工具。保留的 12 個是 Bash、Read、Edit、Write、Task、Skill、ToolSearch、WebFetch、WebSearch、Monitor、NotebookEdit、TaskStop。之後每個請求的提示詞從約 24,300 token 降到約 17,300 token,少了 29%。
這個數字換成美元時會縮水。原因是提示詞快取,工具定義在同一個工作階段裡大多以快取讀取計價,Sonnet 5.5 的快取讀取只要基本輸入價的 5%(每百萬 token 0.10 美元)。所以 B 組的快取讀取 token 少了 16%,但費用只少 6.2%。用 token 省了多少來宣傳的數字,和帳單上看到的數字會差一大截,這點在比較任何省 token 工具時都要分清楚。
另一個值得注意的地方,工作階段紀錄顯示,Claude Code 對這 70 個 MCP 工具啟用了延後載入,提示詞裡只列名稱,需要時才用 ToolSearch 取回完整定義。所以省下的約 7,000 token,大部分來自被移除的 18 個內建工具(Cron、Worktree、Workflow、SendMessage 等,每個都帶完整 schema),MCP 工具本身只佔名稱清單那幾行。換到不支援延後載入的代理,或連接器多到超過延後門檻之前,修剪的效果可能不同。
Micro-skills:學到的事實是對的
C、D 兩組在幾個工作階段後,就把 repo 的操作方式整理成一小段說明,在每次工作階段開始時注入。其中一輪學到的內容如下(節錄):
The project’s Python environment is
.venv/at the repo root (interpreter.venv/bin/python); barepython/python3lacks the project’s dependencies, and setup notes are in CONTRIBUTING.md.Canonical test command in invkit:
.venv/bin/python scripts/gen_rates.py && APP_ENV=test .venv/bin/python -m pytest(gen_rates.py generates the rates data first; APP_ENV=test is set for pytest; use the .venv interpreter, not system python).
這正是前面埋的三個地雷的完整解法。效果可以從工具呼叫的錯誤看出來,下表是穩態期(第 5 到 12 題,每組 32 次工作階段)代理撞到的環境錯誤次數:
| 組別 | No module named … | settings not configured |
|---|---|---|
| A 無外掛 | 23 | 21 |
| B 預設 | 31 | 26 |
| C 全開 | 11 | 15 |
| D 全開(修正) | 4 | 8 |
撞牆的次數少了,回合數與輸出 token 也跟著下降(平均每輪回合數 A 81.0、D 76.5,輸出 token A 21,842、D 19,136)。不過要說明一點,Sonnet 5.5 本來就很會先讀 CONTRIBUTING.md,沒有外掛時一題也只多撞一兩次牆,所以 micro-skills 能省的空間,在這個 repo 上並不大。地雷越隱蔽、越沒有文件,它應該越有用。
由 Haiku 5.5 當提案者的 D 組,整理出的說明比較長(約 1,000 字元對 C 組的約 520 字元),除了測試指令,也記下了模組與測試檔的對應位置。樣本只有 4 輪,我們不推論哪個提案者比較好。
陷阱:haiku 別名在我們的環境跑的是 Sonnet
C 組的主工作階段明明是四組中第二省的,合計卻多花 2.9%。拆開附加呼叫才發現,外掛呼叫的是 claude -p --model haiku,但回傳的 modelUsage 全部是 claude-sonnet-5-5。我們在同一台機器上直接驗證:
| 指令 | 實際模型 | 一次「Reply OK」的費用 |
|---|---|---|
claude -p --model haiku | claude-sonnet-5-5 | 約 0.27 美元 |
claude -p --model claude-haiku-5-5 | claude-haiku-5-5 | 約 0.014 美元 |
(這兩筆都是帶完整系統提示的空工作階段,外掛自己的呼叫有去掉 MCP 與工具,實際每次約 0.04 到 0.05 美元。)
我們沒有查到這是 Claude Code 2.1.314 的刻意行為還是帳號方案造成的對應,但結果很清楚,外掛的 README 說附加呼叫用最便宜、夠用的模型,在這個環境裡實際上用的是比 Haiku 5.5 貴 20 倍的 Sonnet 5.5。C 組每輪 4 到 5 次提案者呼叫,合計 0.20 美元,佔主工作階段的 18%。
外掛有 paid_model 設定可以修正。D 組只改了這一項,附加呼叫降到每輪 0.018 美元,合計從多花 2.9% 變成省 13.0%。外掛自己的 te status 以有效 token 計算附加開銷,不分模型單價,以各組第 2 輪為例,C 組顯示 15.6%、D 組顯示 25.7%,方向恰好與帳單相反。判斷附加開銷時,請以美元為準。
如果你要開 micro-skills,建議一併執行:
/tokeneconomizer:config set microskills=on
 /tokeneconomizer:config set paid_model=claude-haiku-5-5
或在環境變數設定 TE_PAID_MODEL=claude-haiku-5-5。開了之後,用 claude -p --model haiku --output-format json 跑一次,看 modelUsage 是不是真的 Haiku。
迴圈防護這次無用武之地
192 次工作階段中,迴圈防護的裁判只被叫醒一次(B 組某輪第一題,代理在環境設定上試了幾次),判定「沒有卡住」(信心 0.8),全程零次轉向。這次刻意設計的第 9、11 題,Sonnet 5.5 平均 4 到 10 個回合就解完了,沒有進入迴圈。
這表示迴圈防護在這次實測中的成本幾乎為零,但效益也無從觀察。論文的 SWE-Bench 任務更長、更難,代理更容易在錯的方向上反覆嘗試,那才是這個機制的主場。順帶一提,那一次裁判呼叫同樣跑在 Sonnet 5.5 上。
換成 Opus 5.5 或 Fable 5.1 實測結果與換算不同
一開始只用 Sonnet 的 token 組成乘以牌價,推估其他主模型的結果,D 組在 Opus 5.5 與 Fable 5.1 上都是省 13% 左右。為了確認這個推估站不站得住,另外用兩個模型各跑了 A、D 兩組,每組 2 輪 × 12 題,48 次工作階段全數通過。Opus 5.5 沿用 Claude Code 設定中的 effort high,Fable 5.1 使用 Claude Code 的預設 effort。
| 主模型 | A 無外掛(逐輪) | D 全開(修正,逐輪) | 實測變化 | 穩態(第 5 到 12 題) | 原本換算 |
|---|---|---|---|---|---|
| Sonnet 5.5 | $1.274 到 $1.296(4 輪) | $1.072 到 $1.153(4 輪) | -13.0% | -22.4% | 實測基準 |
| Opus 5.5 | $3.729、$3.609 | $3.422、$3.452 | -6.3% | -8.8% | -13.7% |
| Fable 5.1 | $9.542、$9.814 | $8.656、$7.844 | -14.8% | -18.7% | -12.9% |
三個模型都是 D 組的每一輪低於 A 組的每一輪,所以會省錢這個方向是穩定的,但幅度不能直接從 Sonnet 換算:
- Opus 5.5 只省 6.3%,比換算少一半。 Opus 在這組題目上走得比較長(每輪約 97 個回合,Sonnet 約 81 個),每個工作階段的輸出 token 是 Sonnet 的 2.4 倍,12 題要 3.67 美元,是 Sonnet 的 2.9 倍,而不是牌價比例的 2 倍。多出來的花費落在推理與輸出,工具修剪碰不到,而 micro-skills 在 Opus 上幾乎沒有減少撞牆次數(每個工作階段平均 1.42 次對 1.38 次),能省的只剩提示詞那一塊。
- Fable 5.1 省 14.8%,略多於換算。 Fable 的回合數最多(每輪 173 到 231 個),撞到環境地雷的次數也最多,micro-skills 在它身上最有效:撞牆次數從每個工作階段 1.92 次降到 1.29 次,D 組平均每輪少了 32 個回合,輸出 token 少 16%,牆鐘時間也短了約 13%。
- 附加呼叫在三個模型上都一樣便宜。 指定 Haiku 5.5 後,每輪的提案者費用約 0.02 美元,相對於 Opus 或 Fable 的主工作階段幾乎可以忽略。
換句話說,價格換算只能告訴你單價越貴,同樣的 token 減量越值錢,卻沒辦法預測不同模型會怎麼走路徑。這也是決定補跑實測的原因,若只看換算,會高估 Opus 的效益一倍。
使用的牌價(每百萬 token,美元):
| 模型 | 輸入 | 5 分鐘快取寫入 | 1 小時快取寫入 | 快取讀取 | 輸出 |
|---|---|---|---|---|---|
| Fable 5.1 | 10 | 12.50 | 20 | 0.25 | 50 |
| Opus 5.5 | 4 | 5 | 8 | 0.20 | 20 |
| Sonnet 5.5 | 2 | 2.50 | 4 | 0.10 | 10 |
| Haiku 5.5 | 0.10 | 0.125 | 0.20 | 0.01 | 0.50 |
為什麼比論文的 18% 到 31% 少
我們的結果落在論文數字的三分之一到二分之一,可能的原因有幾個:
- 任務太短。 每題平均約 20 秒、7 個回合,代理幾乎沒有走冤枉路的空間。SWE-Bench 任務長得多,迴圈防護與 micro-skills 都有更多可以省的地方。
- 迴圈防護完全沒有出手。 論文中它是三個機制之一,這裡它的貢獻是零。
- Sonnet 5.5 很少撞牆。 它會主動讀
CONTRIBUTING.md,地雷的代價本來就不高。 - 提示詞快取稀釋了工具修剪。 Claude Code 的快取命中率很高,工具定義大多以 5% 的價格計費。
換句話說,在短任務、強模型、文件齊全的情境下,TokenEconomizer 能省的錢有限但確實存在,任務越長、repo 越難搞,論文的高節省數字越有可能出現。
使用前要知道的風險
修剪掉的工具會從這個 repo 消失。本次修剪移除了全部 MCP 連接器工具。之後若要在這個 repo 裡請代理讀 Google Drive 或操作 Canva,工具已經不在清單裡,需要執行 /tokeneconomizer:toolprune restore。deny 清單寫在 repo 的 .claude/settings.local.json,外掛會把它加進 .git/info/exclude,不會被誤提交。
注入的內容來自 repo 的輸出。micro-skills 的事實是從指令輸出與工作階段摘要整理出來的,而這些內容是 repo 可以控制的。在不信任的 repo 上開 micro-skills,等於讓 repo 有機會往你的系統提示裡寫字。官方預設關閉,也是同樣的考量。
有些資料會送出本機,裁判與轉向撰寫會送出最近動作的摘要(指令、搜尋樣式、被編輯檔案的檔名、錯誤特徵,不含檔案內容與任務描述),提案者會送出工作階段摘要。這些都透過你自己的代理 CLI 送到原本的模型供應商,沒有第三方。
費用算在你的方案上,附加呼叫用的是你的訂閱或 API 額度,請先確認別名對應到的實際模型。
版本相容性也要留意,官方明列支援的代理版本範圍,transcript 格式是各代理的內部格式,代理升級後外掛可能讀錯。2.1.314 已超出範圍,雖然這次正常,仍建議代理升級後看一次 te status 與 ~/.tokeneconomizer/errors.log。
結論與建議設定
TokenEconomizer 在環境中確實能省錢,而且沒有降低完成率,但幅度比論文小,且有一個預設行為會讓它倒賠:
- 只想要穩定、零風險的節省: 用預設值就好。工具修剪在連接器多的環境效果最明顯,迴圈防護平時幾乎不花錢。本次省 6.2%,穩態 10.8%。
- 常在同一個 repo 工作、且信任這個 repo: 打開 micro-skills,同時把
paid_model指定為完整的 Haiku 模型 ID。本次省 13.0%,穩態 22.4%。 - 不要只開 micro-skills 而不檢查附加呼叫的模型。 在我們的 Claude Code 版本上,這會讓總費用比不裝還高。
- 主模型不同,效益差很多。 同一套設定在 Fable 5.1 上省 14.8%,在 Opus 5.5 上只省 6.3%。要評估自己的情境,最好用自己的主模型實際跑幾輪,不要只拿別的模型的數字換算。
最後,任何宣稱省 token的工具,都值得自己用帳單上的美元再算一次,同樣的 token 減量,在提示詞快取下換成美元可能只剩一半,而工具自己的附加呼叫也要算進去。
附錄:方法與重現
- 實測日期:2026-10-31。總計 288 次正式工作階段(Sonnet 5.5 四組 × 4 輪、Opus 5.5 與 Fable 5.1 各兩組 × 2 輪,每輪 12 題),含前導測試與作廢批次,實際花費約 83 美元(以 API 牌價計)。
- Opus 與 Fable 的第 2 輪曾因帳號用量上限中斷,中斷的工作階段整批作廢,從乾淨狀態重跑,Fable D 組第 1 輪只有第 12 題撞到上限,該題單獨重跑(重跑前外掛已折入一次未完成的工作階段,影響僅限最後一題)。
- Claude Code 2.1.314、
--model sonnet --permission-mode acceptEdits --allowedTools Bash --output-format stream-json,停用其他外掛與自動記憶,四組設定相同,只差外掛與其環境變數。 - TokenEconomizer commit e428fc9,以
--plugin-dir載入,B、C、D 設TE_TOOLPRUNE_QUIET_MINUTES=0,C、D 設TE_MICROSKILLS=on,D 另設TE_PAID_MODEL=claude-haiku-5-5。 - 每組 4 輪 × 12 題,每輪獨立的 repo 複本與
TOKENECONOMIZER_HOME,分兩批並行執行。 - 評分:隱藏測試+該題起始版本的可見測試,並先做雙向自測。檢查過所有工作階段紀錄,代理沒有讀到隱藏測試。
- 費用:主工作階段用
total_cost_usd,並以逐模型 token 數乘牌價重算核對,附加呼叫以 PATH 轉接程式逐次記錄。 - 限制:單一自建 repo、短任務;Sonnet 每組 4 輪,Opus 與 Fable 每組只有 2 輪且只測 A、D 兩組,迴圈防護未被觸發,效益未測得。