上一篇比較了 DeepSeek-V4.1-Flash-1017 在兩台 DGX Spark 上的兩套配方,結論是 TensorFold 比 vLLM kit 快約 2 倍,手邊的 hermes 助理也因此換到 TensorFold 上。接著來做上一篇沒測試的影像輸入、超過 140K token 的上下文,以及大型測試資料集。
CyberQ 實測 DeepSeek-V4.1-Flash-1017,影像輸入 11 題全對,51 萬 token 的長文取針也找得到,記憶體一點都沒增加,真正的上限是溫度,OpenAI 公布的 GSM8K 測試資料集全部 1,319 題答對 96.97%,而開思考在這類題目上沒有任何幫助,只是多花 1.9 倍的輸出。
測試環境與上一篇相同,兩台 DGX Spark 以 ConnectX-7 直連,TP=2,權重是 LibertAIDAI 的 1017 EXL3 2.9 bpw 加官方 1017 Engram,引擎是 TensorFold(Elevatormusic 配方,伺服器端加了 --no-thinking)。以下全部在這個環境中進行,也是現階段 CyberQ hermes agents 現在實際使用的地端 AI 推論後端伺服器。
一、影像輸入 11 題全對
1017 有原生的影像理解能力,但 TensorFold 的 --help 對 --vision 的說明是「支援 GLM 與 Qwen 的視覺模型」,沒有提到 DeepSeek,所以第一步是確認它到底能不能用。
為了能客觀評分,沒有用網路上的圖片,而是拿上一篇自己做的速度圖、終端機截圖和封面圖出題,每一題的正確答案都是已知的:
| 類型 | 題數 | 例題 | 結果 |
|---|---|---|---|
| 讀圖表上的數值 | 5 | 「TensorFold 在 4 路那一列的數值是多少?」 | 5/5 |
| 讀截圖裡的文字 | 4 | 「容器使用的映像標籤是什麼?」(12 位十六進位字串) | 4/4 |
| 數物件 | 1 | 「畫面中有幾台電腦?」 | 1/1 |
| 一次給兩張圖 | 1 | 從兩張圖各讀一個數值 | 1/1 |
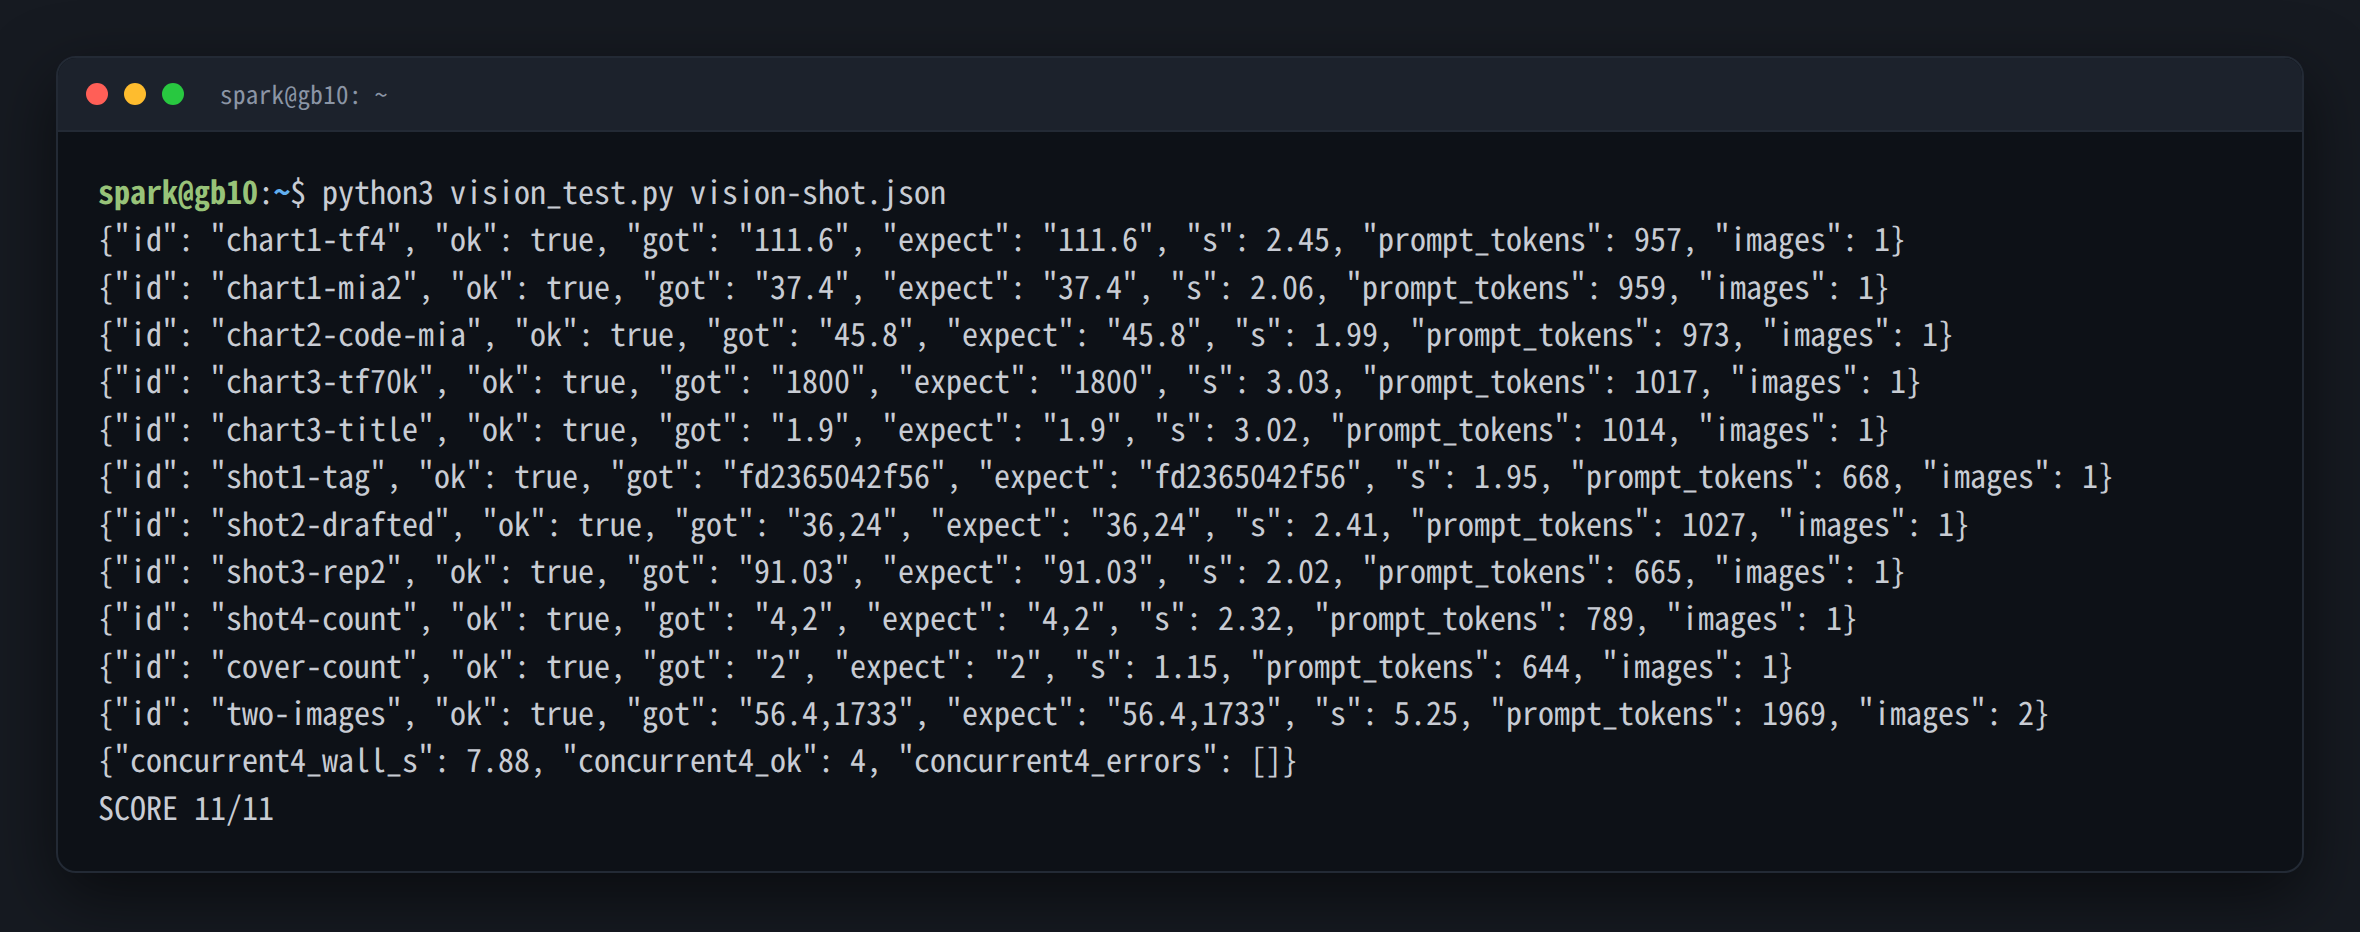
幾個量化數字:
每張圖約佔 650 到 1,000 個 token,看圖片內容而定。
單題回應 1 到 4.5 秒,一次給兩張圖約 5 秒。
4 個請求同時各帶一張圖,4 題全對、合計 7.9 秒,沒有錯誤。
測試前後兩台的可用記憶體都維持在 6 到 7 GiB,影像輸入沒有額外吃記憶體。
要說明的是,這組圖都是乾淨的數位圖表與終端機畫面,比照片或手寫容易辨識,所以 11/11 代表「能用、讀得準」,不代表在各種圖片上都這麼好。另一套 vLLM kit 在 CyberQ Lab 環境的設定裡關閉了視覺塔,而它的社群回報過單張大圖超過 prefill 分塊一半就會卡死的問題,這次沒有測這一塊。
經代理與 hermes 實際使用
前面 11 題是直接打引擎,但 hermes 實際上是經 LiteLLM 代理連到引擎。所以我把同樣 11 題改走代理再跑一次,同樣 11/11,4 路同時帶圖 4/4、8.3 秒,而且每一題的輸入 token 數都和直連完全相同,表示代理把圖片原樣轉給引擎,沒有改寫或丟棄。
接著在 hermes 裡實際傳了兩張圖,並請它根據圖中內容再上網查詢,結果都正確。從引擎的紀錄可以看出 hermes 怎麼處理圖片,它的 image_input_mode 設為 auto,實際上沒有把原圖放進主對話,而是讓主對話呼叫看圖工具,由工具帶著圖片另外問一次模型,拿回一段文字描述,主對話再根據這段文字回答。
| 順序 | 請求 | 輸入 token | 輸出 token |
|---|---|---|---|
| 1 | 主對話決定呼叫看圖工具 | 約 5 萬 | 約 110 |
| 2 | 看圖工具:圖片加問題 | 約 805 | 730 到 800(文字描述) |
| 3 | 主對話根據描述作答 | 約 5 萬 1 千(大多命中快取) | 視問題而定 |
第 3 步只比第 1 步多約 1,000 個 token,剛好是一段描述加上工具呼叫的大小,而一張原圖就要 650 到 1,000 個 token,可見主對話沒有收到原圖。每張圖另外還有一筆約 815 個 token 的小請求,從紀錄看不出用途。
這種做法的好處是主對話不用每一輪都背著圖片的 token,代價是主模型看到的是描述而不是原圖,描述裡漏掉的細節它就答不出來。hermes 的看圖工具與主對話設定的是同一個 1017 模型,所以看圖能力相同,差別只在資訊有沒有在轉成文字時遺失。
二、51 萬 token 的長文埋針測試
TensorFold 設定的上下文上限是 1,048,576 token,作者自己測到 200K。延續上一篇的長文取針,CyberQ 在一大段繁中技術文件的正中間放一句「機房保險箱的密碼是 XXXXXXXX」,再問模型密碼是什麼。
| 提示長度 | 命中快取 | prefill 時間 | prefill 吞吐 | 找到密碼 | 可用記憶體最低 | 機殼熱區最高 |
|---|---|---|---|---|---|---|
| 255,471 token | 8,192 | 150.5 秒 | 1,643 tok/s | 是 | 6/5 GiB | 95/92°C |
| 510,790 token | 65,536 | 331.7 秒 | 1,342 tok/s | 是 | 6/6 GiB | 96/95°C |
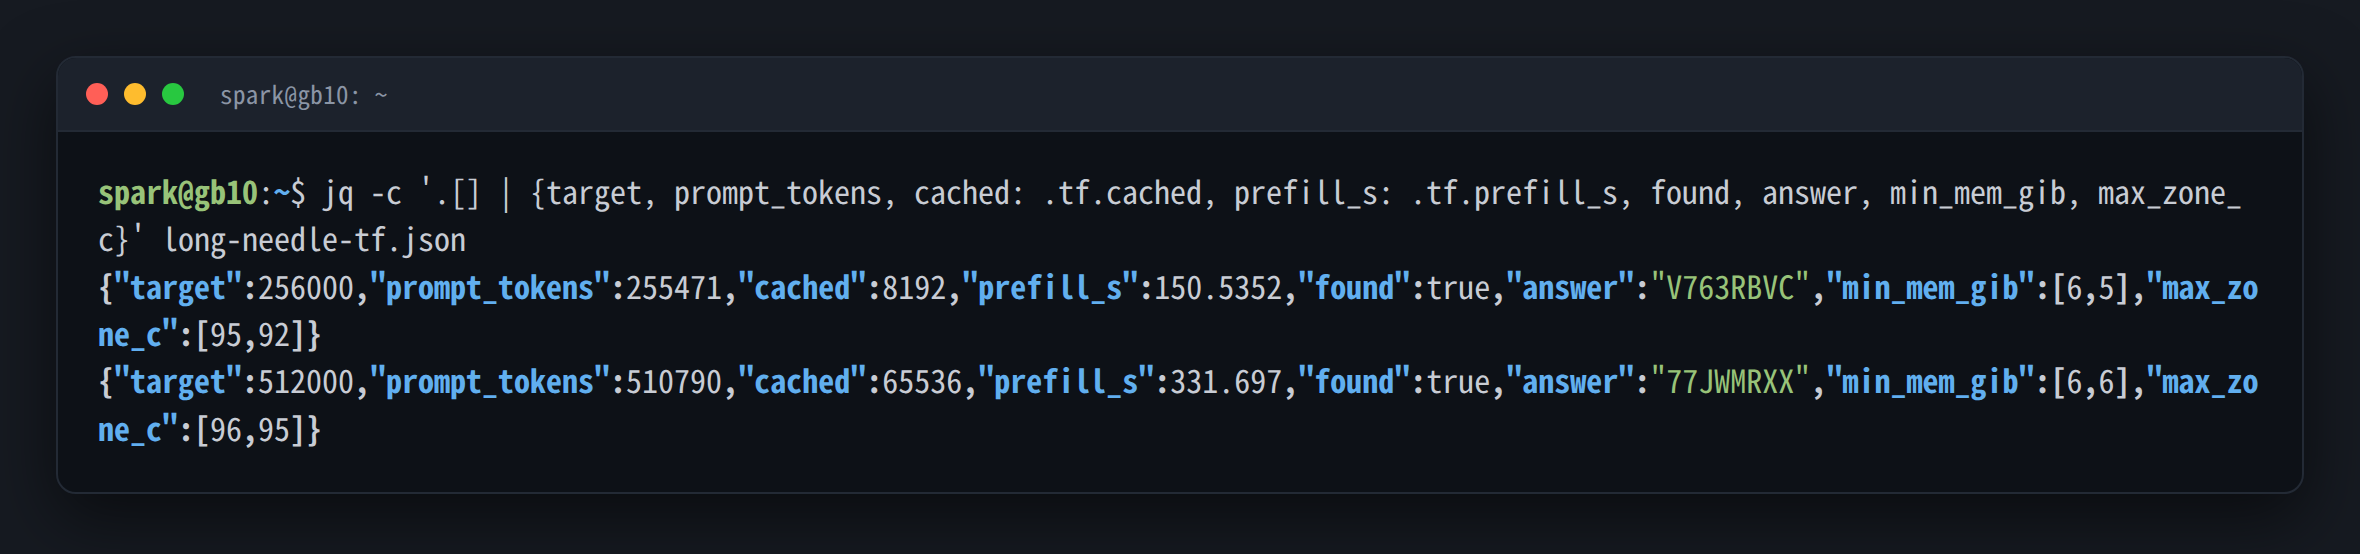
min_mem_gib 與 max_zone_c 分別是兩台在請求期間的最低可用記憶體與最高熱區溫度。吞吐是用引擎回報的 prefill 秒數、扣掉命中 prefix cache 的部分算的。把上一篇的數字接起來看,prefill 吞吐在 140K 以內幾乎持平,之後隨長度慢慢下降:
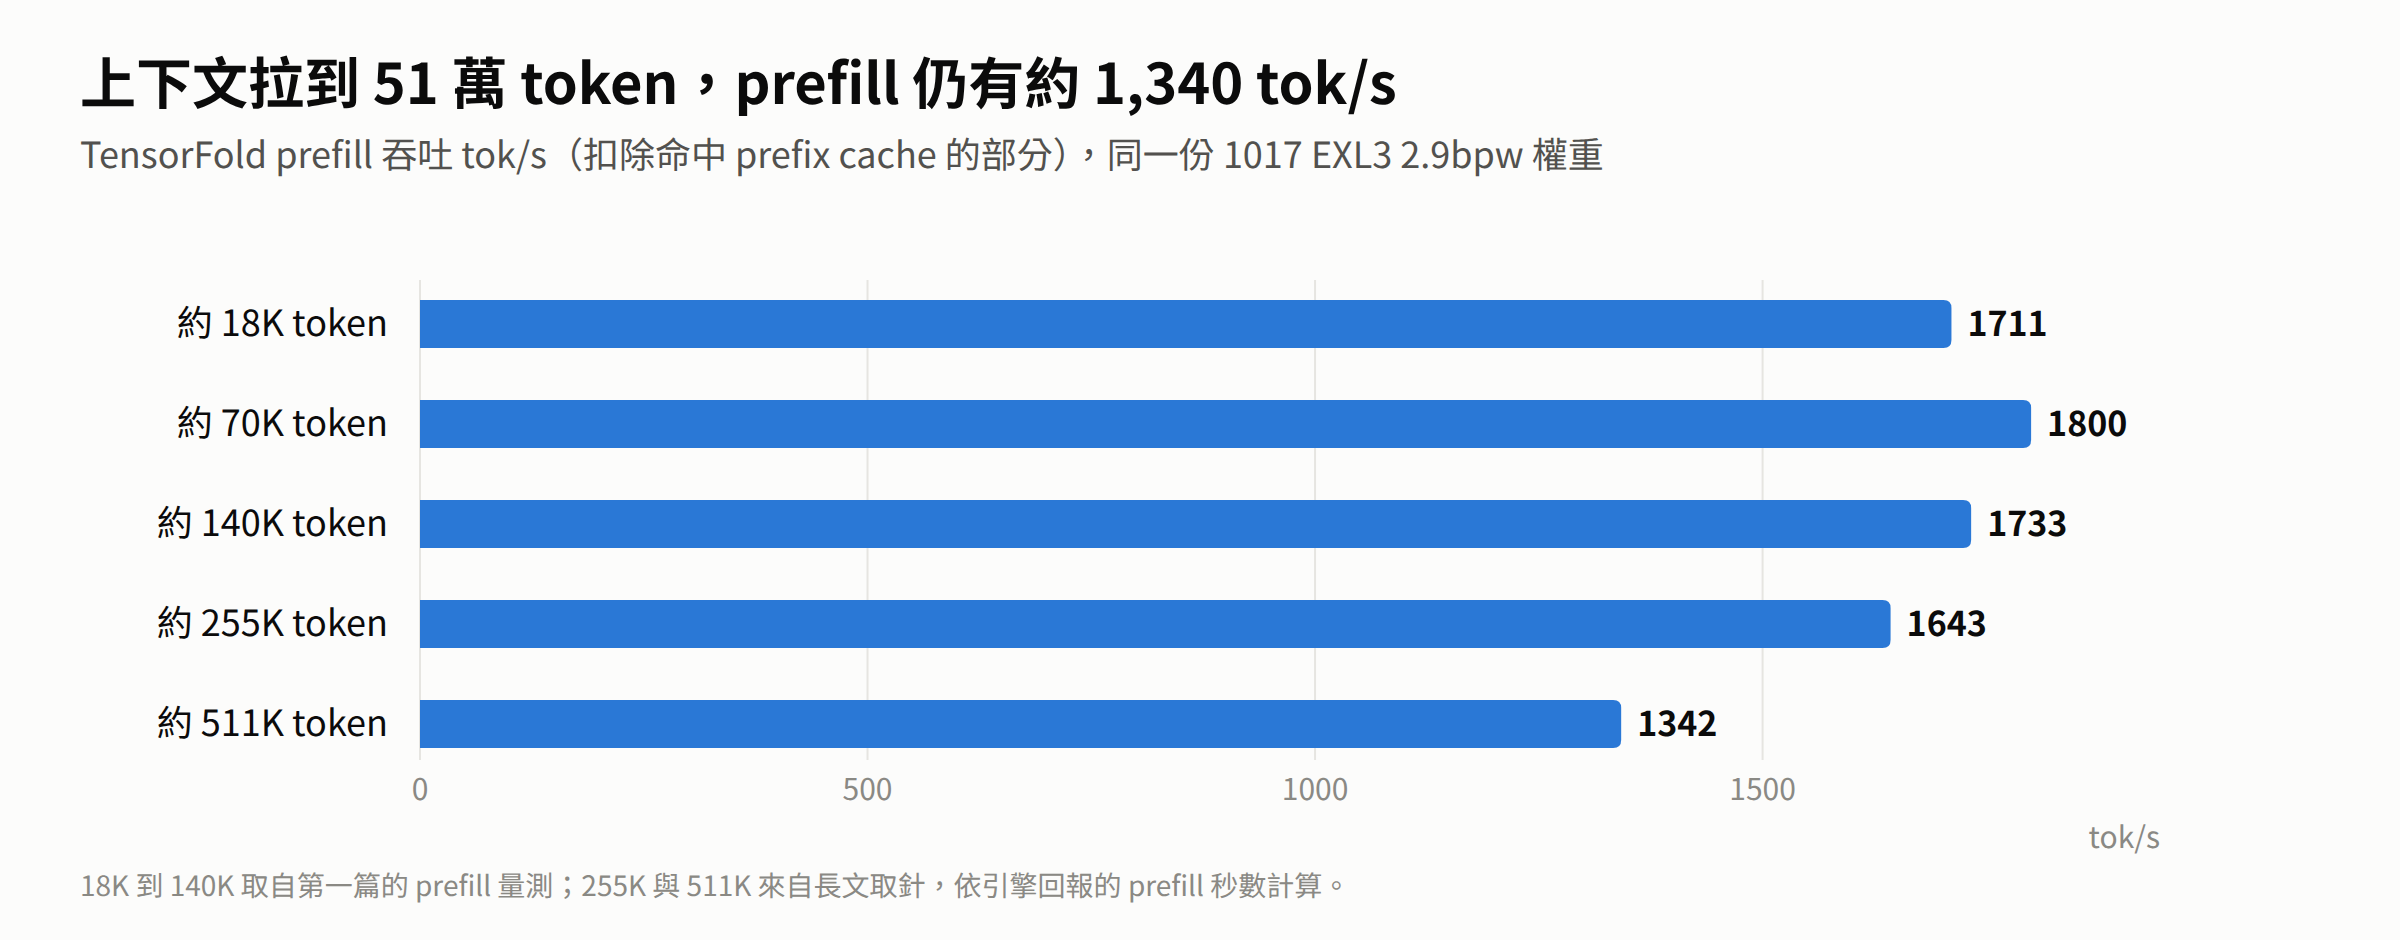
兩個重要的觀察:
記憶體不會隨上下文增加
TensorFold 在啟動時就把 1M 上下文所需的 KV 池配置好了,所以從 18K 到 51 萬 token,兩台的可用記憶體都停在 5 到 6 GiB。這和許多引擎「上下文越長、記憶體越吃緊」的行為不同。
真正的上限是溫度
51 萬 token 的 prefill 要滿載跑 5 分半鐘,熱區最高到 96°C。先前遇過 GB10 在熱區長時間停在 91 度以上後無預警斷電,所以這次量測加了兩道守門看門狗程式碼,任一台可用記憶體低於 2 GiB,或熱區連續 2 分鐘以上達 94°C,就立刻停掉服務。在本期測試中,這次兩道都沒有觸發,但 96°C 已經是我在這對機器上看過最高的溫度,所以沒有繼續往 768K 或 1M 測。
換成實際使用的感受,一次丟進 25 萬 token,要等約 2 分半鐘才開始回答,丟進 51 萬 token,則要等約 5 分半鐘。整體來說,這表現,實務上能用,但這種長度比較適合一次性的大文件分析,不適合單純的互動對話。好家在,這種任務在多輪對話會命中 prefix cache,同一段長上下文只有第一次要等,所以後面的推論時間就會加快很多。
三、GSM8K 全集:96.97%
上一篇測試的數學只有 10 題,樣本太小。這次跑 GSM8K 測試集全部 1,319 題,題目與標準答案取自 OpenAI 公開的原始 repo,題目維持英文,要求最後一行寫「Answer: 數字」,由程式比對。
| 設定 | 題數 | 答對 | 準確率 | 被截斷 | 平均輸出 | 耗時 |
|---|---|---|---|---|---|---|
| 關思考,T=0,4 路併發 | 1,319 | 1,279 | 96.97% | 0 | 166 token | 28.5 分鐘 |
| 開思考,T=0,4 路併發(抽 200 題) | 200 | 193 | 96.5% | 1 | 329 token | 9.2 分鐘 |
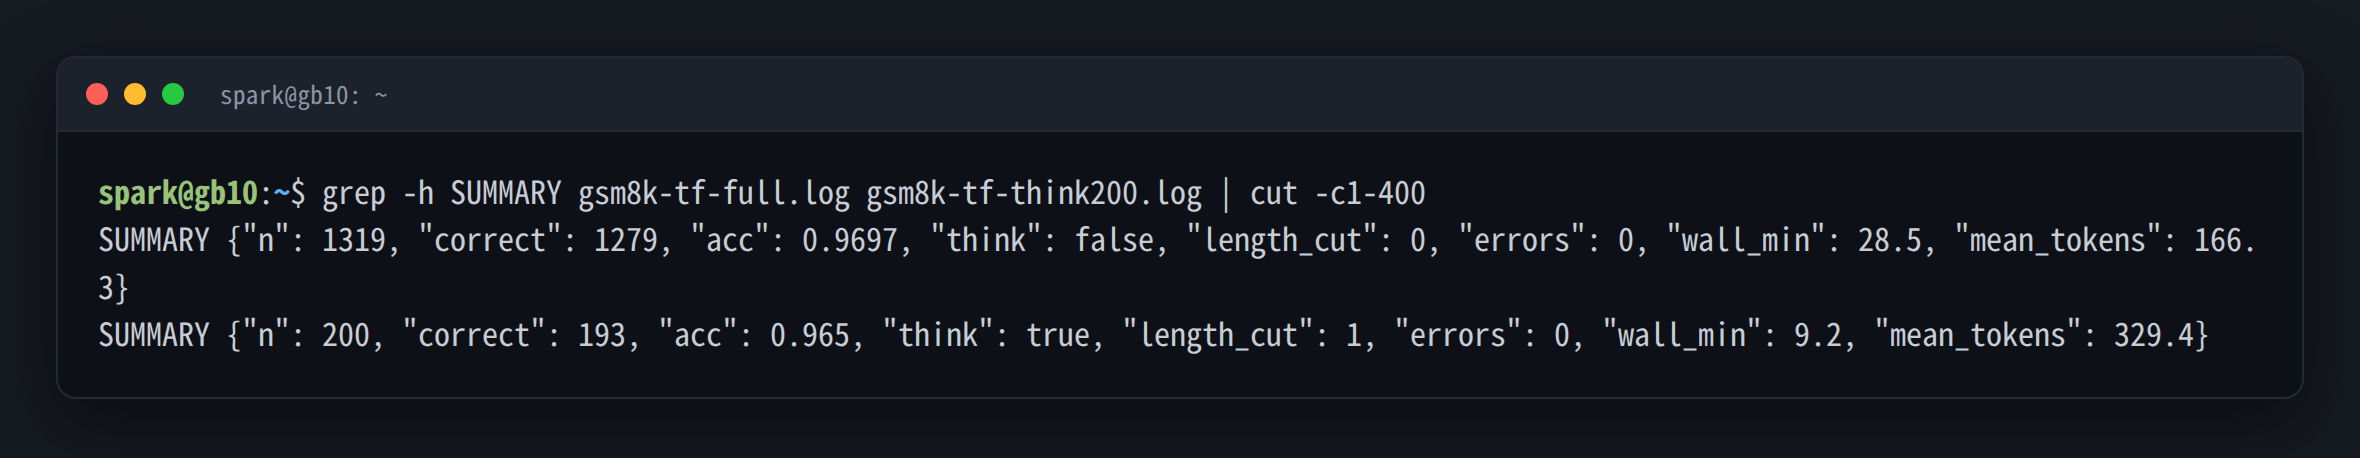
錯的 40 題均逐一確認過,每一題都有明確寫出「Answer:」那一行,評分程式也都抓到了數字,所以是真的答錯,不是格式問題。其中有少數屬於題庫本身的標註爭議,例如模型答 36.36 秒、標準答案寫 36。
開思考有沒有幫助?
兩組題數不同,直接比 96.97% 與 96.5% 沒有意義,所以從全集裡取出同樣那 200 題來比:
| 同一批 200 題 | 答對 | 平均輸出 |
|---|---|---|
| 關思考 | 193 | 177 token |
| 開思考 | 193 | 329 token(其中約 240 是推理) |
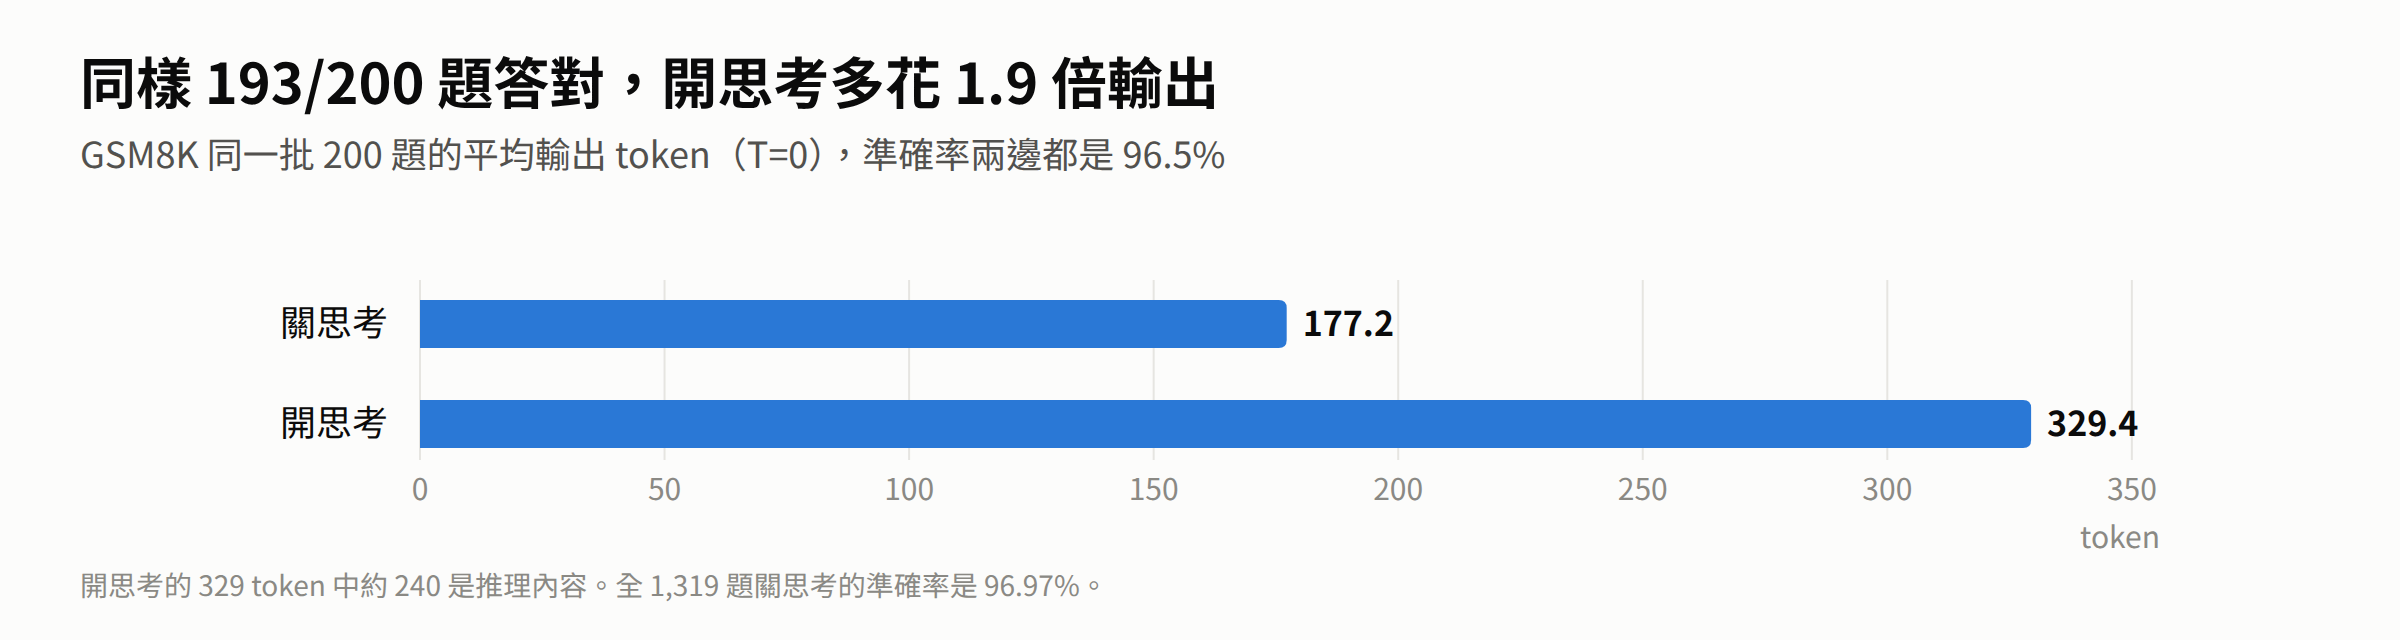
答對的題數完全相同,開思考救回 1 題,同時又錯了 1 題。代價是輸出多了 1.9 倍。GSM8K 對這個模型已經接近飽和,開思考在這類題目上沒有收益。這也支持 hermes 維持「預設不開思考」的設定,大部分人們使用日常的助理任務,多半不需要深度推理,省下來的輸出就是更快的回應。
上一篇 10 題的小樣本裡,關思考因為「推理不收斂、寫到上限被截斷」各錯一題,開思考則全對。到了 1,319 題的規模,關思考一題都沒有被截斷,所以那兩題比較像是個別題目的貪婪解碼走偏,而不是關思考的系統性弱點。
四、為什麼沒有測試 KL divergence 呢
量化品質最嚴謹的指標,是拿量化版與原版模型在同一批文字上的輸出機率分布算 KL divergence。CyberQ 之前已用過社群公布的參考分布量過舊版 V4.1 的量化權重,但那份參考分布是用 9 月版的原版模型算的。
而這次 DeepSeek V4.1 Flash 1017 的權重整份換新,拿 1017 的量化版去比 9 月版的參考分布,量到的會是「模型改版」加上「量化誤差」混在一起的差異,數字沒有意義。要測試這個,需要有人公布 1017 原版的參考分布,或自己用能放下原版權重的機器算,兩台 DGX Spark 放不下約 510 GB 的原版。目前可以參考的是量化作者公布的困惑度,數字分別是程式碼 +1.8%、散文 +0.4%。
五、對 hermes agents 的意義
| 問題 | 答案 |
|---|---|
| 能不能丟圖片給它看? | 可以。引擎端讀圖表與截圖都很準,經 LiteLLM 代理同樣 11 題全對,每題的輸入 token 數與直連完全相同。在 hermes 裡實測兩張圖加後續上網查詢也都正確。hermes 會先由看圖工具把圖轉成文字,主對話不帶原圖。 |
| 上下文開多長才安全? | 51 萬 token 實測可用,記憶體不是問題,但超長 prefill 會讓機器長時間高溫,上一篇模擬 hermes 長對話的測試是 4 萬到 7 萬 token,離這個範圍很遠。 |
| 要不要預設開思考? | 不要。GSM8K 同題對照沒有收益,只多花輸出。 |
六、結論:1017 適合地端做什麼
兩篇測下來,CyberQ 對 1017 在地端的定位是,一套可以長期開著、給個人、小團隊或小公司使用的本地 agent 主力模型。它的強項不是某一項指標特別突出,而是在兩台 DGX Spark 這種小型硬體上,同時做到夠快、工具呼叫可靠、繁中穩定、還能看圖並分析,而且資料完全不離開自己的機器。
適合的情境
- 個人或小團隊的 agent 助理。 這是 hermes 現在的用法,也是我認為最合適的位置。工具呼叫 6/6、長對話簡體字 0、可以 4 路併發;hermes 每輪約 5 萬 token 的對話,第一輪沒有快取時要等約 30 秒,之後靠 prefix cache 多半幾秒內就開始回應。官方這版主打的 agent 分數提升(Terminal-Bench 4.0 從 31.2 到 42.3)我沒有獨立驗證,這兩篇測的是它在本機能不能穩定地用。
- 程式碼輔助與自動化腳本。 程式碼解碼在 T=0 時約 107 tok/s,700 token 的程式碼約 7 秒寫完。這是投機解碼在低溫下的數字,取樣溫度調高時會慢一些。
- 不能外送的文件與圖表。 內部報告、合約、系統截圖、監控圖表這類資料,最適合在地端處理。11 題圖表與截圖全對;25 萬 token 的文件約 2 分半鐘讀完,51 萬 token 也讀得完。這種長度適合排程或一次性的批次工作,例如夜間摘要、文件比對,而不是在對話中臨時丟進一整本手冊。
- 日常的推理與計算。 GSM8K 關思考 96.97%,開思考沒有額外收益。這類工作直接關思考使用,回應更快、輸出更短。
不適合,或要先想清楚的情境
- 多人同時使用的服務。 4 路併發時每路約 30 tok/s,合計約 112 tok/s。給幾個人用沒有問題,但要開給整個部門,排隊會很明顯,需要更多硬體或改用較小的模型。
- 長時間滿載的超長上下文。 51 萬 token 的 prefill 讓熱區到 96°C。記憶體不是瓶頸,散熱才是;要常態處理這種長度,得先改善機器的擺放與散熱,或把文件切段處理。
- 無人值守、要求高可用的正式服務。 TensorFold 遇到裝置錯誤不會自動重啟,重新啟動也要約 2 分鐘。當個人或內部工具可以接受,要當正式服務就得自己補上監控與自動重啟。
- 對判讀精度要求很高的工作。 這是 2.9 bpw 的量化版,作者公布的困惑度只比原版高 0.4% 到 1.8%,但我沒有量 KL divergence;影像也只測了乾淨的數位圖片。要判讀照片、手寫或掃描文件的場合,建議先用自己的資料試過,重要的結果仍要有人覆核。
配方怎麼選
同一份權重,TensorFold 的速度約是 vLLM kit 的 2 倍,正確性打平。目前要在兩台 DGX Spark 上跑 1017,我會選 TensorFold。vLLM kit 的好處是沿用 vLLM 的介面與操作方式,適合已經以 vLLM 為主要基礎設施、願意用速度換取維運一致的環境。
CyberQ 認為,在兩台 DGX Spark 上,1017 已經是能每天實際使用的地端 agent 後端,它的限制主要來自硬體的併發與散熱,模型本身倒是還好囉。
參考模型和資料
DeepSeek:DeepSeek-V4.1-Flash-1017(MIT 授權)
LibertAIDAI:EXL3 2.9 bpw 量化權重(MIT 授權)
Elevatormusic:TensorFold 雙機配方。bertholomus:V4.1 的 TensorFold 引擎實作,以及 ashhart 與 TensorFold 的貢獻者。
OpenAI:GSM8K 資料集(MIT 授權)。