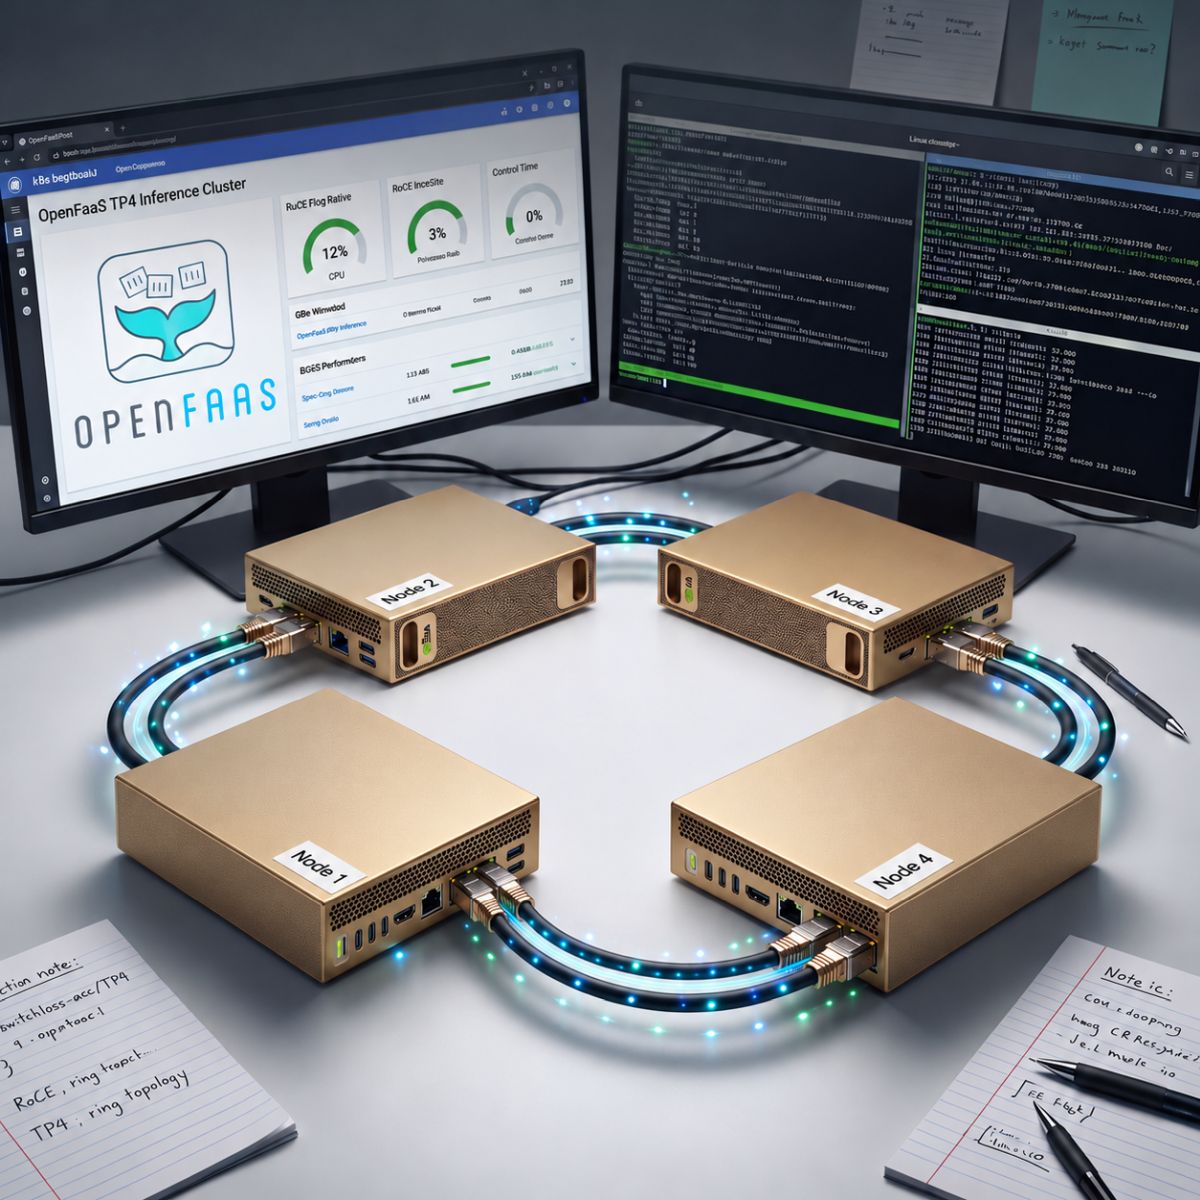
企業採購地端 AI 設備,理由未必來自每百萬 token 的成本比較。OpenFaaS 創辦人 Alex Ellis 在 2026 年 9 月 15 日的部署紀錄中,說明團隊如何從 RTX 工作站逐步走向四台 DGX Spark,他們需要處理不能交給第三方的資料,也希望在自己掌控的環境中執行產品安全測試。這筆投資的評估基準,是工作能否完成,以及資料與服務的控制權。
這個需求有具體的業務背景。Ellis 在較早的Alex Ellis 前篇部署紀錄文章中提到,OpenFaaS 透過診斷工具蒐集客戶 Kubernetes 安裝環境的完整快照,再交由隔離環境中的地端模型協助分析。這類資料直接涉及客戶環境,不能只因雲端模型提供資料保留選項,就認定適合傳送。從部署角度看,資料是否離開企業,以及離開後如何保存,是兩個需要分別判斷的問題。
不過,資料控制只能解釋為何需要地端 AI,設備規模仍須由模型與工作負載決定。OpenFaaS 原先使用 RTX PRO 6000 Blackwell 搭配 Qwen 27B 級模型,Ellis 也記錄過代理在任務中反覆輸出、無法自行脫困的情況。因此,生成速度夠快,仍不能保證代理能可靠地完成長時間工作。評估模型時,工具呼叫、錯誤恢復與人工介入需求,必須與 tok/s 一起觀察。
他接著透過朋友的雙機 DGX Spark 環境測試 DeepSeek V4 Flash 0731,確認符合需求後才採購。原文提到,前兩台配備 4TB SSD 的設備,在英國的購入成本接近一萬英鎊,這是當時的雙機價格。之後增加到四台,則是為了拓展大型模型與內部紅隊測試能力。團隊最終讓不同模型測試自家產品,作者表示,過程中發現並修補了不同嚴重程度的漏洞。
理解這次擴充,需要先看 NVIDIA DGX Spark 的記憶體架構。本案例使用每台 128GB 統一記憶體的 GB10 系統,CPU 與 GPU 共用記憶體,NVIDIA 公布的記憶體頻寬為 273GB/s,並提供 ConnectX-7 高速網路介面。四台的標稱記憶體總和為 512GB,但分散在各節點,模型必須透過支援多節點的推論引擎配置,還須留下作業系統、執行階段與快取所需空間。
這也說明了大容量與高速度之間的取捨。多節點可以讓原本單機放不下的模型進入可部署範圍,同時也引入節點間通訊。選擇硬體時,必須同時確認權重能否容納、上下文需要多少快取,以及推論過程的運算與資料交換成本。只把四台的容量相加,還不足以判斷模型是否實用。
OpenFaaS 的四機部署採用直接接線的 RoCE 環狀拓樸,每個節點連接兩個相鄰節點,透過 TP4 張量平行共同提供推論服務。其公開的 switchless-nccl 專案指出,原版 NCCL 的部分連線方式會嘗試連接環中沒有直接線路的節點,因此需要修補通訊行為,並明確使用 Ring 演算法。這讓四機叢集可以省去高速交換器,但也讓部署依賴特定拓樸與設定。
這套方式有明確的適用範圍。switchless-nccl 要求所有 vLLM 程序載入相同的修補版函式庫,並正確配置網路介面位址與 RoCE 識別資訊,專案也明言,交換器網路與雙節點直連應使用原版 NCCL。對企業而言,省下交換器支出後,仍要承擔軟體版本、節點設定與後續驗證的維護工作。
效能則是另一個需要仔細閱讀的部分。Ellis 開發的 RigMark 將文字、程式碼、可預測輸出、提示詞處理與同時請求分開測試,並記錄模型、量化、推論引擎與測試設定。它的定位是推論服務基準測試,完整代理任務的正確性與完成率,仍需要另外驗證。尤其使用推測式解碼時,草稿模型提出的 token 被主模型接受多少,會隨生成內容改變,單一速度數字很難涵蓋所有工作。
到了 10 月 7 日的 NVIDIA 論壇討論,讀者詢問不同部署配方的同時使用人數為何差異很大。Ellis 回覆,模型量化、引擎與測試方式各不相同,並指出目前使用 RiNGSiDE 配方,文字生成約為 60 tok/s、prefill 約為 5,000 tok/s。他也表示,仍採用雙機 DeepSeek V4 Flash 0731 與四機 GLM-5.3-Flash 兩種設定,這些數字與選擇都是他的部署經驗。對於更大的完整 GLM-5.3 與 DeepSeek V4.1 Flash,他認為前者的 NVFP4 配置無法放進四機,後者在其工作中未帶來足夠增益,因此延續現有模型
RiNGSiDE 的公開測試紀錄與方法提供了更清楚的測試條件。以下為 2026 年 9 月 26 日四機 TP4 測試窗口的結果,使用 RedHatAI 的 GLM-5.3-Flash-NVFP4 權重與 DFlash2 草稿模型,RigMark 推理強度設為 low,各項數字取兩次測試的中位數。這些結果出自專案維護者的紀錄,並非本文另行實測。
| 測試項目 | 公開結果 | 判讀重點 |
|---|---|---|
| 單路文字生成 | 61.7 tok/s | 此測試提示下的文字輸出速度 |
| 單路程式碼生成 | 105.3 tok/s | 生成內容不同,速度也有明顯差異 |
| 單路可預測結構化輸出 | 145.4 tok/s | 應作為特定工作負載的結果 |
| 64K 提示詞冷處理首 token 延遲 | 12.87 秒 | 反映長輸入開始回應前的等待時間 |
| 16 路短程式碼請求整體吞吐量 | 345.8 tok/s | 是所有請求的合計吞吐量 |
因此,能否支援 16 人需要拆成更具體的容量問題。RiNGSiDE 確實公布了 16 路短請求測試,但這與 16 個完整、長時間的代理工作階段不同。專案預設上下文上限為 262,144 tokens,另有較長上下文實驗;其文件特別說明,--max-num-seqs 16 是排程上限,不能據此認定有足夠 KV cache 同時容納 16 個滿長度請求,也不能保證各種負載下的延遲。
對程式代理來說,輸入處理往往尤其重要。Ellis 較早公開的一組四機 TP4 使用紀錄涵蓋 476 次請求,提示詞 token 與完成輸出 token 的比例約為 58:1。這是特定部署的使用樣本,但也提供了有用的觀察,代理反覆讀取程式碼、工具結果與對話內容時,prefill 和前綴快取重用會直接影響操作感受。只比較輸出 tok/s,可能忽略大部分等待時間的來源。
當這些模型開始供團隊共同使用,部署也就進入服務管理階段。Ellis 在前篇部署紀錄文章介紹 Toilgate,用來集中呈現模型與管理存取,他將身分、權限、用量、模型路由與電力監測列為地端 AI 的運維問題。這使硬體投資的評估範圍更完整,除了模型能跑多快,還要考慮誰能使用、如何更新,以及服務是否足以讓同事依賴。
公開配方本身也有導入限制。RiNGSiDE 部署限制 文件說明,實測使用的映像與原生二進位元件並未公開散布,自行重建後需要重新驗證,其 DFlash2 草稿模型另採非商業用途授權,API 則預設沒有驗證與 TLS。這些都是評估該配方能否進入企業環境的實際條件,不能由跑分結果代替。
CyberQ 認為,從這個案例可以歸納出的採購方法,是先選定需要地端處理的工作,再驗證模型品質、延遲、容量與維護成本。單人短任務、多位同事共同使用,以及長上下文代理,需要不同的測試條件。四台 DGX Spark 能提供多少價值,最終仍取決於企業能否把這些條件落實成穩定、可管理的工作流程。