
側錄資安封包系列第二篇,上一篇 用 QNAP NAS 打造資安封包側錄一體機,規劃了一套中小企業負擔得起的封包側錄一體機。這篇則是後續我們想要測試的問題,NAS 等級的硬體做全封包擷取,極限到底在哪裡 ? 有一個概念之後,各家 SI 採用時可以有一個好的基準去估算要採購的硬體規格。
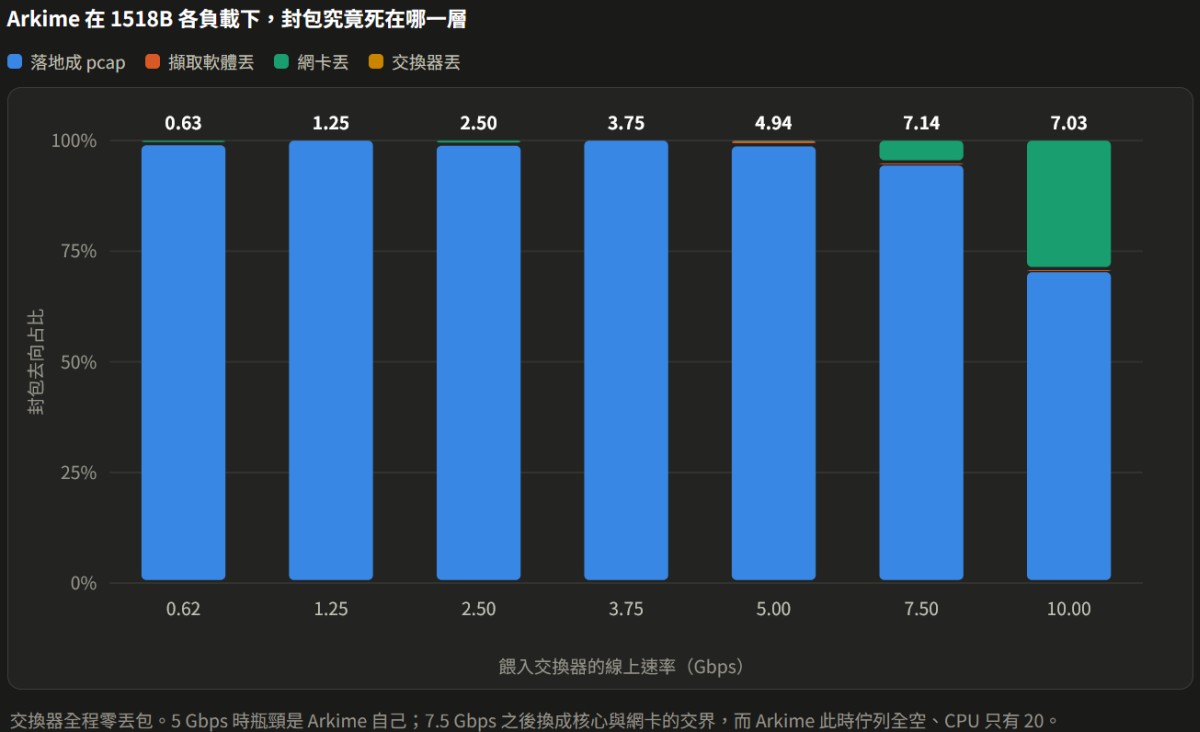
如果不想看測試資料的,可以直接先看結論。這台 8 核心 Intel Atom 處理器 C5125 的機器全封包側錄的零丟包上限是 3.5 Gbps,擋住它的是儲存,位置在每秒 435 到 466 MB 之間。這道瓶頸只看位元組速率,與每秒封包數完全無關。用 284,460 pps 寫 435 MB/s 是零丟包,用 812,743 pps 寫 429 MB/s 也是零丟包,封包數差 2.9 倍,結果一致。
如果改用 snaplen 128 或 256 截斷擷取,10 Gbps 線速零丟包,812,748 pps 全數落地。要守 10GbE 網段,就可選這個路線。
拖了很久的 Arkime 對等比較也做完了。用重放真實流量把兩套工具放上同一個負載之後,這台機器跑 Arkime 的瓶頸在 CPU,磁碟落地被 Atom C5125 擋在 141 到 181 MB/s,掃過四組設定都調不動,詳見下方的結果七。
而擷取軟體本身的天花板,整輪測試結束仍然沒有到。每次把負載往上推,先滿的都是別的環節,依序是鏈路、儲存、流量產生器、網卡。簡單說呢,瓶頸是需要從不同環節的測試中找答案的。
本文所有資料均以 SpesCap 0.6.1 正式版的多執行緒 fanout 引擎為準,搭配 Arkime 做輔助。四輪共 117 個測試點中,有一些資料必須整批作廢,那些測試中的陷阱比數字本身更容易在別人的測試裡重演,已另外整理成番外篇「封包擷取效能測試的量測陷阱」,本文則專注在最終資料與結論。
測試環境
| 項目 | 規格 |
|---|---|
| 網路封包側錄主機 | QNAP TS-855X,Intel Atom C5125 八核心 2.8GHz,64GB RAM |
| 儲存池 | 22.6TB,mirror ×2 + raidz2 ×1,6 顆 Seagate 4TB HDD |
| pcap 資料集 | ZFS,recordsize 128K,compression=off、primarycache=metadata |
| 側錄埠 | 內建 10GbE(atlantic),PROMISC、不綁 IPv4、RX ring 4096 |
| 管理埠 | 另一埠 2.5GbE,側錄與管理分離 |
| 交換器 | QNAP QSW-M3212R-8S4T,鏡像來源埠方向設為「輸入」 |
| 流量產生端 | NVIDIA DGX Spark,enP7s7(Realtek r8127,單一 TX queue),pktgen |
| 受測軟體 | SpesCap 0.6.1(多執行緒 fanout 引擎,對照舊版單執行緒 tcpdump 4.99.6 引擎)、Arkime 6.7.0 |
側錄埠不綁 IPv4 的原因在於,網卡一旦有 IPv4 位址就會自己回 ARP、送 mDNS,那些多出來的封包會全部被錄進去污染樣本,所以要關掉。同時呢,QNAP QTS/QuTS Hero 的介面都不允許完全停用 TCP/IP,所以要把網路卡設成只啟用 IPv6 即可。
測試方法採用 pktgen 為主要封包產生方式
產生器選 pktgen
這是先量過封包產生端的天花板才決定的走向。
| 產生器 | 1518B 訊框 | 516B | 64B |
|---|---|---|---|
| pktgen(單執行緒) | 812,729 pps / 9.999 Gbps | 1,879,062 pps / 8.057 Gbps | 1,865,203 pps / 1.253 Gbps |
| tcpreplay | 273,837 pps / 3.369 Gbps | 543,104 pps / 2.329 Gbps | 1,091,866 pps / 0.734 Gbps |
pktgen 在大封包快了 3 倍。產生端網卡只有 1 條 TX queue,多開 kpktgend 執行緒只是讓它們搶同一條佇列,反而更慢。單佇列下設定 clone_skb,能讓 pktgen 重用同一個 skb 省掉配置成本,設 100 可再提高 32.3%,達到 2.4 Mpps。代價是封包內容固定,等同單一條流,後面會再提到這對 fanout 分派方式的影響。
合成流量有其極限,壓縮與 session 相關的題目必須改用重放真實側錄流量來測,這也留到後面對應的段落說明。
分層計數
CyeberQ 實測如果只記一個總丟包率,沒辦法知道封包掛在哪個地方。因此這次的測試,每個測試點同時記錄四層,包括封包產生端的送出、交換器鏡像埠、NAS 網卡、擷取軟體共四層。每個測試點的 result.json 同時寫入實際生效的擷取設定(引擎、讀取執行緒數、分派方式、snaplen、落地目錄),不能只記錄標籤字串,避免萬一碰到失真資料的影響,來龍去脈可看之後的翻外篇。
前置條件要先設定交換器的鏡像埠方向
要側錄封包,搭配交換器去做事比較好的,網管型或簡易網管型的交換器,能夠設定鏡像埠,這時的設定中,如果來源埠設成「兩者」(輸出輸入 TX/RX 皆鏡像),一個從 port1 送到 port2 的封包會被複製兩次,所以測試中只能開輸入。以下是 CyberQ 實測同一個辦公網段的結果。
| 鏡像方向 | 重複封包 | 實測吞吐 |
|---|---|---|
| 全埠「兩者」 | 49.7% | 3.82 Mbps |
| 全埠「輸入」 | 12.7% | 2.60 Mbps |
改成單向「輸入」後涵蓋範圍完全相同,每個封包在進入交換器時被複製一次。剩下的 12.7% 是流量本身真實的重複(TCP 重送、週期性 ARP/mDNS)。雙向鏡像會讓儲存與側錄埠頻寬各浪費一半,而且分析工具看到的流量是雙倍,TCP 分析可能誤判成重送,所以絕對不要開雙向來側錄封包。
結果一:多執行緒比單執行緒效果更佳
封包測試如果使用單執行緒引擎(單一 tcpdump 行程)在多流量負載下的表現如下。
| 測試點 | 送出 | 端到端丟包 | 落地 |
|---|---|---|---|
| 1518B @ 1.23 Gbps | 99,999 pps | 2.86% | 97,142 pps |
| 1518B @ 2.50 Gbps(線速) | 203,210 pps | 51.7% | 98,232 pps / 1.21 Gbps |
| 64B @ 1.0 Mpps | 999,999 pps | 16.1% | 838,670 pps |
瓶頸在單核。以一秒間隔讀該行程的 CPU 時間,平均 94.9%、峰值 122%,而且在 8 顆核心之間游走。同一時間整機八核平均只有 49.8% busy。用 top 的整機視角去看,會誤判成CPU 不忙的假象。
如果採用多執行緒 fanout 引擎側錄封包,會改用多個 AF_PACKET socket(TPACKET_V3 mmap 環狀緩衝區)加入同一個核心 PACKET_FANOUT 群組,由核心把封包雜湊後分派給其中一個 socket,各自寫各自的檔案。同一組負載、同一台機器測試的結果如下。
| 測試點 | 單執行緒 | fanout×2 | fanout×4 | fanout×8 |
|---|---|---|---|---|
| 1518B @ 1.23 Gbps | 2.86% | 0% | 0% | 0% |
| 1518B @ 2.50 Gbps(線速) | 51.7% | 0% | 0% | 0% |
| 64B @ 1.0 Mpps | 16.1% | 0% | 0% | 0% |
線速那一列的落地量是 203,214 pps,送出是 203,210 pps,一個封包都沒掉,很棒。
值得注意的是 fanout×2 就已經零丟包。這代表增益有兩個來源,一是平行化,二是單執行緒本身的路徑更短(mmap 環狀緩衝區加 1 MiB 寫入緩衝,相對於 libpcap 的逐封包讀取與 stdio 小緩衝)。下一節呢,我們會再把這兩者分離開來。
結果二:單一大流會讓 fanout 退化
PACKET_FANOUT_HASH 以「流」為單位雜湊,好處是同一條連線的封包固定落在同一個檔案,代價是單一條流無法被分散。
用單一條流的封包去打 2.5 Gbps 網速的連接埠,設定為 fanout×4 去吃。
| 分派方式 | 佇列分布 | 端到端丟包 |
|---|---|---|
hash | q2 獨吞 15,471 MB,其餘為 0 | 0.085% |
rnd | q0=4447 q1=4448 q2=4445 q3=4449 MB | 0% |
hash 模式下四個讀取執行緒只有一個在工作,而它仍然只掉了 0.085%。這正好把兩個增益來源分離開來。單一個 fanout 讀取執行緒就已經比單執行緒引擎快一個數量級(tcpdump 在同一點掉 51.7%),平行化屬於額外的餘裕。
這件事在生產環境同樣會發生。如果某條連線本身就佔滿頻寬,比方說我們在機房測試的大型備份、單一伺服器的大量傳輸,這種環境下去側錄封包,hash 會把它全壓在一個執行緒上。此時要改用 rnd,代價是同一條流的封包會散在不同檔案,但沒關係,那是之後分析封包的人要煩惱的事。
結果三:換上 10GbE 之後,瓶頸出現了
把鏡像目的埠改到 10GbE 埠之後重跑矩陣。
| 引擎 | 擷取長度 | 送入 | 落地 pps | 落地寫入 | 端到端丟包 |
|---|---|---|---|---|---|
| 舊版單執行緒 | 完整封包 | 2.5 Gbps | 94,290 | 144 MB/s | 53.6% |
| 舊版單執行緒 | 完整封包 | 10 Gbps | 82,351 | 126 MB/s | 89.9% |
| fanout×4 | 完整封包 | 2.5 Gbps | 203,215 | 311 MB/s | 0% |
| fanout×4 | 完整封包 | 5 Gbps | 312,648 | 478 MB/s | 23.1% |
| fanout×4 | 完整封包 | 10 Gbps | 344,762 | 528 MB/s | 57.6% |
| fanout×8 | snaplen 128 | 10 Gbps | 812,736 | 117 MB/s | 0% |
| fanout×8 | snaplen 256 | 10 Gbps | 812,735 | 221 MB/s | 0% |
十二個測試點的網卡層與交換器層丟包全部是 0,所以端到端丟包就是軟體丟包。
看落地寫入那一欄,答案幾乎是自己跳出來的。每個零丟包的點都在 311 MB/s 以下,每個丟包的點都在 470 MB/s 以上。
那道牆是磁碟,還是 CPU呢 ?
位元組速率有兩個可能的去處,ZFS 的寫入路徑,或是每位元組的記憶體複製成本。兩者都隨位元組數等比例上升,光看矩陣分不出來。
所以分辨的方法比想像中簡單。把儲存從等式裡拿掉。同一組流量、同一組擷取參數,只把 pcap 目錄從 ZFS 換成 /dev/shm。
| 落地位置 | 落地 pps | 落地寫入 | 核心丟棄 | 端到端丟包 |
|---|---|---|---|---|
| ZFS | 628,292 | 961 MB/s | 922,364 | 22.70% |
| tmpfs | 812,600 | 1,243 MB/s | 0 | 0% |
tmpfs 那一輪一個封包都沒掉,核心丟棄計數是 0。擷取路徑在 10 Gbps 線速的全封包負載下吃得下 1,243 MB/s,是 ZFS 持續吞吐的兩倍以上,而且同樣沒有觸頂,所以瓶頸是傳統硬碟 RAID 6,如果你是用 SSD ,這部分就可以再突破了。
另外,還有有一件事要說明,否則這張表會被誤讀。ZFS 那一欄的 961 MB/s 並非持續吞吐。這組對照只跑 5 秒,而 ZFS 的 dirty data 緩衝有 4 GB,5 秒內吸掉了一大部分。同一個測試點跑 60 秒時,落地只有 528 MB/s。短跑會讓儲存看起來比實際好將近一倍,這是規劃容量時會忽略掉的部分。
第二個獨立證據用完全不同的機制再驗一次。同樣寫 ZFS、同樣的擷取參數,只把資料集設成 compression=lz4。合成流量內容高度重複,lz4 會把實際寫到碟片的位元組壓掉大半。
| 條件 | 送入 | 邏輯寫入 | 實體寫入 | 端到端丟包 |
|---|---|---|---|---|
compression=off | 5 Gbps | 622 MB/s | 478 MB/s | 23.09% |
compression=lz4 | 5 Gbps | 622 MB/s | 19.6 MB/s | 0% |
邏輯寫入量完全相同(37.31 GB),實體只寫了 1.18 GB,丟包從 23.09% 變成 0。要強調這只能當作機制驗證,不能當作使用建議。真實流量壓不動,生產環境開壓縮不會獲得這個效果,理由在後面的結果五。
結果四:逼近瓶頸顯示關鍵在位元組
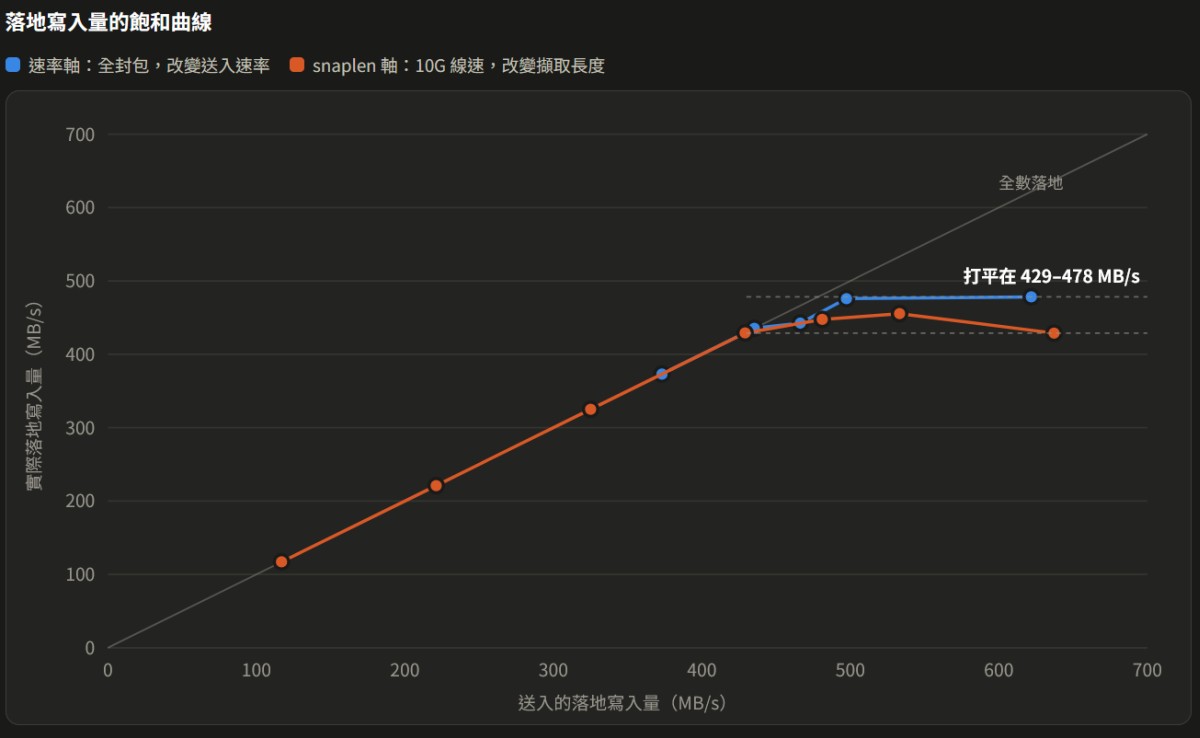
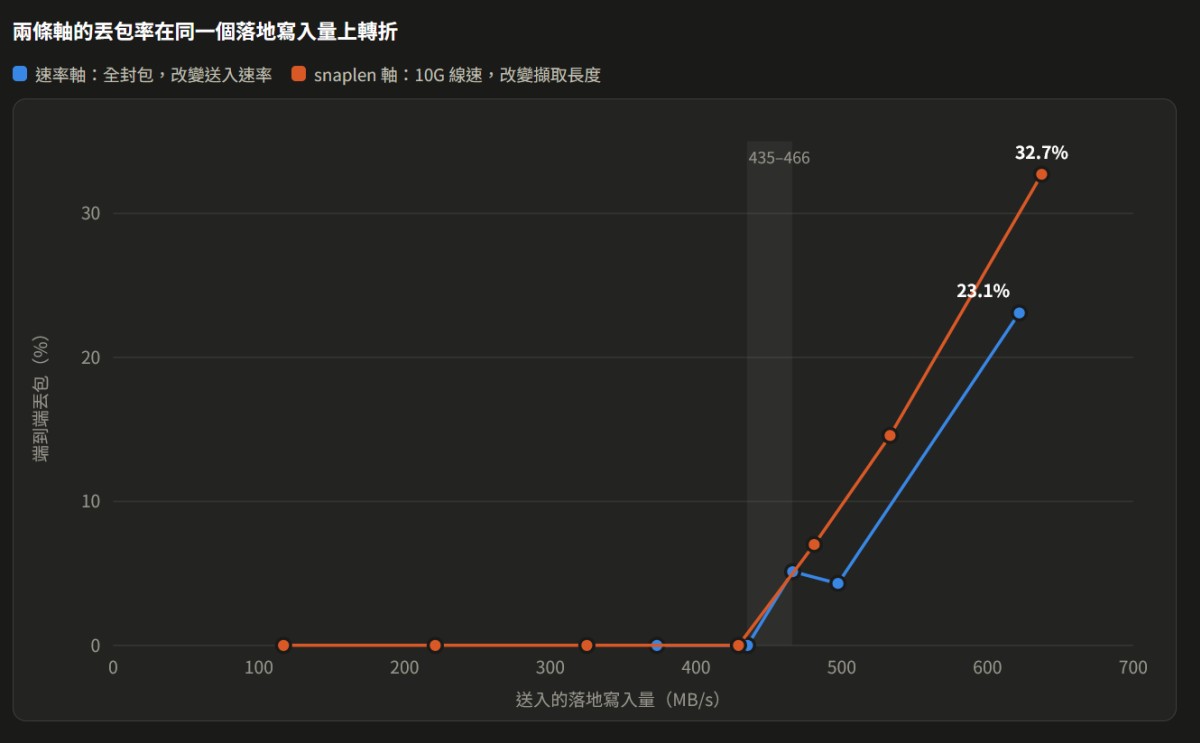
用兩條互相獨立的軸從兩側逼近同一道瓶頸。兩條軸的橫座標都是落地寫入量 MB/s,全部 fanout×4、多流量負載、60 秒一點。
速率軸固定全封包,改變送入速率(每秒封包數跟著變)。
| 送入速率 | 送入寫入 | 落地寫入 | 落地 pps | 端到端丟包 |
|---|---|---|---|---|
| 3.00 Gbps | 373 MB/s | 373 MB/s | 243,877 | 0% |
| 3.50 Gbps | 435 MB/s | 435 MB/s | 284,526 | 0% |
| 3.75 Gbps | 466 MB/s | 442 MB/s | 289,166 | 5.13% |
| 4.00 Gbps | 497 MB/s | 476 MB/s | 311,106 | 4.31% |
snaplen 軸固定 10G 線速的 812,743 pps,只改每個封包存下多少位元組。
| 擷取長度 | 送入寫入 | 落地寫入 | 落地 pps | 端到端丟包 |
|---|---|---|---|---|
| snaplen 128 | 117 MB/s | 117 MB/s | 812,748 | 0% |
| snaplen 256 | 221 MB/s | 221 MB/s | 812,743 | 0% |
| snaplen 384 | 325 MB/s | 325 MB/s | 812,744 | 0% |
| snaplen 512 | 429 MB/s | 429 MB/s | 812,740 | 0% |
| snaplen 576 | 481 MB/s | 448 MB/s | 755,866 | 7.00% |
| snaplen 640 | 533 MB/s | 455 MB/s | 694,262 | 14.58% |
| snaplen 768 | 637 MB/s | 429 MB/s | 546,922 | 32.71% |
最直接的一組對照如下。3.50 Gbps 那點用 284,460 pps 寫 435 MB/s,零丟包。snaplen 512 那點用 812,743 pps 寫 429 MB/s,同樣零丟包。每秒封包數差 2.9 倍、位元組速率相同,結果一致。
兩條軸的轉折也落在同一段。零丟包的最高點是 435 與 429 MB/s,開始丟包的最低點是 466 與 481 MB/s。牆因此收窄到 435 到 466 MB/s。換算成全封包側錄的實用結論,3.5 Gbps 零丟包,3.75 Gbps 就開始掉。
瓶頸是一段帶狀區間
超載時的持續落地量在 429 到 476 MB/s 之間跳動,3.75 Gbps 掉 5.13%,比 4.0 Gbps 的 4.31% 還高。HDD 與 ZFS txg 的時序讓相鄰兩點有約 8% 的變異。
結果五:開或不開 ZFS 壓縮都沒差,但校驗和讓證據完整性可證明對監管價值。
ZFS 壓縮牽涉兩個問題,省不省空間,以及是否吃吞吐量。兩題都用真實流量測。
第一個是空間。把樣本寫進另一個 compression=on(即 lz4)、recordsize=128K 的資料集,逐檔比對邏輯位元組與實際佔用的區塊,得到的就是 ZFS 自己的 lz4 壓縮比。
| 樣本 | 邏輯 | 磁碟 | ZFS lz4 壓縮比 |
|---|---|---|---|
| 真實流量,完整封包 | 49.00 MB | 48.98 MB | 1.000× |
| 真實流量,截斷 128 | 6.53 MB | 6.49 MB | 1.006× |
| 真實流量,截斷 256 | 10.96 MB | 10.88 MB | 1.007× |
| 合成流量(snaplen 128) | 50.33 MB | 12.60 MB | 3.993× |
真實流量截斷到 128 bytes 之後,lz4 只壓到 1.006×,等於沒有壓縮到。snaplen 128 帶來的空間效益全部來自截斷封包資訊本身(49.00 降到 6.53 MB,約 7.5 倍),壓縮再疊上去只多 0.6%。合成流量那個 3.99× 純屬 pktgen 內容重複造成的假象。
第二個是吞吐。這個項目呢,合成流量永遠測不到,因為合成封包在 ZFS 上被壓掉 30 倍以上,儲存路徑根本沒影響。所以測試改用重放真實側錄流量,30 萬個封包、平均訊框 640 bytes、83% 位元組是 TLS 加密負載,也就是壓縮也壓不動的。
另外,CyberQ 提醒,這裡有個安全問題要先處理。把側錄到的真實流量原封不動打回正式 LAN 是會出事的,真實 MAC 會在交換器的 FDB 之間跳動,而且目的主機真的會收到那些封包。處理方式是用 tcprewrite 只改寫二層位址,變成「產生器到單一已知主機」的單播,L3/L4 與負載完全不動。這樣既保住不可壓縮的內容與多流特性(fanout 的 hash 才有東西可分),又不會干擾任何其他主機。
fanout×4、全封包、60 秒一點,用多行程重放把負載推過瓶頸。
| 行程數 | 壓縮 | 送入寫入 | 落地寫入 | 軟體丟包 | ZFS 實測比值 |
|---|---|---|---|---|---|
| 3 | lz4 | 585 MB/s | 457 MB/s | 22.69% | 1.009× |
| 3 | off | 613 MB/s | 460 MB/s | 25.87% | 1.000× |
兩邊都遠超過瓶頸,此時落地寫入測試到的就是儲存的持續寫入能力。460.0 對 457.0 MB/s,相差 0.65%,小於這輪矩陣相鄰測試點之間本來就有的約 8% 變異。
所以壓縮這件事的完整結論如下。空間換不到(真實流量 1% 上下),吞吐也不會被吃掉。開與不開都不影響側錄能力。如果是要進行封包側錄的專用機器,效能要往上提升的話,這邊建議會維持關掉,理由只是少一個變數。要省空間該調的是 snaplen,截斷本身就有 7.5 倍。
ZFS 適合當側錄儲存的真正理由與壓縮無關。校驗和讓證據完整性可被證明,對監管鏈有實質價值。快照讓事件後瞬間凍結證據,成本趨近於零,搭配 WORM 更完整。recordsize 1M 適合大塊循序寫入。primarycache=metadata 則是因為 pcap 寫一次幾乎不再讀,讓它進 ARC 只會把其他服務的工作集擠出去。
結果六:小封包的限制在網卡,約 1.6 Mpps
把產生器用 clone_skb=100 推上 2.4 Mpps 之後打 NAS。clone_skb 的代價是單一條流,所以配 fanout_mode=rnd,並加測 hash 當對照。
| 分派方式 | 送入 pps | 落地 pps | 佇列分布 | 網卡丟棄 | 擷取軟體丟棄 |
|---|---|---|---|---|---|
| rnd | 2,357,743 | 1,605,252 | 平均(934 到 935 MB) | 45,669,969 | 0 |
| hash | 2,409,618 | 1,453,180 | q5 獨吞 6,621 MB | 57,343,317 | 0 |
兩種模式的擷取軟體丟包都是 0。連只有一個讀取執行緒在工作的 hash,都跟得上 1.45 Mpps。這一點的寫入量只有約 125 MB/s,遠低於 435 MB/s 的儲存瓶頸,所以也和儲存無關。
丟包全部發生在網卡層。所以 64B 的限制是網卡接收路徑,約 1.6 Mpps,而 fanout 引擎本身的天花板仍然沒有到。
順帶一個沒有定論的觀察。hash(一個讀取執行緒)的網卡丟棄比 rnd(八個)多 26%。環狀緩衝區從未填滿,所以合理推測是那個滿載的讀取執行緒與網卡的 softirq 搶同一顆核心。這只是推測,沒有進一步驗證。
結果七:Arkime 的對等比較,瓶頸在 CPU
前幾輪已經確認合成 pktgen 流量對 Arkime 是不適合的輸入。單一條流會被它的去重機制整批丟掉,隨機化多條流則會讓每個封包幾乎都變成一條新連線,60 秒產生 844 萬條 session,把 OpenSearch 的索引撐爆。兩種形態都測不到它的擷取能力。
所以這一輪改用重放自家辦公室網段的真實側錄流量,送入速率用 tcpreplay -M 鎖死,同一個負載上兩套工具各跑一次,兩邊實際送入量偏差在 0.07% 以內。對等的定義如下。
| 項目 | SpesCap 0.6.1 | Arkime 6.7.0 |
|---|---|---|
| 擷取路徑 | fanout,4 個 AF_PACKET 讀取器 | pcapReadMethod=afpacketv3,tpacketv3NumThreads=4 |
| 落地格式 | 未壓縮 pcap | simpleCompression=none,未壓縮 pcap |
| 資料集 | 同一個 compression=off、primarycache=metadata 資料集 | 同左 |
走到答案之前處理過的困難
讀取路徑不對等
Arkime 預設的 pcapReadMethod 是 libpcap,只有一條讀取執行緒,在 310.0 MB/s 的真實流量下核心環形緩衝直接掉 55.25%。改成 afpacketv3 加四條執行緒之後核心層丟包歸零。本文上半部提到那個「大封包快 7.9 倍」與這裡的 55%,其實是同一件事的兩面,比的都是設定,不是能力。
dedupPackets=0 關不掉去重。
Arkime 6.7 會在 log 印出 Resetting dedupPackets since 0 is less than the min 65535,實際生效值是 65535。在 55 萬 pps 之下這個視窗只有約 0.1 秒,遠短於重放檔繞一圈的時間,所以迴圈重複的封包不會被誤判成鏡像重複,結論不受影響,但這件事得先確認才敢往下走。
totalDropped 看不到真正的丟包
讀取路徑改對之後,arkime_stats 回報的丟包變成 0,看起來 Arkime 追平了。但去量它實際寫到碟片上的位元組,只到 SpesCap 的六成以下。Arkime 讀進來之後在自己的封包佇列上溢位丟掉的那一批,統計文件裡完全看不到。兩套工具唯一共通的尺是磁碟上的位元組,封包計數器的語意各家不同,totalPackets 算的是處理過的、received 算的是核心遞交的,因此二家會不一樣。
對等之後的結果
| 送入落地 MB/s | SpesCap 落地 | SpesCap 丟包 | SpesCap CPU | Arkime 落地 | Arkime 核心層丟 | Arkime 內部丟 | Arkime CPU |
|---|---|---|---|---|---|---|---|
| 310.0 | 309.8 MB/s | 1.60% | 65.4% | 182.9 MB/s | 0.00% | 41.8% | 97.5% |
| 475.4 | 455.9 MB/s | 5.56% | 79.4% | 130.0 MB/s | 5.82% | 71.4% | 99.1% |
| 561.1 | 373.5 MB/s | 34.02% | 73.7% | 113.4 MB/s | 18.05% | 76.0% | 99.0% |
內部丟包率是用位元組推導的,分母是核心真的遞交給 Arkime 的封包量,分子是它真的寫到碟片上的位元組。Arkime 落地的位元組是 SpesCap 的 0.29 到 0.59 倍,而它把整台 NAS 的 CPU 吃到接近滿載。
差距是沒辦法改設定補上的
在最低那個負載上用了四組不同的設定看成績能不能往上。
| 讀取執行緒 | packetThreads | 佇列上限 | 磁碟落地 | 全機 CPU |
|---|---|---|---|---|
| 4 | 4 | 400,000 | 141.3 MB/s | 98.6% |
| 4 | 4 | 2,000,000 | 165.6 MB/s | 99.1% |
| 2 | 6 | 2,000,000 | 181.0 MB/s | 98.7% |
| 4 | 6 | 2,000,000 | 157.8 MB/s | 98.7% |
磁碟落地量在 141.3 到 181.0 MB/s 之間,每一組的全機 CPU 都接近滿載。同一組設定跑三次量到 165.5、165.6、182.9 MB/s,重跑變異約一成,所以這張表裡小於一成的差距可省略。讀取執行緒從 4 降到 2 會讓核心層開始掉封包,packetThreads 從 4 加到 6 則是 10 條執行緒去擠 8 個核心,反而更差。這台機器跑 Arkime 的瓶頸不在儲存也不在擷取路徑,在 Intel Atom C5125 這顆處理器。
原因回到兩套工具每個封包做的事。SpesCap 寫進 pcap 就結束,同一負載下全機 CPU 只用 65.4%。Arkime 還要協定解析、建立 session 索引、把索引推進 OpenSearch,而 OpenSearch 就在同一台機器上跟它搶 CPU 核心的使用權,所以肯定會比較慢。
所以怎麼選呢 ?
| SpesCap | Arkime | |
|---|---|---|
| 每個封包做的事 | 寫進 pcap 就結束 | 寫 pcap + 協定解析 + 建立 session 索引 |
| 這台機器上的落地上限 | 儲存牆 435 到 466 MB/s | CPU 天花板 141.3 到 181.0 MB/s |
| 外部依賴 | 無 | OpenSearch(8GB heap 起跳,與擷取搶同一顆 CPU) |
| 檢索 | 依時間區間匯出 pcap,自己開 | 依 IP、埠、JA4、SNI 在網頁介面檢索 |
| 部署 | 一個 QPKG | 兩個容器加資料庫初始化 |
要事後檢索、而且流量在 181 MB/s 以內,Arkime 划得來。要在這台機器上把頻寬吃到儲存的極限,就只能選 SpesCap。如果換一顆更好的桌上型或伺服器等級的 CPU,這個結論很可能會不一樣,但在 8 核 Atom 處理器上 Arkime 確實會比 SpesCap 吃力,SpesCap 更適合在中小企業的中小型 NAS 上擔任網路封包側錄設備和搭配資安封包分析軟體或平台使用。
擷取能力之外,兩者的定位差異倒是很清楚,一個是搭配 QNAP NAS 的單一 QKPG 軟體,一個是可採用容器部署的軟體組合 (加上OpenSearch )。要事後在網頁介面檢索就用 Arkime。只要留證據、把資源留給儲存就用 SpesCap。
改善效能測試的紀錄
最有效,換掉單執行緒的擷取路徑。2.5 Gbps 線速下丟包從 51.7% 降到 0%,10 Gbps 下落地量是舊引擎的 4.2 倍。整輪測試裡唯一數量級的改變。
snaplen 截斷同樣有效
10 Gbps 線速下 snaplen 128 與 256 都是零丟包,空間約 7.5 倍、擷取成本降九成。代價是失去完整的負載證據。在 10GbE 網段上,這是目前唯一能同時解掉擷取與儲存兩道牆的做法。
ZFS 壓縮開或關沒有差別
真實流量本來就壓不動(1.006×),實測也不吃吞吐(超載持續落地量 460 對 457 MB/s)。
把讀取執行緒從 4 加到 8 也沒有差別
送入量相同時反而少落地 1.7%。瓶頸在儲存側,加讀取執行緒只是多一個寫入串流來搶同一條路。加執行緒只有在瓶頸所在的那一段才能獲得能力。
網卡的 RX ring buffer 有效但改善有限
10GbE 埠從 4096 加倍到 8184,網卡層少丟了 436 萬個封包,但下游丟包跟著上升,淨落地量只多 4.2%。瓶頸只是往下游搬了一段。要警告的是,這個指令曾讓測試機當機且設定不持久,細節見姊妹篇,不要在營運時間直接調整。
這台機器能守多大的網段
| 情境 | 建議 |
|---|---|
| 全封包側錄 | **3.5 Gbps 零丟包,3.75 Gbps 開始掉。**限制在儲存側的位元組速率,加執行緒沒有用 |
snaplen 128/256 | 10 Gbps 線速零丟包,實測 812,748 pps 全數落地。要守 10GbE 網段就走這條 |
| 小封包為主的網段 | 限制在網卡接收路徑,約 1.6 Mpps,擷取軟體本身還有餘裕 |
| 需要事後依 IP/埠/JA4 檢索 | 流量在 181 MB/s 以內用 Arkime,超過就得在檢索與頻寬之間取捨,在這顆 CPU 上兩者不可兼得 |
| 網段流量以單一大流為主 | fanout 要改用 rnd 分派,否則會退化成單執行緒 |
| 要拉長可回溯期 | 先調 snaplen(約 7.5 倍),再考慮加硬碟。不要指望壓縮 |
| 儲存是瓶頸 | 關掉壓縮、primarycache=metadata、recordsize 1M,讀取執行緒設 4 就好 |
實務上的組合建議是這樣,全網段 snaplen 128 長期保存,另開一個窄 BPF 條件的工作錄關鍵主機的完整負載。前者守得住 10GbE,後者的量小到不會碰到牆。核心的 BPF 過濾發生在複製到使用者空間之前,所以第二個窄條件的工作幾乎不增加成本。
還有一個前提不會變。鏡像目的埠的線速就是整套系統的硬上限。把 11 個 10G 埠鏡像到一個 2.5G 目的埠,比例是 44:1,丟包會發生在交換器,跟 NAS 的能力無關。
未解問題下一篇番外篇待續
fanout 引擎的天花板仍然沒有到。整輪下來,擋住它的依序是鏈路、儲存、產生器、網卡。要繼續往上推,需要換一張小封包接收能力更好的網卡,或用多台產生器分打到多張網卡。
儲存側的下一步是划不划算的問題。瓶頸已經確認在磁碟。10 Gbps 線速的全封包側錄需要持續 1,243 MB/s,等於每小時 4.5 TB、每天 107 TB。普通的 SSD 在這種大量資料的情況下只能當落地緩衝,回溯期還是得靠 HDD 承接。要評估的是SSD 收、背景搬到 HDD這套機制。
Arkime 在 CPU 不是瓶頸的機器上能走到哪裡,還沒有定論,本文只有確認它在 8 核 Atom C5125 上被 CPU 擋在 141 到 181 MB/s,但那是這顆處理器的結論,不能當成 Arkime 的結論。要知道它的真正上限,得換一台 CPU 不是瓶頸的機器跑才行。
儲存瓶頸的絕對位置只在這一組硬體上成立,所以你用更高階的硬體和儲存硬碟,更多顆或 SSD 的採用,瓶頸就能往上突破並提升超大量封包擷取的效能。這款機器的 6 顆 HDD 的 mirror×2 加 raidz2 換成別的配置,數字一定會變,但「只看位元組速率、與每秒封包數無關」這個性質應該不變。