Google 在 Antigravity CLI(指令名稱 agy)開放了 Gemini 4 Argon,官方介紹是「最強的先進模型,為複雜、多步驟的 agent 工作流程與深度推理打造」。宣傳文字說明不了實際能力,所以 CyberQ 把 Argon 放進先前評測本地模型時用過的同一組 agent 題目,七個任務,每題跑三次,每次都用全新的工作目錄,通過與否一律由腳本判定,不看 agent 自己怎麼描述。
簡單的測試結果可以先說,21 次中通過 20 次。七題裡唯一分得出高下的第 03 題(讀崩潰 log 寫出完整修法)答對兩次,這是目前測過的所有組合中最好的成績。唯一的失敗不是答錯,而是查資料查到中止。另外也記錄了在 headless 模式跑 agy 時會遇到的三個陷阱,沒處理的話,結果會看起來像模型很差。
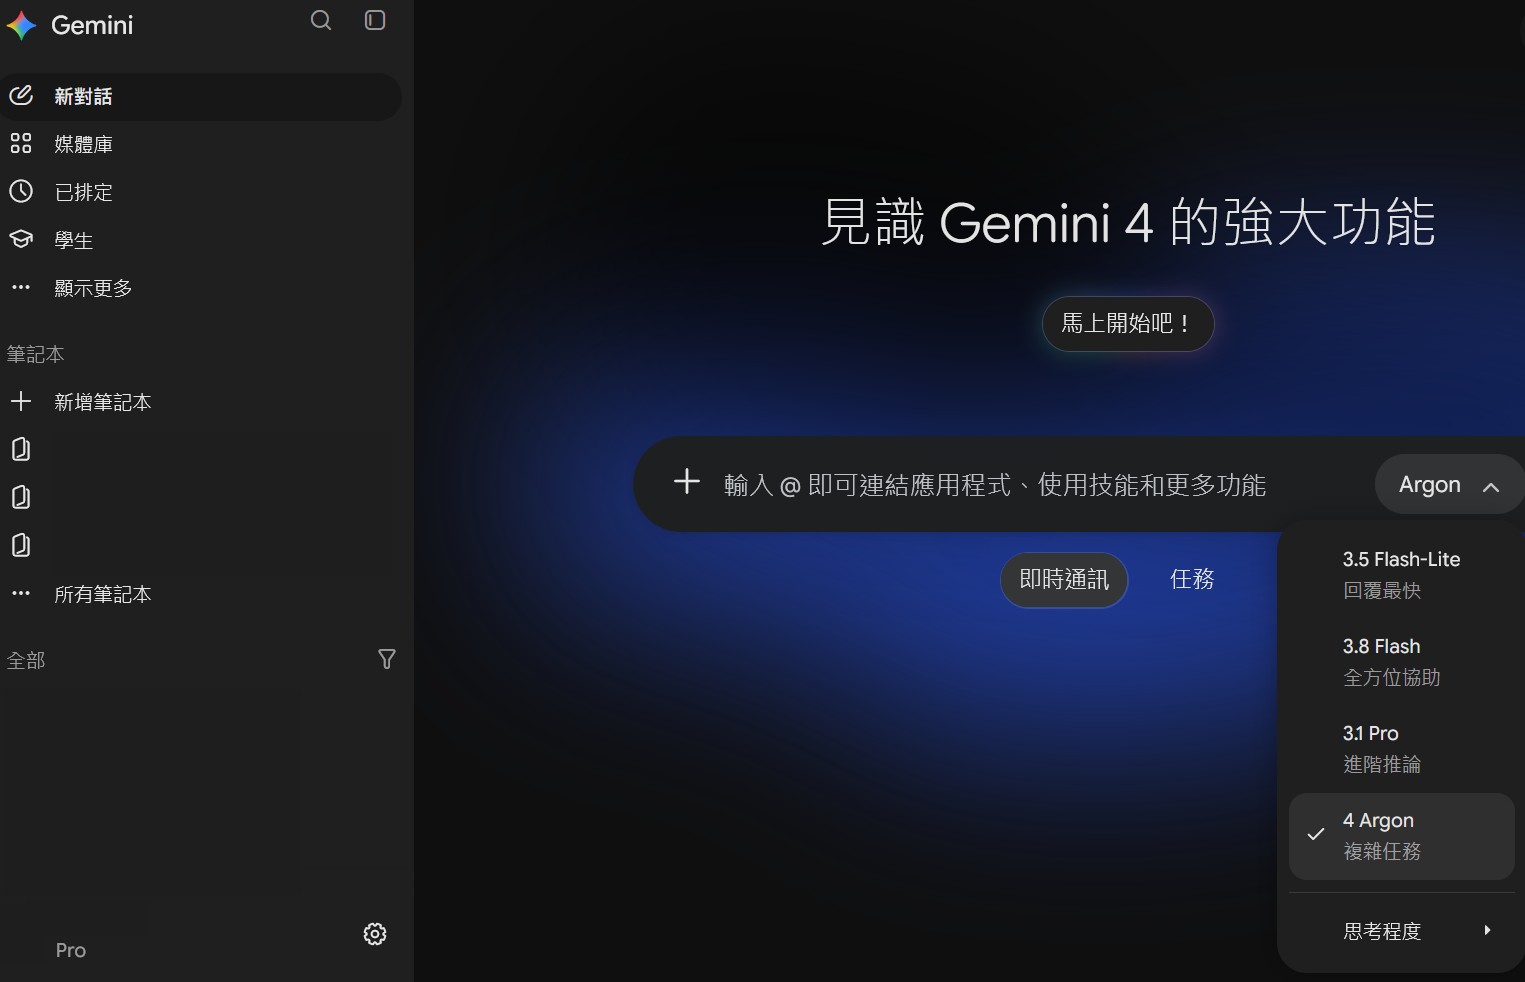
目前 Gemini 4 Argon 如果要用在 Agy Cli ,只有 Ultra 訂閱用戶或 API 用戶可用。如果是 Pro 用戶,目前主要是用 web 介面來切換使用。
一、測試方法
CyberQ 的測試題目沿用先前 390 次本地模型實測的同一組,涵蓋 agent 日常會做的事:
| 任務 | 內容 |
|---|---|
| 01 | 修一個會靜默丟掉最後一段的 off-by-one bug,測試要全部通過 |
| 02 | 把兩個模組裡重複的函式抽成共用模組,行為不變 |
| 03 | 讀一份 vLLM 啟動失敗的 log,寫出根因與完整的環境變數修法 |
| 04 | 找出設定檔的埠衝突並修好,但契約埠不能動 |
| 05 | 從零寫一個 CLI 工具,要通過一份沒給它看過的測資 |
| 06 | 在一份九萬多 token 的文件裡找出三個散落的事實 |
| 07 | 四步相依的工具鏈:讀檔、計算、寫檔、自我驗證 |
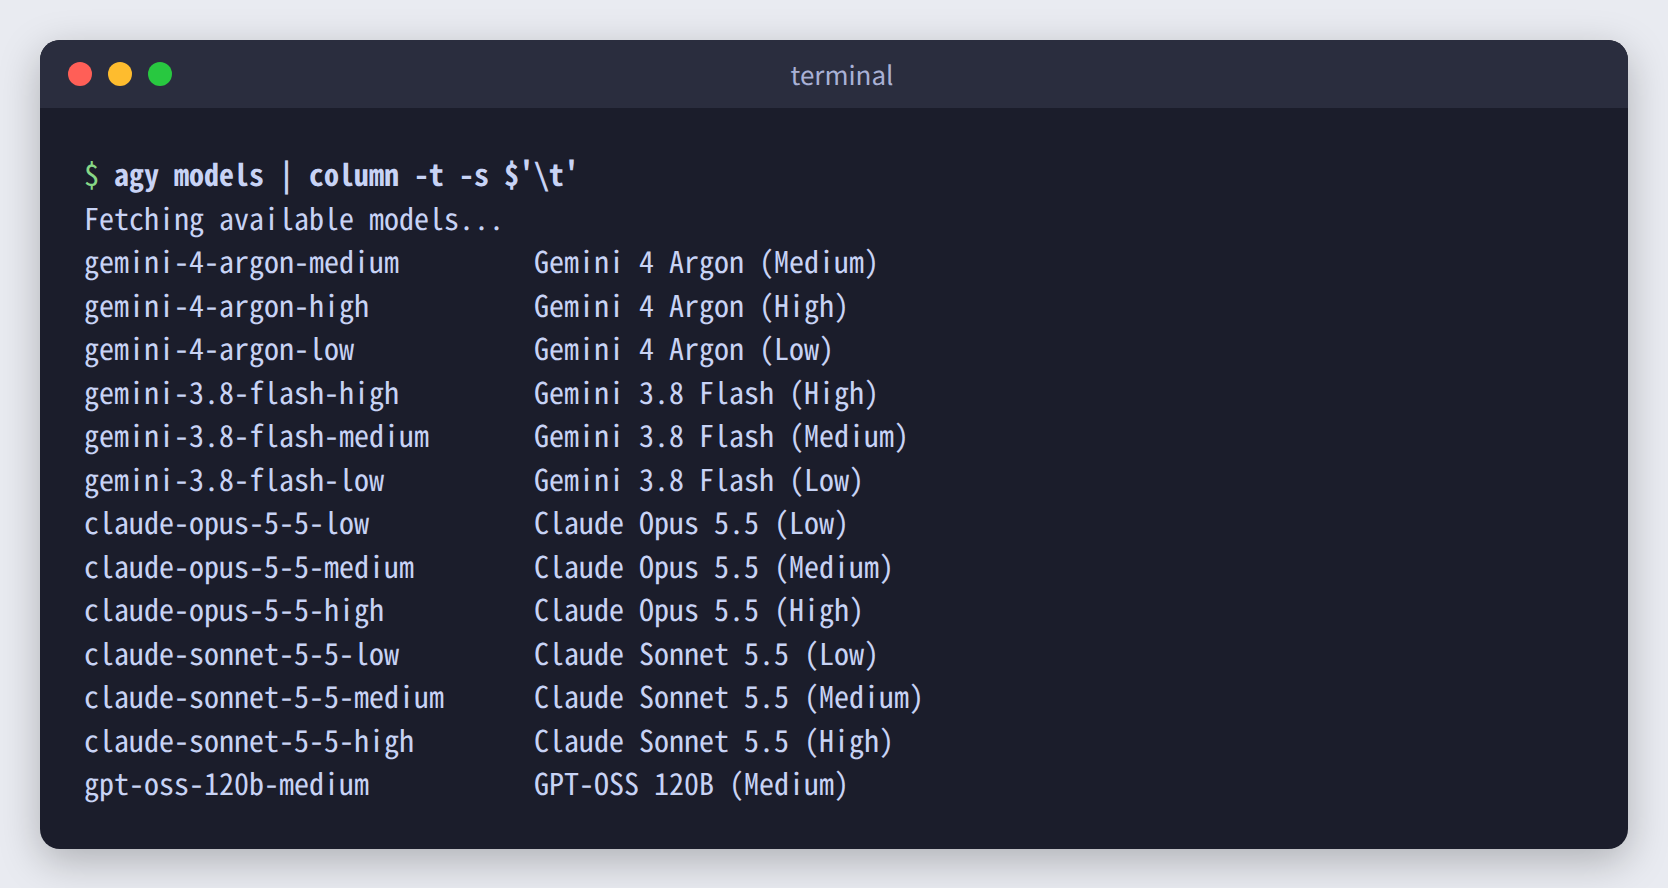
每題給 900 秒預算,跑三次。模型是 gemini-4-argon-high,也就是 Argon 的 High 思考強度。agy models 列出的 Argon 有 Low、Medium、High 三檔:
二、結果總覽:20/21
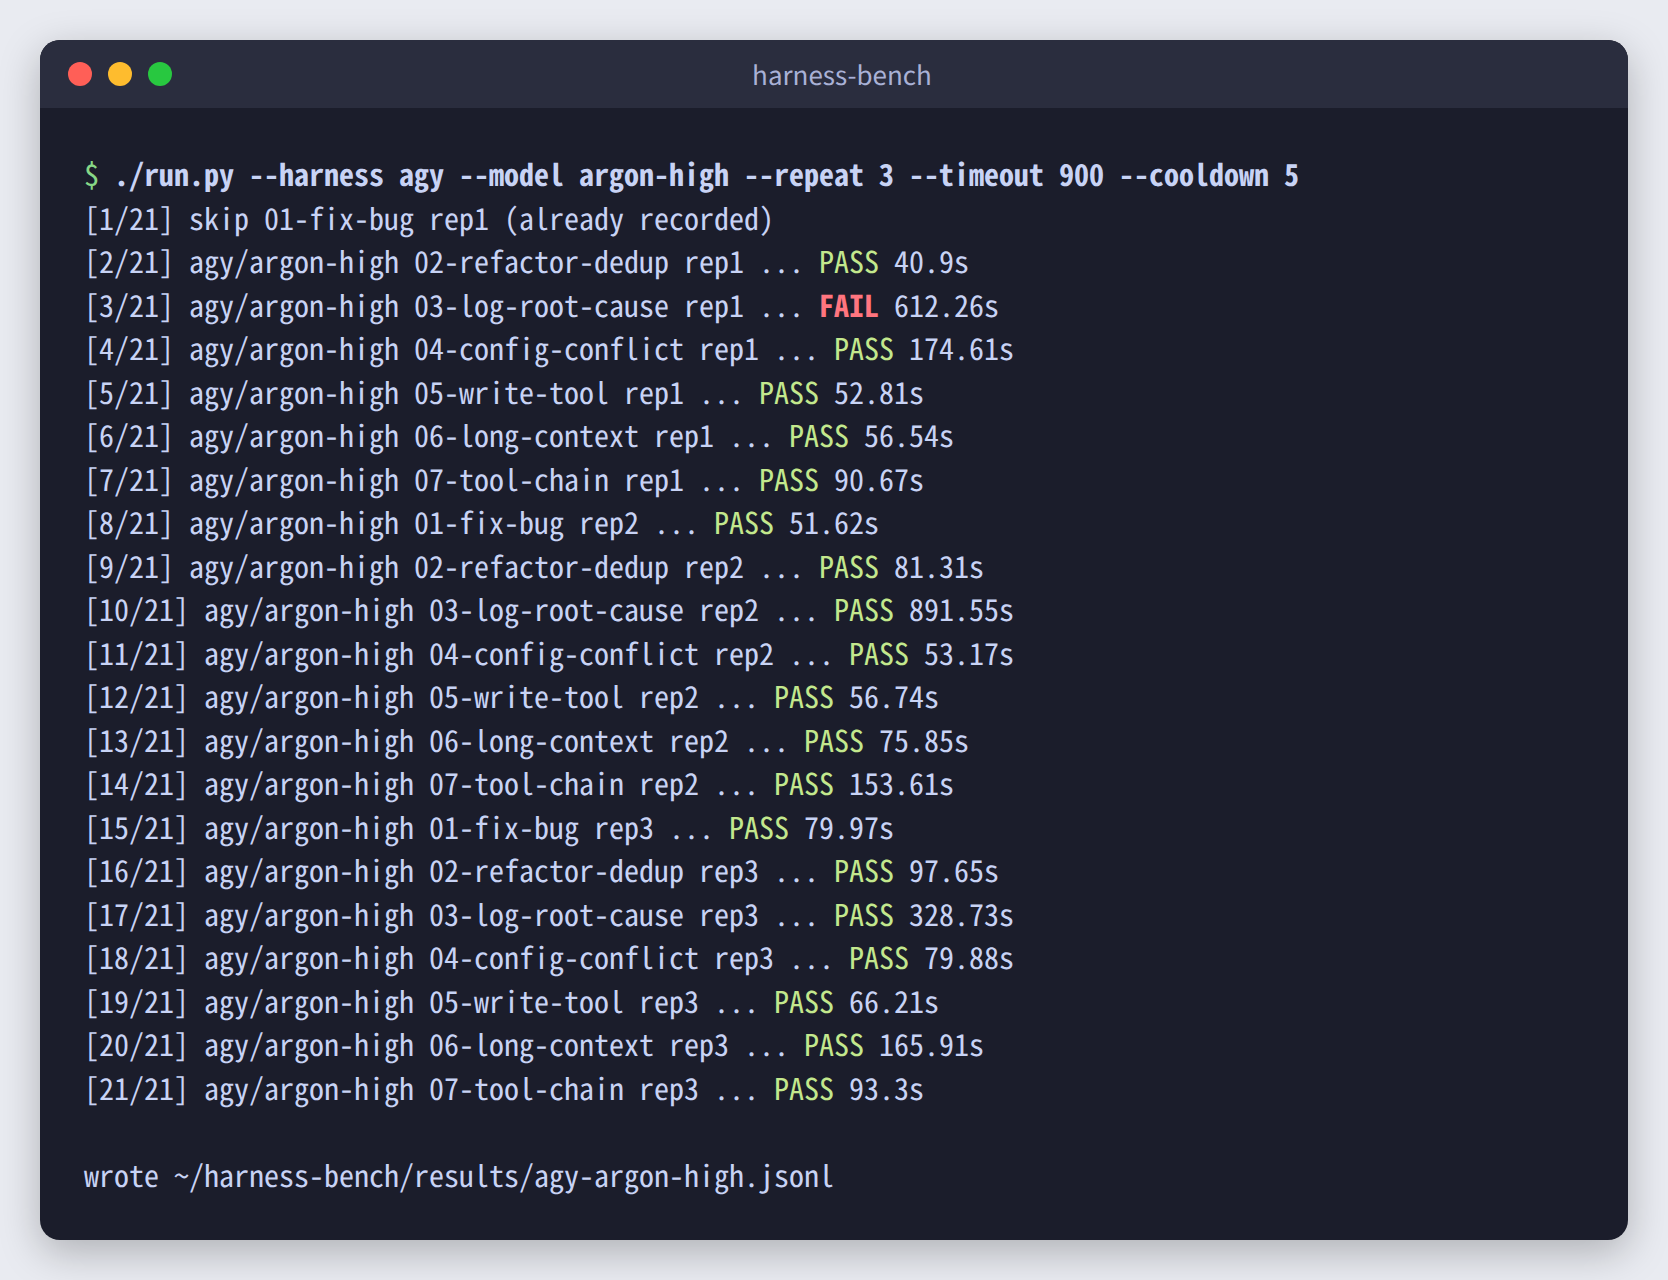
| 任務 | 通過 | 耗時中位數 |
|---|---|---|
| 01 修 bug | 3/3 | 51.6 秒 |
| 02 重構去重 | 3/3 | 81.3 秒 |
| 03 log 找根因 | 2/3 | 612.3 秒 |
| 04 設定衝突 | 3/3 | 79.9 秒 |
| 05 寫工具 | 3/3 | 56.7 秒 |
| 06 長上下文 | 3/3 | 75.8 秒 |
| 07 工具鏈 | 3/3 | 93.3 秒 |
第 03 題以外的 18 次全部通過,耗時中位數 78 秒,最長 175 秒。這六題在本地模型上同樣全數通過,所以它們分不出高下,這次也一樣。
與先前的本地組合放在一起看:
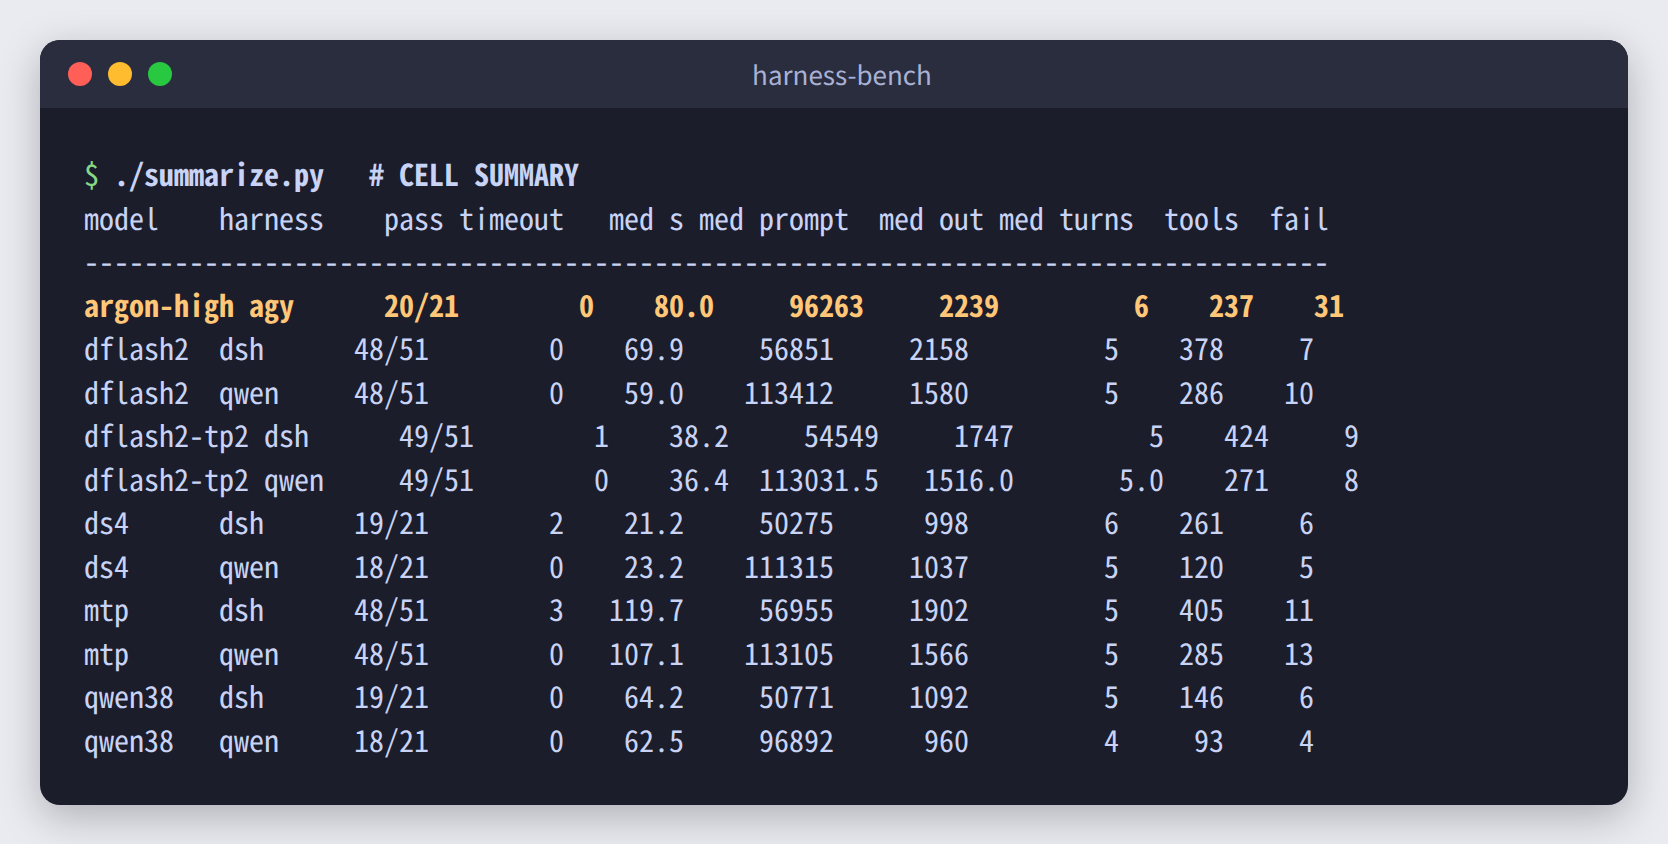
這張表的秒數不能直接比較。Argon 在雲端,耗時包含網路與排隊,本地組合是 NVIDIA DGX Spark 上的實際推論速度,所以這次能比的是通過率與失敗型態。
三、第 03 題:唯一分得出高下的題目
第 03 題給的是一份真實的 vLLM 崩潰 log,結尾是:
AssertionError: DeepGEMM layout transform requires sm_90a or sm_100a, got sm_121a
陷阱在於只關掉 VLLM_USE_DEEP_GEMM 不夠,MoE 那條路徑有自己的開關 VLLM_MOE_USE_DEEP_GEMM,兩個都要設成 0。題目也明確要求「每個需要的變數都要列出,只給一部分不算數」。
本地組合在這題的成績是每組三次中 0 到 1 次通過。兩套 harness 的失敗方式正好相反,DeepSeek Harness 會一直查證,查到超時都沒寫出檔案,Qwen Code 則很快交卷,但把變數名少寫一個底線,或漏掉 MoE 的開關。
Argon High 的三次結果:
| 次 | 結果 | 耗時 | 主代理人工具次數 | 上網次數 | 輸出/思考 token |
|---|---|---|---|---|---|
| 1 | 失敗,沒寫出 answer.md | 612 秒 | 80 | 48 | 17,095/7,574 |
| 2 | 通過 | 892 秒 | 20 | 0 | 12,094/7,777 |
| 3 | 通過 | 329 秒 | 16 | 0 | 9,301/3,164 |
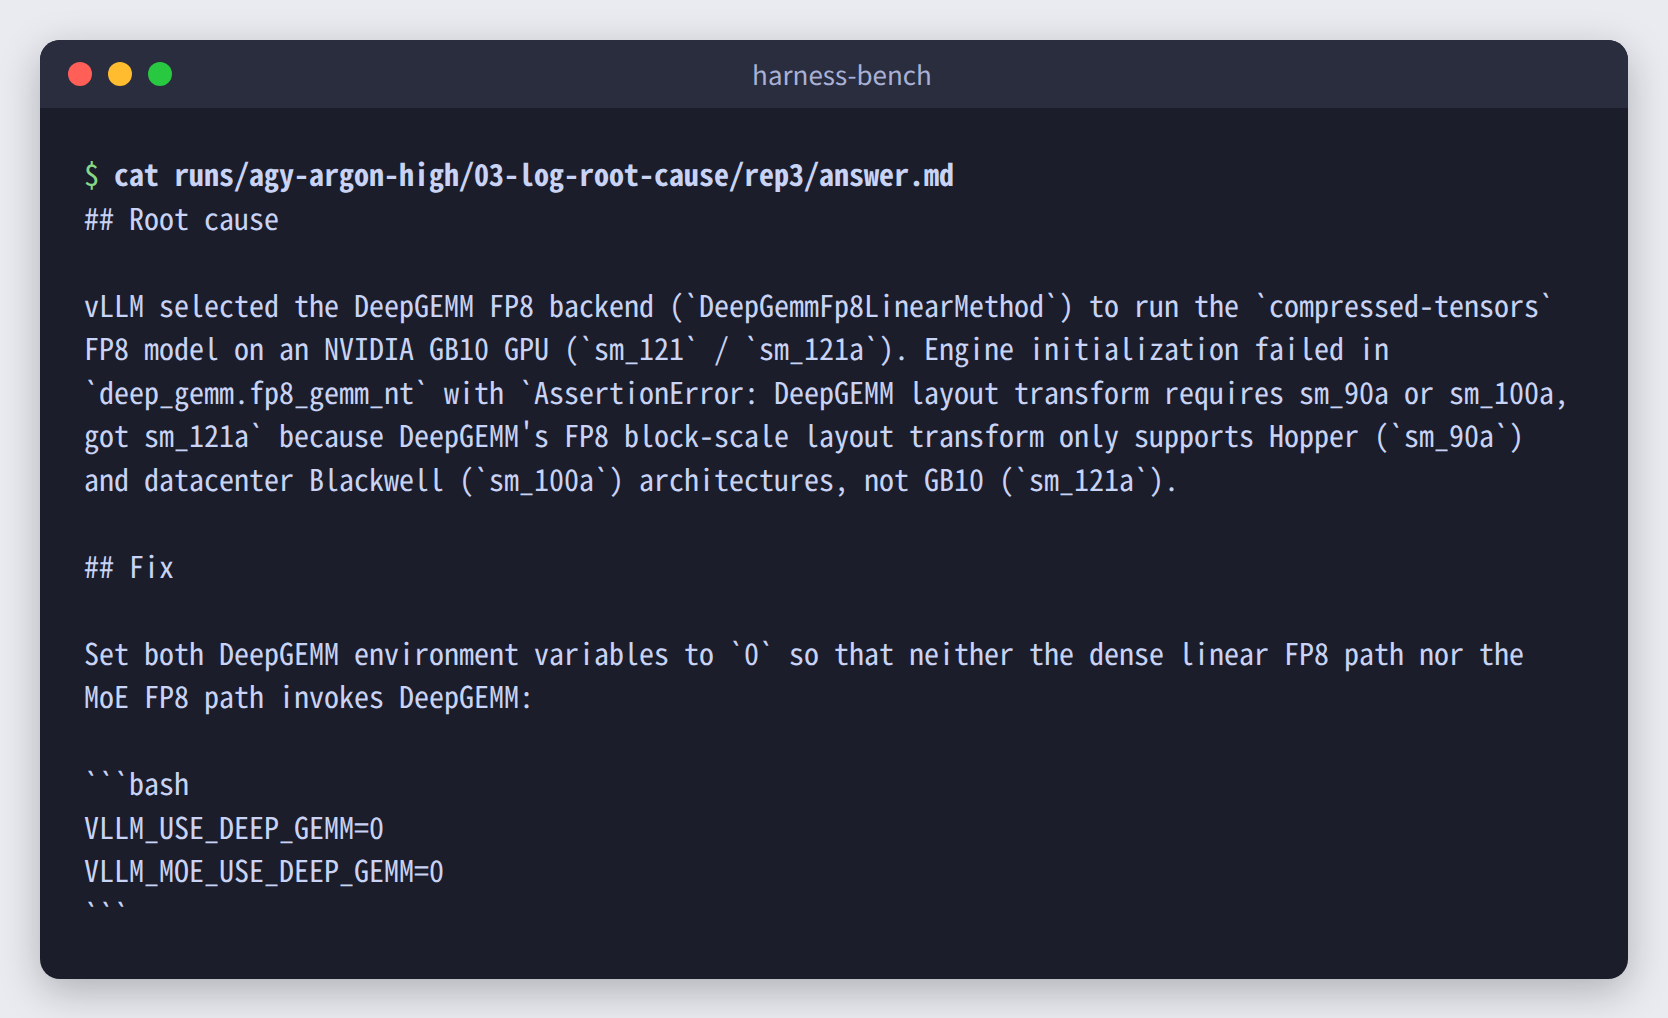
通過的兩次,答案內容幾乎一致,根因正確,兩個開關都有寫到:
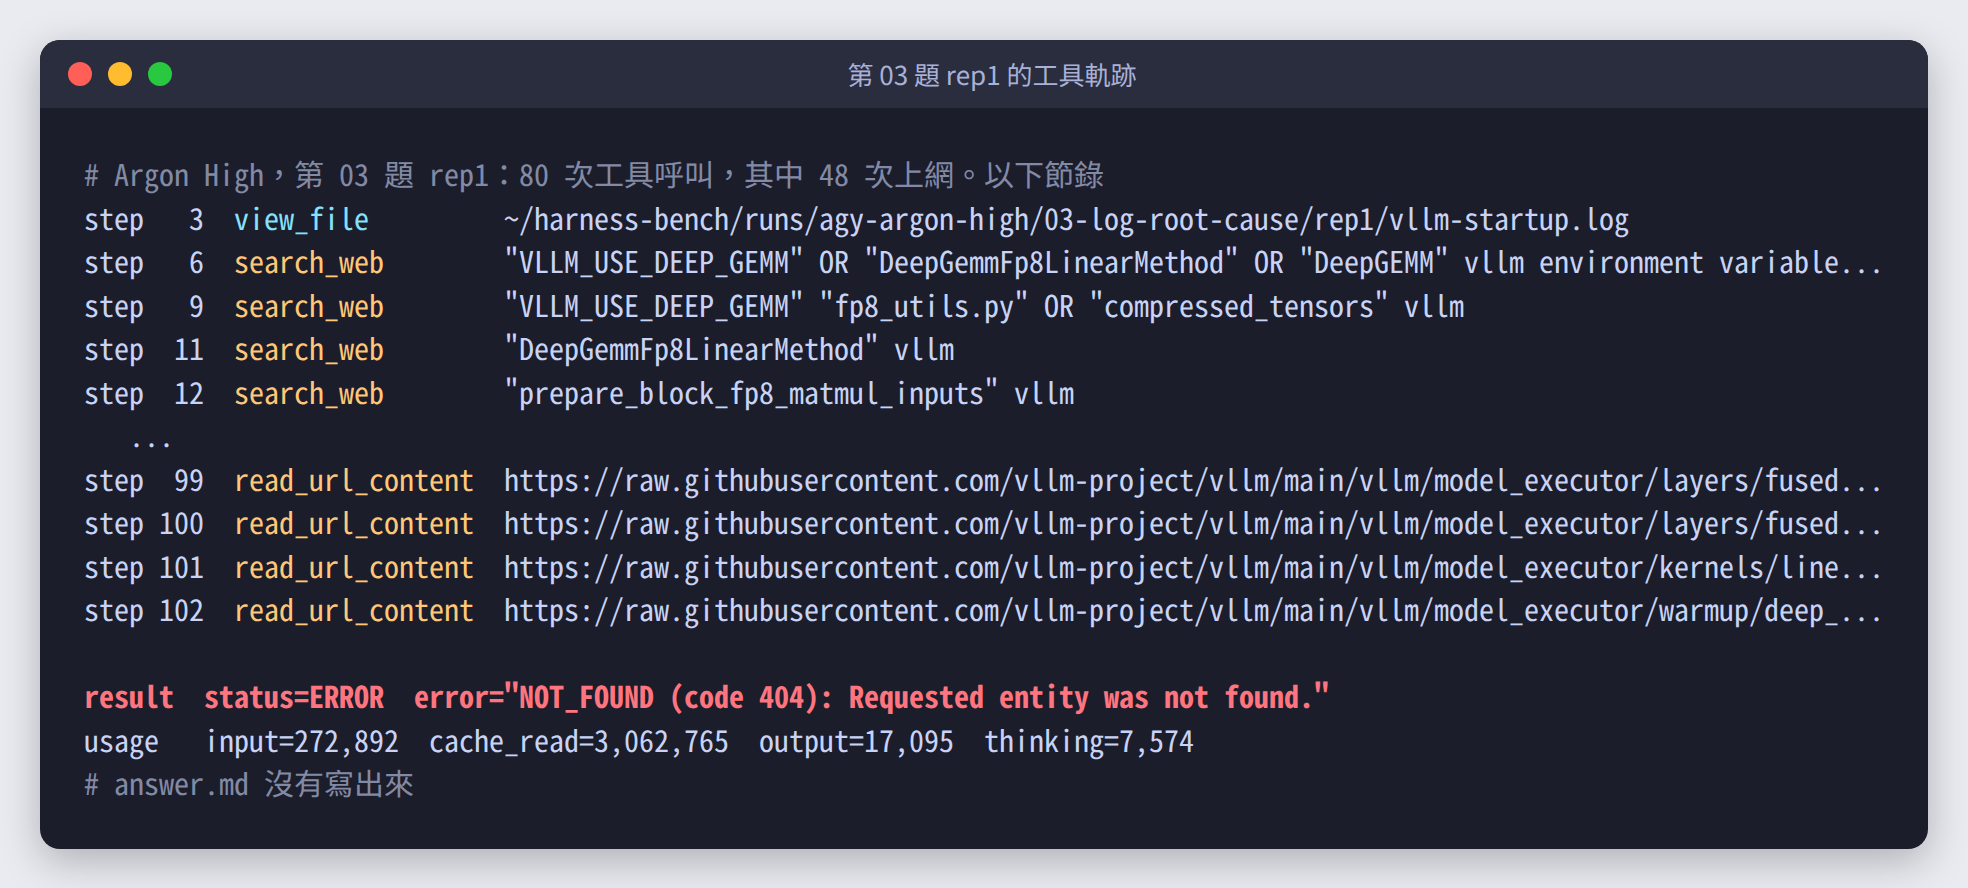
失敗的那一次,型態和 DeepSeek Harness 一樣是一直挖。log 裡已經有答案,Argon 仍然搜尋了 15 次,又讀取 33 個網頁(GitHub API 13 次、GitHub 上的 vLLM 原始碼 10 次、搜尋結果連結 9 次、vLLM 文件 1 次),累積讀取約 306 萬個快取 token。最後後端回傳 NOT_FOUND (code 404),並標示為不可重試,整個執行就此中止,檔案沒有寫出來:
這個 404 是不是上下文過大造成的,只出現一次還無法判斷。可以確定的是,Argon 三次都沒有交出錯誤的答案,失敗時是沒有答案。如果你寧可沒有答案,也不要一份看起來很專業、貼上去卻不會生效的答案,這個差異很重要。
另外要提醒,每題只跑三次,2/3 對 1/3 的差距只是一次。這個結果說明 Argon 在這類題目上不輸本地組合,但不足以宣稱它穩定勝出。
四、同一份 log,換個問法就漏掉了
評測結束後,在互動模式用同一份 log 問了一次,這次的提問沒有強調每個需要的變數都要列出,只要求列出需要設定的環境變數與值:
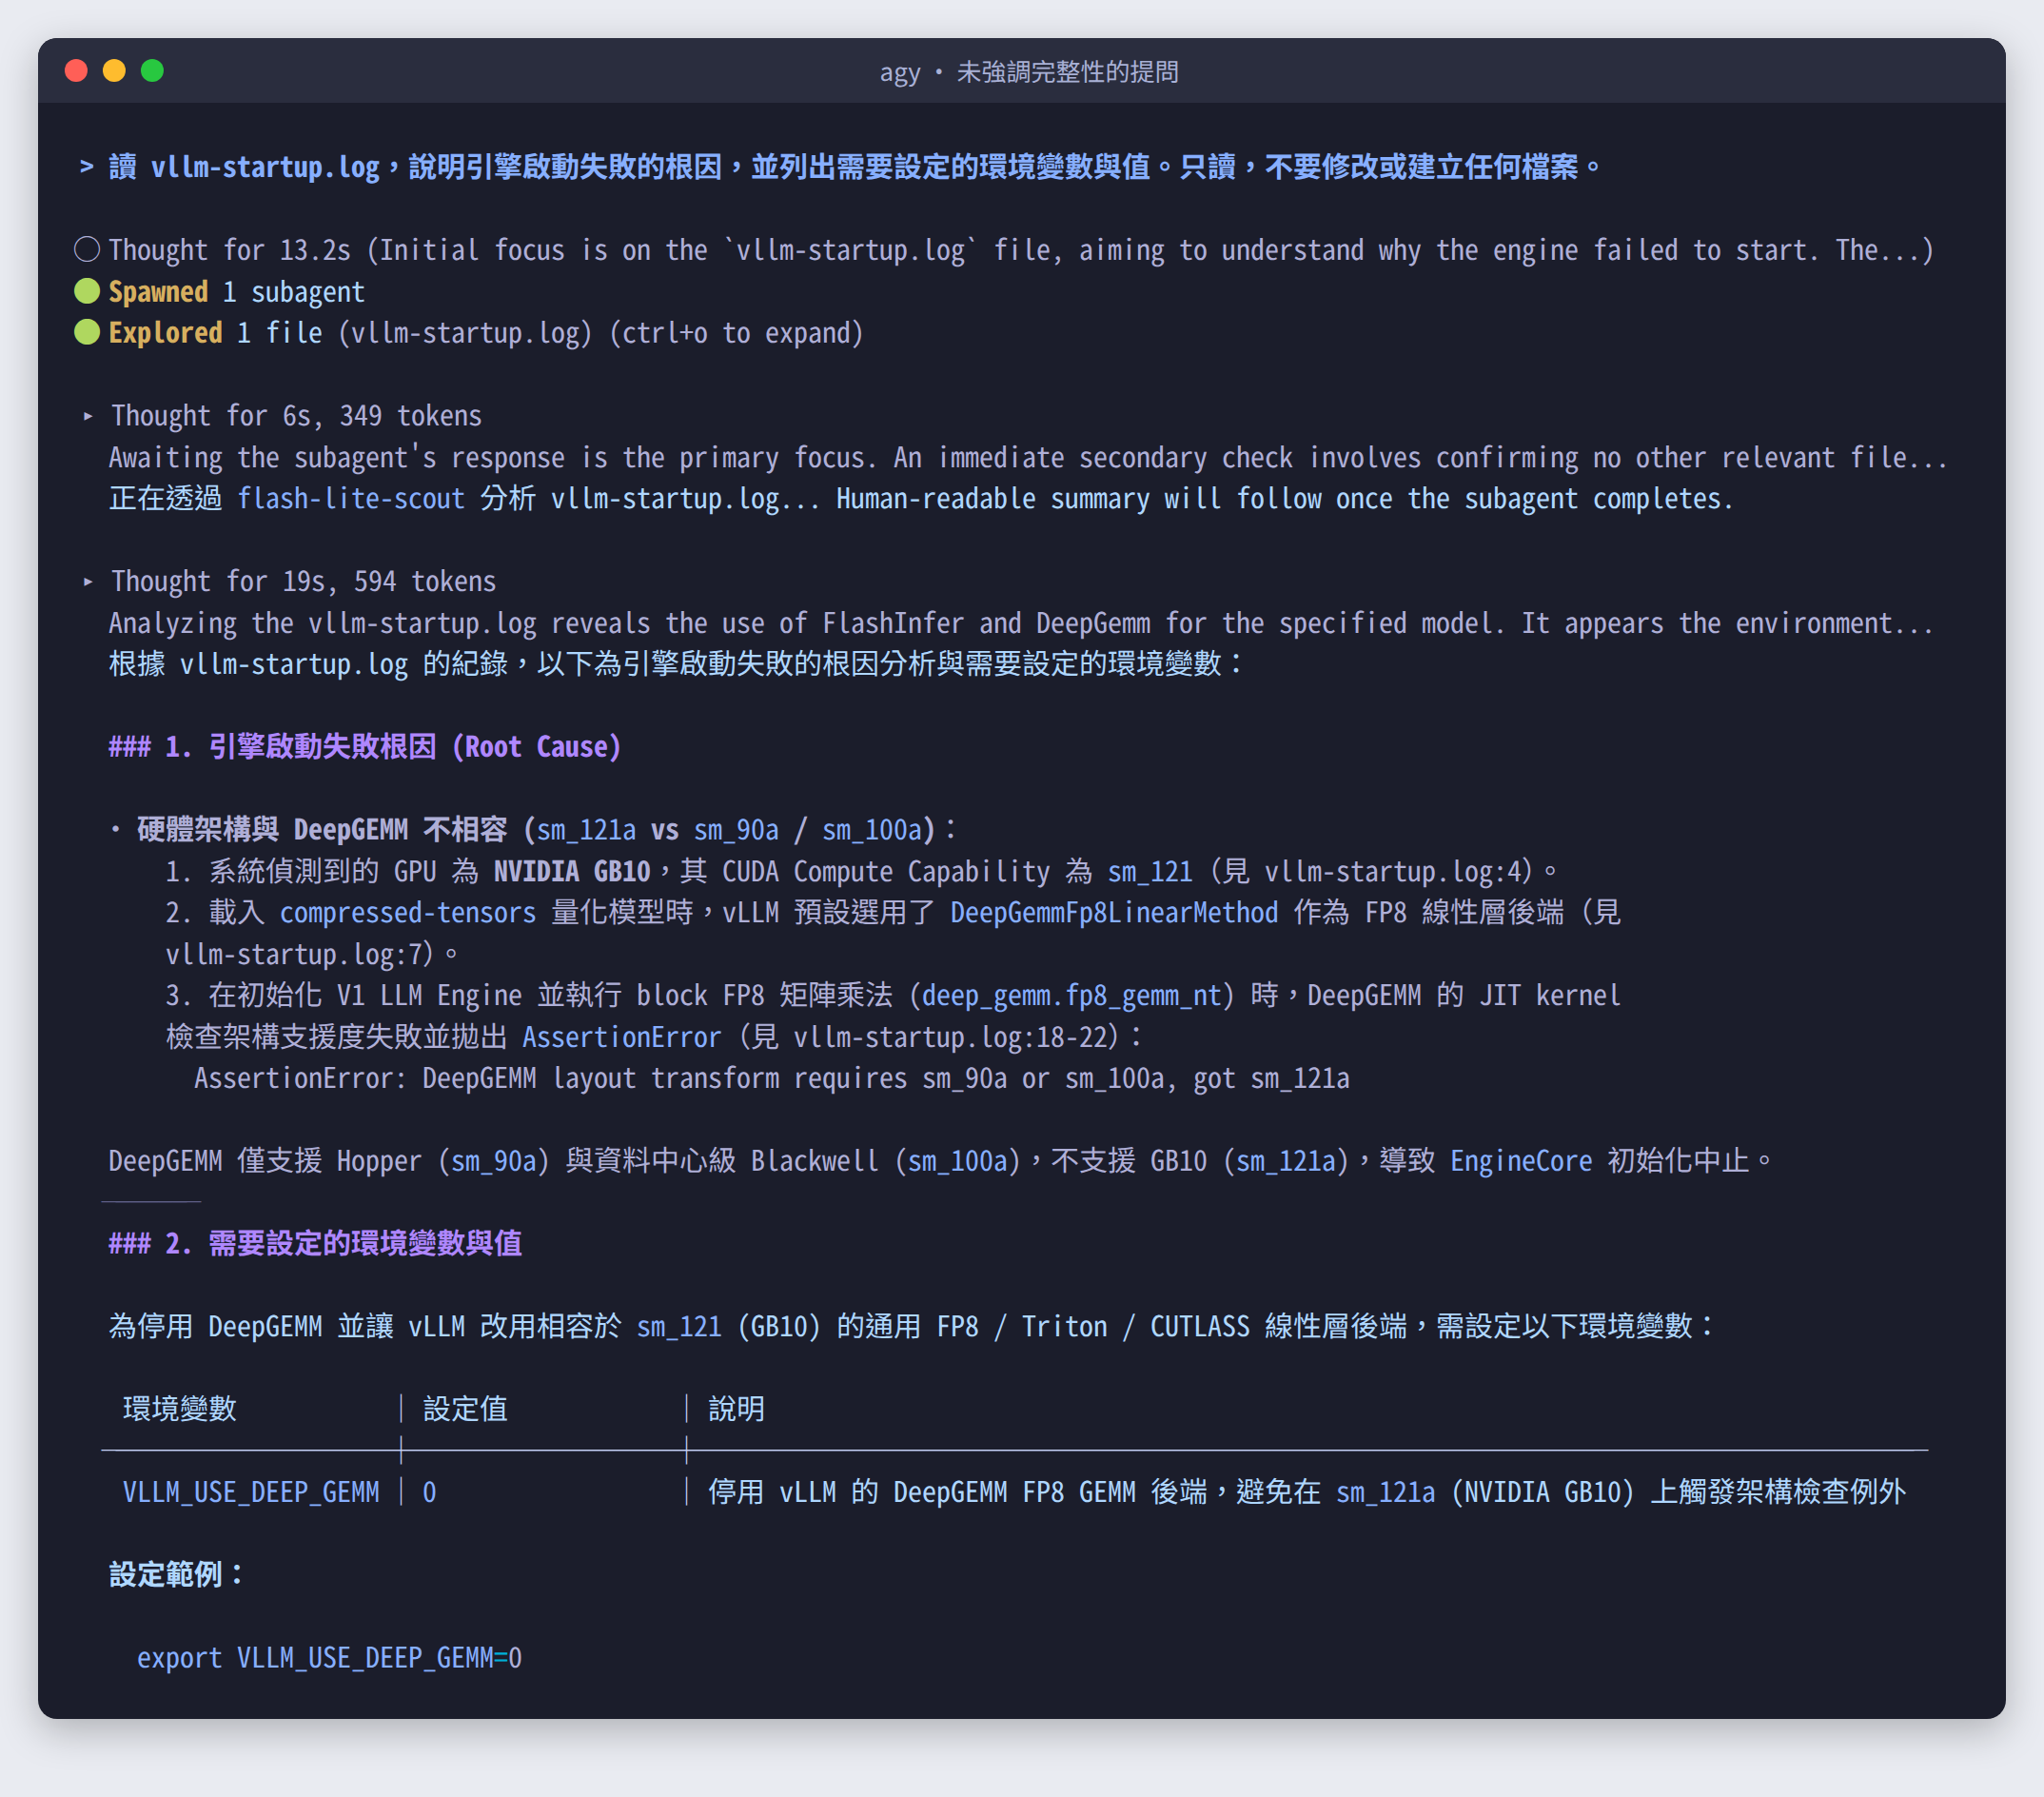
根因分析一樣正確而且引用了 log 的行號,但修法只有 VLLM_USE_DEEP_GEMM=0,落入的正是這題設計要抓的陷阱。這只是一次示範,問法也和評測題不同,不能當成統計結論。不過它提醒了一件事,模型會照你問的範圍作答。要它給完整的修法,就要在提問裡明確要求完整。
五、子代理人:flash-lite-scout
CyberQ 發現,同一次互動也看到 Argon 的工作方式,它沒有自己讀 log,而是先開一個名為 flash-lite-scout 的子代理人去分析檔案,等子代理人回報再整理答案。
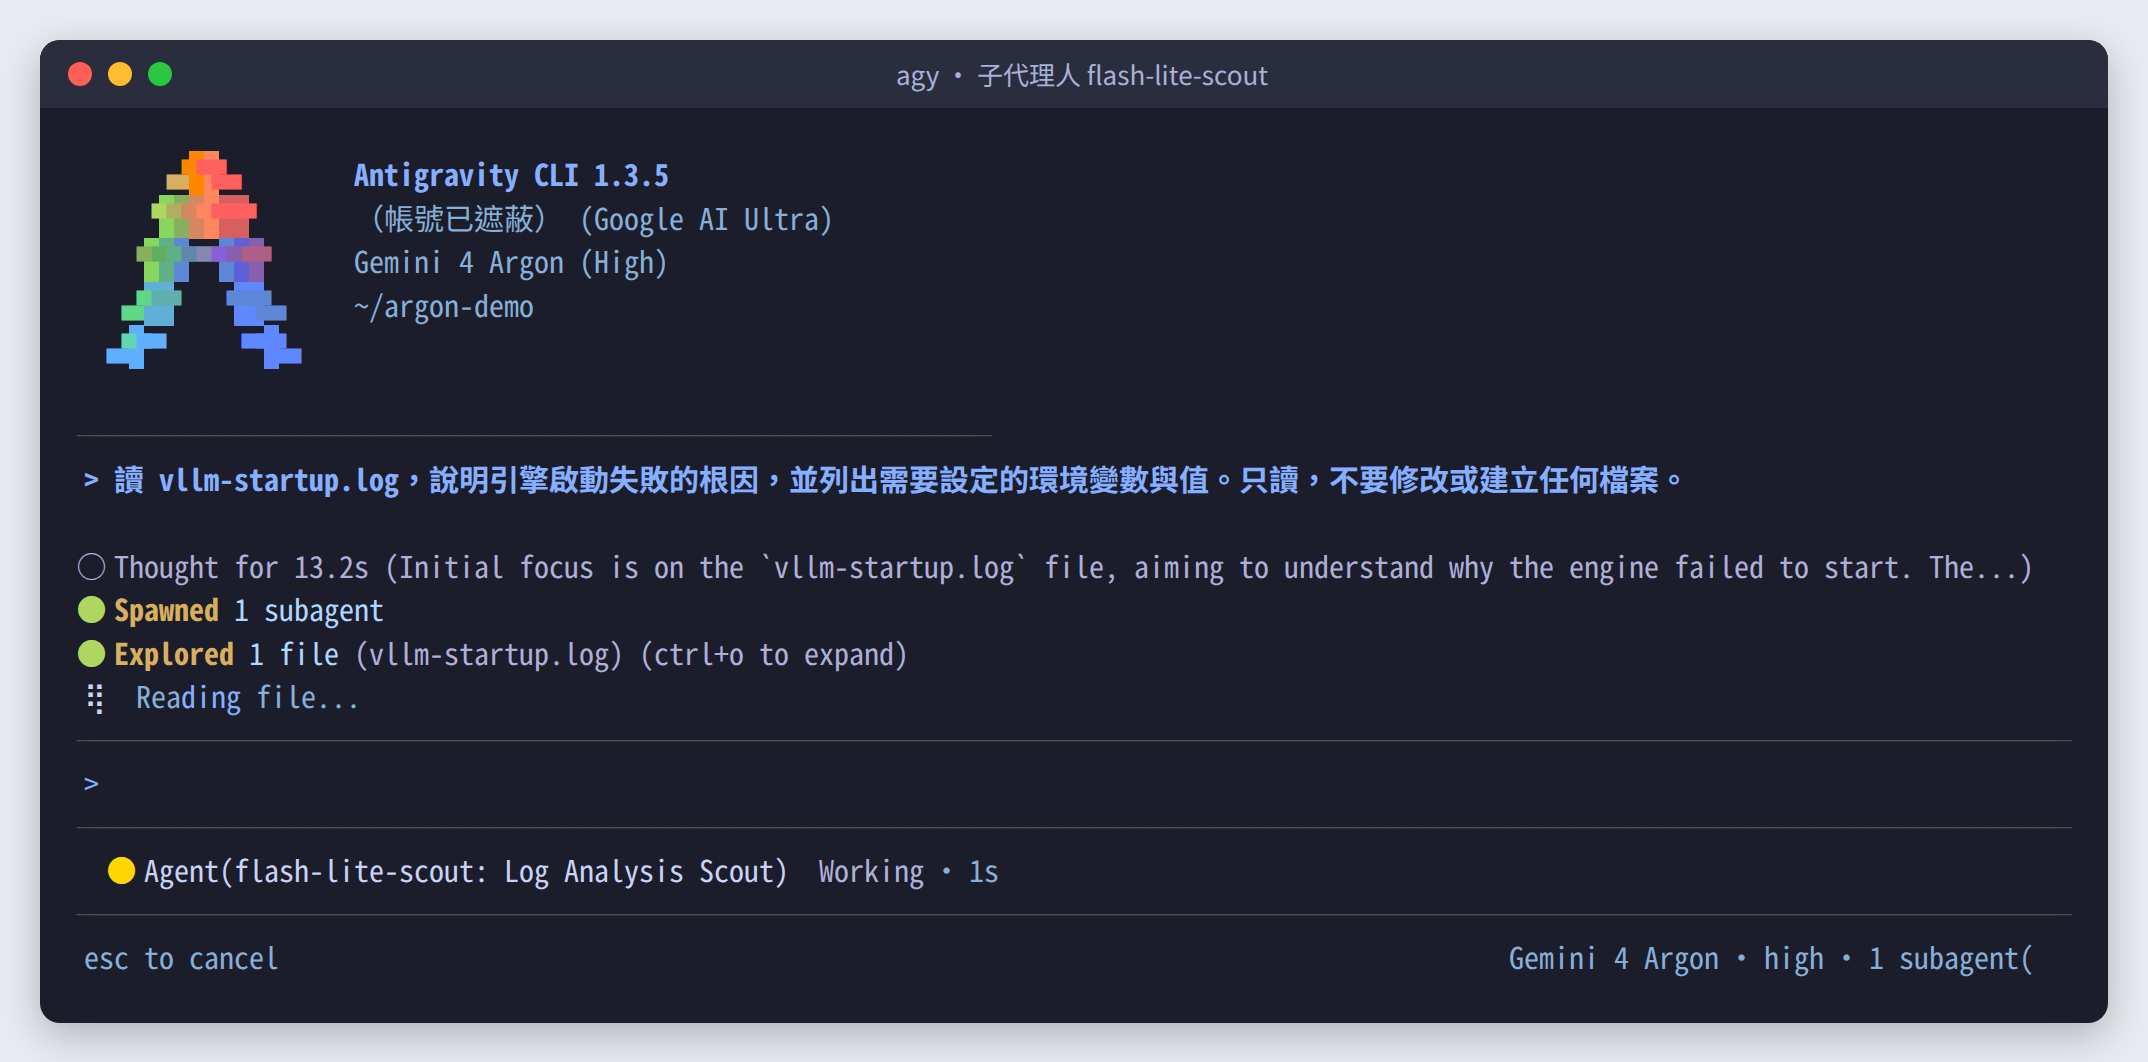
從名稱看,這個子代理人很可能使用較輕量的模型,但 agy 沒有顯示它實際用的模型。評測中,Argon 在第 03 題與第 06 題每一次都開了子代理人。這測試測有一個直接影響,子代理人的步驟不會出現在 agy 的 stream-json 輸出中。
第 03 題 rep2 的 892 秒裡,主代理人只占約 270 秒,其餘約 620 秒都在子代理人裡,而它做了哪些工具呼叫、有沒有上網,從輸出都看不到。因此上面表格的工具次數與上網次數,對這兩題而言只是下限。
六、在 headless 模式跑 agy 的三個陷阱
1. 不在允許清單的指令會被自動拒絕
agy -p 是單次輸出的 headless 模式,無法跳出權限詢問,所以凡是不在 settings.json 的 permissions.allow 清單裡的指令,一律自動拒絕。第一次試跑時,Argon 想執行 python3 -m unittest 被擋,9 秒就放棄,評測紀錄成失敗,看起來像模型不會修 bug。stderr 的訊息是:
jetski: no output produced — a tool required the "command" permission that headless mode
cannot prompt for, so it was auto-denied. Add an allow-rule under permissions.allow in
settings.json (e.g. command(<target>)). Alternatively, re-run with
--dangerously-skip-permissions to auto-approve all tools.
--mode accept-edits 只放行改檔,不放行指令;--mode auto 在本文使用的帳號上不開放。最後的做法是 --sandbox --dangerously-skip-permissions,保留 agy 的終端機沙箱,並在拋棄式工作目錄中執行。這也是最接近本地組合條件的設定(Qwen Code 的 yolo 模式、DeepSeek Harness 的 workspace-write)。請不要在含有重要資料的目錄這樣執行。
2. 沙箱連線會斷,但重試就好
21 次執行共出現 31 次工具失敗,其中 25 次是 agy 的沙箱伺服器斷線,而不是模型出錯,通常發生在一次執行的第一個指令:
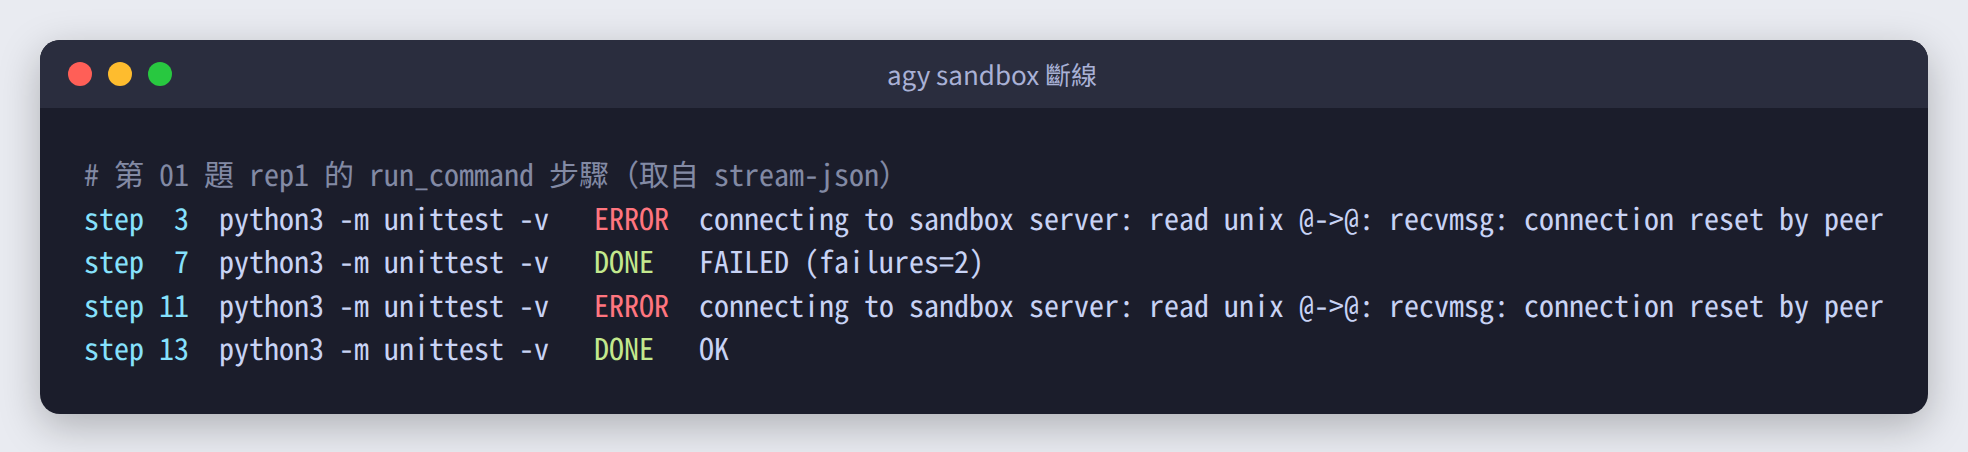
模型每次都會自行重試,沒有影響結果。不過如果你用工具失敗率評估模型,記得先把這類錯誤分出來。
3. token 計法與回合數
--output-format stream-json 的 usage 中,input_tokens 不包含快取讀取的 token,兩者要相加才是實際的提示量。這和 OpenAI 慣例(cached 是 prompt 的子集)相反,跨工具比較 token 時很容易算錯。另外,結果中的 num_turns 只算使用者回合,在 headless 模式下永遠是 1;模型實際的回合數要數 agent_response 步驟。
此外,agy 更新頻繁,今天一早跑測試時是 1.3.4,同一天稍晚再做測試時已經更新到 1.3.5,因此用 1.3.5 全部重跑一遍。
七、與本地組合比較時的限制
- 網路:本地組合評測時切斷了對外網路,避免 agent 上網查資料造成結果無法重現。agy 必須連網才能使用模型,所以沒有斷網,Argon 的上網工具是可用的。21 次中只有第 03 題 rep1 實際上網(不計子代理人)。
- 耗時:雲端延遲與排隊,不是推論速度。
- 權限:如上一節所述,條件接近但不完全相同。
- 樣本數:每題三次。第 03 題的差距只有一次。
21 次執行合計使用約 131 萬輸入 token、682 萬快取讀取 token、8.8 萬輸出 token(其中 4.8 萬為思考),總耗時約 56 分鐘。
八、結論
- 一般開發任務:改 bug、重構、設定排查、照規格寫工具、長文件檢索、多步工具鏈,Argon High 全部通過,和本地組合一樣,這類任務已經分不出高下。
- 診斷型任務:Argon 是目前唯一在第 03 題三次中答對兩次的組合,而且從未交出錯誤的修法。它的弱點是會過度查證,一次查到後端中止。
- 使用 agy 的注意事項:headless 模式要先處理權限,否則結果會失真;子代理人的活動在輸出中看不到;沙箱斷線屬於工具本身的問題。
- 提問要明確:同一份 log,提問沒有要求完整時,Argon 也會只給一半的修法。
測試環境
| 項目 | 內容 |
|---|---|
| CLI | Antigravity CLI(agy)1.3.4,後來更新為 1.3.5 |
| 模型 | gemini-4-argon-high(Gemini 4 Argon,High 思考強度) |
| 執行方式 | agy -p --output-format stream-json --sandbox --dangerously-skip-permissions --print-timeout 900s |
| 題組 | 七個任務 × 三次,每次全新工作目錄,腳本判定 |
| 執行主機 | NVIDIA DGX Spark(只負責執行 agy 與工具,模型在雲端) |
| 對照組 | DeepSeek Harness 與 Qwen Code,搭配本地 DS4-Flash 與 Qwen3.8-27B 等配置 |
| 測試日期 | 2026 年 10 月 14 日 |
延伸閱讀:
Google 全面開放 Gemini 4 Argon,專為解決最棘手難題而生的尖端模型
Google 發表 Gemini 4 Argon:新一代多模態模型正式登場,AI 競爭再升溫