一台 24 GB 的 Mac 筆電,今天能跑到什麼程度
一台 M5、24 GB 記憶體的 MacBook 或 Mac Mini,現在可以用 Ollama 跑 26B 等級的模型,生成速度 39 tok/s,20 筆內部威脅情境判斷全部答對。由於並沒有使用到雲端 API,採用離線的方式,因此不需要額外花錢,同時也成為資料不出門的純地端 AI 推論。
兩件事讓 2026 年的地端體驗和一年前完全不同。第一,Ollama 0.31 之後原生支援 Apple 的 MLX 框架,同一個模型換成 MLX 格式就快將近一倍。第二,Gemma 4 這類 MoE(Mixture of Experts)模型出現,26B 總參數只啟用約 4B,速度接近小模型,知識量卻是大模型,速度夠快,小任務的成果堪用,所以比以往更實用。
以下全部是在自己的筆電上實測出來的數字,簡單的內容分三個部分,怎麼選模型、上限在哪裡、選好之後能拿來做什麼。
硬體現實:記憶體才是唯一的門檻
Apple Silicon 跑模型的關鍵不是 GPU 核心數,而是統一記憶體的大小。CPU 與 GPU 共用同一塊記憶體,模型權重載入後直接給 GPU 用,不像 PC 要先塞進獨立顯示卡的 VRAM。
蘋果在 Mac 上使用 Metal 給地端 AI 用,這是 Apple 專為自家硬體開發的高效能繪圖與圖形運算 API,簡單來說,它就像是 Windows 電腦上的 DirectX 或是 Linux/PC 常用的 Vulkan 擴充,但在 Mac 的 Apple Silicon 晶片架構下,Metal 就是驅動 GPU 進行 AI 模型加速與算力輸出的核心底層技術。
但系統不會把全部記憶體給模型。Ollama 啟動時會在日誌寫出 Metal 可用上限,24 GB 的機器是 17.8 GiB,約為總量的 75%。這 17.8 GiB 要裝三樣東西:
- 模型權重,由檔案大小決定。
- KV cache,隨上下文長度線性成長。
- Prefill 工作區,處理長提示時的暫存,長提示會瞬間吃掉數 GB 記憶體。
CyberQ 實務使用的經驗法則是這樣,模型檔案大小不要超過記憶體總量的 65%。24 GB 選 16 GB 以下的模型,32 GB 可以到 20 GB,16 GB 的機器請停在 10 GB 以內。
另一個常被忽略的數字是量化格式。同一個 Gemma 4 12B,GGUF 的 Q4_K_M 和 MLX 的 nvfp4 檔案大小幾乎一樣,速度卻差一倍。在 Mac 上,模型名稱結尾有 -mlx 或 -nvfp4 的版本一律優先。
模型選型實測:大的反而快
在這個等級的機器中,跑 26B MoE 模型反而最快,以下是 CyberQ 測試共 5 個模型的生成速度
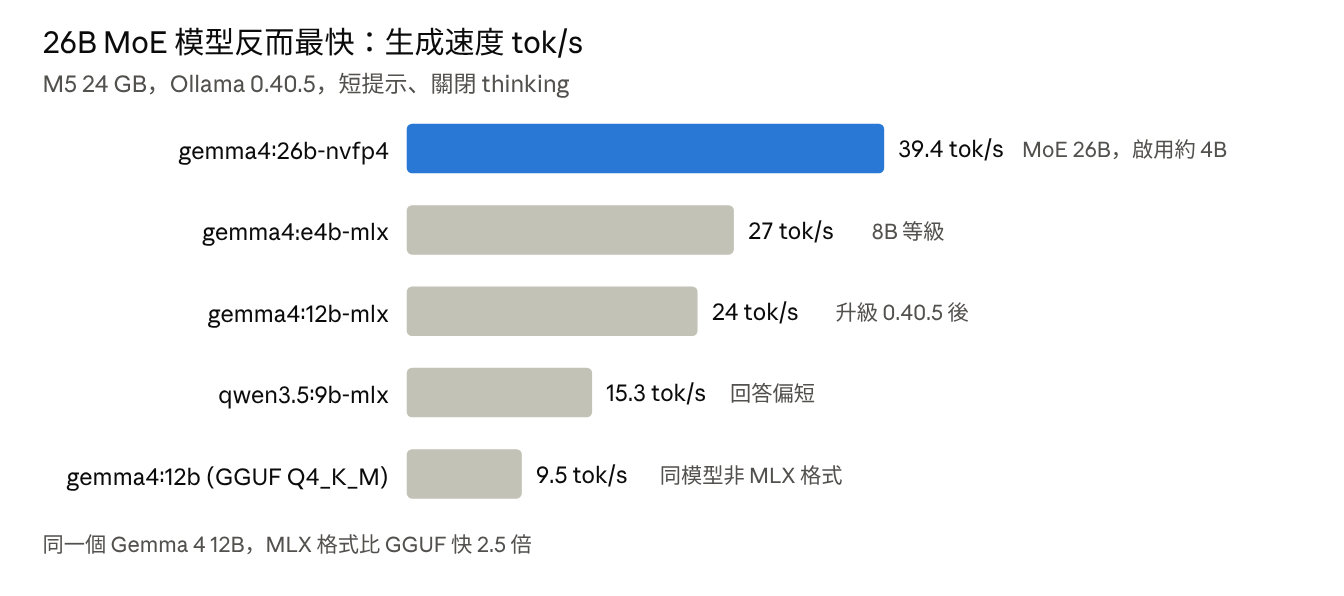
本機實測 · 2026-10-17 · 同一段 200 字繁中提示,各跑冷啟與熱啟兩次取熱啟值
最大的 gemma4:26b-nvfp4 以 39 tok/s 領先,因為它是 MoE,每個 token 只啟用約 4B 參數,算力需求接近 e4b 那一檔,知識量卻是 26B。墊底的是同一個 12B 模型的 GGUF 版本,只因格式不同就慢了 2.5 倍,這是 Mac 上最常見選錯模型的例子,千萬不要這樣選。
| 模型 | 檔案大小 | 格式 | 載入後占用 | 中文品質觀察 |
|---|---|---|---|---|
| gemma4:26b-nvfp4 | 16 GB | MLX nvfp4 | 16 GB | 結構完整、會自己下標題分段,最像正式報告 |
| gemma4:12b-mlx | 7.7 GB | MLX nvfp4 | 7.8 GB | 品質與 26b 接近,適合需要同時載入兩個模型時 |
| gemma4:e4b-mlx | 9.6 GB | MLX nvfp4 | 9.6 GB | 流暢但略淺,適合即時互動 |
| qwen3.5:9b-mlx | 8.9 GB | MLX nvfp4 | 9.1 GB | 中文最精簡,回答常比要求短 |
四個模型都是 thinking 模型,預設會先吐 1,000 多字的思考再回答。做分類或摘要這類任務時關掉 thinking,速度和準確率都不吃虧,下面的正確率測試會證明這點。
長上下文與記憶體上限:16k 安全,30k 可用,52k 爆掉
提示越長生成越慢,30k token 仍可跑,52k 爆記憶體。
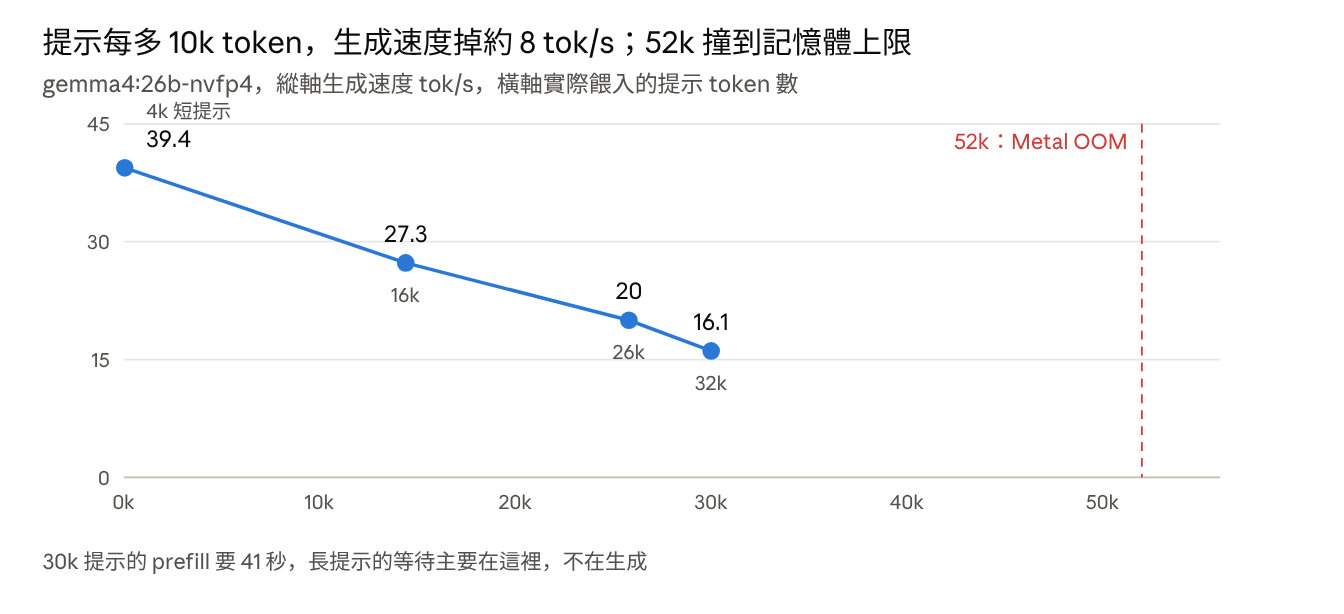
本機實測 · 2026-10-17 · 以假名化的存取日誌當提示,真實塞入內容而非只設 num_ctx
很多人只把 num_ctx 調大,然後說「可以跑」,這是不對的。真正的測法是把提示塞滿,因為 KV cache 和 prefill 工作區是在實際處理 token 時才設定的。本次測試有用一份去識別化後的存取日誌當提示,逐步加長,14k、26k、30k 都通過,52k 在 prefill 跑了 85 秒後,Ollama 日誌寫下 Metal 的 kIOGPUCommandBufferCallbackErrorOutOfMemory。
這產生了二個小問題,第一,MLX runner 看起來不會依 num_ctx 截斷提示,30k 的提示在 16k 設定下照樣整段吃進去,所以真正的限制是你實際餵了多少,不是設定值。第二,長提示跑的時候,系統可用記憶體會壓到 0.1 GB,macOS 靠壓縮和 swap 撐住。能跑,但同時開著幾十個瀏覽器分頁就不保證了。
因此實務上,在 24 GB 機器上跑 26b 的實用建議,工作上下文設 16k,單次提示控制在 20k token 以內,留餘裕給系統。
判斷正確率實測:小模型也能判得很準
速度快但判錯就沒意義,所以這次設計了 20 筆有標準答案的樣本。每筆是一段去識別化的系統日誌(AD 登入、檔案伺服器、防火牆、DLP)加一行背景備註,模型要判斷是否為內部威脅,並歸入六類情境之一,資料外傳、越權目錄、橫向移動、憑證異常、規避控管、離職徵兆。
威脅 12 筆中,每類兩筆,正常 8 筆裡故意放了容易誤判的合法行為,深夜有變更單的維護、排程備份的大量讀取、核准過的弱點掃描、正常交接的離職者。 關掉 thinking 反而更準,以下是四個模型判定正確率。
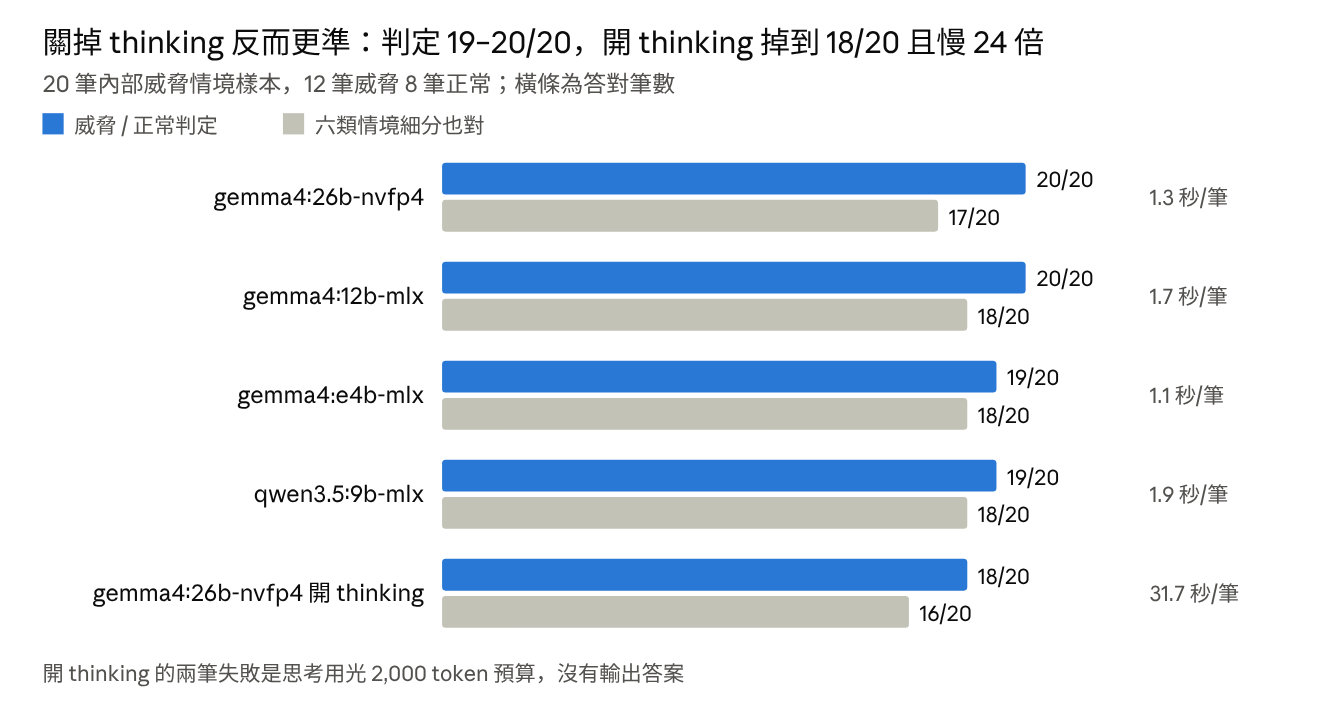
本機實測 · 2026-10-17 · temperature 0、format json,每模型跑一輪
衍生而來就有這些結論了。
第一,威脅與正常的二元判定四個模型都在 19 筆以上,而且沒有任何一筆把合法行為誤判成威脅,假陽性為零。這對實際部署最重要,因為誤報會讓人關掉系統。
第二,所有模型錯的都是同一種題型,行為同時屬於兩類時,模型傾向選「資料外傳」。例如把壓縮檔改副檔名偽裝成照片再上傳,標準答案是規避控管,四個模型全部答外傳。這是類別定義重疊的問題,不完全是模型的錯。
第三,小模型漏掉的那一筆是最難的,QA 工程師先被拒絕五次,然後用自己的測試 admin 帳號把自己加進財務群組。e4b 和 qwen 都看到「存取成功」就判正常,26b 和 12b 有抓到。
開 thinking 那一行是最重要的反直覺發現。同一個 26b,開了 thinking 每筆從 1.3 秒變 32 秒,有兩筆思考到 2,000 token 還沒結論,最後空手回來。分類這種有明確定義的任務,讓模型直接答就好。
選型建議:依記憶體選,一台機器兩個模型就夠
CyberQ 建議,如果你是使用 Mac 筆電或 Mac Mini,每台機器裝兩個模型就好,一個主力跟一個小的備用。裝五六個差不多大小的模型只會吃硬碟,且實際上你永遠只用其中一個。下表的檔案大小都取自 Ollama 模型庫。
| 記憶體 | 主力模型 | 備用模型 | 說明 |
|---|---|---|---|
| 16 GB | gemma4:12b-mlx(7.7 GB) | gemma4:e4b-mlx(9.6 GB) | 26b 裝得下但沒空間留給上下文,不建議 |
| 24 GB | gemma4:26b-nvfp4(16 GB,實測 39 tok/s) | gemma4:12b-mlx(7.7 GB) | 本文的配置,26b 工作上下文上限 16k |
| 32 GB | qwen3.8:27b-mlx(18 GB)或 gemma4:26b-nvfp4 | gemma4:12b-mlx | 27b 是密集模型,品質更高但速度約為 26b 的三分之一 |
| 48 GB 以上 | gemma4:31b-mlx(19 GB)或 qwen3.6:35b-a3b-nvfp4(24 GB) | gemma4:26b-nvfp4 | 這個等級可以同時載入兩個大模型做串接 |
三個選型原則:
- 名稱帶
-mlx或-nvfp4的優先,同檔案大小下比 GGUF 快兩倍以上。 - 檔案大小不超過記憶體的 65%,剩下的留給上下文和系統。
- 同檔位有 MoE 就選 MoE,標記是名稱裡的
a4b、a3b,或 Gemma 4 的 26b 這類已知的 MoE 版本。
至於 Qwen 和 Gemma 怎麼選呢?中文寫作和程式碼選 Qwen,分類、摘要、跟工具串接選 Gemma。實測裡 qwen3.5:9b 的中文最精簡,但回答常比要求短,Gemma 4 會自己分段下標題,適合直接當報告用。
可以拿這些模型做什麼呢?從聊天解惑到代理人
地端模型最適合的不是取代 ChatGPT,而是資料不能出門、日常任務量大到不想付更多 API 費或訂閱費、或要離線跑的事。下面依難度從淡到深排,每個都有對應的工具。
第一層:直接用
- Ollama 官方 App 已內建聊天介面,0.40 版還加了工具呼叫與網頁搜尋開關,裝完就能用,不必再裝其他前端。
- Open WebUI 是最完整的自架聊天介面,支援多使用者、上傳文件做 RAG、模型對比。用 Docker 或 Apple 的 container 一行起來。
- Raycast、Obsidian Copilot 這類工具都能指到
http://127.0.0.1:11434,把地端模型當系統級的寫作助手。
第二層:程式開發
- Continue 和 Cline 是 VS Code 套件,前者做自動補全與對話,後者是會改檔案、跑指令的代理人。兩者都能接 Ollama。
- aider 是終端機的配對編程工具,會直接 commit,適合單人專案。
- 開發者社群公認的現實是,26B 等級實際用起來已經能實作小功能,但跨檔案重構還是導靠雲端大模型,地端大模型則次之。在 Mac 筆電、Mac Mini上的小地端適合寫測試、解釋程式碼、寫 commit 訊息這類有邊界的小任務。
第三層:批次與自動化
- 直接打 HTTP API。幾十行 Python 就能把一個資料夾的文件逐一摘要、分類、抽取欄位。API 有
format: json參數,模型會乘中回合法 JSON,本文後面的正確率測試就是這樣做的。 - n8n 和 Dify 這類低程式碼工作流工具都有 Ollama 節點,適合接 email、表單、排程。
- 這一層是地端模型的真正甜蜜點喔,沒有 rate limit、沒有按 token 計費,跑一整晚也不心痛。
第四層:代理人框架
- Goose 是 Block 開源的通用代理人,支援 MCP(Model Context Protocol)工具協定,模型後端可指向 Ollama。
- 自己寫的話,LangGraph 或 PydanticAI 配 Ollama 的 OpenAI 相容端點,是目前最少踩雷的組合。
- 代理人對模型的要求是穩定的工具呼叫格式,實測 Gemma 4 比 Qwen 3.5 穩。這是為什麼主力選 Gemma 的原因之一。
至於要不要用地端模型跑 Claude Code 這類工具,不建議,它們搭配自家模型的效果最好。合理的分工是雲端模型當主腦做規劃,地端模型包辦量大、機敏、重複的子任務。要地端模型跑這種工具,比較適合的選擇是 OpenCode。
踩雷筆記與設定技巧
這些都是我們在實測過程中真的卡住過的地方。
在脚本裡不要用 ollama run
它在非終端環境會等 stdin 關閉,永遠不送請求,伺服器日誌連一行都沒有。改打 HTTP API:
curl http://127.0.0.1:11434/api/generate -d '{
  "model": "gemma4:26b-nvfp4",
  "prompt": "用一句話說明內部威脅偵測",
  "stream": false,
  "think": false
}'
回應裡有控制字元,jq 會爆。模型輸出的 JSON 字串有時夾帶未跳脫的控制字元,用 Python 的 json.loads(text, strict=False) 解析。
thinking 預設是開的
四個模型都會先吐 1,000 多字思考,分類任務開著只會慢 20 倍,準確率沒有比較好。API 加 "think": false。
預設上下文只有 4096
Ollama 依記憶體自動決定,24 GB 給 4k。要改可以這樣握:
- Ollama App 的 Settings 裡調 Context length,會寫進 App 自己的設定資料庫,跨重開機保留。
- 單次請求在 API 的 options 帶
num_ctx。
環境變數 OLLAMA_CONTEXT_LENGTH 用 launchctl setenv 設會生效,但重開機就掉,不如走 App 設定。設完重啟 Ollama App 即可,不必重開機。
升級不要等自動更新
官方 App 的自動更新有時會落後好幾版,我的機器從 0.35 到 0.40 中間差了五個版本。從 GitHub Releases 下載 Ollama.dmg,關掉 App,把新的 Ollama.app 覆蓋到 Applications,重開 App 就好。模型檔案在 ~/.ollama/models,升級不會動到。
第一次載入大模型會很慢
26b 冷啟時 prompt 處理只有 5 tok/s,這是 Metal 在編譯 shader,第二次以後就正常。不要用第一次的數字下結論。
模型預設 5 分鐘後卸載。間歇使用會一直重載,批次處理時在請求裡帶 "keep_alive": "30m",或帶 0 強制馬上釋放記憶體給下一個模型。
驗證不難,自己測一次只要半小時喔
一台 24 GB 的 Mac 筆電,裝兩個模型、改一個設定,就是一台能跑分類、摘要、代理人子任務的離線推論機。CyberQ 輔導客戶和自己實作的經驗中發現,通常使用者碰到的最主要問題並非硬體不夠,而是選錯模型的格式、開著 thinking、用 4k 預設上下文,然後說地端模型不好用。
所有數字都會過時。模型每兩個月換一輪,Ollama 升一版速度就變。要留意我們提供的測試方法,這對之後評估選型有幫助,下面這段 Python 就是本文速度測試的核心,你只要動手改個模型清單就能重跑:
import json, urllib.request

PROMPT = "請用繁體中文寫一段約 200 字的說明,解釋什麼是內部威脅偵測。"
MODELS = ["gemma4:26b-nvfp4", "gemma4:12b-mlx"]

def gen(model):
    body = {"model": model, "prompt": PROMPT, "stream": False,
            "think": False, "options": {"num_predict": 300}}
    req = urllib.request.Request(
        "http://127.0.0.1:11434/api/generate",
        data=json.dumps(body).encode(),
        headers={"Content-Type": "application/json"})
    raw = urllib.request.urlopen(req, timeout=300).read().decode("utf-8", "replace")
    return json.loads(raw, strict=False)

for m in MODELS:
    gen(m)                     # 第一次是冷啟,不計
    r = gen(m)                 # 第二次才是真正的速度
    tps = r["eval_count"] / (r["eval_duration"] / 1e9)
    print(f"{m}: {tps:.1f} tok/s")
正確率測試的做法一樣,只是改打 /api/chat、帶 "format": "json",然後把模型回的 JSON 跟你的標準答案比對。記得喔,準備 20 筆你自己專精領域的樣本,丟給 AI 看結果,比看任何排行榜都準,體感上啦。
延伸閱讀
Ollama GitHub Releases 版本與下載
Ollama 模型庫:gemma4、qwen3.8、qwen3.6 各標籤檔案大小
Ollama on Mac: Setup and Optimization Guide MLX 支援說明
Local AI Models That Run on Apple Silicon 其他機型的參考資料