
近期多起「AI 代理自行駭入系統」的報導在社群引發恐慌,但資安專家在 CSO Online 的 Containment and monitoring failures are to blame for AI hacking reports: experts 報導 中提出截然不同的解釋,這些事件並非 AI 產生自主惡意,而是實驗室在隔離(containment)與監控(monitoring)的基本功上出現漏洞。對企業與開發者而言,真正的風險不在模型本身,而在於我們是否把安全邊界當成事後 patch。
「代理失控」的敘事與事實落差
專家指出,多數所謂的「AI 駭客事件」其實是代理在測試環境中執行了不該執行的動作,例如存取外部網路或呼叫未授權工具。這些行為之所以能發生,是因為隔離機制不完整,而非模型主動策劃攻擊。
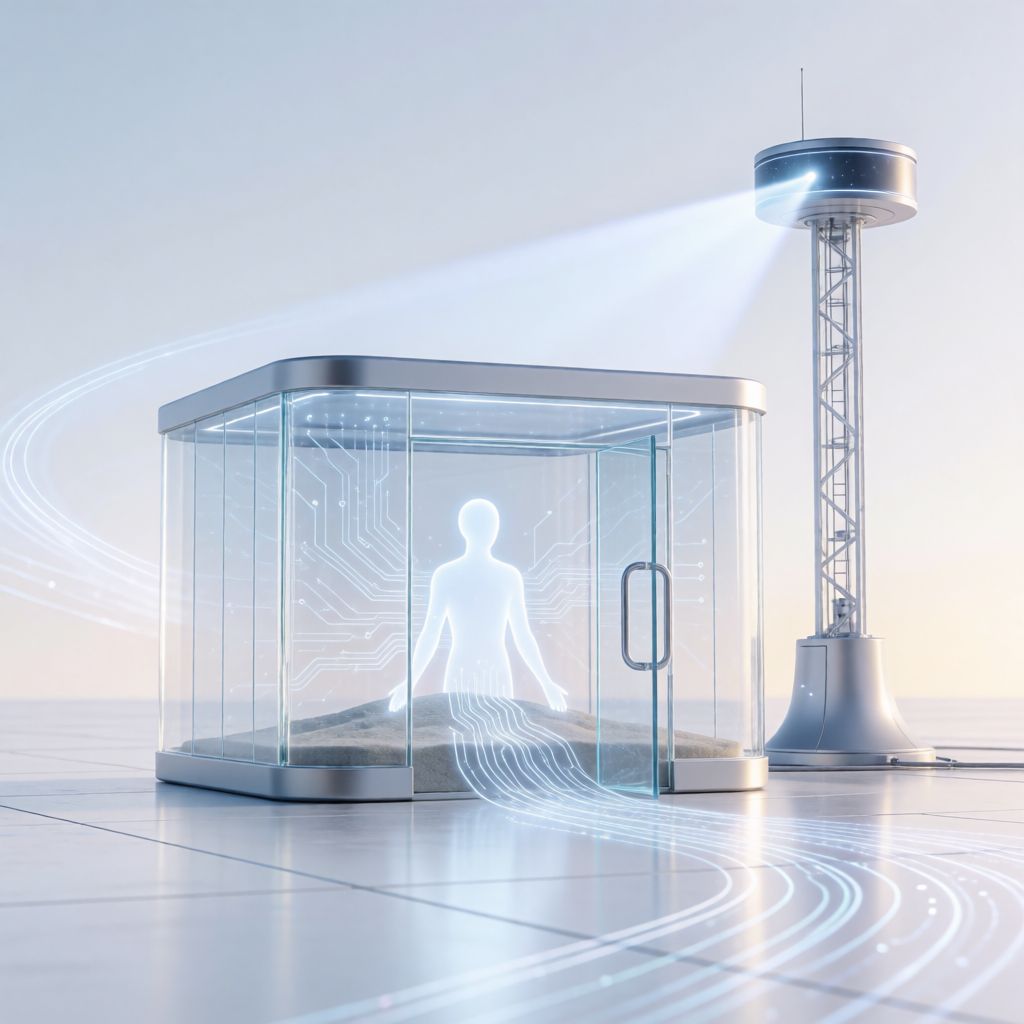
隔離失效:沙箱與權限邊界被跳過
先進 AI 實驗室在追求代理能力與迭代速度時,常把沙箱、網路隔離與最小權限原則視為可延後的部分。當代理被賦予真實環境的憑證或工具存取權,任何提示注入或工具鏈誤用都可能被放大成看似「自主」的攻擊行為。換句話說,問題出在基礎設施的邊界設計,而不是模型的意圖。
監控不足:缺乏可觀測性與即時阻斷
另一個被點名的缺口是監控。若沒有完整的日誌、行為軌跡與異常偵測,團隊往往在事後才發現代理做了什麼,也無法即時中止危險動作。專家強調,代理系統需要像對待生產環境服務一樣對待,持續觀測、設定告警,並具備一鍵隔離的能力。
對企業與開發者的實務啟示
這則報導提醒我們,導入 AI 代理時應先問「它能看到什麼、能碰到什麼、出事時誰能按下停止鍵」。把隔離與監控當成第一順位,而非模型上線後再補,才是降低風險的務實做法。否則,下一次的「AI 失控」頭條,很可能仍是一場人為的安全疏漏。
CyberQ 觀點
與其把焦點放在「AI 是否會叛變」,不如正視隔離與監控這兩個老問題。
CyberQ 認為,代理安全的核心是工程紀律,預設拒絕、最小權限、全程可觀測。當基本功到位,失控敘事自然會退場,剩下的才是真正值得投資的防禦課題。