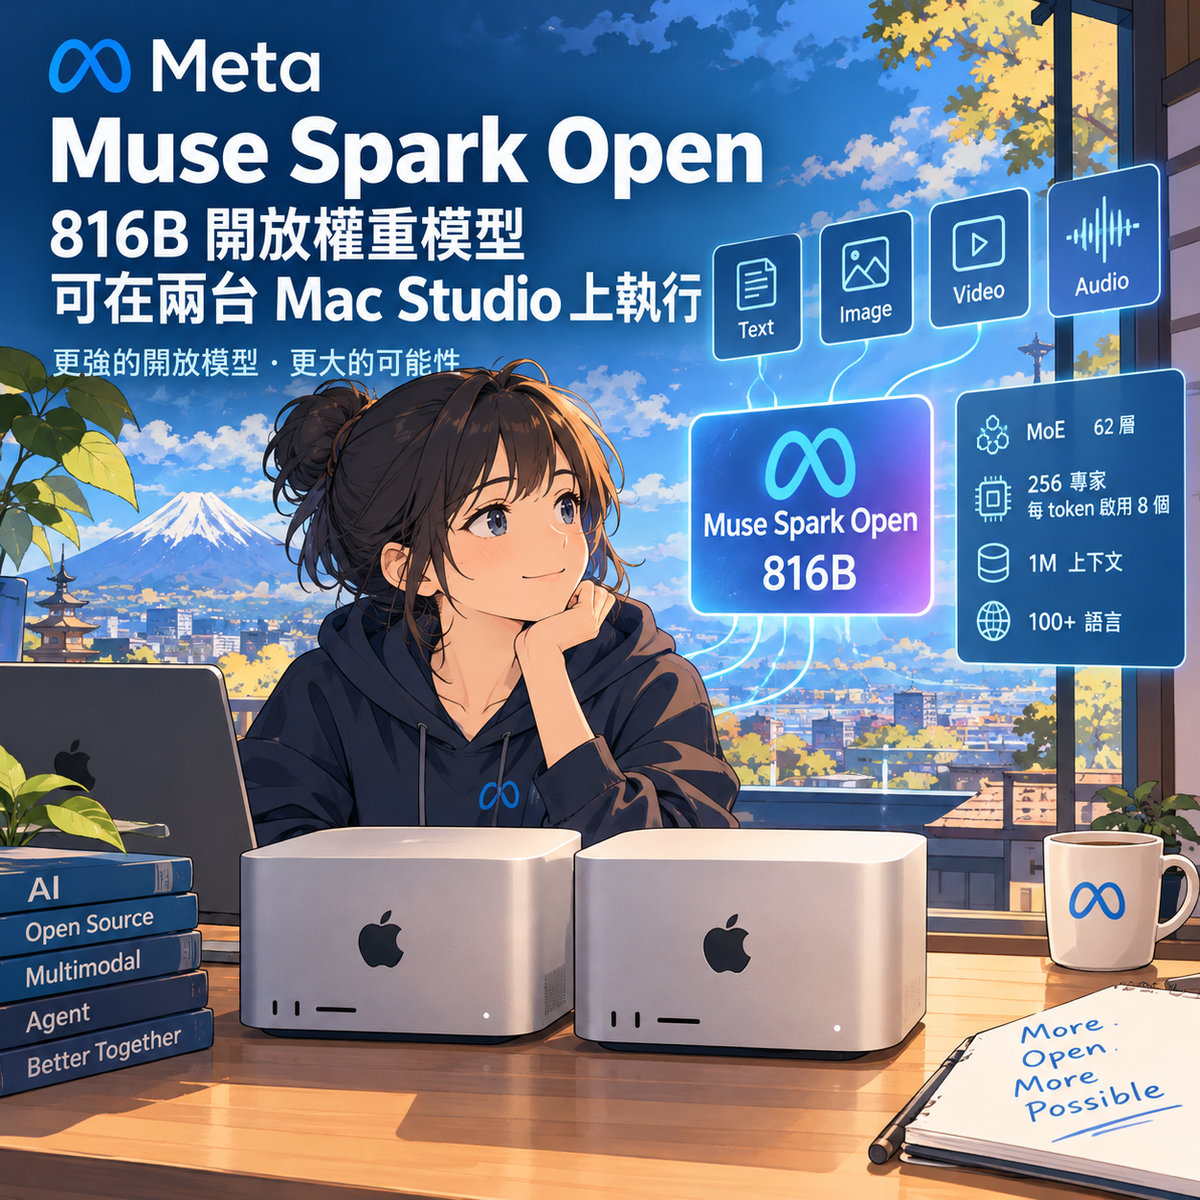
Meta Superintelligence Labs 發表了 Muse Spark Open,並宣稱這是目前美國最強的開放權重模型。這是一個 816B 總參數、每個 token 啟用 42B 參數的混合專家(MoE)模型,支援 100 萬 token 上下文與文字、影像、影片、音訊輸入,權重已上架 Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden 與 Microsoft Foundry Models。
這次發布有三個值得注意的面向。第一,Meta 在 Llama 之後重新回到開放權重路線,直接與 Kimi K3、GLM 5.3、Qwen3.8 等中國實驗室的大型開放模型競爭。第二,Meta 與 Apple 合作,宣稱兩台搭載 M5 Ultra 的 Mac Studio 即可在桌面上執行完整模型。第三,模型附帶額外的安全後訓練,並公開了越獄拒絕率與代理任務風險評測,對評估自建推論環境的企業資安團隊而言,是少見的可查驗資料。
CyberQ 根據 Meta 官方公告、Hugging Face 模型卡與評測方法報告整理,並進行實測。
模型規格與架構
Muse Spark Open 的核心是一個 62 層、256 個專家、每個 token 路由至 8 個專家的 MoE Transformer,另外搭配一個 1.8B 參數的 Perception Encoder 負責視覺輸入。Hugging Face 的技術說明指出,全部 256 個專家都必須常駐記憶體,因此佈署時需要 816B 模型的記憶體容量,但推論速度接近 42B 模型。
| 項目 | 規格 |
|---|---|
| 總參數 / 啟用參數 | 816B / 42B |
| 架構 | MoE Transformer + Perception Encoder |
| 層數 | 62 |
| 專家數 / 每 token 啟用 | 256 / 8(top-k 路由) |
| 隱藏維度 | 8192 |
| 注意力 | GQA,128 個 Q head、16 個 KV head,head 維度 64,啟用 QK-norm 與輸出閘控 |
| 詞彙量 | 202,048 |
| 上下文長度 | 1M token(推論) |
| 輸入 / 輸出模態 | 文字、影像、影片、音訊 / 文字 |
| 語言 | 訓練資料涵蓋 100 種以上語言 |
| Perception Encoder | 1.8B 參數,50 層,14×14 patch,4096 輸出維度,稀疏注意力 |
| 權重格式 | BF16(約 822 GB)、NVFP4(約 484 GB) |
| 推理強度 | low / medium / high / xhigh,預設 xhigh |
以上規格引自 Hugging Face 模型卡,檢查點容量數字引自 AlphaSignal 報導,待查官方確認。
模型卡列出的適用場景包括多步推理、端對端代理任務、程式開發代理、工具呼叫、多模態推理、合成資料生成與 LLM-as-a-judge 評估。Meta 建議在複雜推理、程式開發與代理任務使用 high 或 xhigh 推理強度,取樣參數為 temperature 1.0、top_p 1.0、停用 top_k。
命名方面,義大利科技媒體 Pasquale Pillitteri 指出,PyTorch 部落格的對應文章標題為「Muse Spark 1.2 Is Now Open Weights」,文中說明此模型與 Muse Spark 1.3 共用同一基礎模型,而 Meta 於 10 月 12 日發表的 Muse Wonder 並未開放權重。
效能評測,領先美國同業但與中國模型互有勝負
Meta 在模型卡中將 Muse Spark Open 與 Inkling、Nemotron 3 Ultra、Beam、Mistral Large 4、Qwen3.8-2.4T-A95B、GLM 5.3、Kimi K3 等開放權重模型並列比較。以下摘錄代理、推理、程式開發與多模態四類的主要項目,數據引自 Hugging Face 模型卡,各項目的來源與評測設定見 Meta 的評測方法報告。
| 評測項目 | Muse Spark Open | Inkling | Qwen3.8-2.4T | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|---|
| AA Intelligence Index | 39 | 26 | 40 | 45 | 44 |
| JobBench | 61.8 | 31.1 | 52.7 | 61.4 | 54.3 |
| MCP-Atlas | 89.2 | 76.0 | 84.5 | 84.2 | 82.3 |
| OSWorld Verified | 80.4 | 40.1 | 未測 | 未測 | 84.8 |
| Toolathlon Verified | 72.8 | 45.5 | 72.5 | 73.0 | 76.5 |
| HLE-Diamond(無工具) | 26.1 | 11.2 | 17.3 | 16.4 | 22.2 |
| AA Omniscience | 25 | 2 | 4 | 14 | 20 |
| GPQA Diamond | 89.0 | 87.2 | 93.5 | 91.7 | 93.5 |
| DeepSWE 1.1 | 60 | 未報 | 57 | 67 | 68 |
| Terminal-Bench 2.1 | 76.4 | 55.1 | 82.0 | 83.9 | 85.0 |
| ZeroBench(含工具) | 50.0 | 14.0 | 未測 | 未測 | 41.0 |
| VideoMMEv2 | 61.5 | 36.9 | 未測 | 未測 | 65.4 |
CyberQ 從這些資料解讀,Muse Spark Open 在 JobBench、MCP-Atlas、HLE-Diamond、AA Omniscience、ZeroBench 等項目取得同組最高分,在工具呼叫與事實可靠度方面表現突出。AA Omniscience 特別值得注意,該指標以答對數減去答錯數計算,棄答優於自信錯答,Muse Spark Open 的 25 分遠高於 Inkling 的 2 分與 Qwen3.8 的 4 分,代表幻覺控制較佳。
在純程式開發項目則落後中國模型。Terminal-Bench 2.1 的 76.4 分低於 Kimi K3 的 85.0 與 GLM 5.3 的 83.9,DeepSWE 1.1 的 60 分也低於兩者。GPQA Diamond 的 89.0 分同樣不及 Qwen3.8 與 Kimi K3 的 93.5。Meta 自己在整體智慧指數上也只有 39 分,低於 GLM 5.3 的 45 與 Kimi K3 的 44。
因此「美國最強開放權重模型」的說法成立,但「全球最強」則不然。The New Stack 的評價是依評測項目不同,與最佳中國模型互有勝負。AlphaSignal 則提醒,獨立評測尚未驗證 Meta 的宣稱。
評測方法報告有幾點需要留意。第三方模型數據混合了官方排行榜、Artificial Analysis、各廠商自報與 Meta 內部執行,Meta 也承認其代理工具與系統提示並未針對第三方模型調校。Beam 與 Mistral Large 4 因權重未廣泛釋出,僅引用自報數字。多模態項目只與 Inkling 和 Kimi K3 比較,因為其他模型不支援原生多模態輸入。
兩台 M5 Ultra Mac Studio 在桌面執行 816B 模型
Meta 宣稱 Muse Spark Open 是同級模型中第一個能在桌面執行的,條件是兩台搭載 M5 Ultra 的 Mac Studio,搭配最新版 MLX 框架。Meta 官方公告說明其技術基礎為 Apple 的統一記憶體架構,M5 Ultra 的整合式 GPU 每台可使用至多 512 GB 記憶體,兩台合計約 1 TB,足以容納整個模型。1.2 TB/s 的記憶體頻寬則足以讀取每個 token 所需的 42B 啟用參數。
Meta 展示了幾個完全在本機執行的代理工作流程,使用 Muse Code 搭配 Muse Spark Open。其一是對開源 Mastodon 用戶端 Ice Cubes 提交真實的 iOS 修改,包含錯誤修正、新功能與完整建置。其二是端對端操作 DaVinci Resolve,由模型逐格檢視影片素材,找出最佳片段並裁切為直式影片。
The New Stack 引述 Meta 方面在 X 上的貼文,指此成果來自與 Apple 的 John Ternus 合作(發文者待查),The New Stack 以「你買不起的 Mac」為題描述這個配置。VentureBeat 指出模型卡列出的最低需求為 NVFP4 版本 700 GB 加速器記憶體、BF16 版本 2 TB,兩台 512 GB 的 Mac Studio 剛好跨過 NVFP4 的門檻。
取得與佈署管道
Muse Spark Open 自 10 月 15 日起可透過多種管道取得,不需申請即可呼叫 API,自行下載權重則需在 Hugging Face 填寫法定姓名、出生日期與完整組織名稱並接受授權條款。
| 管道 | 內容 |
|---|---|
| 權重下載 | Hugging Face、Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Models |
| 託管 API | Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI |
| 推論引擎 | SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、Apple MLX、llama.cpp、Unsloth |
| 硬體最佳化 | AMD、Apple、Intel、NVIDIA |
| 微調 | PyTorch TorchTitan |
| 最低 GPU 記憶體 | NVFP4 版本 700 GB,BF16 版本 2 TB |
Meta 在 開發者文件 提供了 SGLang 與 vLLM 的啟動範例,兩者都使用 muse 推理解析器與工具呼叫解析器,並可搭配投機解碼草稿模型(SGLang 用 RadixArk/Muse-Spark-Open-DFlash2,vLLM 用 Inferact/Muse-Spark-Open-DSpark,設定 7 個投機 token)。Meta 同時為 SGLang 提供可自動調校的 Helion GPU 核心,宣稱在 NVIDIA 與 AMD GPU 上取得 1.03 至 3.95 倍的核心層級加速,在 AMD MI350 上有 3% 的端對端加速。
社群量化版本已經出現。explainx.ai 列出 ggml-org 發布的 GGUF Q2_K 量化版可用 llama.cpp 載入,Hugging Face 模型卡顯示截至 10 月 16 日已有 10 個量化版本與 1 個微調版本。模型卡亦註明量化推論在邊緣案例可能有輕微品質差異。
對台灣多數企業與個人開發者而言,700 GB 的記憶體門檻仍是實際障礙。以 NVIDIA DGX Spark 的 128 GB 統一記憶體計算,即使以雙機叢集也無法載入 NVFP4 版本,更低位元的社群量化版是否能在 256 GB 環境執行且維持可用品質,待實測。
授權條款,開放權重但非開源
Muse Spark Open 採用 Meta 自訂的 Muse Model License,並非 OSI 認可的開源授權。Hugging Face 模型頁面公開的條款允許免費使用、複製、修改、微調、蒸餾、合併、發布與銷售,但附帶三項主要條件。
- 所有副本與衍生模型必須附上版權聲明、授權條款與使用政策。
- 任何使用本模型或衍生模型的產品、服務、文件、網站或設定選單,必須明顯標示「Built with Muse Spark Open」。衍生模型的定義涵蓋以本模型或其輸出所訓練、微調、蒸餾或改良的任何 AI 模型。
- 若授權人及其關係企業對外以 API 或類似介面提供模型即服務(Model as a Service),且連續 12 個月總營收超過 2,000 萬美元,必須通知 Meta 並另行簽訂書面協議。內部使用、研究、非模型即服務的商業活動,以及將模型作為自家產品功能元件,均不受此限。
Meta 聲明不主張模型輸出的所有權。附件的使用政策列出禁止用途,包括軍事、武器、ITAR 管制項目、關鍵基礎設施操作、惡意程式製作、冒充他人、未揭露 AI 生成內容等,並明定模型不適用於 18 歲以下使用者。
與 Llama 授權相比,這份條款的營收門檻從月活躍用戶數改為年營收 2,000 萬美元,且只針對模型即服務業務。The New Stack 評論指出,與部分新的中國模型相同,權重開放但授權並未同步開放。對台灣企業而言,最需要留意的是第 2 條的標示義務,內部工具或對客戶提供的服務只要用到此模型或其蒸餾版本,介面或文件上都必須標示。
安全與資安面向,額外安全後訓練的實際效果
Muse Spark Open 與託管版 Muse Spark 的最大差異在於額外的安全後訓練。Meta 的理由是開放權重模型會在沒有系統層防護的情況下被單獨使用,因此必須強化模型本身的抗濫用能力。模型卡公開了四類安全評估結果,對資安團隊而言是評估自建推論環境風險的第一手資料。
| 評估類別 | 內容 | 結果 |
|---|---|---|
| 內容安全 | 有害內容生成與拒絕行為、回應品質、意識形態平衡 | 符合發布標準 |
| 代理風險 | 使用工具或代替使用者行動時的有害或未授權行為,包括不安全程式執行與程式開發代理的破壞性變更 | 符合發布標準 |
| 隱私 | 個人與敏感資訊的處理,包括代理行動中的不當揭露 | 符合發布標準 |
| 準備度(Preparedness) | 依 Meta Superintelligence Scaling Framework 評估化學生物、網路、失控三類風險 | 達到框架要求的發布門檻 |
網路安全項目的數字最值得關注。Meta 以自適應攻擊者模擬開發者直接呼叫 API 的方式,在沒有任何系統層防護的條件下測試,模型在內部評測拒絕了 99.2% 的越獄嘗試,在 PolyGuard 網路子集、RedCode 與 CyberBench 2024 的彙整結果為 94.8%。相同條件下 Kimi K3 分別只有 75.5% 與 70.2%。
化學生物項目在 SecureBio 的 BioTIER 拒絕評測超過 98%,內部單輪化學評測超過 99%,多輪代理評測的生物與化學拒絕率分別超過 97% 與 98%。失控風險方面,MASK 誠實度評測為 98.1%,Agentic Misalignment 評測的不當行為率為 0%。
模型卡的比較表還有兩個通用安全指標。FORTRESS 對抗評測的平均風險分數(ARS)為 5.8,遠低於 Kimi K3 的 26.7 與 GLM 5.3 的 28.2,但過度拒絕分數(ORS)為 17.4,高於 Kimi K3 的 2.7 與 GLM 5.3 的 3.2,代表安全強化的代價是對正常請求的誤拒率上升。StrongREJECT v2 自適應攻擊成功率為 0.5%,其他模型介於 62.9% 至 86.4%。
對企業導入的實務建議,模型卡本身已有明確指引,整理如下。
- 不要將模型單獨暴露給終端使用者,應佈署於有護欄的 AI 系統之中,並針對使用情境調整。
- 在代理場景中,對不可逆操作加入人工確認。
- 面向使用者的應用應避免暴露原始思考鏈,對推理摘要施加安全檢查。
- 保護內部的 assistant 訊息不受使用者操控,並對越獄與對抗輸入採用多層防護。
- Meta 明確表示,下游修改(包括微調與量化)可能削弱安全性,發布版本的評測結果不應套用至修改後的模型。
最後一點對台灣企業特別重要。許多自建推論環境會為了節省記憶體而使用社群量化版本,或為了符合內部術語而進行微調,這些版本都不在 Meta 的安全評測涵蓋範圍內,企業必須自行補做紅隊測試。
CyberQ 觀點
Muse Spark Open 的意義在於美國實驗室重新加入大型開放權重模型的競爭,讓企業在 DeepSeek、Qwen、GLM、Kimi 之外多了一個來源國不同的選項。對於供應鏈或資料來源有地緣政治考量的台灣企業,特別是受 ITGC 或金融監理規範的組織,這個差異可能比幾分的評測差距更具決策意義。
但從自建推論的角度,816B 的規模讓這個模型與多數台灣企業的現有硬體有相當距離。700 GB 的 NVFP4 門檻遠超過單一 GPU 伺服器的常見配置,需要多張資料中心等級 GPU,或 Meta 所示範的兩台頂規 Mac Studio。依 CyberQ 的觀察,中國實驗室近期釋出的開放模型通常同時提供多種中小型號,Meta 這次只釋出單一規格,這是尚未補上的缺口。
安全評測資料是這次發布最值得肯定的部分。Meta 公開了在無系統護欄條件下的越獄拒絕率,並直接與競爭模型對比,這是過去開放權重模型少見的透明度。不過 17.4% 的過度拒絕率也提醒資安團隊,在選型時必須將誤拒對業務流程的影響與攻擊成功率一併衡量。
CyberQ 後續將關注三件事。第一,社群量化版本在 256 GB 等級硬體上的實際可用性。第二,M5 Ultra Mac Studio 雙機配置的實測吞吐量與台灣供貨狀況。第三,獨立評測機構對 Meta 宣稱數字的驗證結果。
延伸閱讀
Introducing Muse Spark Open, The Most Capable US Open‑Weight Model to Date,Meta AI Research,2026-10-15
Muse Spark Open Model Card,Hugging Face,含 Muse Model License 全文
Muse Spark Open Evaluation Methodology,Meta,2026-10
Build with Muse Spark Open,Meta 開發者文件
Welcome Muse Spark Open,Hugging Face Blog