QNAP 在地端搜尋工具 Qsirch 7.0 上加入了 AI RAG 搜尋(Beta),方便用戶能用自然語言提問,從 NAS 中已經索引的文件找出員工需要的檔案和摘要來。Qsirch 會先從 NAS 上已建立索引的文件找出相關段落,再交給大型語言模型整理成答案,並附上來源檔案。模型可以用 NAS 本機的 LLM Core,也可以接任何 OpenAI 相容的 API。
這次在 TVS-h877AX 上把兩種接法都設定起來,用同一組可以逐字查核答案的文件與題目,比較準確度、速度與幻覺。CyberQ 實測,同語言的問題,本機 8B 模型(DeepSeek R1 8B)就能全部答對。真正的瓶頸則在檢索,尤其是跨語言。另外,12 GB 顯示卡在 Qsirch 上只能用 12B 以下的模型。
測試環境
| 項目 | 內容 |
|---|---|
| NAS | TVS-h877AX,AMD Ryzen 5 7645,16 GB RAM,QuTS hero h6.0.2 |
| 顯示卡 | NVIDIA 顯示卡,12 GB VRAM,設為 Container Station 模式 |
| Qsirch | 7.0.3.2 |
| LLM Core | 1.0.2(本機模型:Mistral 7B Q4_0、DeepSeek R1 8B Q4_K_M) |
| QNAP AI Core | 3.8.1(物件索引用) |
| 外部模型 | 區網內另一台 AI 伺服器以 vLLM 提供的 DeepSeek-V4.1-Flash,經 OpenAI 相容 API 連接 |
| 嵌入模型 | Multilingual E5 Small(Qsirch 內建,本機執行),對照組為 Gemini Embedding 001(雲端) |
進階索引:OCR、顏色與物件
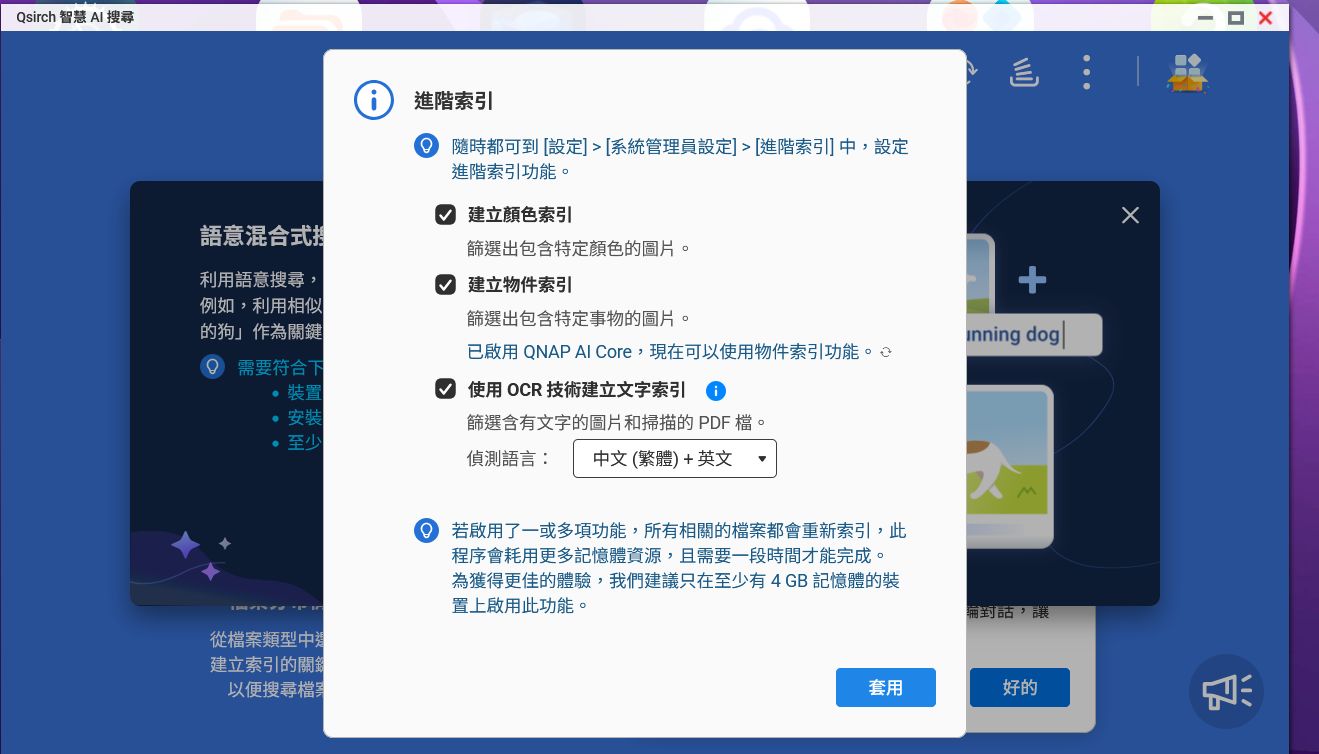
第一次開啟 Qsirch 會詢問是否啟用進階索引。顏色索引與 OCR 可以直接勾選,OCR 的偵測語言可選「中文(繁體)+英文」。物件索引則需要另外安裝 QNAP AI Core,沒裝時會顯示紅字提示。
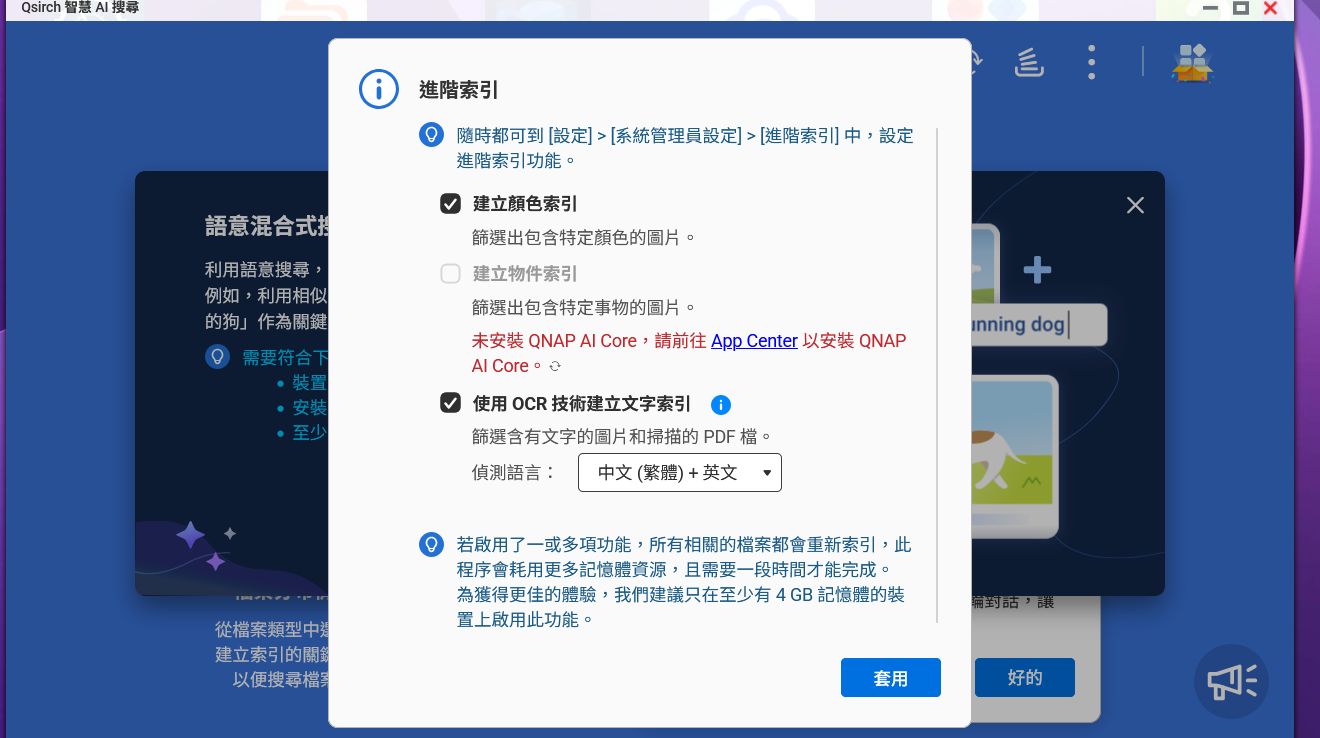
從 App Center 裝好 QNAP AI Core 之後,物件索引就可以勾選。官方建議這些功能在 4 GB 以上記憶體的機器才啟用,因為啟用後所有相關檔案都會重新索引。
RAG 搜尋的設定入口
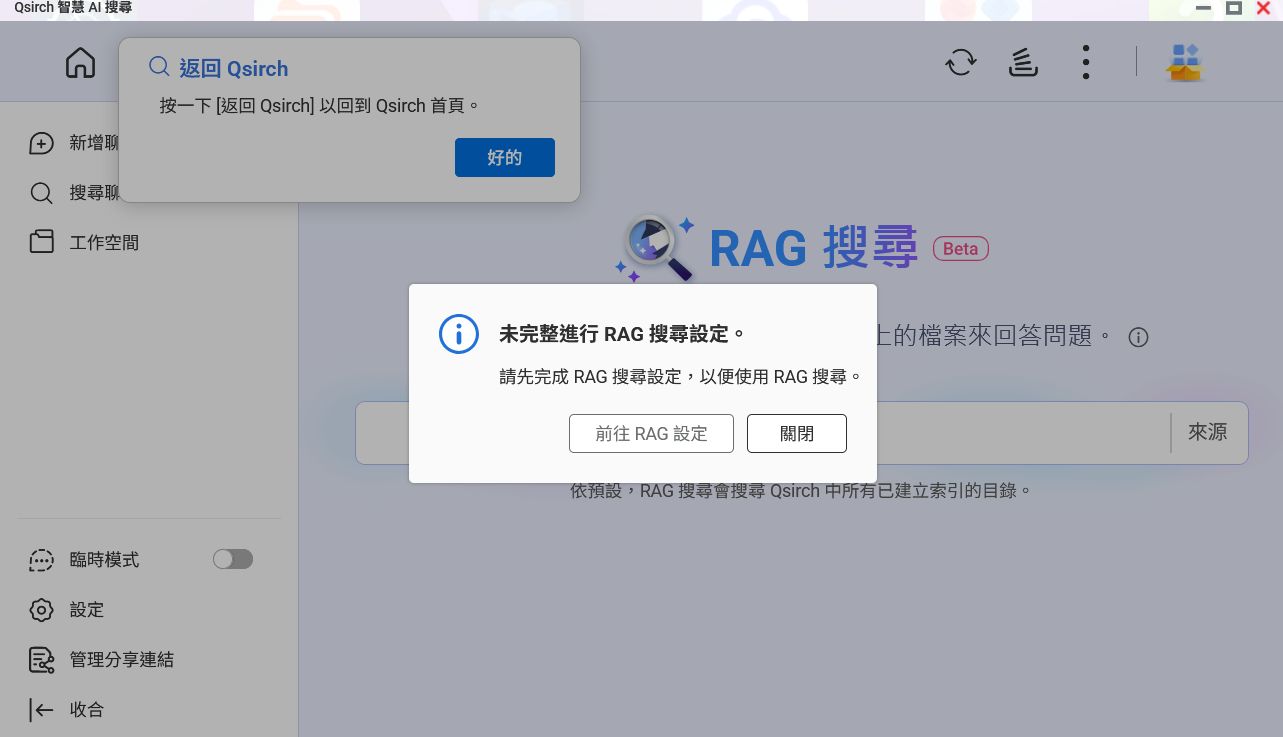
Qsirch 首頁的新功能介紹中可以看到「RAG 搜尋:工作空間(Beta)」,讓指定的資料夾變成可以提問的知識庫。第一次進入 RAG 搜尋會提示尚未完成設定。
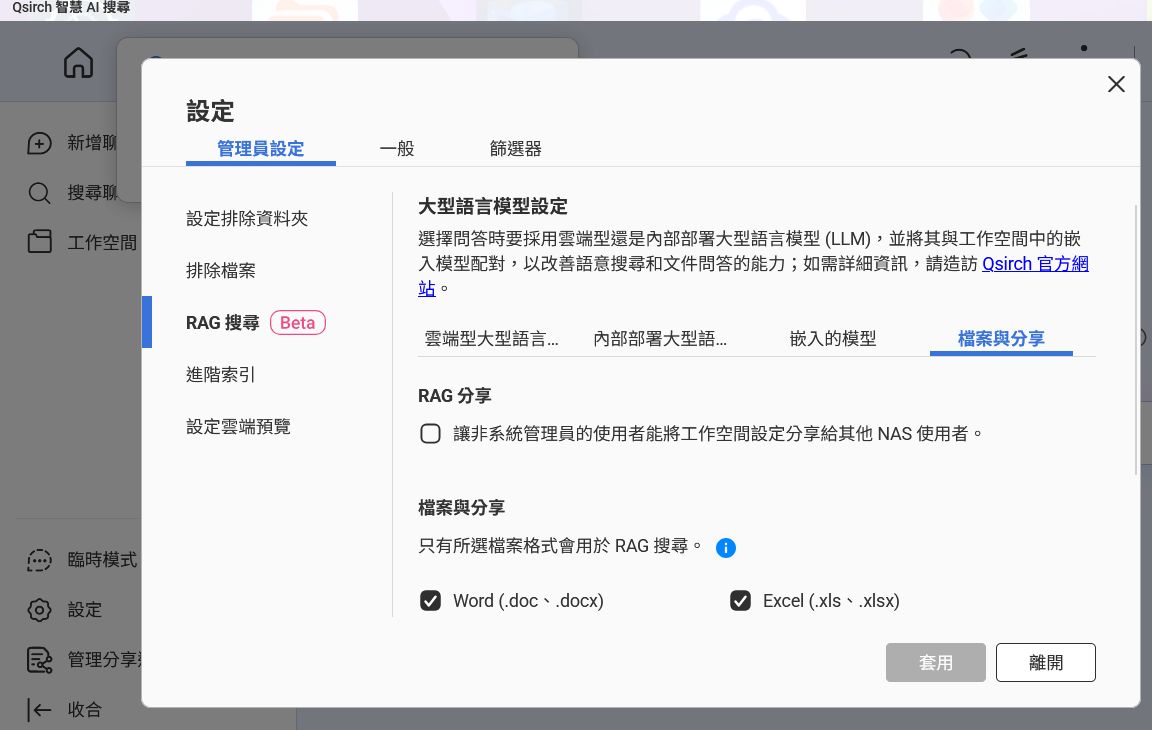
設定位於「設定 > 管理員設定 > RAG 搜尋」,分成四個分頁:雲端型大型語言模型、內部部署大型語言模型、嵌入的模型、檔案與分享。「檔案與分享」可以決定哪些檔案格式用於 RAG(Word、Excel、PowerPoint、PDF、純文字、Markdown、電子郵件),以及是否允許一般使用者分享工作空間。
接法一:本機 LLM Core
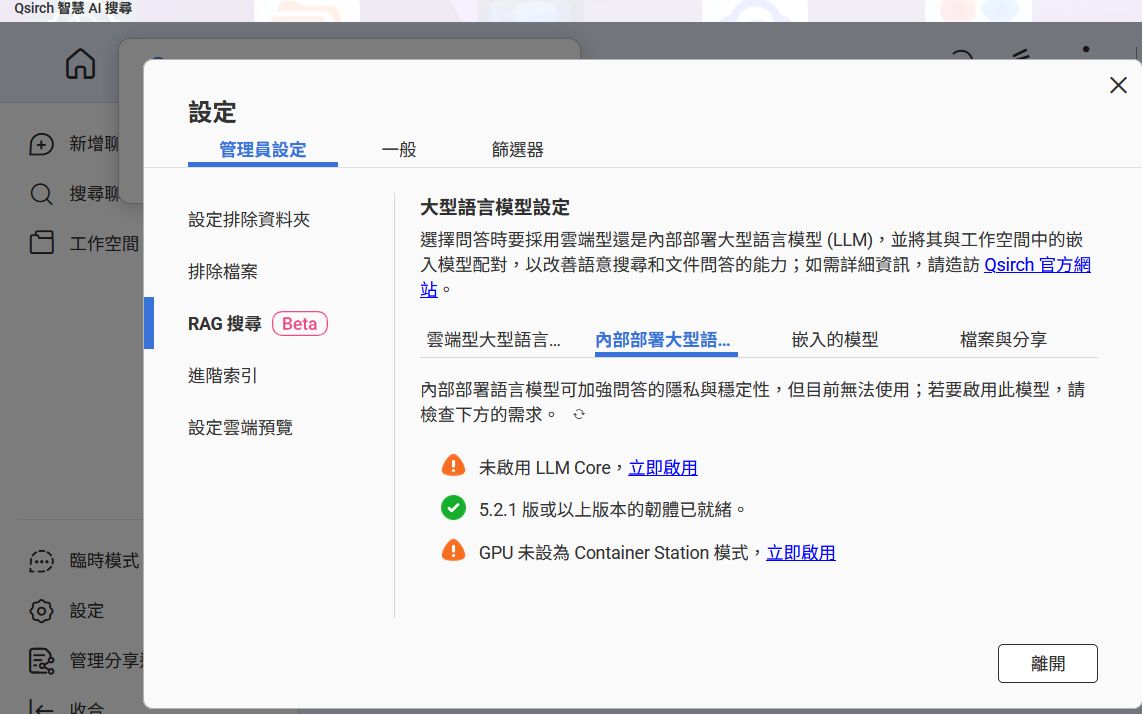
「內部部署大型語言模型」分頁會先列出三個前置條件:
- 已安裝並啟用 LLM Core
- 韌體為 5.2.1 或以上
- GPU 設為 Container Station 模式
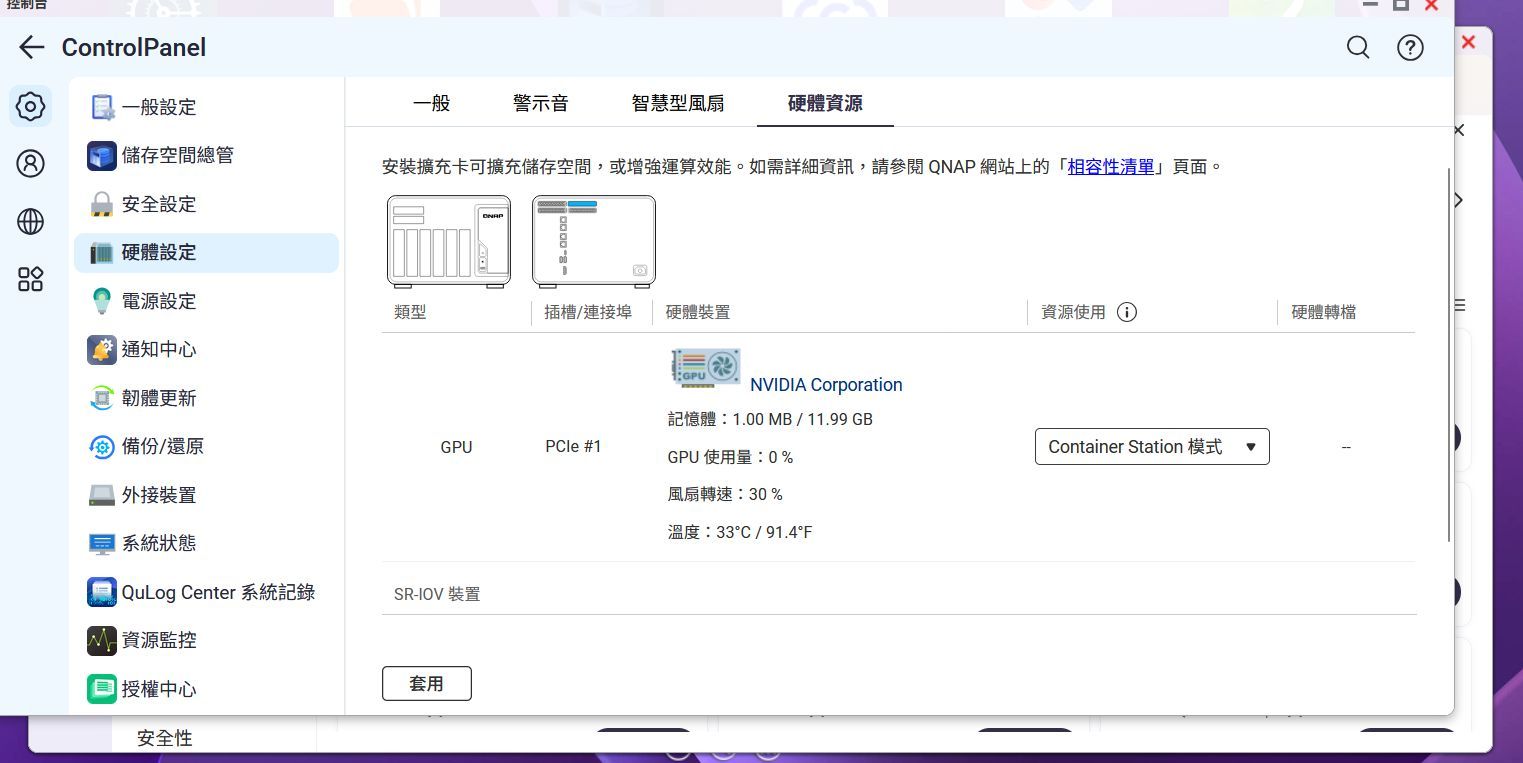
GPU 模式在「控制台 > 系統 > 硬體設定 > 硬體資源」切換,將顯示卡的資源使用改成「Container Station 模式」後套用。
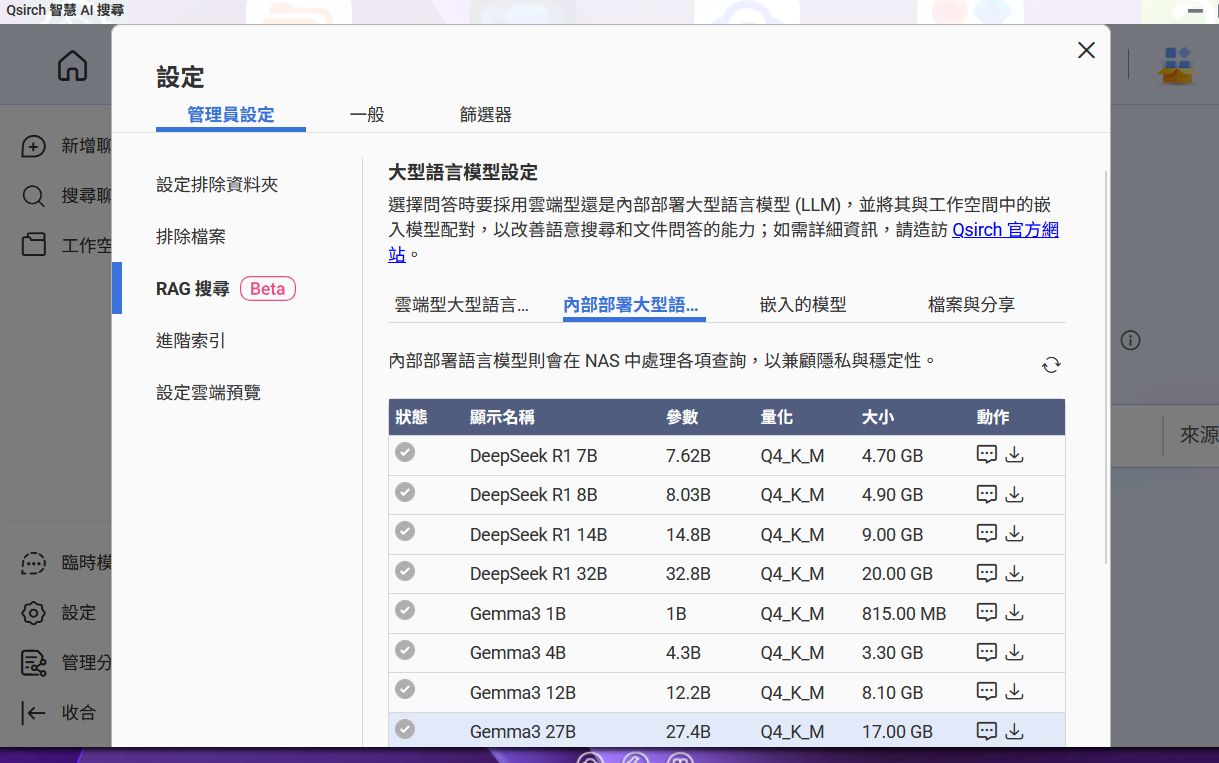
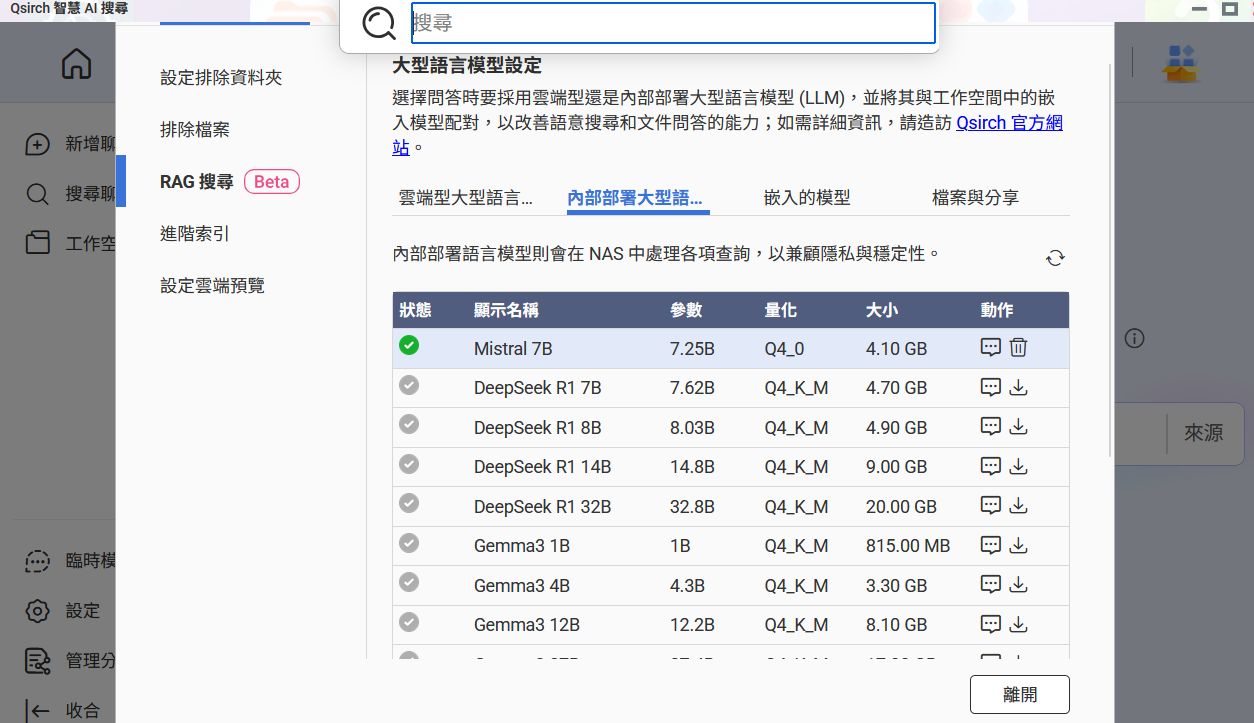
條件都滿足後,分頁會改為模型清單,列出 DeepSeek R1(7B 到 32B)、Gemma3(1B 到 27B)、Mistral 7B 等量化模型,清單上標有參數量、量化方式與檔案大小。我們先下載 Mistral 7B(Q4_0,4.1 GB)。
12 GB 顯示卡實際能用哪些模型
清單上有 15 款模型,但在這台機器上真正能拿來做 RAG 的只有少數幾款,原因有兩道關卡。
第一道:下載時出現錯誤碼 2105。 Gemma3、Qwen3.5 全系列與 gpt-oss 20B 按下載後都會失敗。LLM Core 的記錄顯示,Ollama 模型庫回應的是「此模型需要較新版本的 Ollama」(HTTP 412),而 LLM Core 1.0.2 內建的 Ollama 是 0.17.6。
QNAP 官方套件目錄中有較新的 LLM Core 1.1.0(2026 年 7 月發佈),在 QuTS hero h6.0.2 的 App Center 裡看不到,但官方套件可以手動安裝。我們實際裝上之後,內建的 Ollama 升到 0.21.0,既有的模型與 GPU 設定都保留下來,Qsirch 也照常運作;可惜 Gemma3、Qwen3.5、gpt-oss,連 1.1.0 目錄裡新增的 Gemma4 與 Qwen3.5 2B,下載時仍然被要求更新 Ollama。也就是說,Ollama 模型庫的最低版本要求已經超過 QNAP 目前提供的版本,要等 LLM Core 再更新。
第二道:Qsirch 以參數量比對 VRAM。 Phi-4 14B 下載成功(9.1 GB),但提問時一律失敗,Qsirch 記錄的原因是「Model parameter size (14.0GB) exceeds GPU memory (12.0GB)」。Qsirch 直接從模型名稱取出參數量(14B),當作 14 GB 與顯示卡記憶體比較,而不是看模型實際占用多少 VRAM。所以 12 GB 的卡只能使用名稱標示 12B 以下的模型,即使 14B 的 Q4 模型其實放得進去。
兩道關卡疊起來,12 GB 顯示卡能用於 Qsirch 的本機模型如下(LLM Core 1.0.2 與 1.1.0 結果相同):
| 模型 | 能下載 | Qsirch 可使用 |
|---|---|---|
| Mistral 7B | 是 | 是 |
| DeepSeek R1 7B、8B | 是 | 是 |
| DeepSeek R1 14B、Phi-4 14B | 是 | 否(參數量超過 12) |
| DeepSeek R1 32B | 是 | 否 |
| Gemma3、Qwen3.5、gpt-oss 全系列 | 否(錯誤碼 2105) | 不適用 |
因此本文的本機對照組只能選用 Mistral 7B 與 DeepSeek R1 8B。DeepSeek R1 是推理模型,Qsirch 呼叫本機模型時會要求關閉思考,實測回答中沒有出現思考過程。
陷阱:LLM Core 沒拿到 GPU,提問直接失敗
設定完成後第一次提問,畫面沒有回答。查 Qsirch 的後端記錄,看到的是:
load model to GPU failed, model: mistral:7b, size: 4833427456, size_vram: 0原因在安裝順序。這台機器上 LLM Core 先安裝並啟動,NVIDIA 驅動與 GPU 模式切換是之後才完成的。LLM Core 的啟動腳本只在啟動當下檢查有沒有 GPU,當時沒有,就以純 CPU 模式啟動 Ollama,之後也不會自己改變。而 Qsirch 會檢查模型是否真的載入 VRAM,發現沒有就直接回錯誤,不會退回用 CPU 慢慢算。
解法很簡單:在 App Center 把 LLM Core 停止再啟動一次。重新啟動後容器就會掛上 GPU,第一題(含載入模型)約 40 秒出現第一個字,之後每題只要幾秒。這個問題只出在安裝順序:之後我們把 NAS 正常關機再開機,LLM Core 啟動時驅動已經就緒,GPU 就正確掛上了。所以只有在「先裝 LLM Core、後裝驅動或切換 GPU 模式」時需要手動重啟一次;日後若本機模型突然無法回答,也可以先檢查這一點。
接法二:OpenAI 相容 API
「雲端型大型語言模型」不限於公有雲服務。供應商選「OpenAI 相容的 API」,就可以填入區網內自架的推論伺服器,例如 vLLM、Ollama 或 LiteLLM 這類代理。
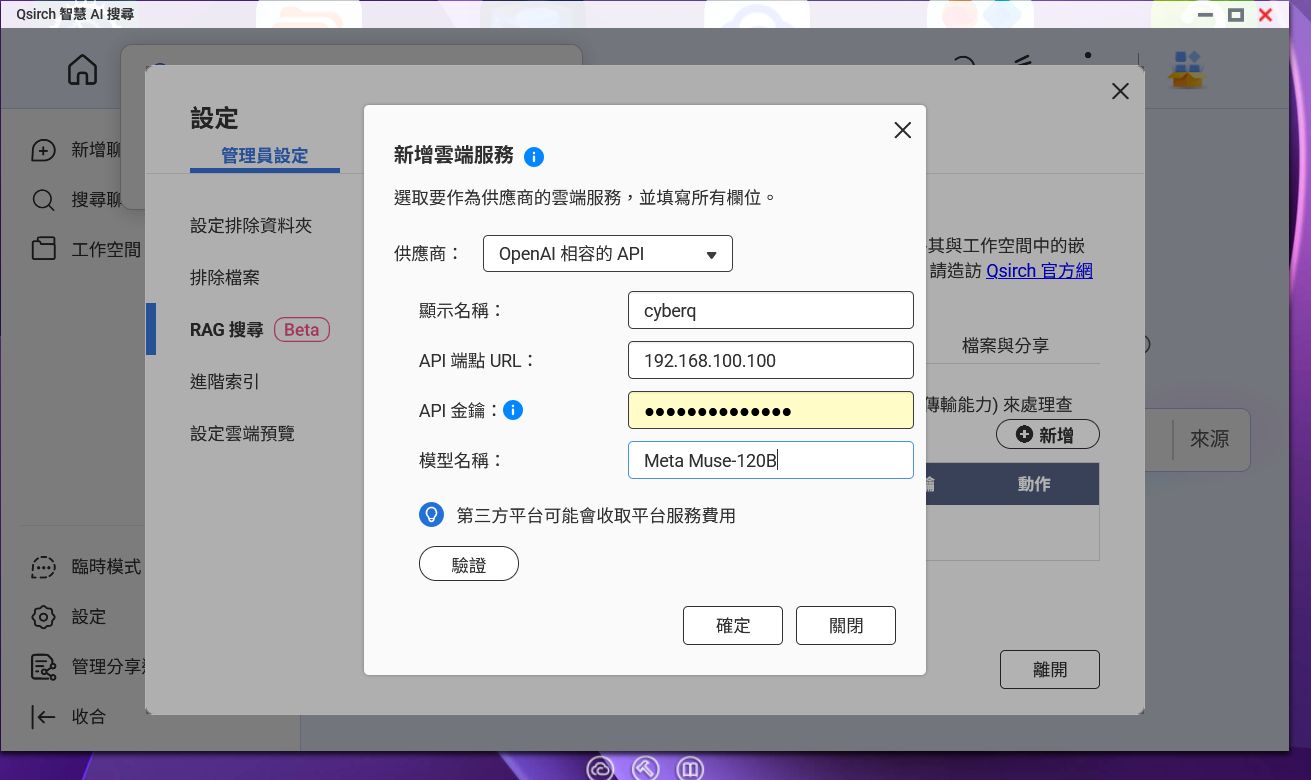
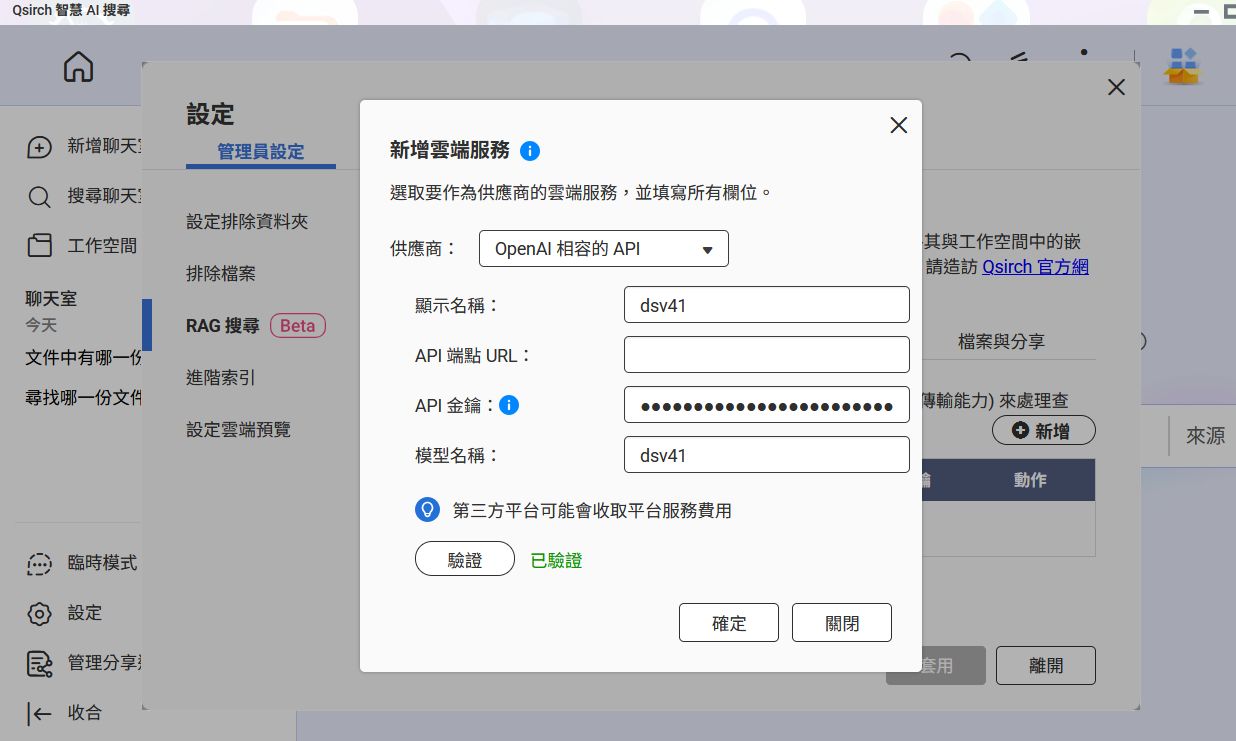
要注意的是端點必須是 NAS 本身連得到 的位址。我們第一次填的是推論伺服器之間直連網段的位址,從 NAS 根本連不過去;改成伺服器在辦公室區網上的位址,並在路徑加上 /v1,按「驗證」就顯示「已驗證」。
測試方法
為了讓答案可以客觀評分,CyberQ 準備了 15 份虛構的內部文件:繁體中文 10 份、英文 3 份、日文 2 份,格式涵蓋 Word、PDF、PowerPoint、純文字與 Markdown,內容是 IT 部門常見的備份策略、UPS 設定、採購比價、預算、資安應變程序等。每份文件都有可以逐字查核的數字或規定。
題目共 14 題,全部用繁體中文提問:
- 9 題同語言:答案在中文文件裡,例如「停電後 NAS 幾分鐘會自動關機?電池剩多少會立即關機?」
- 4 題跨語言:用中文問,但答案只在英文或日文文件裡,例如「發現勒索軟體時,可以直接關機嗎?要在多久內通知資安團隊?」
- 1 題負向題:「員工旅遊今年要去哪裡?」文件裡沒有,正確答案是回答找不到。
評分方式:答對 1 分,部分正確(例如兩個數字對一個)0.5 分。三個模型(Mistral 7B、DeepSeek R1 8B、DeepSeek-V4.1-Flash)各跑兩種模式:
- 資料夾模式:直接在 RAG 搜尋指定文件所在資料夾,沿用 Qsirch 原本的全文索引來檢索。
- 工作空間模式:建立一個工作空間放入同樣 15 份文件,由多語嵌入模型(Multilingual E5 Small)向量化後檢索。15 份文件約 20 秒處理完成。
所有提問都透過 Qsirch 自己的網頁 API 送出,同一題在同一模式下各模型拿到的檢索結果完全相同,差異只來自模型。
結果
準確度
| 模式 | 模型 | 同語言(9 題) | 跨語言(4 題) | 負向題(1 題) | 合計(14 題) |
|---|---|---|---|---|---|
| 資料夾 | Mistral 7B(本機) | 7 | 0 | 1 | 8 |
| 資料夾 | DeepSeek R1 8B(本機) | 9 | 0.5 | 1 | 10.5 |
| 資料夾 | DeepSeek-V4.1-Flash(外部) | 9 | 0 | 1 | 10 |
| 工作空間 | Mistral 7B(本機) | 8 | 1.5 | 1 | 10.5 |
| 工作空間 | DeepSeek R1 8B(本機) | 9 | 1.5 | 1 | 11.5 |
| 工作空間 | DeepSeek-V4.1-Flash(外部) | 9 | 1 | 1 | 11 |
速度
| 模式 | 模型 | 首字時間(中位數) | 完整回答(中位數) | 完整回答(最長) | 回答長度(中位數) |
|---|---|---|---|---|---|
| 資料夾 | Mistral 7B | 1.1 秒 | 3.9 秒 | 9.2 秒 | 120 字 |
| 資料夾 | DeepSeek R1 8B | 0.9 秒 | 7.1 秒 | 13.8 秒 | 329 字 |
| 資料夾 | DeepSeek-V4.1-Flash | 1.2 秒 | 5.8 秒 | 9.2 秒 | 440 字 |
| 工作空間 | Mistral 7B | 1.3 秒 | 4.2 秒 | 16.2 秒 | 121 字 |
| 工作空間 | DeepSeek R1 8B | 1.0 秒 | 8.0 秒 | 14.9 秒 | 362 字 |
| 工作空間 | DeepSeek-V4.1-Flash | 1.4 秒 | 6.6 秒 | 11.9 秒 | 482 字 |
首字時間包含 Qsirch 檢索文件的時間。本機模型在模型已載入的狀態下測試,冷啟動的第一題 Mistral 7B 約 40 秒、DeepSeek R1 8B 約 14 秒。
以上資料均在 LLM Core 1.0.2 下測試,當時 Mistral 7B 載入後常駐約 4.9 GB VRAM,DeepSeek R1 8B 約 6.0 GB,兩者可以同時常駐在 12 GB 的顯示卡上。升級到 1.1.0 後,LLM Core 會依顯示卡記憶體自動設定上下文長度(12 GB 卡設為 16K,原本是 4K),Mistral 7B 的占用因此增加到約 7.6 GB,兩個模型無法再同時常駐,切換模型時要重新載入,第一題要等 25 到 45 秒。Mistral 7B 回答期間 GPU 使用率會到 100%,功耗也頂到顯示卡的上限。
測試後的觀察
1. 同語言的問題,7B 模型大致夠用,但會算錯
Mistral 7B 在同語言題答對 7 到 8 題,錯誤集中在需要計算或轉述數字的地方,例如把「3.2 kW 加上兩台各 1.1 kW」算成 8.6 kW 或 4.6 kW,把「百分之四十五」寫成「四十五成」,或在比價題自行加總出文件裡沒有的金額。DeepSeek R1 8B 同樣是本機的小模型,同語言題在兩種模式下都全對,數字轉述與計算都正確,只在補充說明裡偶爾多寫了文件沒有的推算(例如把三台事務機的月租總額算錯)。DeepSeek-V4.1-Flash 在兩種模式下同語言題也都全對,回答會整理原因與補充事項,長度約為 Mistral 的四倍,但完整回答時間只多約 2 秒。
2. 檢索才是瓶頸,跨語言幾乎找不到
4 題跨語言題在資料夾模式下,正確的英文、日文文件一次都沒有被找出來,換成工作空間的多語嵌入,也只有日文的災害復原手冊被找到。同樣的問題改用文件本身的語言發問(英文問英文、日文問日文),正確文件 4 題都排在第一位。也就是說文件有建好索引,只是中文問句檢索不到外文文件。如果公司文件混有多種語言,目前比較實際的作法是用文件的語言提問,或為重要的外文文件準備中文摘要。
3. 找不到資料時,小模型會編答案
這是兩個模型差異最大的地方。檢索沒有拿到正確文件時,DeepSeek-V4.1-Flash 每一次都明確回答「文件中沒有這項資訊」,並列出它看到的文件各在講什麼。Mistral 7B 則會自行編出答案,例如資料夾模式下的勒索軟體那題,它回答「可以直接關機」,與英文文件中「不要關機,以保留記憶體證據」正好相反。DeepSeek R1 8B 介於兩者之間,多數時候會說明文件中沒有答案,但勒索軟體那題會依一般常識推論「應避免直接關機」,方向雖然正確,卻不是來自文件。對企業內部知識庫而言,看起來很有把握的錯誤答案,比回答不知道更危險。
4. 工作空間比直接搜資料夾好一些
兩個模型在工作空間模式下分數都比較高,主因是嵌入檢索多找到一份日文文件;Mistral 在同語言題也多答對一題(R02 與 R08 的數字轉述正確了)。如果要把某一批文件當成知識庫長期使用,建議建立工作空間。
5. Qsirch 交給地端模型的內容很精簡
從推論伺服器端的記錄看,每次請求的系統提示詞最長約 1,950 字元,也就是只放入檢索到的幾個段落。換言之,這讓小模型也處理得來,但也表示答案品質,幾乎得完全取決於檢索有沒有找對段落。
換成雲端嵌入模型,跨語言會改善嗎
既然瓶頸在檢索,下一個問題是,換一個更強的嵌入模型有沒有用?「嵌入的模型」分頁除了內建的 Multilingual E5 Small,也可以新增雲端嵌入模型,但 Qsirch 軟體中列出的可選雲端供應商只有三家:
| 供應商 | 可選模型 | 自訂端點 |
|---|---|---|
| Gemini | gemini-embedding-001 | 不可 |
| OpenAI | text-embedding-3-small、text-embedding-3-large | 不可 |
| Azure OpenAI | 同上 | 可,但須為 Azure 的部署格式 |
問答模型可以選「OpenAI 相容的 API」接自架伺服器,嵌入模型則沒有這個選項,所以區網內自架的推論服務只能拿來回答,不能拿來向量化文件。選雲端嵌入也代表文件內容會送到雲端服務處理,這點要先和資料管理政策對齊。
因此這次新增了 Gemini Embedding 001,另外建立一個工作空間放入同樣 15 份文件(約 10 秒完成),原本 E5 的工作空間保留不動,兩邊用 DeepSeek R1 8B 與 DeepSeek-V4.1-Flash 各跑同樣 14 題。
| 嵌入模型 | 問答模型 | 同語言(9 題) | 跨語言(4 題) | 負向題(1 題) | 合計(14 題) |
|---|---|---|---|---|---|
| Multilingual E5 Small(本機) | DeepSeek R1 8B | 9 | 1.5 | 1 | 11.5 |
| Gemini Embedding 001(雲端) | DeepSeek R1 8B | 9 | 2 | 1 | 12 |
| Multilingual E5 Small(本機) | DeepSeek-V4.1-Flash | 9 | 1 | 1 | 11 |
| Gemini Embedding 001(雲端) | DeepSeek-V4.1-Flash | 9 | 2 | 1 | 12 |
兩個問答模型拿到的檢索結果完全相同,進步全部來自檢索。逐題看正確文件在檢索結果中的排名(工作空間每題取前 5 個段落):
| 題目 | 文件語言 | E5 Small | Gemini |
|---|---|---|---|
| 勒索軟體可否關機、多久通知 | 英文 | 未進前 5 | 未進前 5 |
| 監控錄影保存期限 | 英文 | 未進前 5 | 未進前 5 |
| 災害復原切換目標時間 | 日文 | 第 2 | 第 1 |
| 舊檔案伺服器保留期間 | 日文 | 未進前 5 | 第 3 |
日文兩題都改善了,「舊檔案伺服器」那題從找不到變成找得到並答對,英文兩題則完全沒有改變。這兩題 DeepSeek-V4.1-Flash 仍然明確回答文件中沒有資訊,還特別指出檢索到的「一小時內通知資訊部」是釣魚郵件的規定、不適用於勒索軟體,DeepSeek R1 8B 則依常識推論,把通知時限說成「一小時內」,與文件寫的 30 分鐘不符。用英文直接問英文文件,Gemini 工作空間一樣把正確文件排在第一位,所以不是文件沒有建好。
原因可以從 Qsirch 的程式結構看出來,工作空間的檢索是混合式的,同時跑向量檢索與全文關鍵字檢索,再以 Reciprocal Rank Fusion 合併排名。中文問句在全文檢索那一側只會命中中文文件,這些文件在合併時被往前推,英文文件就算在向量那一側排得不錯,也可能被擠出前 5 名。換句話說,嵌入模型變強只能改善一半,另一半受限於中文關鍵字的拉扯,這部分使用者無法調整。
速度方面,Gemini 工作空間的首字時間中位數同樣約 1 秒,呼叫雲端向量化問句沒有帶來可察覺的延遲。
結論是雲端嵌入對日文有幫助,對英文沒有幫助,而且要把文件送上雲端。若主要訴求是資料不出 NAS,維持內建的 E5 Small,並用文件本身的語言提問,仍是比較實際的作法。
關於 AI Mode:實際裝上 Qsirch 7.1 檢查
Qsirch 7.1 加入了 AI Mode(以 AI 建立語意索引,可以用描述搜尋照片與影片)。7.1 在 QuTS hero h6.0.2 的 App Center 裡看不到,但 QNAP 官方套件目錄中有,我們手動裝上,直接查詢 AI Mode 的前置檢查結果:
| 檢查項目 | 結果 |
|---|---|
| 機種白名單(TS-X77AX 系列) | 通過 |
| 韌體版本 | 通過 |
| GPU 設為 Container Station 模式 | 通過 |
| 授權 | 通過 |
| LLM Core 版本(需 1.1.0 以上) | 通過(已升級到 1.1.0) |
| Container Station 模式的 VRAM 合計 16 GB 以上 | 未通過(12 GB) |
| 已安裝 CAYIN Media Viewer 並具備授權 | 未通過(未安裝,需付費授權) |
這台機器在機種與軟體條件上都符合,真正卡住的是顯示卡記憶體不足 16 GB,以及需要另外購買 CAYIN Media Viewer 的授權。要在 TVS-h877AX 上使用 AI Mode,需要換裝 16 GB 以上的顯示卡並取得授權。
另外兩個在 7.1 上觀察到的現象:
RAG 搜尋在 7.1 照常運作,「參數量不得超過顯示卡 GB 數」的規則仍然存在。
從 7.0.3 升級到 7.1 時,索引資料庫會重新初始化,原本建立的工作空間不見了。正式環境升級前,建議先備份 Qsirch 的資料。
由於 AI Mode 無法啟用,我們把 Qsirch 退回 7.0.3.2,並以升級前的備份還原,工作空間與 RAG 設定都恢復原狀。本文其餘的測試數據皆在 7.0.3.2 下取得。
建議
先把 GPU 與 NVIDIA 驅動準備好,再安裝 LLM Core;順序相反的話,記得重新啟動一次 LLM Core。
本機模型首選 DeepSeek R1 8B。在 12 GB 顯示卡上它是目前能用的模型中表現最好的,同語言題全對,速度與 Mistral 7B 相近。Mistral 7B 的繁體中文偶有用詞錯誤與算錯。
想用 14B 以上的本機模型,要 16 GB 以上的顯示卡,這是 Qsirch 以參數量比對 VRAM 的規則決定的,與模型實際大小無關。Gemma3、Qwen3.5 則要等 LLM Core 更新內建的 Ollama。
重視答案可信度時,接一個較大的模型。區網內若已有推論伺服器,用 OpenAI 相容 API 接上即可,資料仍然不出公司。
混合多語言文件時,用文件的語言提問,或為外文文件準備中文摘要。
長期使用的文件集建立成工作空間。
本機模型與其他 GPU 應用共用顯示卡時,留意 VRAM 預算。
附錄:題目與標準答案
| 編號 | 問題 | 標準答案 | 文件語言 |
|---|---|---|---|
| R01 | 快照保留天數建議從幾天改成幾天?每小時快照要保留幾份? | 7 天改 30 天;24 份 | 中文 |
| R02 | 停電後 NAS 幾分鐘會自動關機?電池剩多少會立即關機? | 5 分鐘;低於 30% | 中文 |
| R03 | 10GbE 交換器導入計畫的設備預算是多少?什麼時候上線? | 42 萬元;十一月上線 | 中文 |
| R04 | 會議室投影設備哪個方案五年總持有成本最低?報價多少? | 方案甲雷射投影機,88,000 元 | 中文 |
| R05 | 韌體更新前,最近一次完整備份必須在多久以內? | 24 小時內且成功 | 中文 |
| R06 | 新增 GPU 伺服器後機房總耗電多少?空調能力夠嗎? | 5.4 kW;空調 7 kW,餘裕約兩成 | 中文 |
| R07 | VPN 閒置多久會自動斷線?申請要幾個工作天? | 30 分鐘;3 個工作天 | 中文 |
| R08 | 明年度資訊總預算多少?硬體汰換占幾成? | 320 萬元;45% | 中文 |
| R09 | 事務機彩色超印每張多少錢?每台月租多少? | 3 元;2,800 元 | 中文 |
| R10 | 發現勒索軟體時,可以直接關機嗎?要在多久內通知資安團隊? | 不要關機;30 分鐘內 | 英文 |
| R11 | 監控錄影一般保存幾天?跟資安事件有關的要保存多久? | 30 天;3 年 | 英文 |
| R12 | 災害復原站點切換的目標時間是多久? | 4 小時以內 | 日文 |
| R13 | 舊檔案伺服器移轉後還會保留多久?保留期間是什麼狀態? | 一個月,唯讀 | 日文 |
| R14 | 員工旅遊今年要去哪裡? | 應回答找不到 | 無 |