當 AI 資料中心導入 NVIDIA B200/B300或更新的伺服器叢集,大家的目光多半集中在 GPU、NVLink 與高速網路,但訓練與推論流程每天吐出的資料總要有地方放。模型輸出的 JSON 紀錄、評測結果、資料集的歷史版本,這些資料不需要每秒數十 GB 的全快閃儲存,卻需要大容量、可靠、每 TB 成本合理,而且能用標準協定直接掛載的穩定儲存池。
這次 CyberQ 實際開箱並部署一台 QNAP TS-h1677AXU-RP,裝滿 16 顆 Toshiba MG09 18TB 企業級硬碟,組成 188 TB 的 RAID 60 儲存池,擔任 AI 資料中心 B200 叢集的冷資料儲存層。本文從實機外觀、儲存池與共用資料夾規劃、NFS 與 25GbE 網路聚合設定,一路寫到本機 fio 實測資料做開箱實測說明。
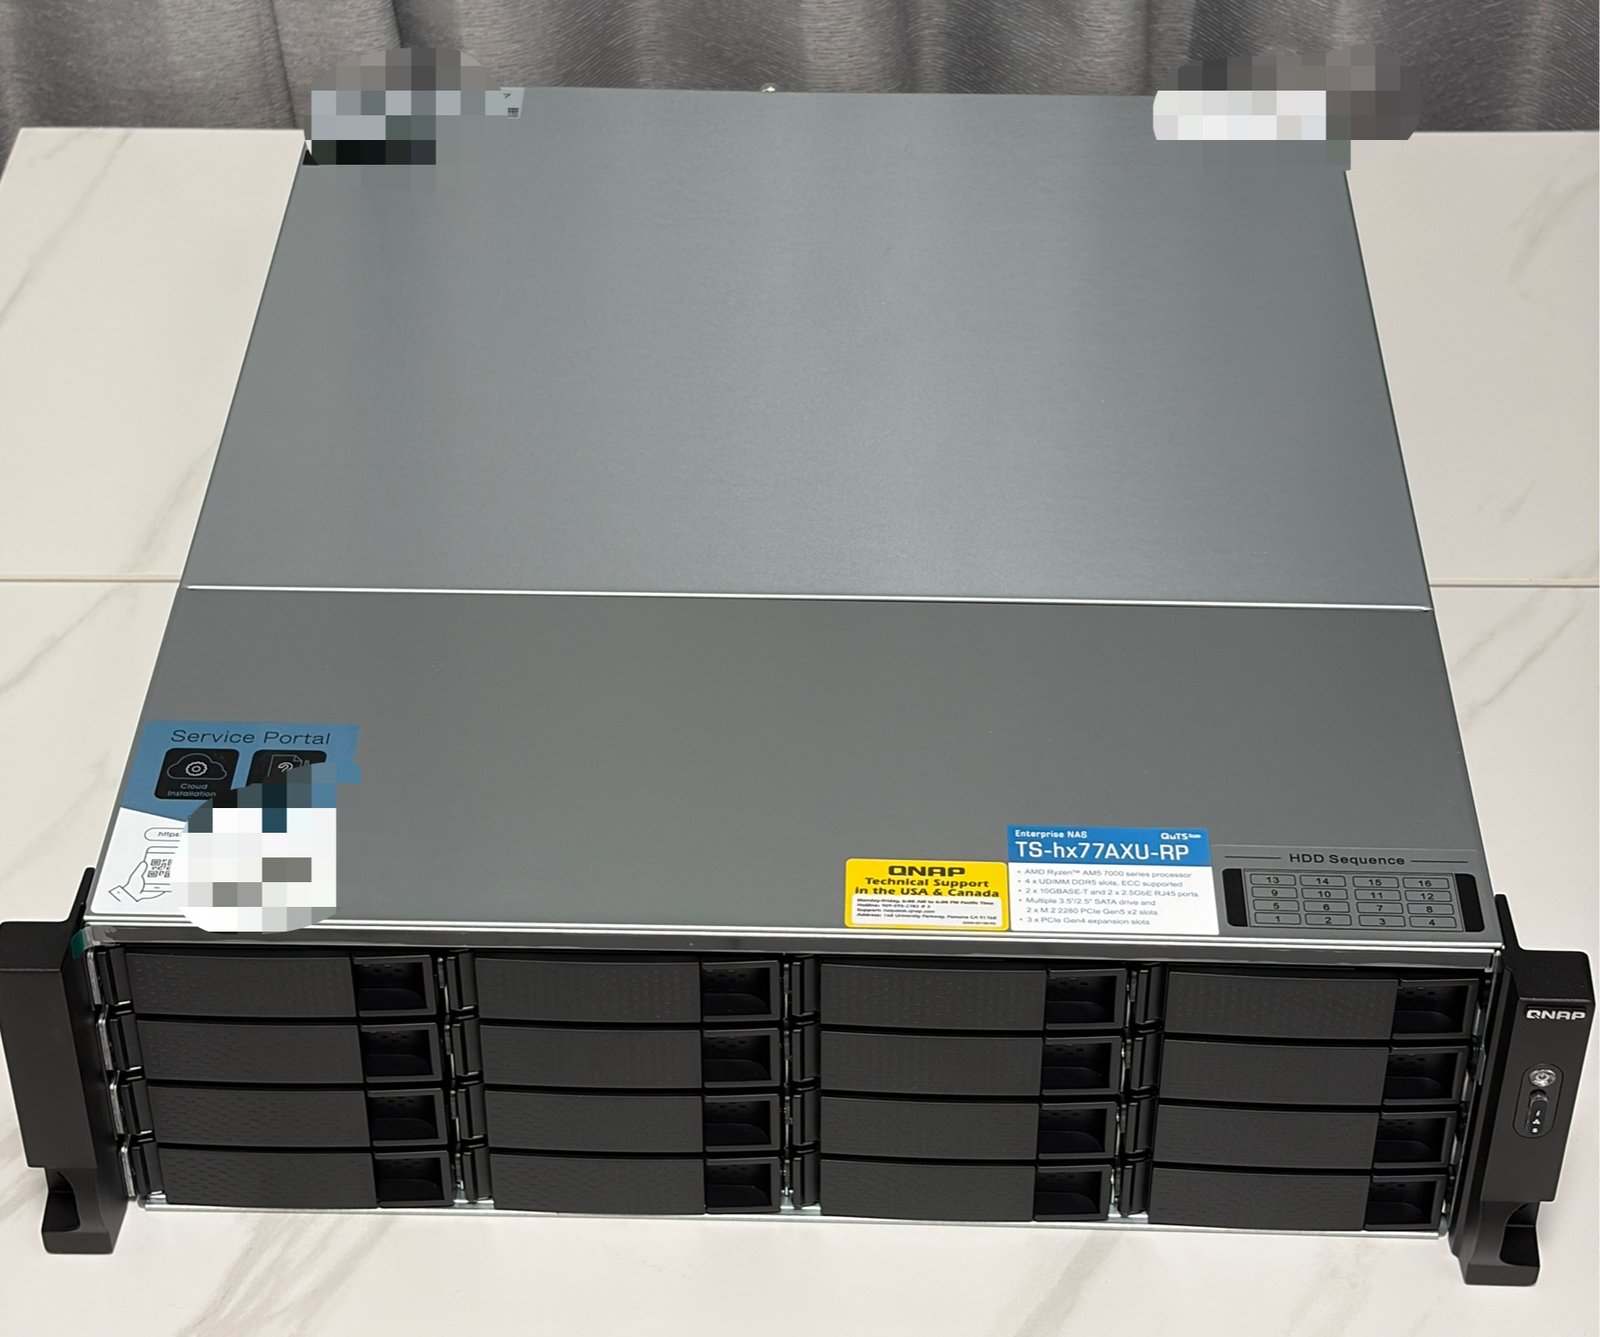
QNAP TS-h1677AXU-RP 是 3U 機架式 ZFS NAS,正面 16 個 3.5 吋硬碟槽,右側為電源鍵與狀態燈號。
部署在 B200 叢集旁的冷資料層
這台 NAS 在 AI 資料中心裡的角色很明確,B200 叢集經由兩台 NVIDIA 高速網路交換器,連到 NAS 上的 25GbE 雙埠網卡,持續寫入單檔約 10 MB 的 JSON 冷資料。GPU 節點本身有高速的本機 NVMe 與專用的熱資料儲存,這台 NAS 負責的是寫得進去、放得夠久、要用時讀得回來的那一層。
因此這次的規劃重點不是追求極限 IOPS,而是聚焦在容量與容錯的平衡、網路頻寬不要成為瓶頸,以及用實測數字確認硬碟陣列本身的能力。
核心硬體規格
TS-h1677AXU-RP 屬於 QNAP 的 AMD Ryzen 7000 系列機架式機種,出廠即搭載 ZFS 架構的 QuTS hero 作業系統。以下規格依據系統資訊畫面、機身貼紙與 QNAP 官方規格頁彙整:
| 項目 | 規格 |
|---|---|
| 處理器 | AMD Ryzen 7 PRO 7745,8 核心 16 執行緒,最高 5.3 GHz(Zen 4) |
| 記憶體 | 預載 32 GB DDR5 UDIMM,4 個插槽,支援 ECC,最高 192 GB |
| 硬碟槽 | 16 個 3.5 吋 SATA 6Gb/s,支援熱插拔 |
| M.2 插槽 | 2 個 M.2 2280 PCIe Gen5 x2 |
| 內建網路 | 2 個 10GBASE-T(Marvell AQtion AQC113)與 2 個 2.5GbE RJ45 |
| PCIe 擴充 | 3 個 PCIe Gen4 插槽(x4、x8 或 x4、x4) |
| USB | 2 個 USB 3.2 Gen 2 Type-A(10Gbps) |
| 電源 | 2 顆 550W 80 PLUS 白金 CRPS 熱插拔備援電源 |
| 散熱 | 3 顆 60mm 系統風扇 |
| 外型 | 3U 機架式 |
| 本次加裝 | QNAP QXG-25G2SF-BCM 雙埠 25GbE SFP28 網卡 |
| 本次硬碟 | 16 顆 Toshiba MG09ACA18TE(18TB、7200 轉、CMR) |
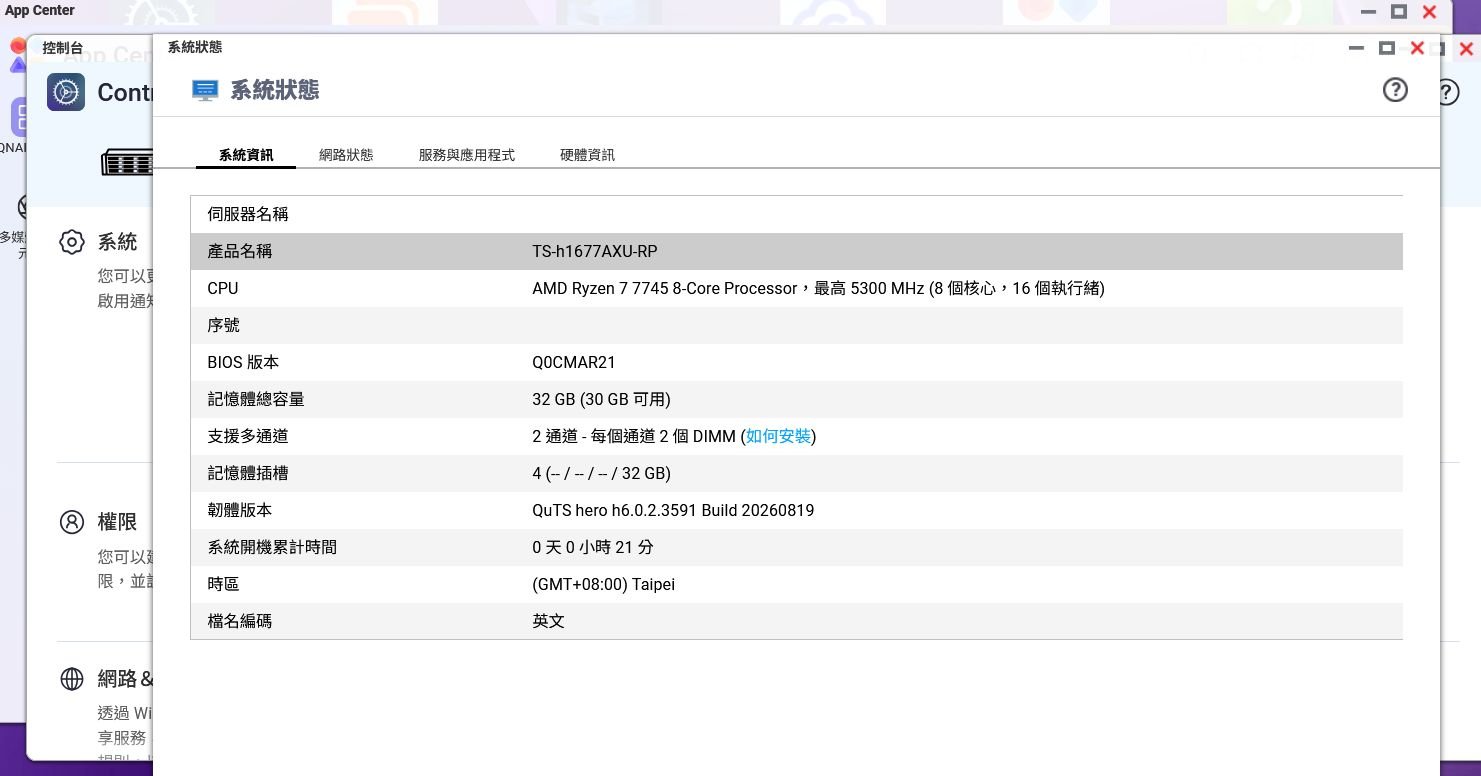
系統資訊頁:CPU 顯示為 Ryzen 7 7745(系統核心回報的完整型號為 Ryzen 7 PRO 7745),記憶體 32 GB,韌體 QuTS hero h6.0.2.3591。
值得注意的是記憶體配置。系統資訊顯示 4 個插槽中只有 1 個插上 32 GB 模組,而這顆處理器是雙通道架構。對冷資料的循序寫入來說,目前的 30 GB 可用記憶體已經足夠,但日後若要擴充給 ZFS ARC 快取使用,CyberQ 建議可成對加裝記憶體,讓雙通道頻寬發揮出來。
外觀開箱:為 24/7 機房而生的用料
機身背面可以看到典型的伺服器配置:左側是主機板 I/O 區,中間是 PCIe 擴充槽,右側是兩顆可熱抽換的備援電源。
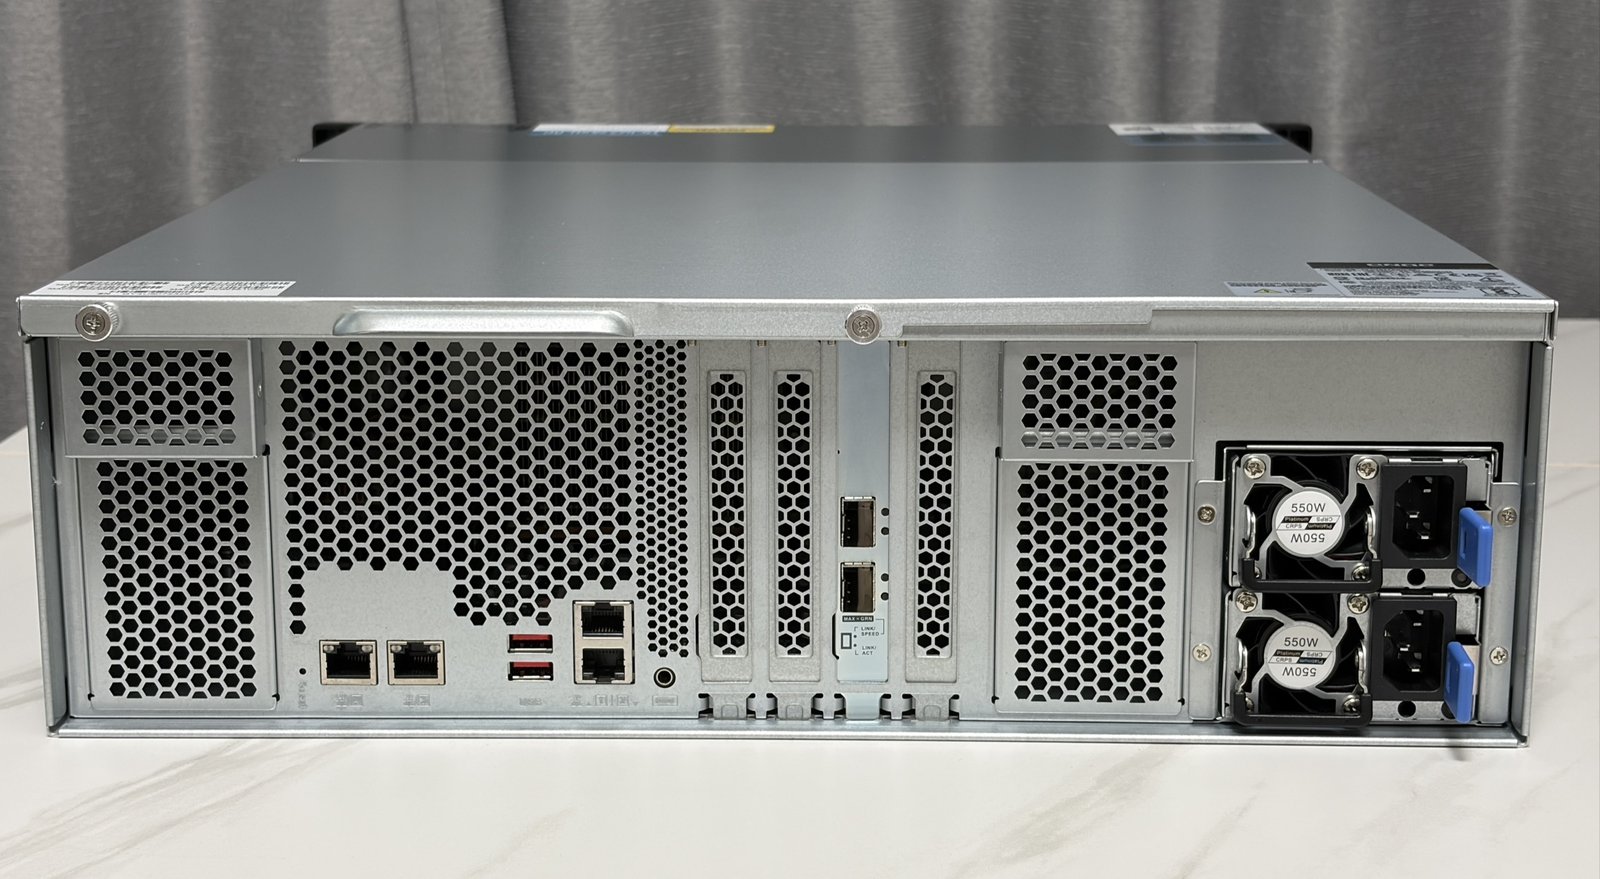
TS-h1677AXU-RP 背面:I/O 區、PCIe 擴充槽與雙備援電源一字排開。
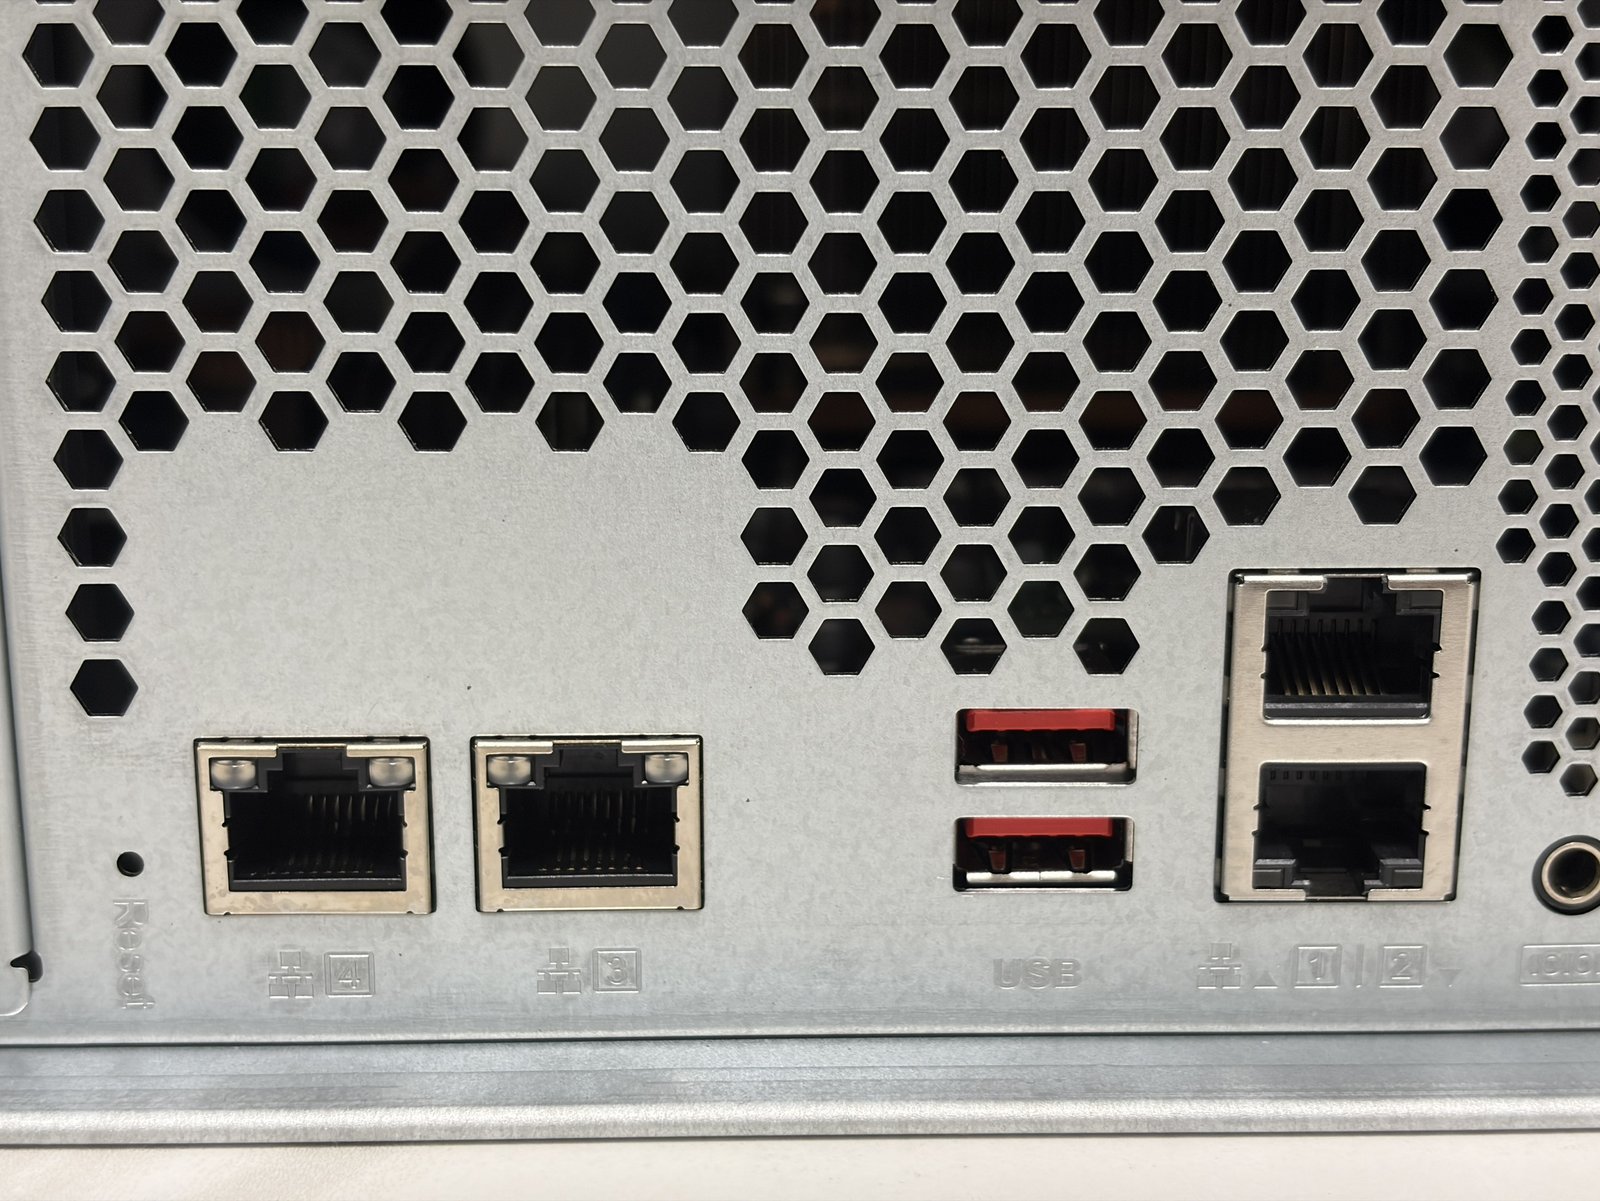
背板 I/O 特寫:左側兩個是 10GBASE-T,右側上下疊放的是兩個 2.5GbE,中間為兩個 USB 3.2 Gen 2。
內建的兩個 10GBASE-T 使用 Marvell AQtion AQC113 晶片,可以直接接上既有的銅線 10GbE 網路作為管理與備援路徑。真正對 B200 叢集提供服務的,是在 PCIe 插槽加裝的 QXG-25G2SF-BCM 雙埠 25GbE 網卡。
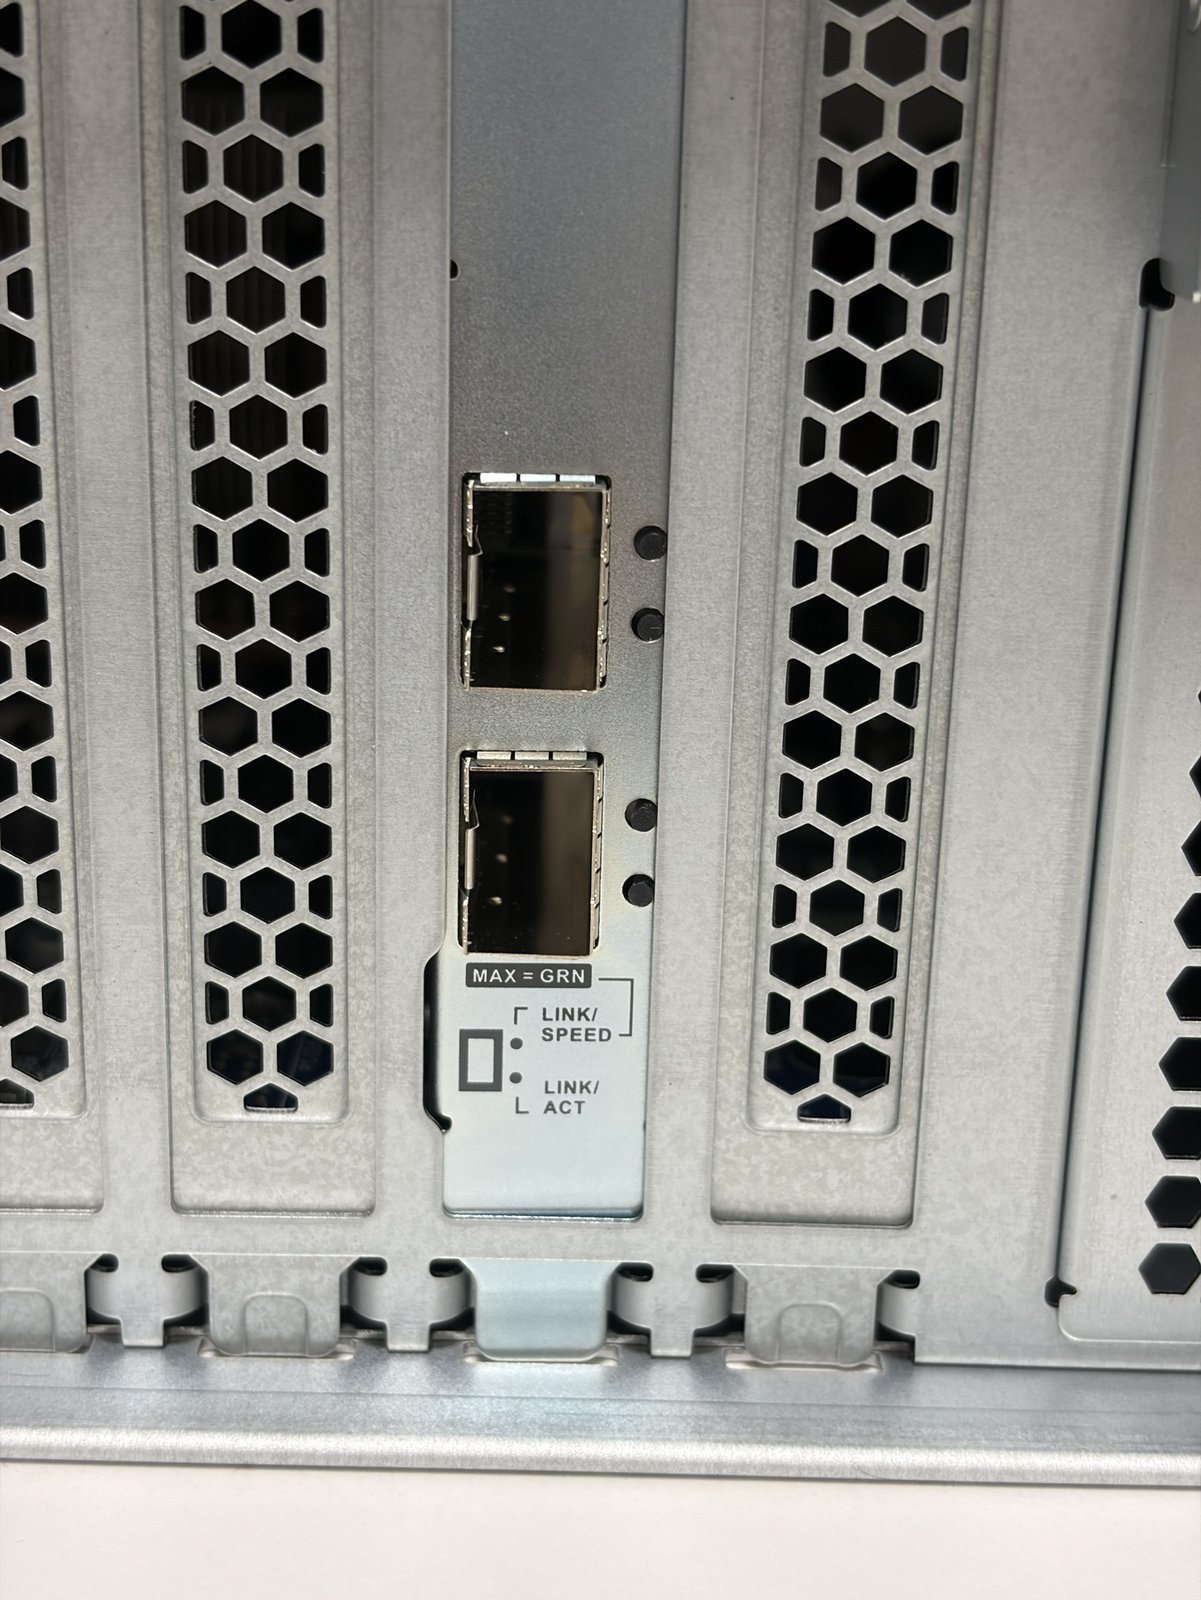
加裝的 QXG-25G2SF-BCM 雙埠 25GbE SFP28 網卡,每埠旁有連線速度與活動燈號。
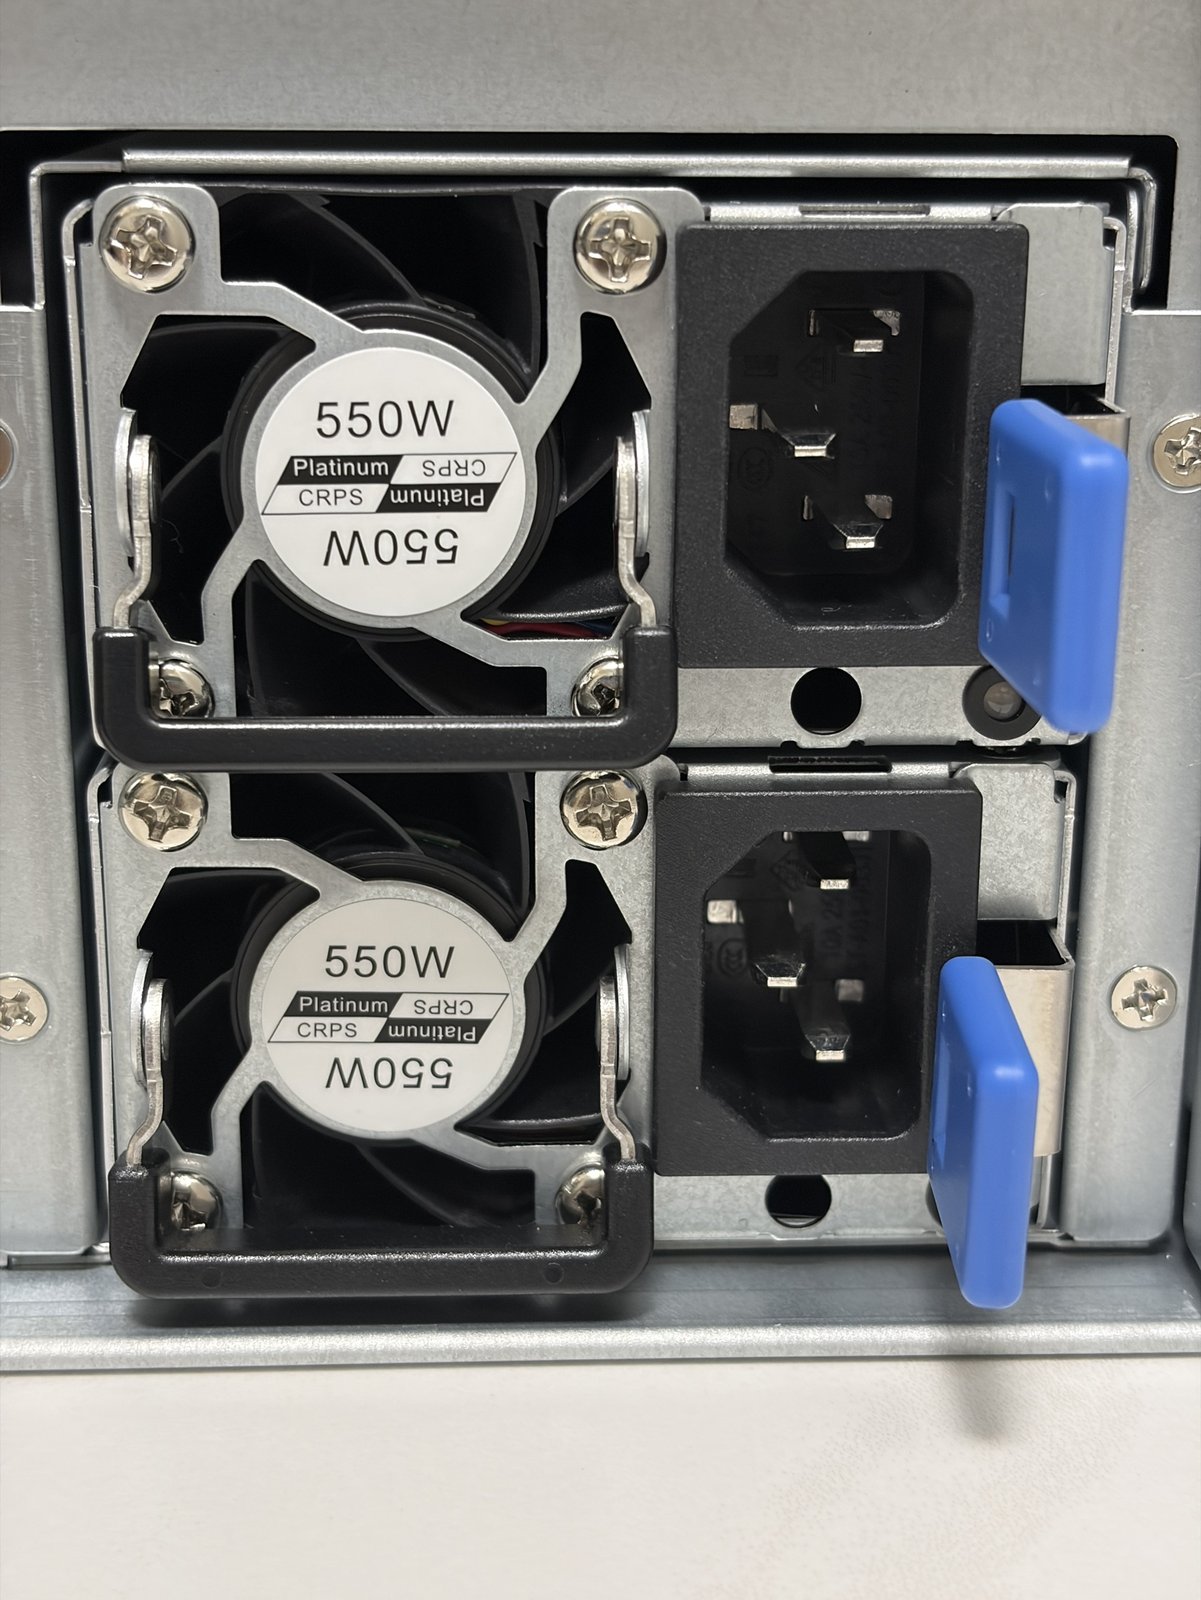
兩顆 550W 白金 CRPS 電源模組,藍色卡榫可直接熱抽換,任一顆故障時另一顆可獨力支撐整機。
16 顆硬碟全部是 Toshiba MG09ACA18TE,這是 18TB、7200 轉、CMR 記錄方式的企業級 SATA 硬碟,官方規格的最大持續傳輸率約 268 MB/s,設計上就是為了資料中心的 24 小時連續運作。
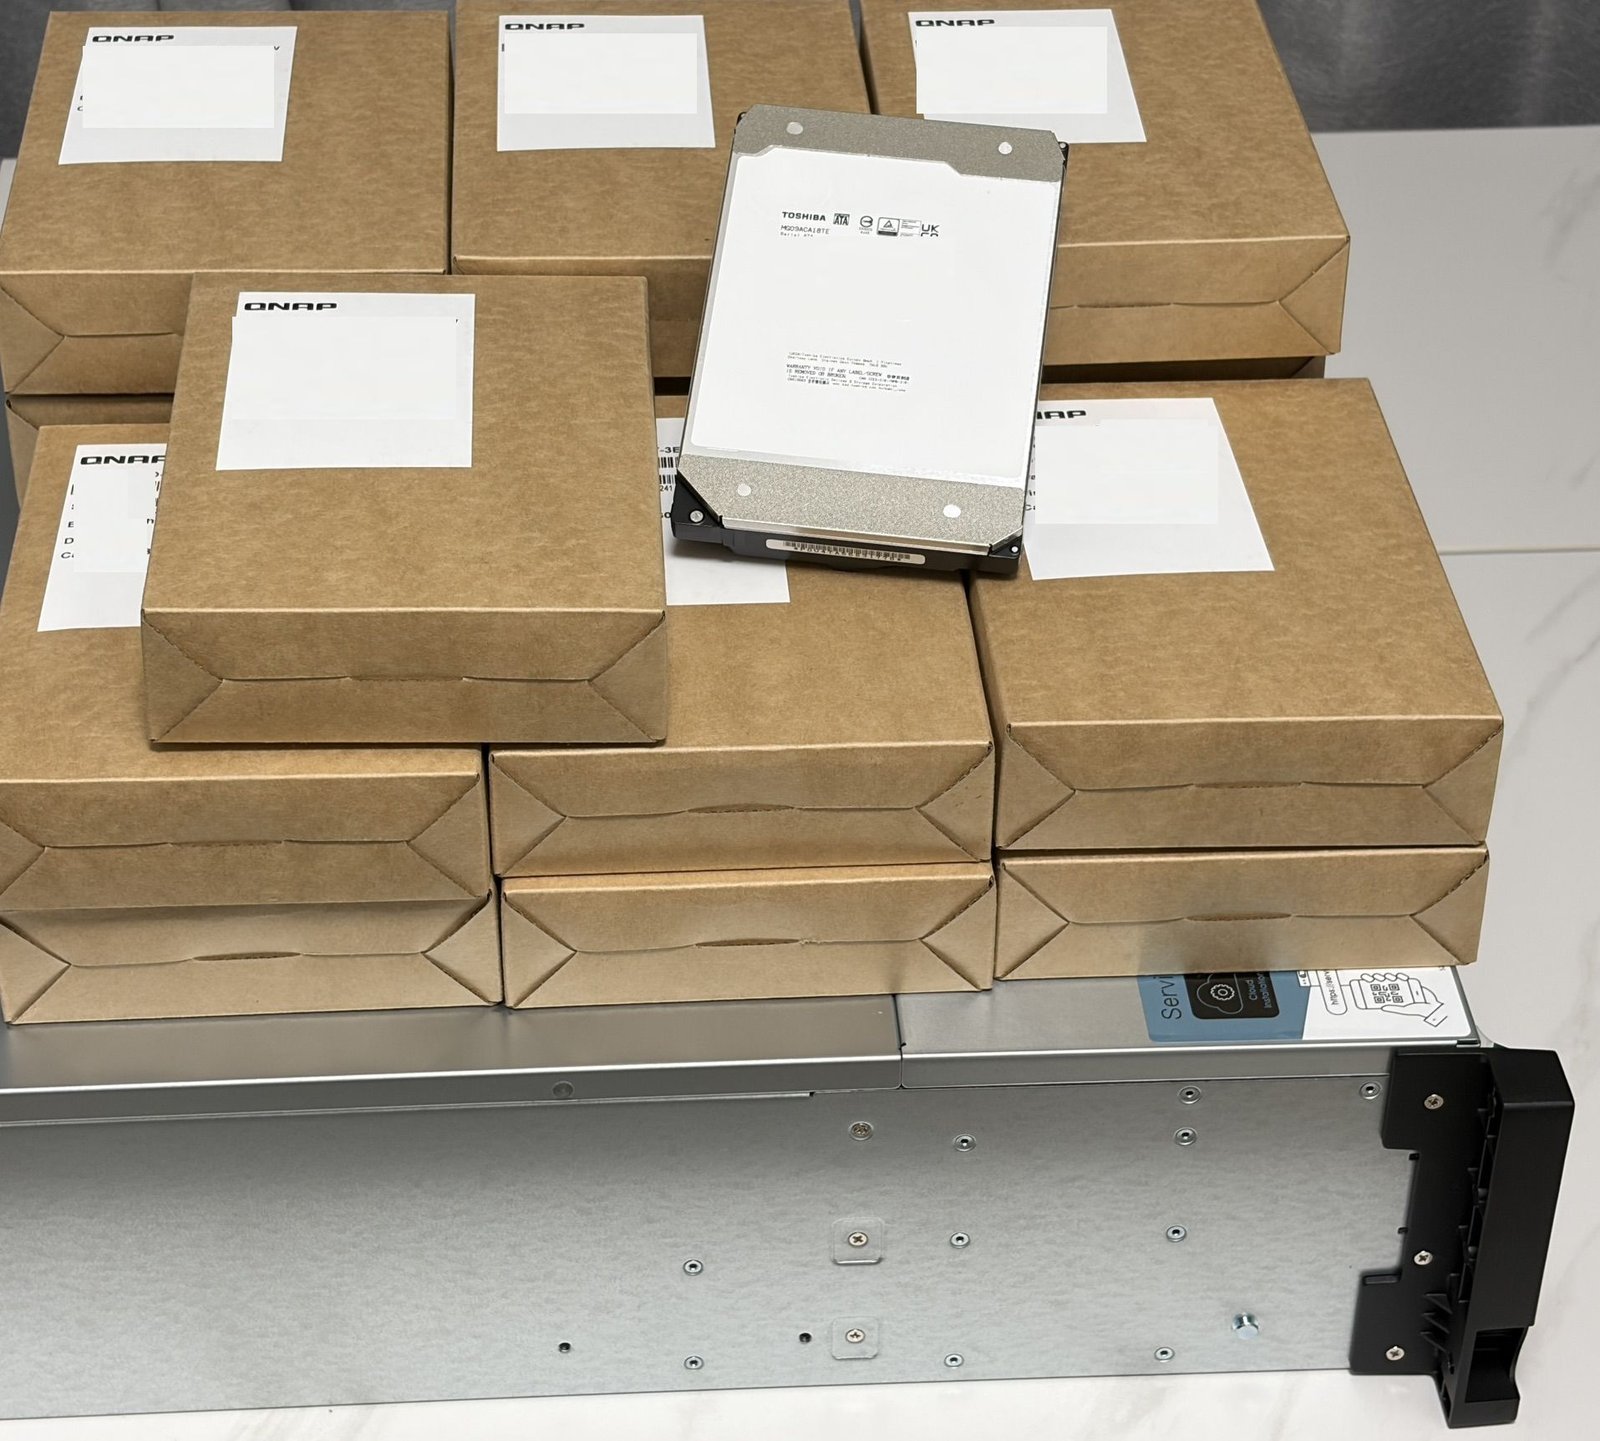
16 盒 Toshiba MG09ACA18TE 18TB 企業級硬碟,準備一次裝滿。
TS-h1677AXU-RP 的硬碟托盤需要以螺絲固定 3.5 吋硬碟,16 顆一次裝完需要一點耐心,但固定得扎實,也有助於降低多顆硬碟同時運轉時的共振。
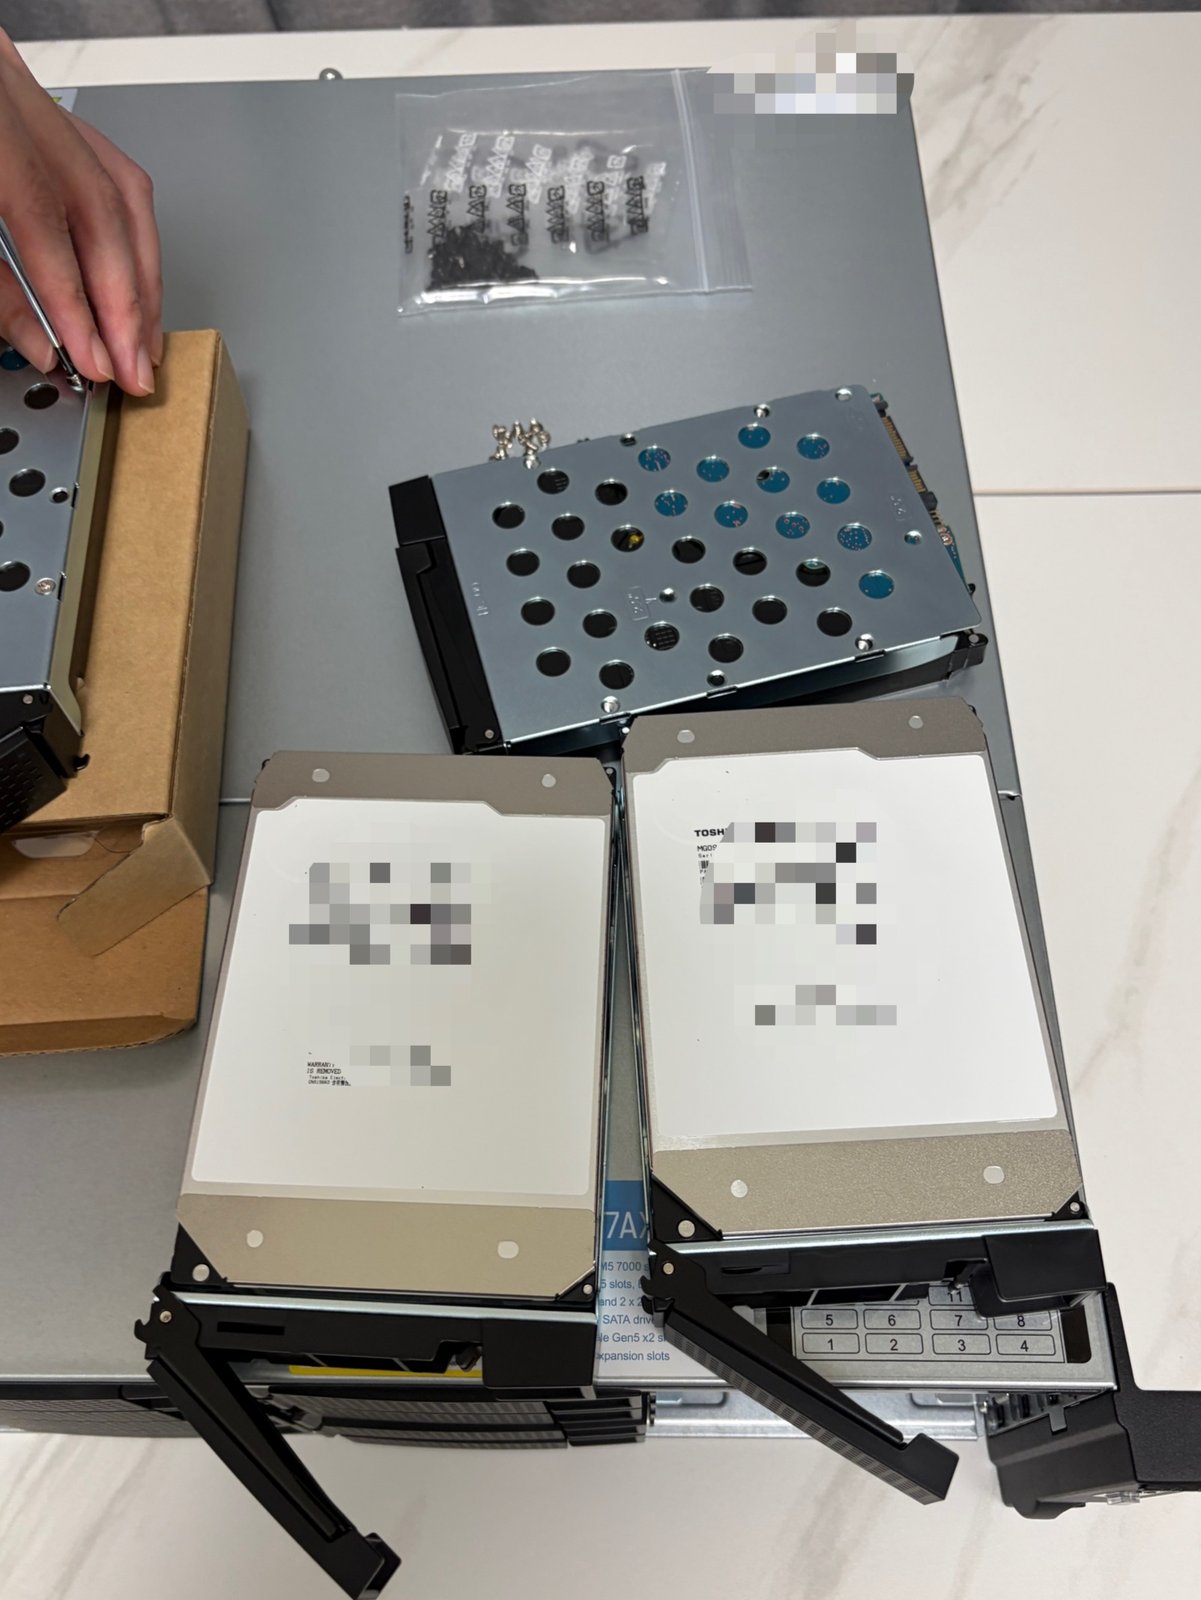
將硬碟以螺絲鎖上托盤,配件包內附足量的螺絲。
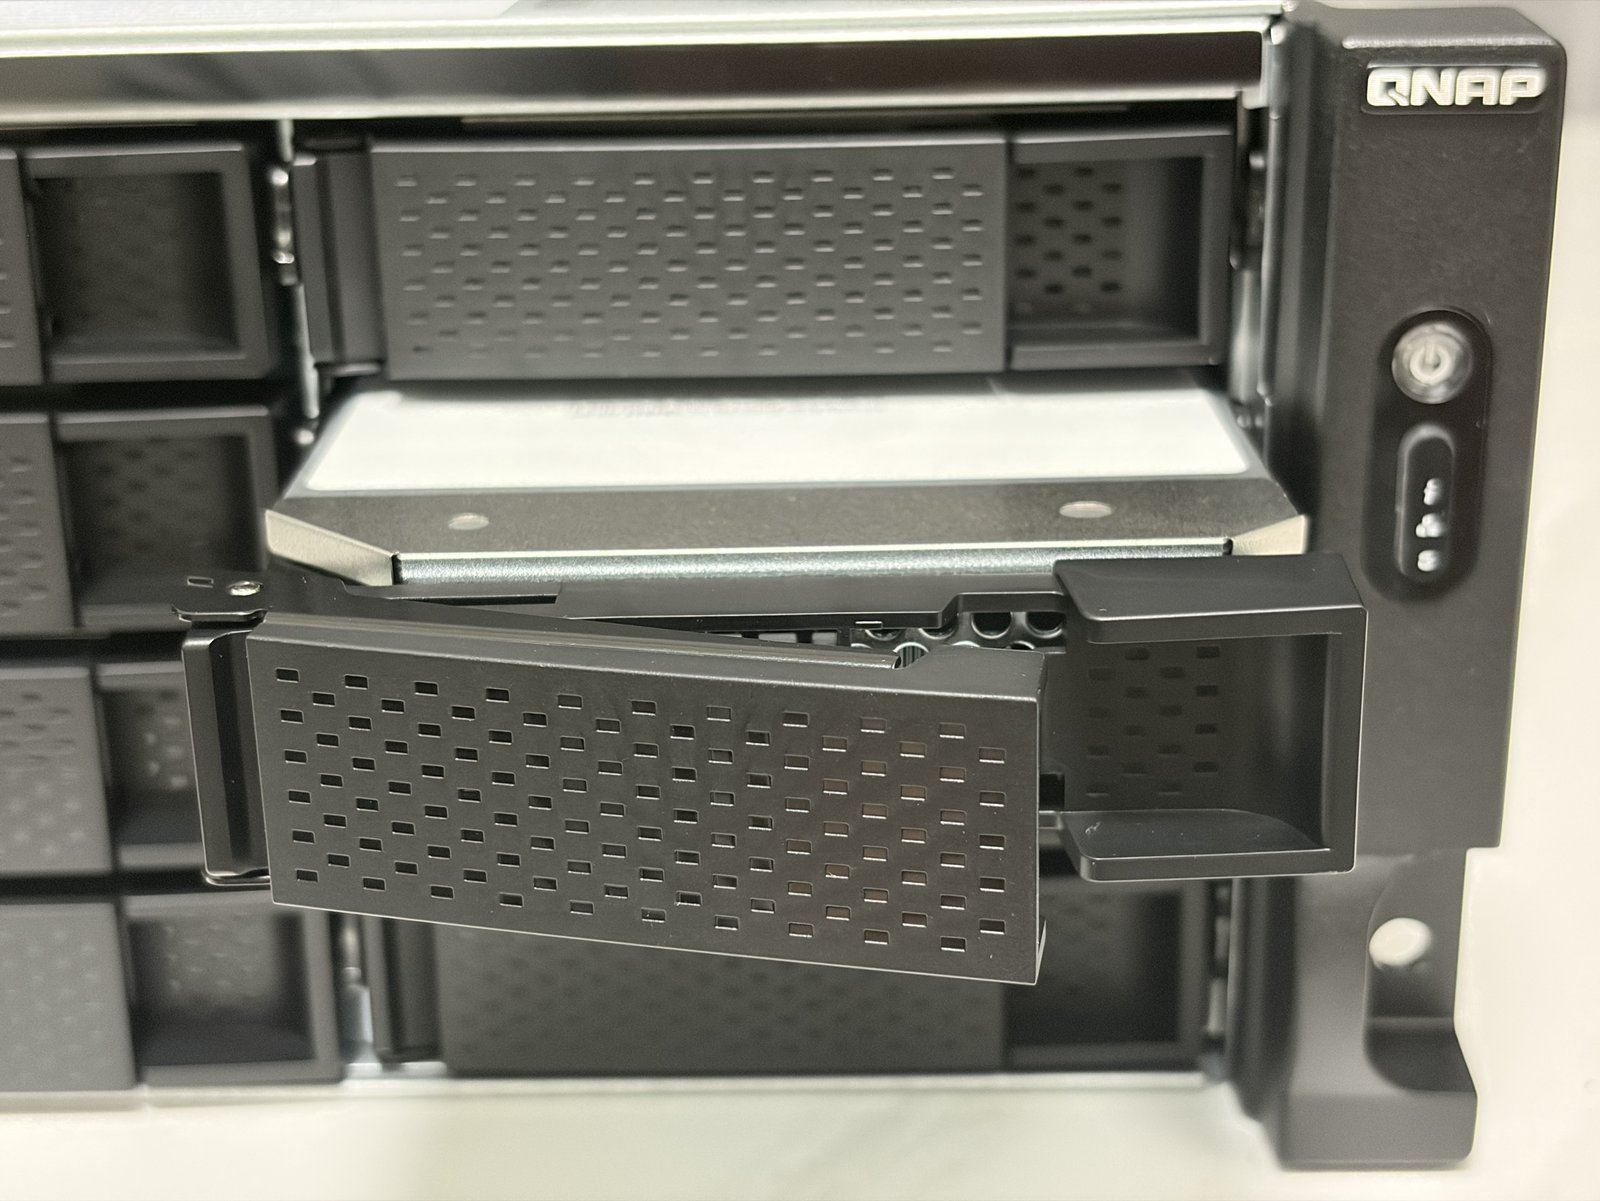
托盤以前端把手推入後扣上,正面燈號區在機身右側。
建立儲存池:為什麼選 RAID 60
硬碟裝好開機後,儲存空間總管可以看到 16 顆 SATA 硬碟全部狀態正常。首次開機時 CPU 溫度 46°C、系統溫度 31°C。
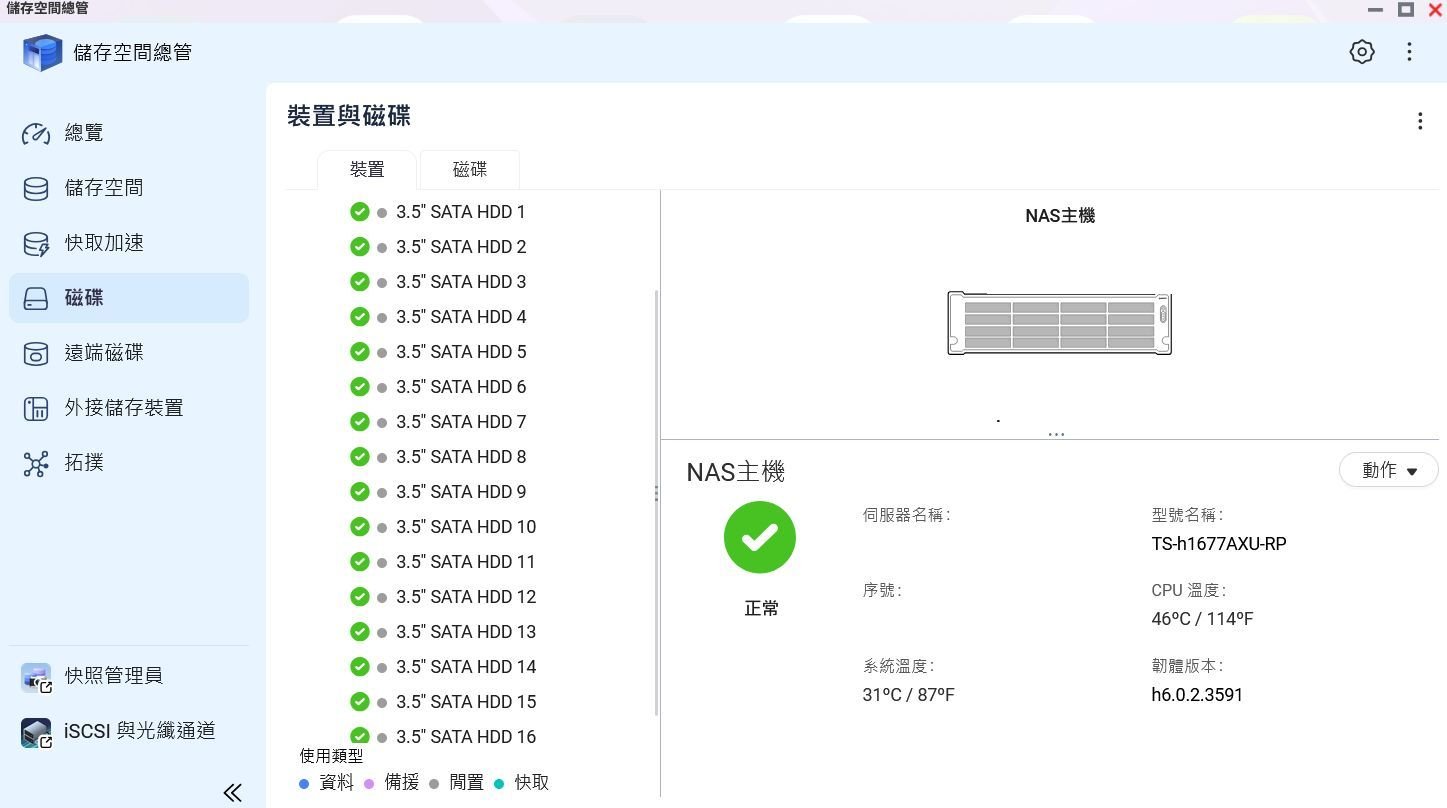
儲存空間總管的裝置與磁碟頁,16 顆 3.5 吋 SATA 硬碟全數正常。
建立儲存池時,CyberQ 選擇 RAID 60,子群組數量 2。在 ZFS 的實作上,這等於兩組 8 顆硬碟的 RAIDZ2 條帶在一起。
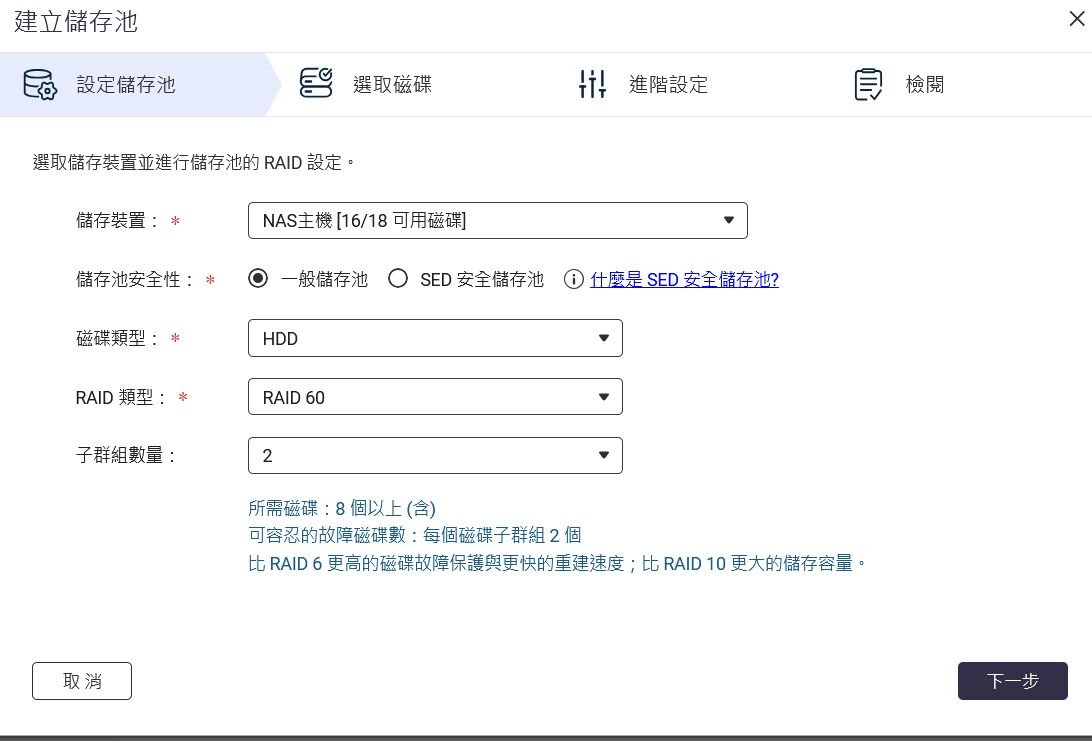
建立儲存池精靈:RAID 60、子群組數量 2,每個子群組可容忍 2 顆硬碟故障。
選擇 RAID 60 而不是單一組 16 顆的 RAID 6,理由有三:
容錯更強:每個子群組各自可容忍 2 顆硬碟故障,最多可同時損失 4 顆(每組 2 顆)。
重建更快、風險更低:18TB 硬碟重建時間很長,重建只牽涉故障所在的 8 顆硬碟,而不是全部 16 顆,重建期間的效能衝擊與二次故障風險都比較小。
效能較好:兩組 vdev 條帶寫入,隨機 I/O 能力大約是單一 vdev 的兩倍。
代價是容量會變少,每組 8 顆中有 2 顆的空間給同位元資料,16 顆裡有 12 顆的容量可用,空間使用率 75%。精靈預估可用容量為 188 TB。
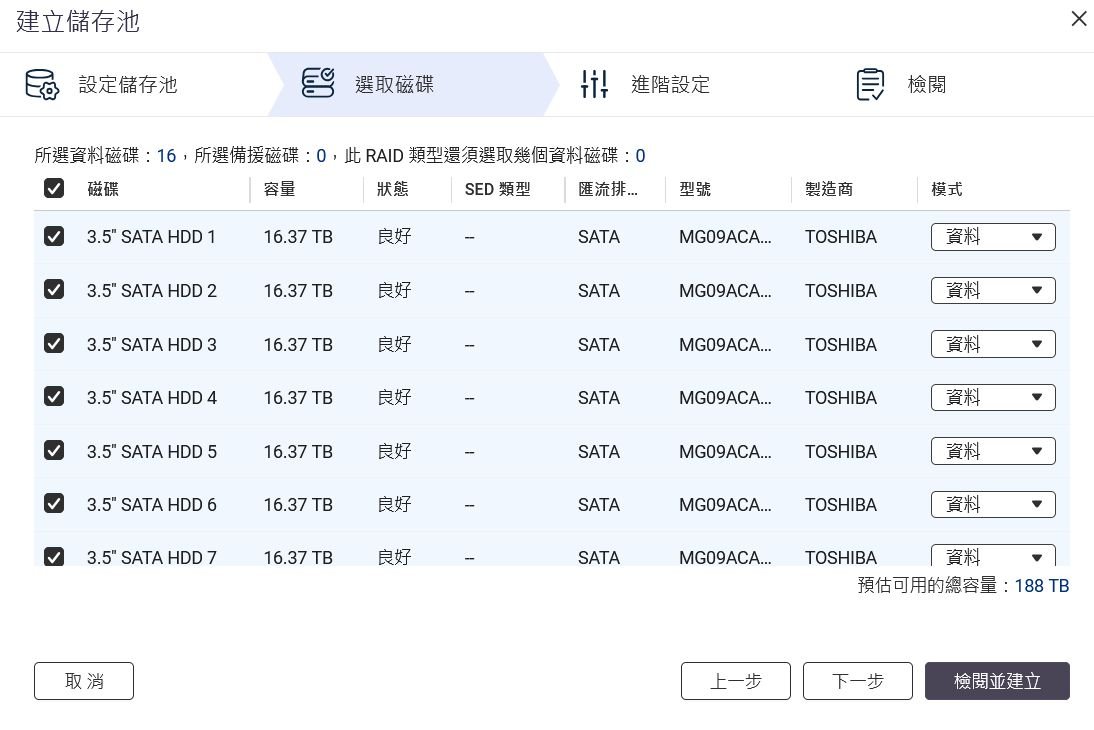
16 顆硬碟全選為資料碟,每顆顯示 16.37 TB,預估可用總容量 188 TB。
這裡的數字先幫大家換算與說明一下,18TB 硬碟以二進位計算約為 16.37 TiB,16 顆原始容量約 261.9 TiB,扣除同位元後 12 顆約 196.4 TiB,再扣除 ZFS 本身的中繼資料與配置開銷,就是介面上的 188.94 TB。
進階設定的部分,保留了預設的 5% 儲存池預留空間(9.4 TB),這是 ZFS 在接近滿載時維持效能與避免寫入失敗的安全餘量,警示臨界值設在 80%。QSAL 是給 SSD 陣列避免同時磨耗到期的功能,純 HDD 儲存池用不到,維持關閉。
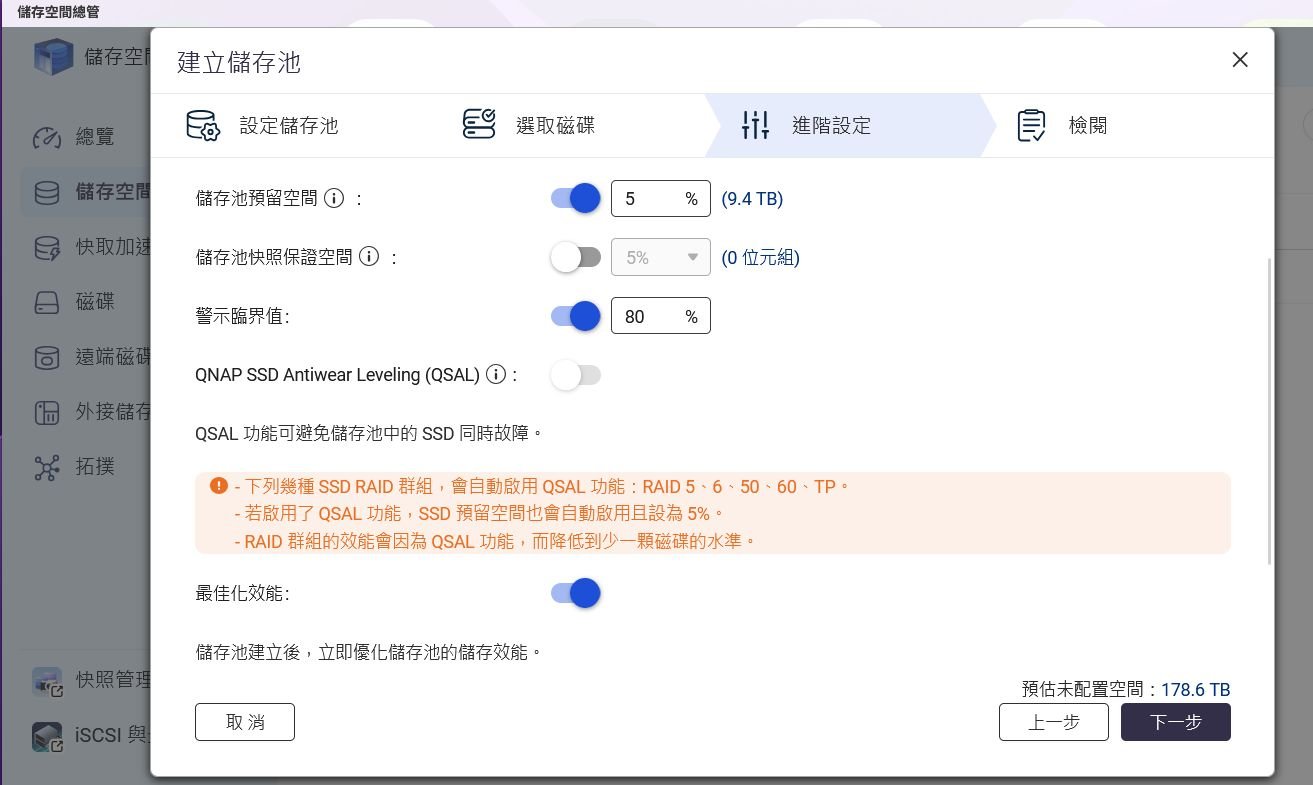
儲存池進階設定:預留空間 5%、快照保證空間關閉、警示臨界值 80%、開啟最佳化效能。
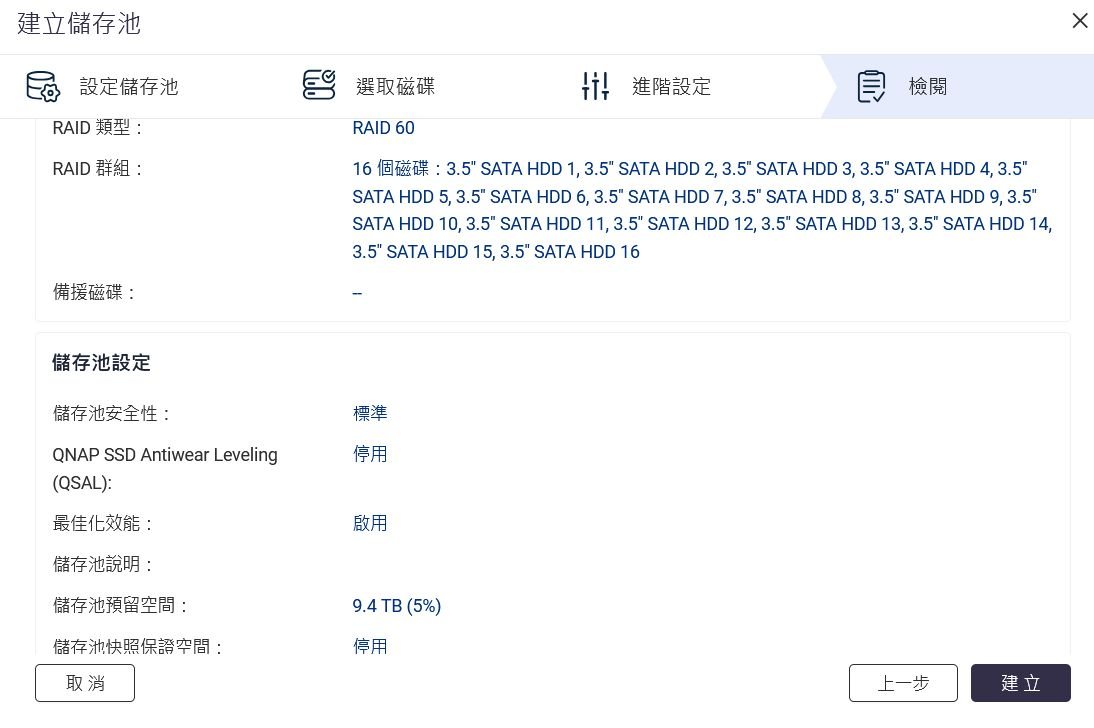
檢閱頁確認 RAID 60 包含全部 16 顆硬碟,沒有備援磁碟。
建立完成後,儲存池會先進入最佳化階段。此時已使用量顯示 10.33 TB,主要就是那 9.4 TB 的預留空間加上中繼資料。
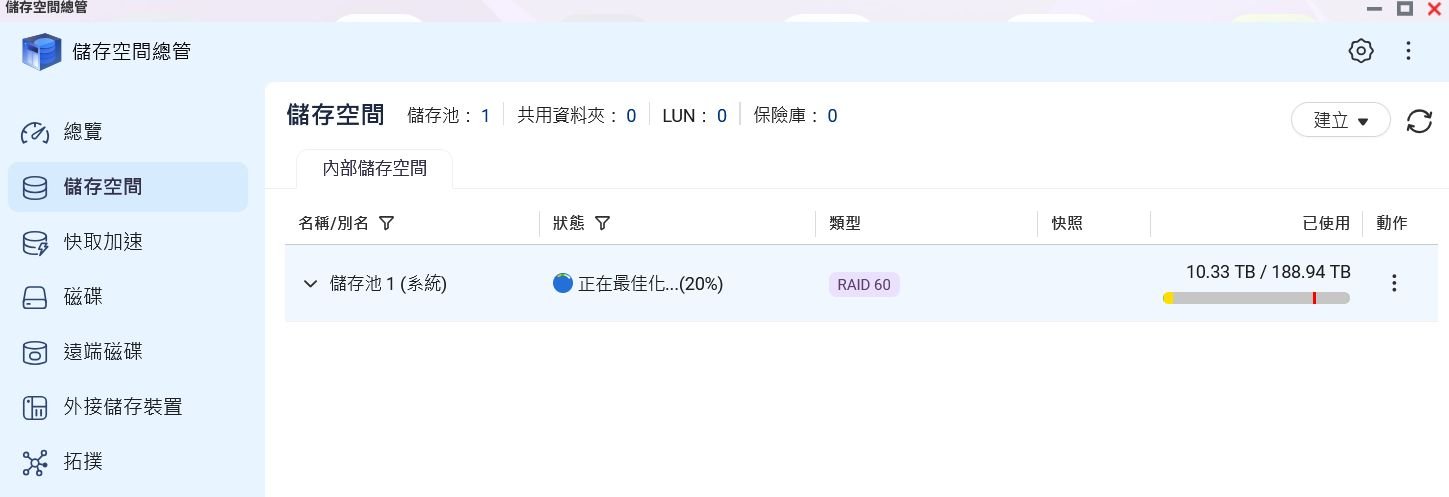
儲存池 1 建立完成,狀態為「正在最佳化(20%)」,容量 188.94 TB。
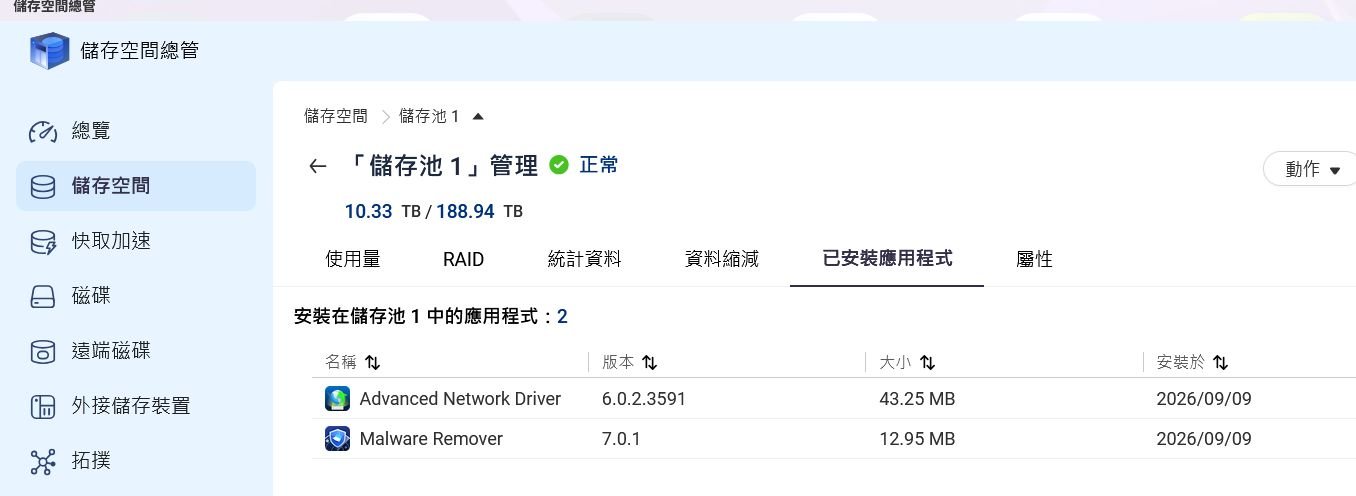
儲存池預設會安裝 Advanced Network Driver 與 Malware Remover 兩個系統應用程式。
共用資料夾:壓縮、區塊大小與 ACL 2.0
進入共用資料夾設定時,QuTS hero 6 會先詢問是否啟用 ACL 2.0。新版 ACL 把單一資料夾可設定的存取控制項目從 124 個提高到 1,020 個,對大型組織的權限管理比較有彈性。這是全新建置的機器,沒有相容性包袱,直接採用 ACL 2.0。要注意的是 ACL 2.0 升級後無法回復,既有環境升級前應先建立快照。
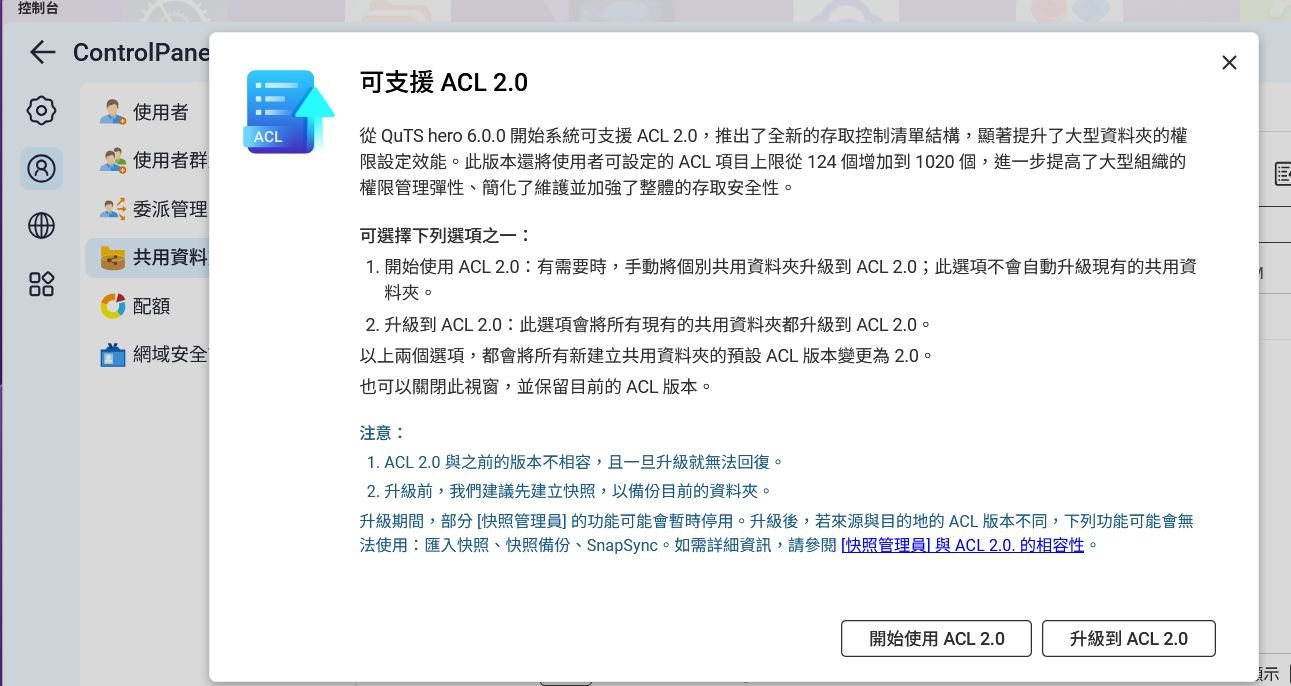
QuTS hero 6.0 起支援 ACL 2.0,升級後無法回復舊版。
我們建立名為 data 的共用資料夾,採用精簡配置並設定 160 TB 配額。保留約 18 TB 的差距,是為了讓儲存池永遠不會被單一資料夾寫滿。
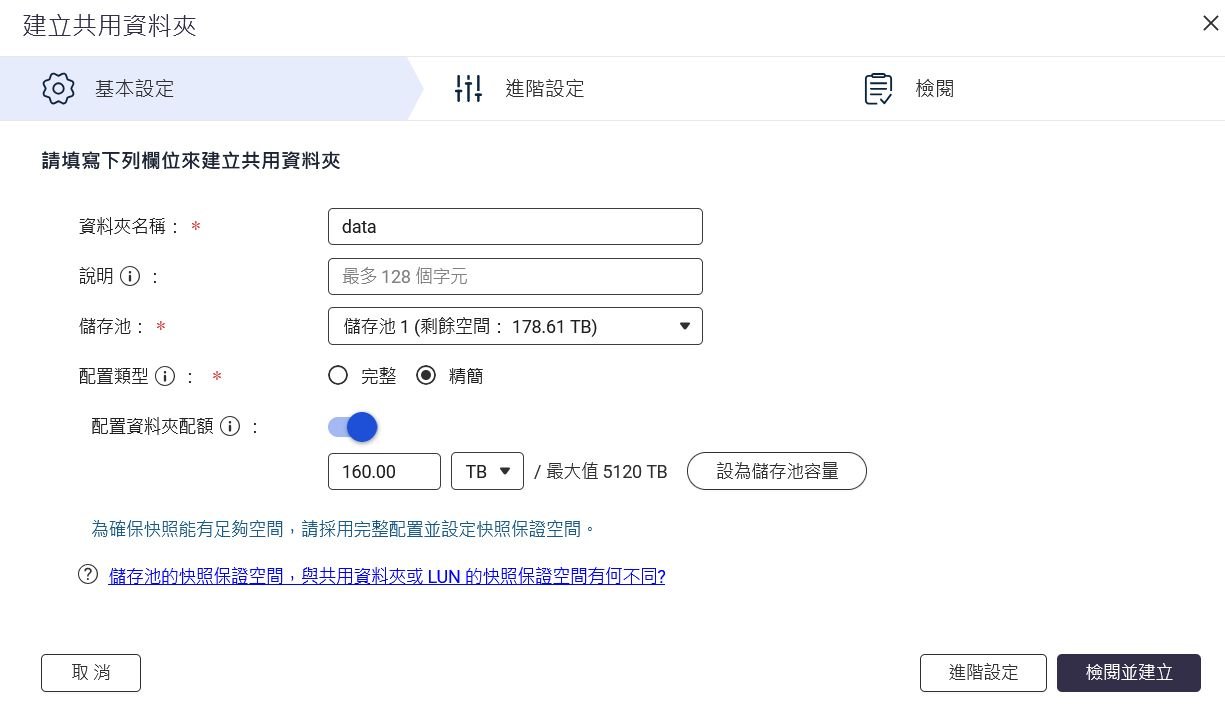
建立共用資料夾 data:精簡配置,配額 160 TB,儲存池剩餘空間 178.61 TB。
儲存空間設定的選擇如下:
壓縮開啟
ZFS 的 lz4 壓縮對不可壓縮資料幾乎沒有成本,對 JSON 這類文字資料則可能有可觀的壓縮率。
重複資料刪除關閉
重複資料刪除需要大量記憶體維護對照表,32 GB 記憶體面對 160 TB 的資料量並不適合,冷資料也很少有區塊層級的重複。
SSD 讀取快取關閉
本機沒有安裝 SSD 快取裝置。
區塊大小 128K
選「影片編輯/大型檔案/備份」設定檔。
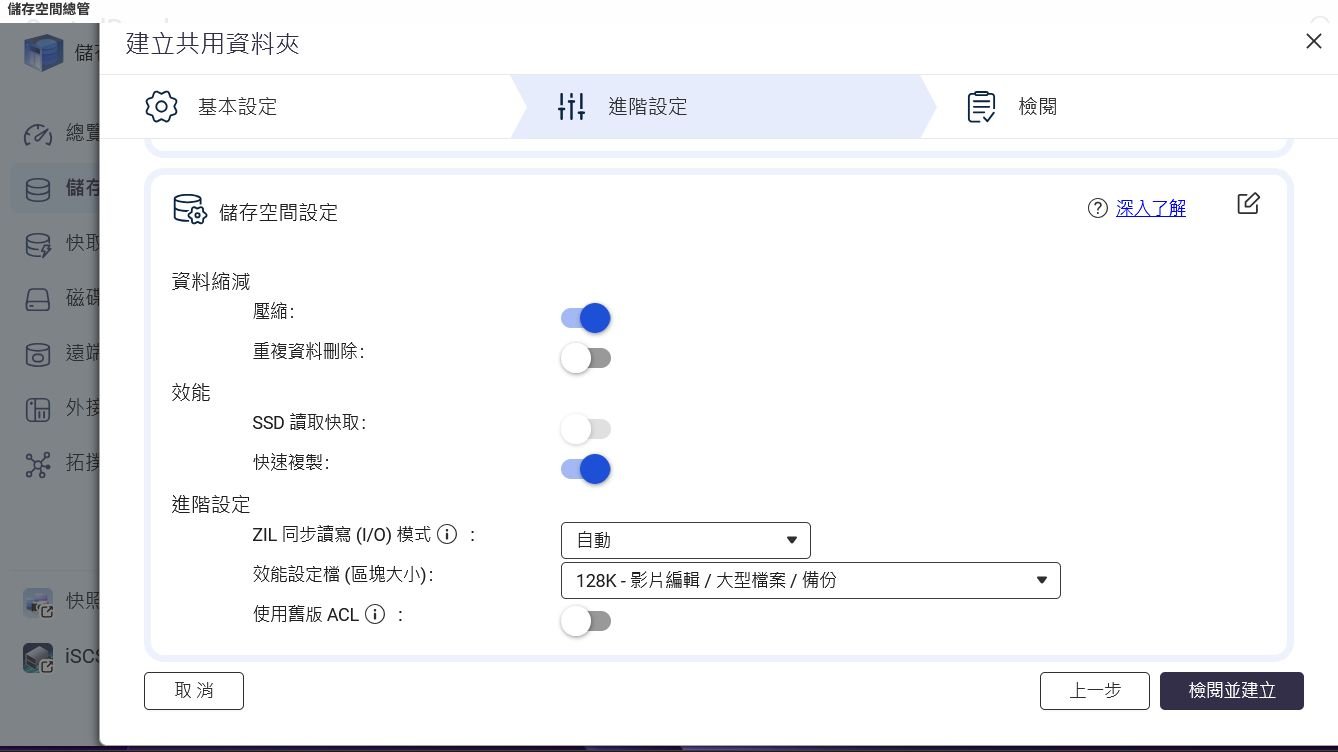
儲存空間設定:開啟壓縮與快速複製,關閉重複資料刪除與 SSD 讀取快取,ZIL 同步模式為自動。
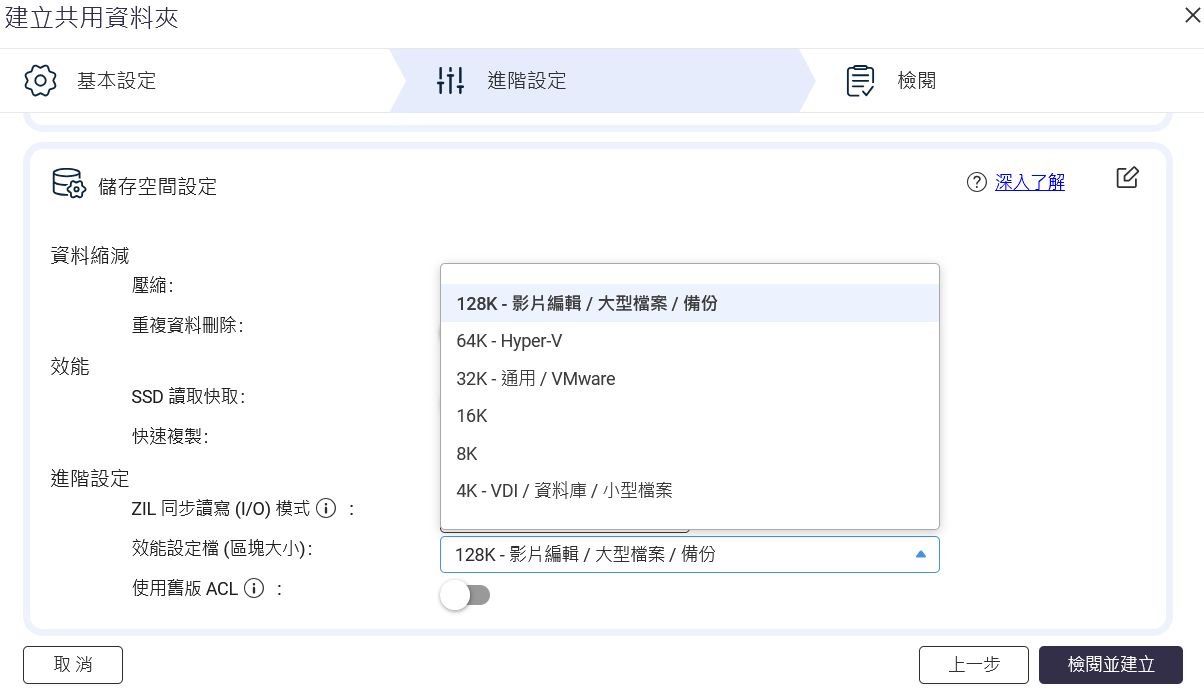
效能設定檔的區塊大小選項,最大就是 128K。
關於區塊大小,128K 是介面上能選的最大值。對 10 MB 的 JSON 檔來說,128K 會把每個檔案切成 80 個記錄,若能用 1M 只需要 10 個。這次有嘗試從命令列修改 recordsize,但系統回覆 property setting is not allowed on bootable datasets,建立子 dataset 也被拒絕。這是目前 QuTS hero 的設計限制,我們已列入向 QNAP 反映的清單。
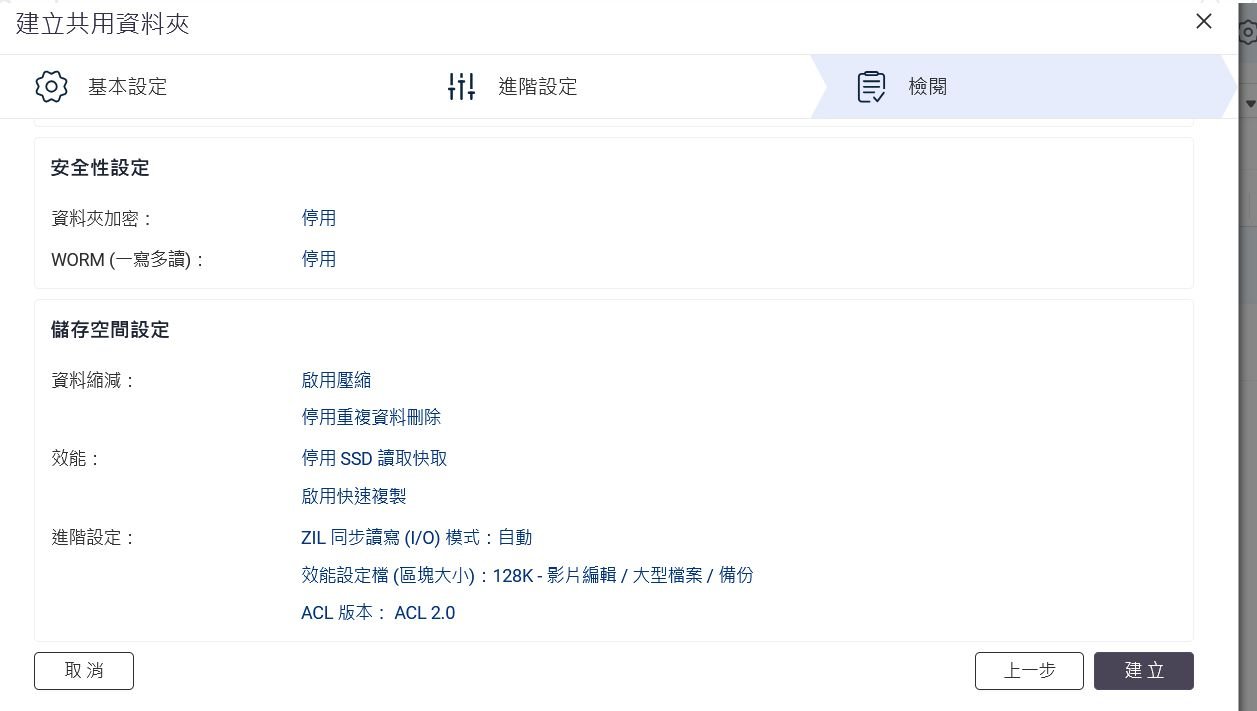
共用資料夾檢閱頁:不加密、不啟用 WORM,壓縮開啟,區塊大小 128K,ACL 2.0。
NFS 設定:只開 NFSv4.1,並啟用 RDMA 選項
B200 節點都是 Linux,因此採用 NFS 提供存取。在控制台的 Linux NFS 服務中,我們只勾選 NFSv4.1,關閉 NFSv2、v3 與 v4.0。NFSv4.1 只需要單一 TCP 2049 埠,防火牆規則最單純,也不需要設定 NFSv3 那一整組固定服務埠,同時 4.1 也支援 session trunking 等較新的功能。
我們也勾選了「啟用 NFS over RDMA」,這在 B200 節點端是可掛載上的。
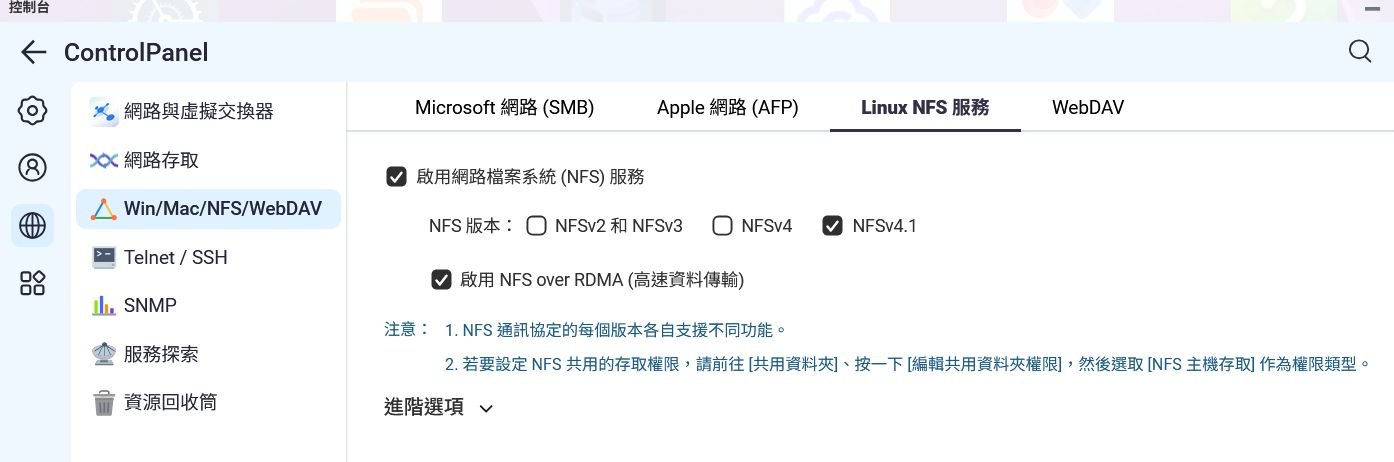
Linux NFS 服務只啟用 NFSv4.1,並勾選 NFS over RDMA。
在共用資料夾的 NFS 主機存取權限中,我們設定為讀寫、「不作 Squash」,並開啟 sync(搭配 wdelay)。GPU 節點上的訓練容器常以 root 身分執行,不作 Squash 可以避免寫入的檔案被對應成匿名使用者而產生權限問題。但這也代表允許存取的主機清單建議是限制在叢集所在的儲存網段,不開放整個內網去存取它。
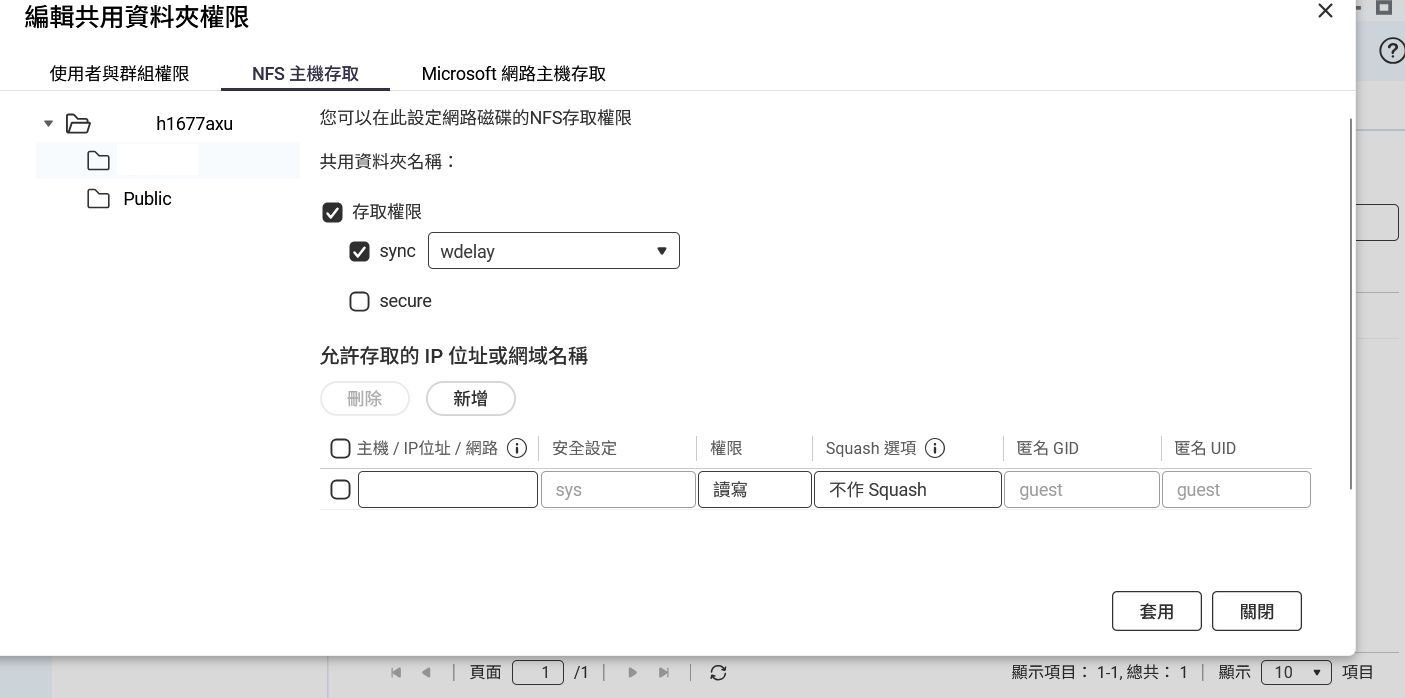
NFS 主機存取權限:讀寫、不作 Squash、開啟 sync,允許清單只填入叢集的儲存網段。
網路採用兩埠 25GbE 做 802.3ad 聚合
網路介面清單中可以看到兩個內建的 10GbE(Adapter 3、4)與加裝網卡的兩個 25GbE(Adapter 5、6),也就是連 25GbE 的光纖線或 AOC 線材。
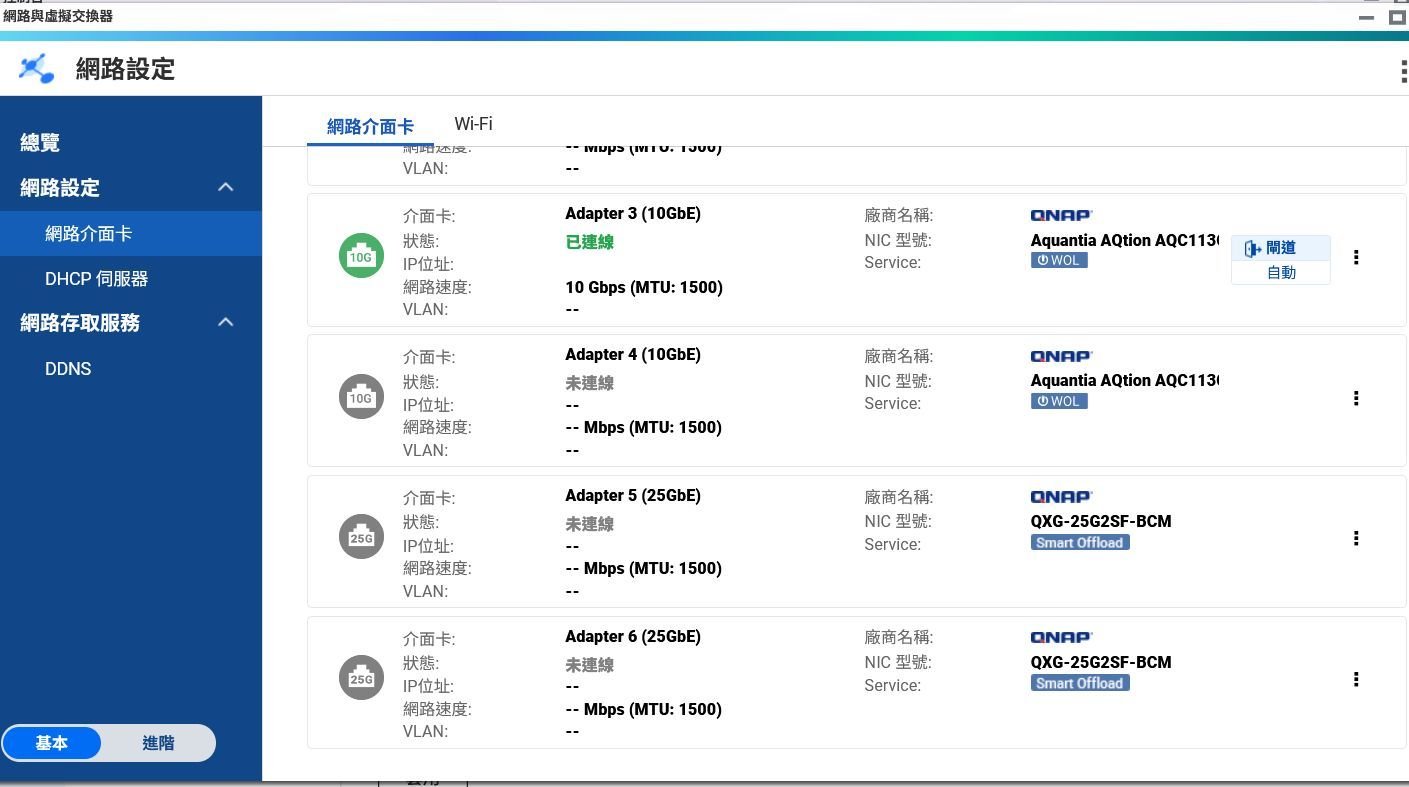
網路介面卡:Adapter 3、4 是內建 10GbE,Adapter 5、6 是加裝的 QXG-25G2SF-BCM 25GbE。
將 Adapter 5 與 6 設為 Port Trunking,交換器類型選網管型交換器,模式選 802.3ad dynamic(LACP),雜湊規則選 Layer 2+3(MAC+IP),完成後聚合頻寬顯示為 50 Gbps。
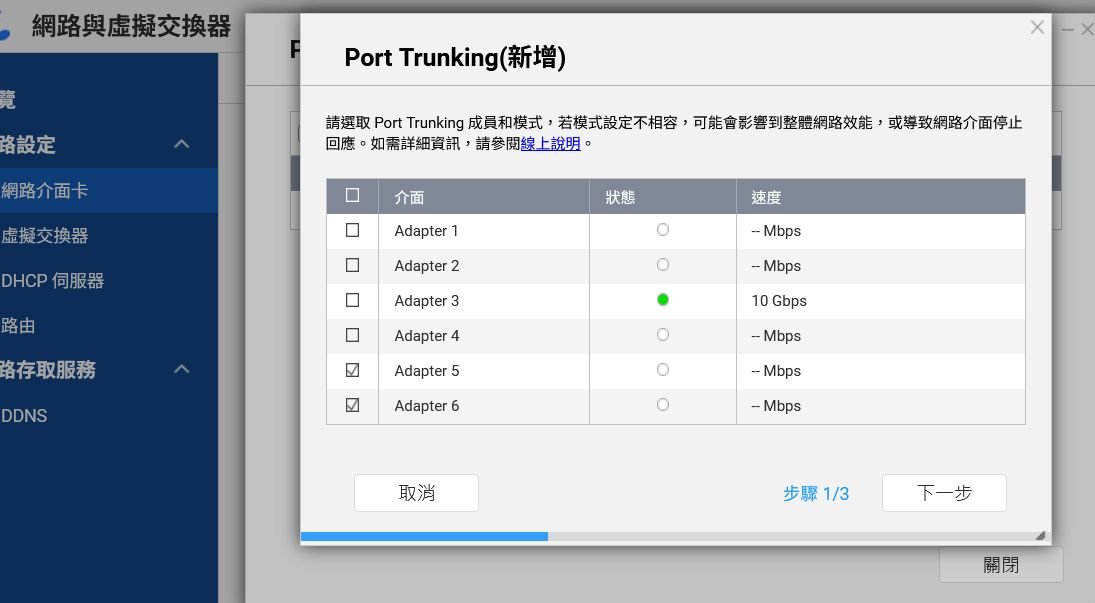
Port Trunking 選取 Adapter 5 與 Adapter 6。
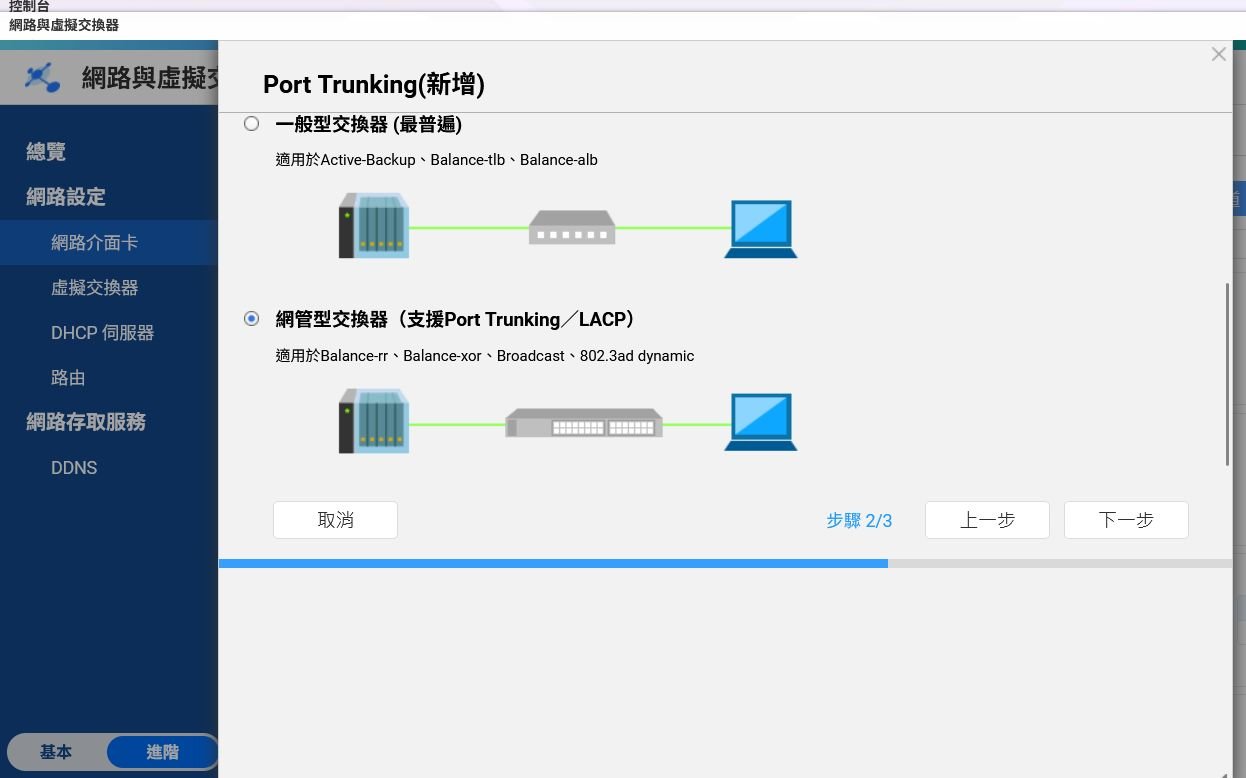
選擇網管型交換器,才能使用 802.3ad 等需要交換器配合的模式。
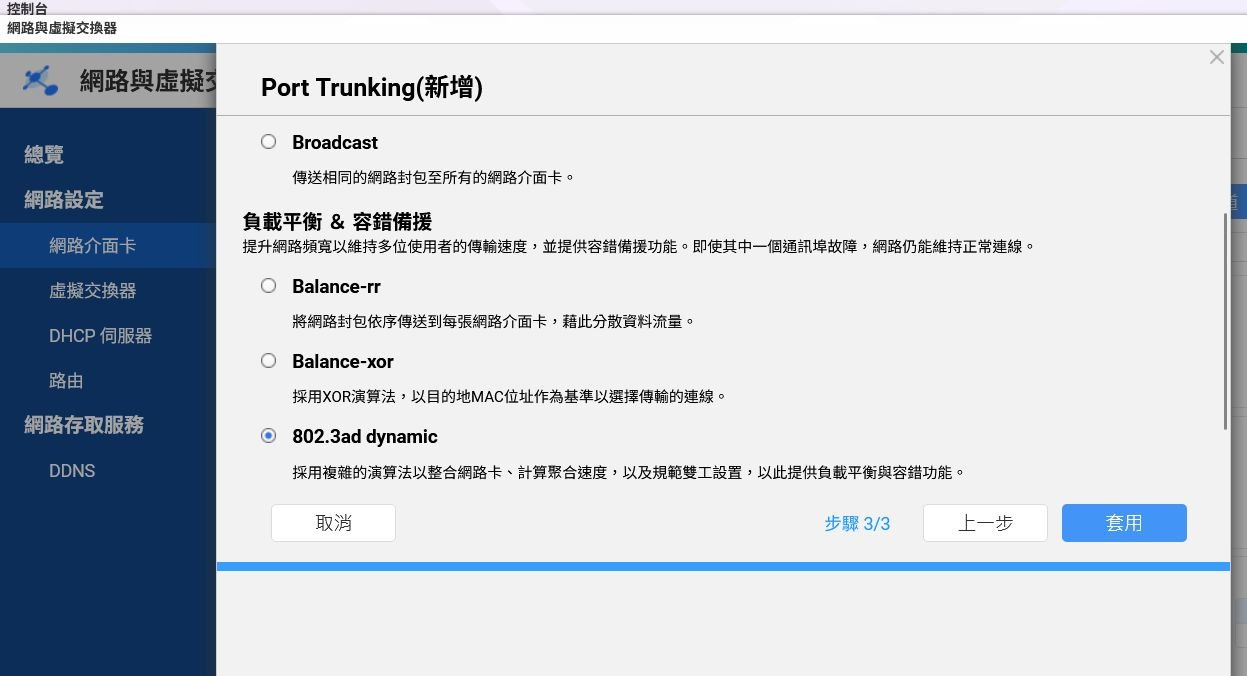
模式選擇 802.3ad dynamic,同時提供負載平衡與容錯備援。
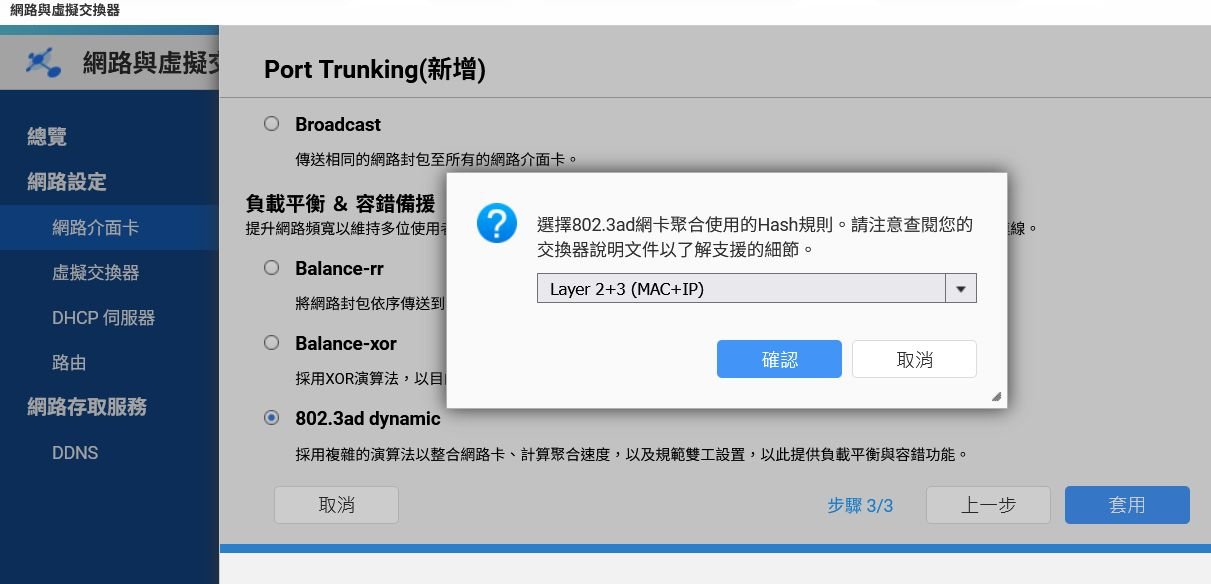
802.3ad 的雜湊規則選 Layer 2+3(MAC+IP)。
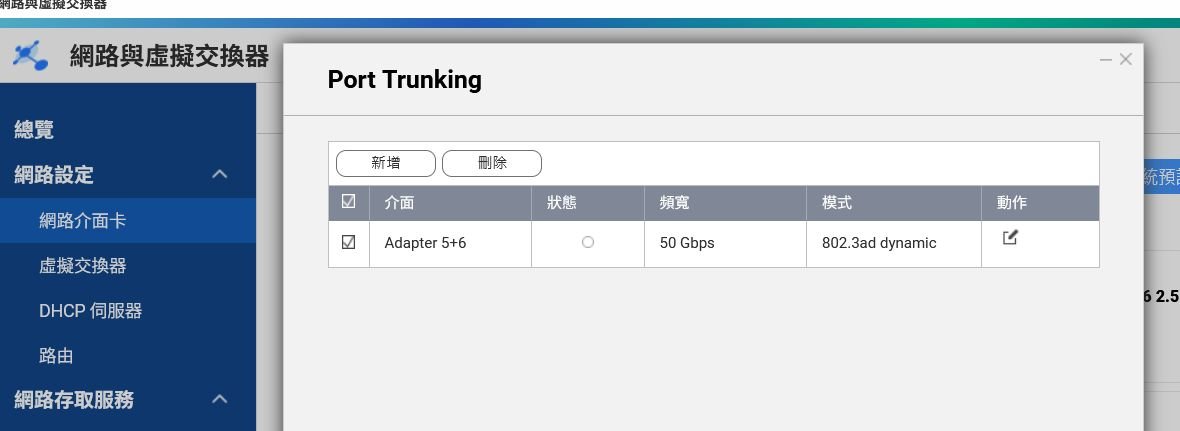
聚合完成,Adapter 5+6 頻寬 50 Gbps,模式 802.3ad dynamic。
聚合介面設定固定 IP,並開啟 9000 的巨型封包(Jumbo Frame)。對大檔循序傳輸而言,MTU 9000 能明顯降低封包處理的負擔,前提是交換器與所有 B200 節點的儲存網卡都要設成相同的 MTU,否則會出現難以追查的斷續問題。
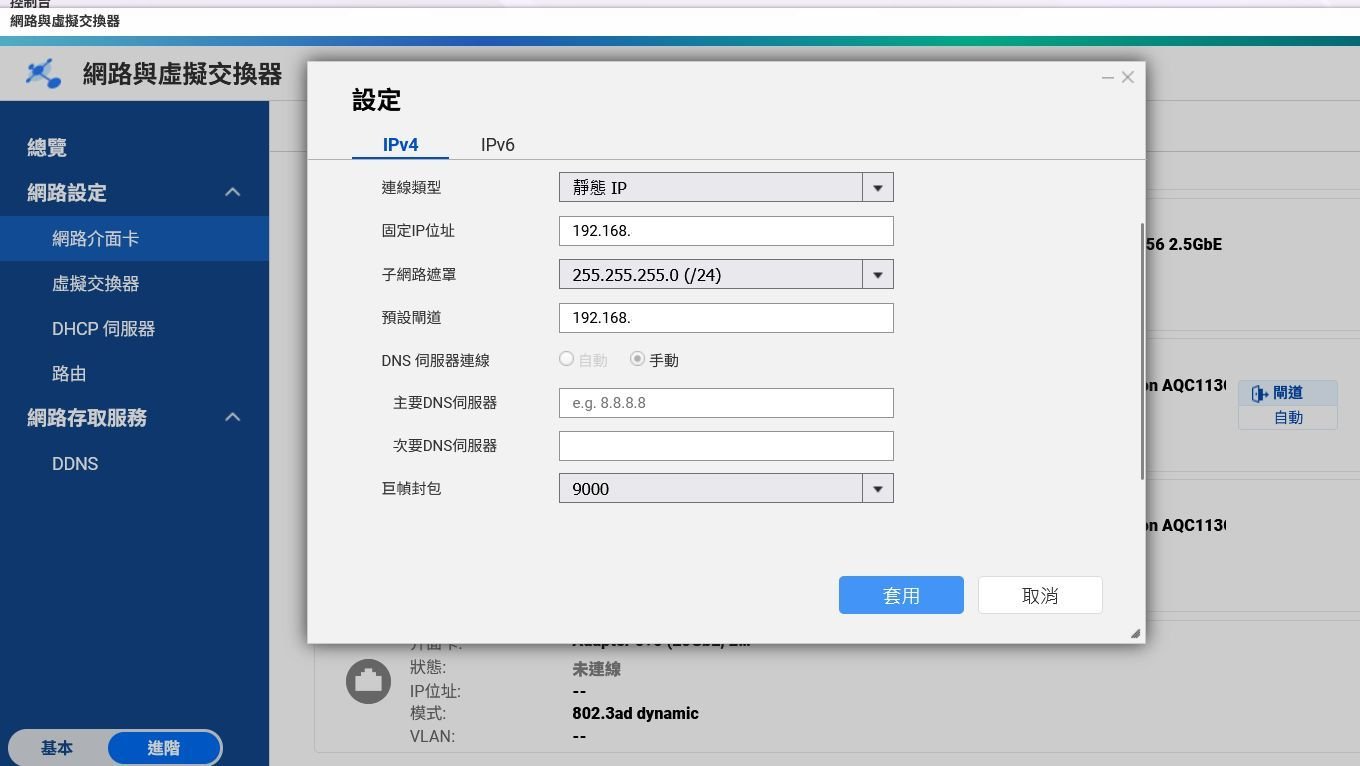
聚合介面設定固定 IP 與 9000 巨型封包。
關於聚合,有三件事稍微說明一下:
50 Gbps 是總頻寬,不是單一連線的頻寬
Layer 2+3 雜湊以來源與目的位址決定走哪一條鏈路,因此單一 B200 節點對 NAS 的流量只會走其中一條 25GbE。多台節點同時寫入時,流量才會分散到兩條。
跨兩台交換器的 LACP 需要交換器端支援 MLAG
如果兩個 25GbE 埠分別接到兩台 NVIDIA 交換器,交換器那一側要設定成 MLAG,NAS 才能把它們視為同一個 LACP 夥伴,若兩埠都接在同一台交換器上,則沒有這個需求,但也少了交換器層級的備援。
管理用的 10GbE 仍是 MTU 1500
管理網路維持預設,但做效能測試時要確認流量確實走在 25GbE 的聚合介面上。
開機後的健康狀態
完成初始設定後,系統在閒置狀態下 CPU 平均使用率 8.3%,記憶體使用 7.93 GB/30.47 GB(26%)。系統溫度 33°C,三顆系統風扇分別在 4,445、4,482 與 3,247 RPM。
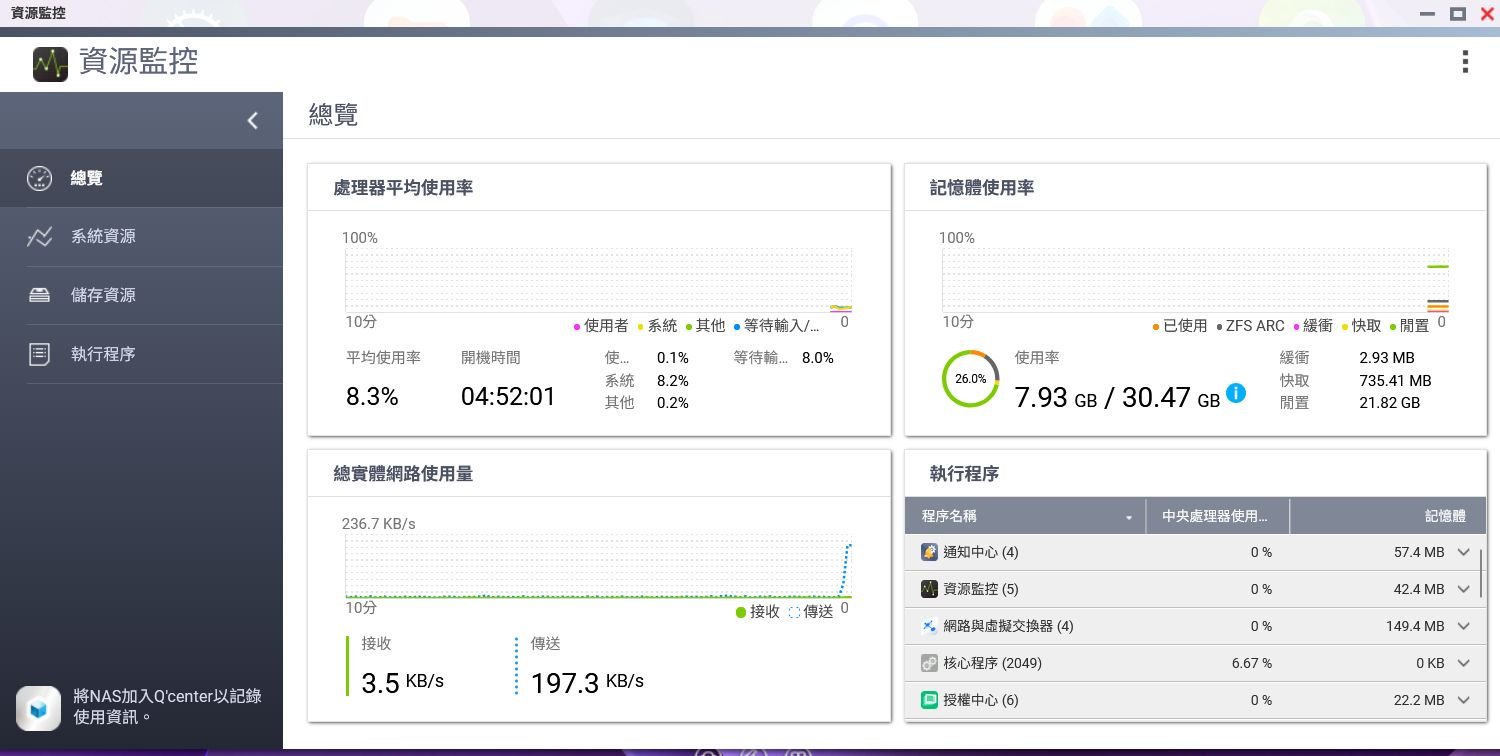
資源監控總覽:開機 4 小時 52 分,CPU 8.3%、記憶體使用率 26%。
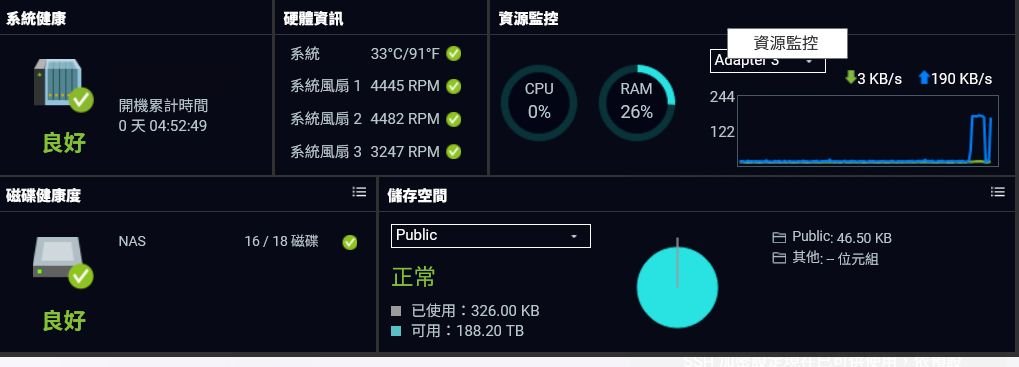
儀表板:系統健康良好,16 顆硬碟全數正常,Public 資料夾可用空間 188.20 TB。
效能實測
實測用的 dataset 設定為 compression=on、checksum=on(fletcher4)、recordsize=128K、sync=standard。本機沒有 special vdev、SLOG 與 L2ARC,是純 HDD 的儲存池,測試跑出 3,370 MB/s。
五輪寫入結果
參數為 bs=1M、iodepth=1、direct=0、end_fsync=1、4 個執行緒、每個檔案 10 MB,模擬 B200 叢集寫入 10 MB JSON 的情境。
| 輪次 | 寫入總量 | 檔案數 | fio 緩衝設定 | 儲存池狀態 | 耗時 | 結果 |
|---|---|---|---|---|---|---|
| 1 | 80 GiB | 8,000 | 可壓縮 75% | 空池 | 23.7 秒 | 3,370 MB/s |
| 2 | 80 GiB | 8,000 | 可壓縮 75% | 已有 80 GB | 24.4 秒 | 3,277 MB/s |
| 3 | 80 GiB | 8,000 | 可壓縮 75% | 剛刪除 160 GB | 24.0 秒 | 3,329 MB/s |
| 4 | 80 GiB | 8,000 | 可壓縮 0% | 已有資料 | 36.2 秒 | 2,208 MB/s |
| 5 | 240 GiB | 24,000 | 可壓縮 75% | 續寫 | 74.1 秒 | 3,241 MB/s |
第 5 輪連續寫入 240 GiB、持續 74 秒,結果與 24 秒的短輪次一致,確認沒有短時間的快取效應。第 3 輪則證明一次刪除大量資料之後,不會立即造成效能衰退。
所有測試寫完之後,用 zfs list 檢查實際壓縮率,used 與 logicalused 同為 313G,壓縮率 1.00x。也就是說,fio 以 buffer_compress_percentage=75 產生的合成資料,lz4 實際上壓不動,因為合成資料的特性沒辦法再壓縮了,但是真實場景的資料是可以壓縮的。
所以上表的每一輪,包括標示可壓縮 75% 的那些,這些測試到的都是不可壓縮資料的寫入能力。這一點很重要,它代表這些數字是保守的下限,真實的 JSON 資料會被壓縮,實際應用情境的吞吐量絕對是更高。
硬碟陣列的基本能力
在不可壓縮的情況下,RAIDZ2 每寫入 6 份資料要多寫 2 份同位元,所以硬碟層的物理流量是使用者吞吐的 1.33 倍。
| 口徑 | 數值 |
|---|---|
| 使用者吞吐(不可壓縮,10 MB 檔,4 執行緒) | 2,208 到 3,370 MB/s |
| 對應的硬碟層物理流量 | 約 2.9 到 4.5 GB/s |
| 持續 74 秒的代表值 | 使用者 3,241 MB/s,硬碟層約 4.3 GB/s |
這個區間落在 16 顆 MG09 組成兩組 RAIDZ2 的合理預期內。以測試來說,60 秒內所有 ZFS 核心執行緒合計只用了 0.36 顆核心,壓縮與校驗和對 Ryzen 7 PRO 7745 來說幾乎沒有負擔。
單顆硬碟的 iostat 尖峰取樣,每秒 1,424 次寫入、149 MB/s,平均佇列深度 3.8,%util 只有 72%。佇列深度一直貼著 ZFS 參數 vdev_async_write_min_active=3 附近,沒有往上限 10 拉高。換句話說,陣列在達到 4.3 GB/s 硬碟層流量時,仍然有未用到的餘裕,應該可以再往上調校。
對 B200 叢集代表什麼 ?
把實測數字放到網路頻寬旁邊比較:
| 連線方式 | 實際可用頻寬 | 與實測寫入吞吐(3.4 GB/s)相比 |
|---|---|---|
| 10GbE 單埠 | 約 1.18 GB/s | 如果用 10GbE網路會是瓶頸,只用到陣列能力的三分之一 |
| 25GbE 單埠 | 約 3.1 GB/s | 大致打平 |
| 25GbE 雙埠聚合 | 約 6.25 GB/s | 有 1.9 到 2.8 倍的餘裕 |
換算成檔案數,10 MB 的 JSON 大約每秒可寫入 220 到 337 個檔,這還是以不可壓縮資料計算的保守值,實際上的每秒可寫入資料量更高不少。
CyberQ 認為:
25GbE 雙埠是合理的選擇
在未壓縮的情境下,單埠 25GbE 就已經與陣列能力打平,真實 JSON 經過壓縮會更快,雙埠就會更有餘裕。如果只用內建的 10GbE,這台 16 顆硬碟的陣列有三分之二的能力會被浪費掉,所以一定要升級網路卡到 25GbE 以上,這是在 AI 時代必要的網路卡與設備投資,採用 100GbE 會更好,可以往上擔任 AI 算力節點的熱資料儲存區。
另外,巨型封包要全線開啟,聚合介面已設 MTU 9000,交換器與 B200 節點端也一致。單一節點最多只會用到一條 25GbE,雙埠的餘裕要在多節點同時寫入時才會發揮出來。
以這次的測試來說,special vdev 的優先順序不高,檔案數量的影響只有 13%,除非未來的檔案遠小於 10 MB,否則不需要為了中繼資料額外投資 SSD。
部署建議
CyberQ 認為,TS-h1677AXU-RP 在這類部署中的表現很符合它的定位,Ryzen 7 PRO 7745 處理 ZFS 的壓縮與校驗和綽綽有餘,16 顆 Toshiba MG09 組成的 RAID 60 在不可壓縮資料下仍有 3.2 GB/s 以上的持續寫入,硬碟層流量達 4.3 GB/s 而且還沒用盡。雙備援電源、3U 機架與 16 個熱插拔硬碟槽,也讓它適合放進 AI 資料中心的機櫃長期運轉。
對 B200 叢集來說,如果這款並非用於餵資料給 GPU 訓練的熱儲存,而是承接大量產出資料的冷資料池,而這正是 HDD 陣列最有成本效益的位置。真正需要注意的,反而是那些在規格表上看不到的細節,比方說網路要用 25GbE 才不會浪費陣列能力,LACP 的單一連線限制與 MLAG 需求要事先規劃,而新建的儲存池,一定要等背景作業結束、用 iostat 確認靜止之後再驗收。
而如果擔任熱資料儲存,就會需要改用 SSD 快取、SSD 陣列,全閃 NAS 機種和儲存設備的必要性就在於此。