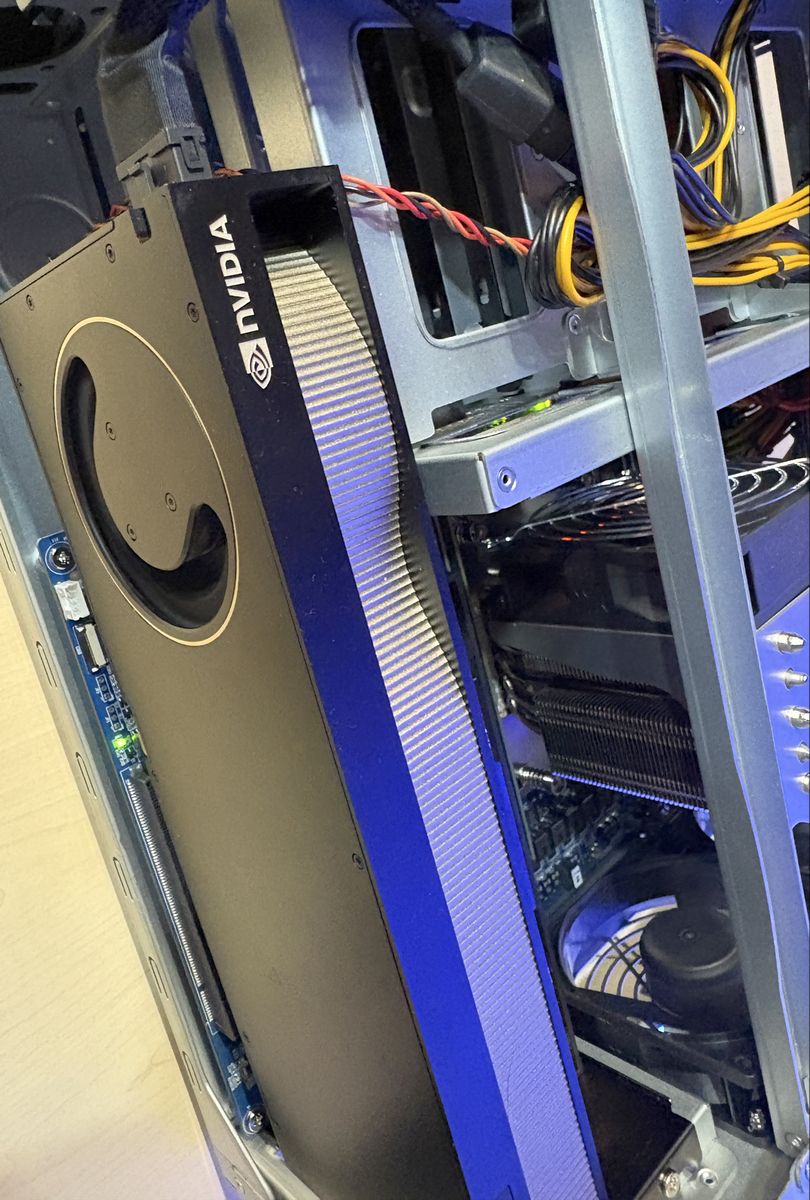
本次實測將焦點鎖定在 sfxnz 釋出的 DeepSeek-V4.1-Flash EXL3 Viterbi 2.0bpw 權重,並於兩台 NVIDIA DGX Spark(GB10)硬體環境下展開測試驗證。評測的核心目標在於檢視其是否具備全面替換既有 Mia 配方版本 DeepSeek-V4.1-Flash 量化模型後端的可行性,涵蓋權重部署效率、推論解碼速度、長文本繁中輸出穩定度,以及雙機硬體資源占用狀況。
CyberQ 實測結果顯示,新設定不僅將過去 Mia 動輒 1 小時的極端載入時間大幅壓縮至 9 分鐘內,單路解碼速度更一舉躍升至 44 tok/s 以上,雙路就更快了。而在處理超過十一萬字的高負載長對話時,依然維持全繁體零亂碼的純淨輸出,展現出其的升級價值。
測試設定
| 項目 | 值 |
|---|---|
| 配方 | sfxnz/DeepSeek-V4.1-Flash-EXL3-vLLM-2x-DGX-Spark @ 3de9146 |
| 權重 | sfxnz/DeepSeek-V4.1-Flash-EXL3 revision 2.0bpw-mcg-viterbi-lmhead-mxfp8,commit 982b704,56 檔、357.5 GB |
| 權重位置 | 兩台本機 ~/.cache/huggingface;engram 兩檔與 ~/dsv41-engram 是 hardlink |
| 映像 | dsv41-flash-exl3-sm121:canonical-e14(sha256:5f7dc2a8…),在 131 建置後以 `docker save |
| 參數 | 上游預設:DSpark k=3、MAX_NUM_SEQS=2、CUDA graph、KV fp8 8 GiB(容量 2,289,205 tokens) |
| 本機設定 | ~/dsv41-exl3/.env.viterbi |
準備過程
下載只抓了 144 GB大小的檔案,需要用到的 engram 兩檔(203 GB)直接 hardlink 機器上既有檔案即可,另外 5 個檔案(約 10 GB)從 NAS 上舊 2.0bpw-mcg 的 blob 複製,並重算 sha256 驗過。
GB10 A 下載約 38 分鐘(約 63 MiB/s),再經 CX7 rsync 到 GB10 B(約 530 MB/s),兩台 56 個檔案的大小都與 Hub 相符。
GB10 B的 ~/.cache/huggingface 原本屬 root(08-23 容器建立,只有 modules),已改名成 ~/.cache/huggingface.root-0823 讓位。
起服務前用 posix_fadvise(DONTNEED) 清掉權重的 page cache(GB10 A 從 102.8 降到 5.5 GiB,GB10 B從 114.3 降到 1.7 GiB),NCCL 一次就通過。
啟動稽核 audit ok: every expected patch engaged on head, worker,日誌裡 py-cpuinfo 在 aarch64 的 JSONDecodeError 不影響服務。
測試結果
sfxnz 可以取代 Mia 當 hermes 後端
它的單路 decode 約 44 tok/s,Mia 是 26 tok/s,32K prefill 約 809 tok/s,載入約 9 分鐘,Mia 要 60 分鐘。
合成長對話沒有亂碼
模擬 hermes 的長度,system 2.5 萬字,對話 6 萬、9 萬、11.7 萬字,共 12 次,輸出的簡體字都是 0,也沒有夾雜其他文字系統或重複片段。
開思考模式時,模型的內部推理是用簡體中文寫的,最後的答案仍是繁中。hermes 走伺服器預設(不思考),不受影響。
Decode(500 字繁中短文,每格 3 次)
| 溫度 | 併發 | 每路 tok/s | 合計 tok/s |
|---|---|---|---|
| 0 | 1 | 41.3 / 44.0 / 44.9 | 40.3 到 44.1 |
| 0 | 2 | 34.8 到 37.0 | 66.5 到 70.8 |
| 0.7 | 1 | 42.5 / 45.3 / 47.7 | 41.8 到 46.8 |
| 0.7 | 2 | 32.6 到 37.6 | 65.0 到 67.2 |
DSpark 平均接受長度 2.75 到 2.96(接受率 58 到 65%)。溫度 0.7 下沒有變慢。對照:Mia 單路 26.0 tok/s(溫度 0、DSpark k=3,0915 量測)。
Prefill(隨機字串,避開 prefix cache)
| 提示長度 | TTFT | tok/s |
|---|---|---|
| 17.2K 到 17.6K | 21.0 到 22.4 s | 787 到 821 |
| 31.8K 到 31.9K | 39.2 到 39.6 s | 806 到 812 |
| 70.1K 到 70.2K | 87.2 到 87.3 s | 804 到 806 |
對照之下,Mia 在 79K 的 prefill 要 125 秒,比較慢。
長對話亂碼測試
語料 system 是 harness 報告的前 2.5 萬字,對話是 15 篇文章切成每段 4000 字的來回。每種長度跑 4 次:溫度 0.7 兩次、溫度 0 一次、溫度 0.7 開思考一次。
| 對話字數 | 提示 tokens | 簡體字 | 其他文字系統 | 重複片段 | 冷啟 TTFT | decode tok/s |
|---|---|---|---|---|---|---|
| 60,341 | 39,042 | 0 | 0 | 0 | 50 到 52 s | 52 到 59 |
| 92,521 | 57,401 | 0 | 0 | 0 | 76 s | 47 到 55 |
| 116,656 | 69,750 | 0 | 0 | 0 | 42 s(部分命中 prefix cache) | 52 到 62 |
長上下文的 decode 反而比短文快,因為答案大量引用上下文,投機解碼命中率比較高。
開思考的那 3 次,有 2 次在 1200 token 上限內沒寫完推理,輸出是空的,此為上限設定造成。
資源
就緒後與測試後,MemAvailable GB10 A 約 22 GiB、GB10 B 約 23 GiB(Mia 是 6 到 9 GiB)。
兩台核心日誌都沒有 Xid,閒置時 GPU 47 到 48°C。
DeepSeek V4.1 Flash 雙機與多機 GB10 部署建議
CyberQ 認為,儘管 Mia 推出的 GB10 雙機 DeepSeek V4.1 Flash 比較早,但綜合各項推論效能與系統監控指標,sfxnz DeepSeek-V4.1-Flash Viterbi 2.0bpw 展現出工程成熟度與上線實用性。雙機在投機解碼的加持下,長上下文解碼效能不降反升,且全程未曾觸發任何 GPU Xid 異常記錄,閒置溫度亦穩定維持在五十度以下。
更關鍵的是,推論就緒後的可用記憶體餘裕相較 Mia 雙機的版本提升了兩倍以上,徹底排除了過往記憶體緊繃所衍生的潛在問題。除去思考模式下內部推理暫以簡體中文草擬的特性,在常規關閉思考的正式環境中,本架構已完全具備承接 Hermes 後端任務的實力,是兼具較低延遲、優異吞吐量與嚴謹繁中品質的高效益替換方案,最適合目前市場上擁有雙機 GB10 設備的公司與團隊使用。
而 Mia 則新推出了 GB10 三機/四機的 DeepSeek V4.1 Flash 社群配方,對於擁有三台或四台 GB10 設備的公司來說,也是另一個可考慮的DeepSeek V4.1 Flash 地端部署新選項。
這個專案則是基於 SGLang 框架,將 DeepSeek-V4.1-Flash 模型部署於 3 至 4 台具備 128B 統一記憶體的 NVIDIA DGX Spark(GB10)節點,透過 ConnectX-7 RoCE 高速網路互連,並結合原生 MXFP4 專家權重、FP8 密集權重、本機 NVMe 卸載 Engram 表格與 DSpark 投機解碼技術,提供相容於 OpenAI 規格的 API 服務端點。
在測試成績方面,三機組態(TP=3)實現了單路解碼 51.0 tok/s(首字延遲 TTFT 為 223 ms)、4 路併發合計解碼 85.4 tok/s 與約 2,000 tok/s 的預填(prefill)吞吐量,並通過 256k 長度的穩定驗證。而進階的四機組態(TP=4)則藉由 EP1、路由 MoE 與序列平行處理,將單路一般文字解碼提升至 87.7 tok/s(程式碼可達 124.8 tok/s),16 路併發合計解碼更大幅擴展至 342.7 tok/s,冷啟動預填效能落在 4,059 至 5,925 tok/s 之間,並在 800 萬 tokens 的 KV 快取配置下,順利通過高達 1,011,084 tokens 的大海撈針長文本實測,完整展現百萬上下文等級的高吞吐分散式推論實力。