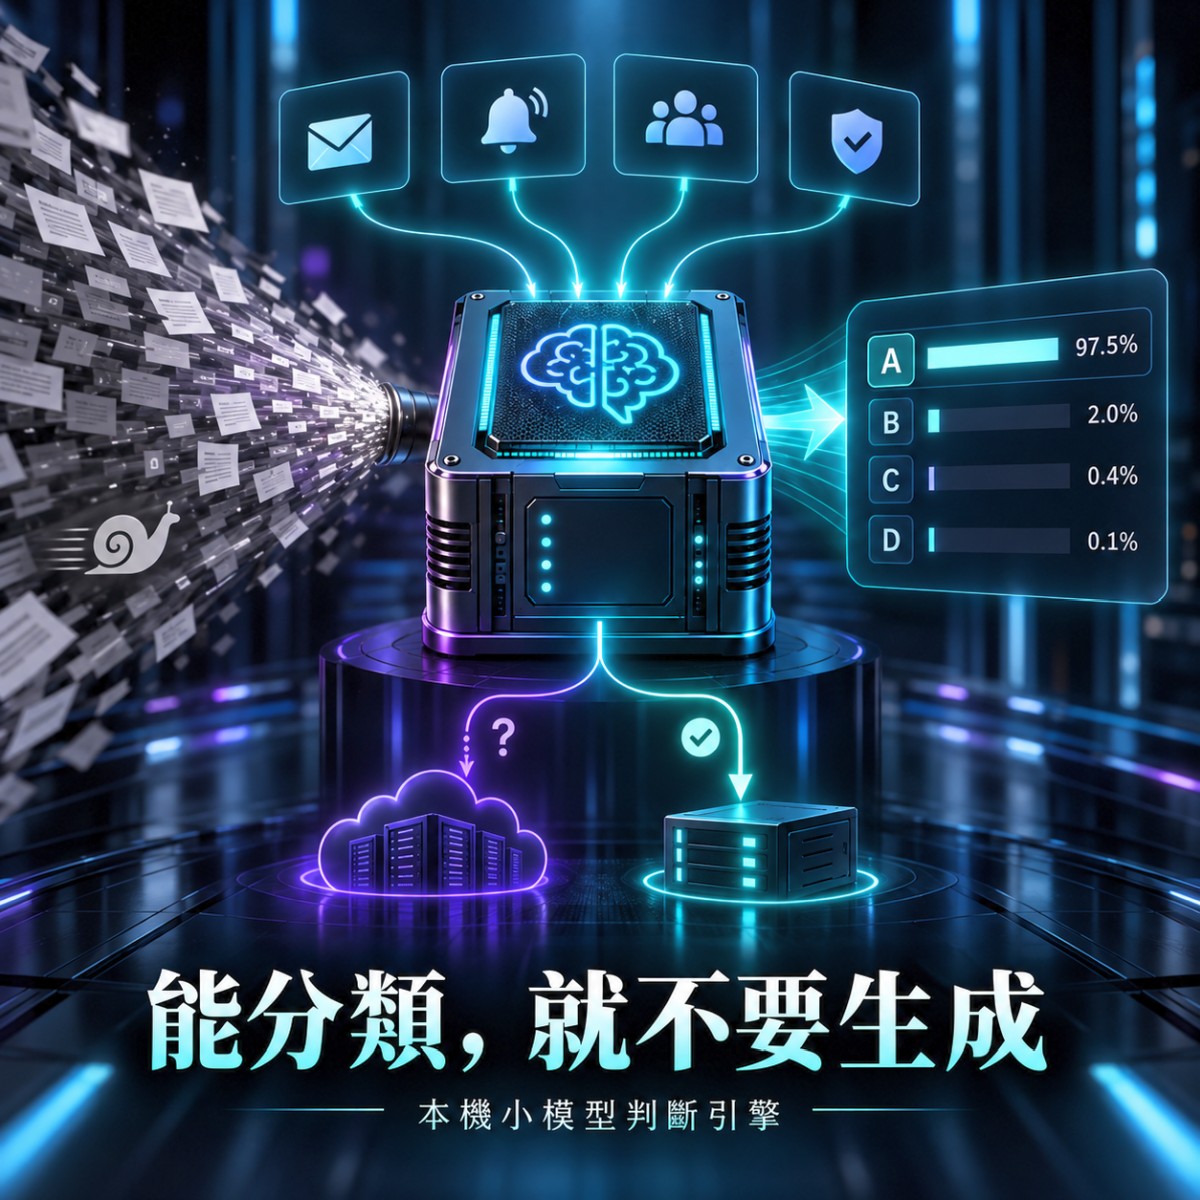
大部分企業內部的 AI 任務,最後只是要一個簡端判斷,這封信要不要回、這筆告警要不要叫醒值班、這段回覆該轉給哪個部門、這份摘要跟原文一不一致。這些任務的答案是有限選項中的一個,但我們習慣的做法仍然是叫語言模型「寫」出答案,然後再去解析它寫了什麼,這無型中會浪費掉很多不必要的計算和電力消耗,
最近看到有人示範另一種做法,放棄用文字生成來處理這些事情,只讀模型對候選答案的機率。我在自己的兩台 NVIDIA DGX Spark 上完整做了一次,包含蒸餾、人工複核與延遲量測。結論雖然和我原本預期的不同,但是卻更有用。
判斷與生成是兩件事
一般的推論流程是這樣:
prompt → prefill → token1 → token2 → token3 → ...就算你只想知道「是」或「否」,模型仍然可能先寫「根據上述情況,我認為」,這些 token 全部都是延遲。
改成判斷專用之後:
prompt → prefill → 讀最後一個位置的 logits → 結束假設候選答案對應到 A、B、C、D 四個 token,取出這四個位置的 logits 做 softmax:
A: 97.5% B: 2.0% C: 0.4% D: 0.1%模型根本不必真的輸出 A。這等於把生成式模型當成判別式分類器用。
有三個實作細節決定成敗:
候選標籤必須是單一 token
中文選項幾乎一定會被切成多個 token,機率會被切碎,所以要用代號(A、B、C 或 1 到 5),並且用 tokenizer 實際驗證每個代號接在答案前綴後都只佔一個 token。
同一份資料的多個問題要共用前綴
把情境放在前面、問題放在後面,前綴的 KV 只算一次,每多一題只付後綴的計算。我這次量到 prefill 63 毫秒、每多一題約 32 毫秒。
選項順序要隨機化
否則模型會學到位置偏好,而不是內容判斷。
實驗設定
教師模型是 DeepSeek V4.1-Flash,以 EXL3 2.9bpw 量化後跨兩台 DGX Spark 做張量平行。學生模型是 Qwen3-4B-Instruct-2507,bf16,用 LoRA(r=32,掛在全部線性層,可訓練參數 6606 萬)微調。
題型照抄 TypeSafe AI 的 Jev 這個商用判斷模型的公開介面,是非題(noul)、單選題(choice)、評分題(score)。資料由教師自己合成,涵蓋 20 個領域,繁體中文與英文混合,共 4000 個情境、9987 題,其中約一半刻意設計成困難案例。
標籤有兩種來源。即答模式直接取 logprobs 當軟標籤,涵蓋全部 9987 題,思考模式取最終答案,只做了 3000 題,優先給測試集與驗證集,並且對即答信心低於 0.9 的題取樣三次做成投票分佈。
訓練 loss 只算答案位置、候選標籤 token 子集上的交叉熵,兩個 epoch 約四個半小時。
最重要的一個設計,另外做人工盲測。 我自己標了 253 題,不看任何模型的答案。這一步不能省,原因下面會講。
結果一:蒸餾沒有明顯提高準確率
| 組別 | 人工隨機抽樣的準確率(n=105) |
|---|---|
| 學生零樣本 | 85.7% |
| 學生蒸餾後 | 87.6% |
| 教師即答 | 93.3% |
| 教師思考 | 95.2% |
提升 1.9 個百分點,而 105 題的 95% 信賴區間大約是正負 4 到 5 個百分點。誠實的講法是:目前沒有足夠證據證明蒸餾提高了整體準確率。
學生也沒有超過教師即答。原因不難找:訓練資料裡只有 19% 有思考模式的標籤,其餘 81% 學的是即答模式,天花板自然就是即答。
如果只看這張表,這個實驗算是失敗。
結果二:蒸餾大幅改善了校準
| 指標 | 零樣本 | 蒸餾後 |
|---|---|---|
| Brier | 0.256 | 0.183 |
| ECE | 0.131 | 0.038 |
校準的意思很簡單,模型說自己有 90% 把握的那批題,實際上是不是真的答對九成。零樣本的模型過度自信,蒸餾後的模型則相當準確。
這比準確率多兩個百分點重要得多,因為它讓信心值可以拿來做決策。
結果三:可以攔下六成五的工作量
有了可信的信心值,就能設門檻,夠有把握的本機小模型自己答,沒把握的則轉給大模型處理,這是許多場域實際進行的實用方式。
| 門檻 | 本機自理的比例 | 自理題的準確率 | 95% 區間 |
|---|---|---|---|
| 0.80 | 72.1% | 97.8% | 0.937 到 0.992 |
| 0.90 | 65.4% | 98.5% | 0.946 到 0.996 |
| 0.95 | 55.2% | 99.1% | 0.949 到 0.998 |
串接起來看整體表現:
| 策略 | 本機自理 | 整體準確率 | 期望延遲 |
|---|---|---|---|
| 全部交給大模型 | 0% | 93.3% | 1413 ms |
| 門檻 0.90 | 65% | 92.4% | 604 ms |
| 門檻 0.95 | 55% | 93.3% | 766 ms |
門檻設在 0.95 時,整體準確率跟全部交給大模型完全相同,但有 55% 的請求不必動用大模型,期望延遲降低 46%。
這才是這個架構真正的價值。問題在於 4B 小模型的 40 億參數有沒有比 6710 億大模型聰明,而是,它能不能可靠地攔下一半以上不需要大模型的工作呢 ? 答案是可以。
三種題型的門檻差很多
| 題型 | 門檻 0.90 時能自理的比例 |
|---|---|
| 是非題 | 89% |
| 單選題 | 81% |
| 評分題 | 27% |
這張表透露一件事,小模型本來就很會做離散分類,是非與單選在零樣本就有九成以上,蒸餾能改善的空間有限,甚至因為 LoRA 動到了決策邊界而略微退步(單選 91.7% 掉到 88.9%,是非 97.5% 掉到 95.0%)。
評分題這領域則完全不同,1 到 5 分不是單純分類,模型必須學會「3 分和 4 分的界線在哪?」,那是教師模型的隱性偏好。所以評分題是唯一明顯進步的題型,62.1% 提升到 75.9%。
換句話說,蒸餾的其實不是知識,而是判斷的尺度,這點在實務上將確實有幫助。
兩個評測上的陷阱
第一,不能拿教師當標準答案。
學生是用教師訓練的,如果評測也用教師當標準,量到的是「學生有多像教師」,不是「學生有多正確」。這次的教師思考模式自己在人工複核下也只有 95.2%,所以學生的天花板本來就在那裡。第一版分析就踩到這個坑,在以教師為參考的保留集上挑門檻,會挑到 0.6,但那個門檻對人工答案只有 92% 準確。
第二,小心條件抽樣。
另外抽了 88 題「三個系統答案不一致」的題來看爭議情況,這一層所有系統的表現都掉到五成上下。但這個資料集是條件在「不一致」才入選的,不是自然分布,不能拿它的數字去代表任何系統的實際準確率。同理,專挑某個模型答錯的題去比較兩個模型,得到的結論沒有意義。
適合用小模型做的任務
只要答案是有限選項,而且不需要解釋,就非常適合採用這種小模型來工作:
客服工單路由、郵件分類
內容審核的通過、複審、封鎖
維運告警的嚴重度與是否需要叫醒值班
檢索結果與問題是否相關
代理人下一步該呼叫哪個工具
回覆品質的評分
這些任務沒有一個需要模型寫出一段自然語言。
實務上的建議
能分類就不要生成
一次前向傳遞加上讀 logits,可以把延遲壓到幾十毫秒的量級。
蒸餾不一定提升準確率,但可能大幅改善校準
對生產系統而言,可信的信心值常常比多兩個百分點的準確率有用。
蒸餾效果取決於教師訊號的種類,不只是教師模型有多強
用推理後的答案、即答的機率分佈、硬標籤或軟分佈,學到的是完全不同的東西。
評測一定要有獨立的標準答案
學生更像老師,不等於學生更正確。
最後補一個量測上的提醒。看到「每次判斷 22 毫秒」這類數字時,先問清楚起點和終點在哪。這次量到的單題端到端是 133 毫秒,但共用情境後的每題增量只有 32 毫秒,兩個都是真的,只是測試到的是不同的事,我們一般在業界軟體研發時,產品在乎的通常是前者。
攔下 65% 大模型工作量,小模型蒸餾是為了信心校準
企業導入 AI 的迷思,往往在於習慣性地將每個問題都當作寫作題,讓龐大的生成式模型去吐出一段自然語言,最後再寫一堆正規表達式苦苦解析。
CyberQ 這場實驗證明的核心價值,當然不是 4B 小模型有多強,而是小模型大模型分工作的機制,其實是具備一點「自知之明」的。當我們放棄生成、回歸 Logits 的機率本質,並透過蒸餾將校準誤差大幅壓低時,信心值便能轉化為高可靠度的決策閘道。
在真實的生產環境中,AI 工程構建一套務實的分流架構,讓在地執行的輕量引擎以數十毫秒的極致延遲過濾掉過半的工作量,大模型則退回後方扮演終極的仲裁者。我們設法去研究計算資源與電力消耗的最佳化,也希望讓 AI 系統走向穩定可靠生產工具。