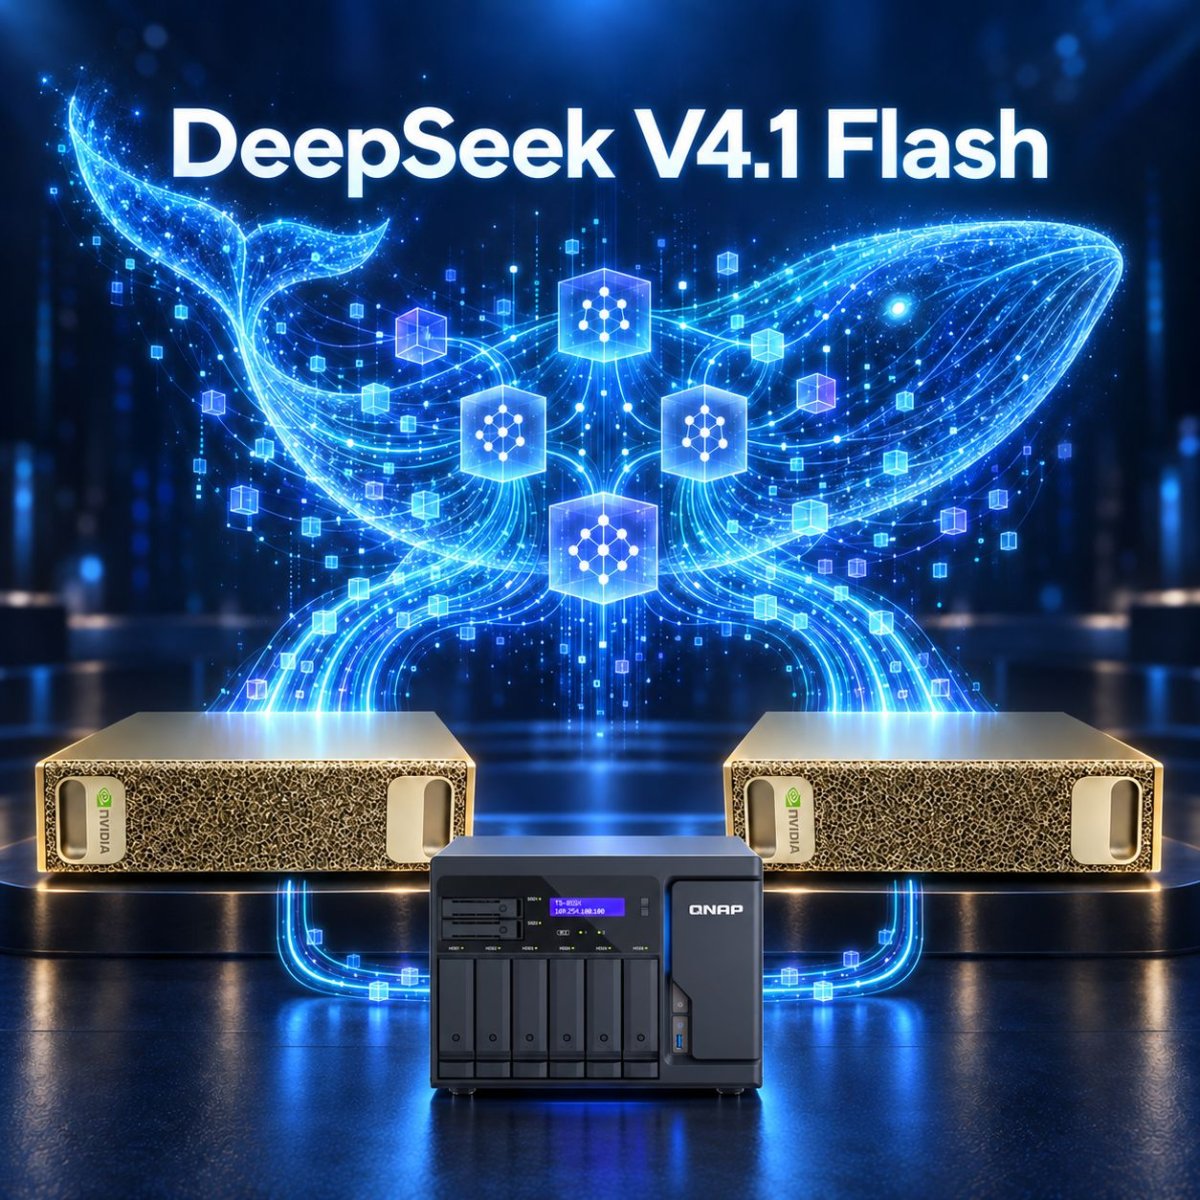
DeepSeek V4.1 Flash 可說是現階段很熱門的一款地端 AI 模型,CyberQ 近期測試將兩台 GB10(TP=2 over CX7)作為推論運算節點,並將 QNAP NAS 規劃為集中式模型倉庫與分層儲存核心。主權重存放在 QNAP NAS 的 NFS 共用資料夾,透過高速網路供雙節點掛載讀取。為了兼顧推論頻寬與網路負載,架構採取分層設計,動態隨機存取負擔較重的 Engram 分片(model-00047 與 model-00048,各約 94.6 GiB)由 QNAP NAS 同步至兩台本機 NVMe SSD,其餘主權重檔案則保留在 NAS 端直接以 NFS 共享。
DeepSeek V4.1 Flash 模型配方評估與儲存配置策略
| 路線 | 容量大小 | QNAP NAS 儲存與本機容納性 | 部署決策 |
| 官方 MXFP4/MXFP8 | 約 510 GB | NAS 可存放,但雙機 GB10 記憶體不足 | 放棄 |
| NVFP4(AtomicChat) | 527 GB | NAS 可存放,但需 B200 級硬體架構 | 放棄 |
| 0xTank 原版 | 510 GB | NAS 可存放,但需 4 台 GB10 叢集 | 放棄 |
| GGUF Q2_K | 246 GB | 單機容量不足,llama.cpp 上游尚未支援 | 放棄 |
| sfxnz EXL3 2.0bpw-mcg | 333.5 GiB | 主權重放 NAS NFS,Engram 189 GiB 放本機 NVMe | 驗證通過,但長上下文失真 |
| MiaAI-Lab EXL3 2.9bpw | 196 GiB | 權重放 NAS NFS,Engram 經 hardlink 共用 | 正式採用方案 |
QNAP NAS NFS 傳輸特性與 Page Cache 釋放技巧
雙節點直接透過 NFS 掛載 QNAP NAS 讀取主模型時,循序讀取頻寬直接決定了載入時間。在部署 MiaAI-Lab 2.9bpw 時,兩台節點幾乎同時從 NAS 讀取整份 196 GiB 檔案,單機 NFS 讀取累計達 175.7 GiB。主模型讀取耗時約 50 分鐘,DSpark draft 重新掃描 checkpoint 需 20 分鐘,總啟動耗時達 70 分鐘。上游啟動腳本的 READY_TIMEOUT 預設為 1500 秒,在此架構下必須改為 3600 秒以上,比方說 5,400 秒,並可在 QNAP 端設定 SSD 讀取快取與調整 NFS 掛載參數(如 rsize=1048576、nconnect)來最佳化高吞吐效能。
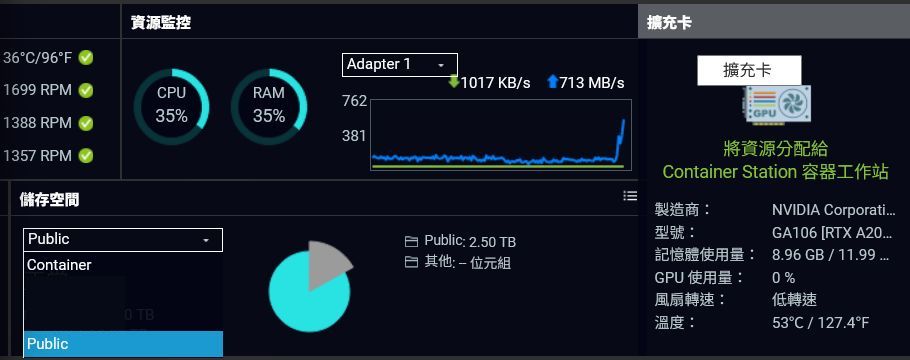
從 QNAP NAS 複製大容量 Engram 分片至本機 NVMe 時,在 GB 10 上偶爾會發生作業系統快取副作用。初始測試中,雙機各自完成近 190 GiB 檔案寫入後,Linux page cache 各被佔用約 110 GiB。這會導致後續 NCCL 建立連線時,InfiniBand 驅動程式回傳 ibv_reg_mr_iova2 failed with error Cannot allocate memory 錯誤,後來 CyberQ 採用比較快的解決方案是透過程式對指定檔案呼叫 posix_fadvise(DONTNEED) 釋放檔案快取,使可用記憶體恢復至正常水準,NCCL 即可一次通過註冊。
DeepSeek V4.1 Flash 推論效能與服務驗證
| 測試指標 | sfxnz 2.0bpw eager(09-14) | MiaAI 2.9bpw(09-15) |
| 單路 Decode(temperature 0、400 token 繁中) | 13.7 tok/s(無 DSpark) | 26.0 tok/s(DSpark k=3) |
| 首字延遲 TTFT(短提示) | 0.26 秒 | 0.25 秒 |
| 79K Token Prefill 時間 | 157 秒 | 125 秒 |
| 功能測試(對話、工具呼叫、思考模式) | 全部 PASS | 全部 PASS |
Proxy :8100 健康檢查狀態 | 3 healthy、0 unhealthy | 3 healthy、0 unhealthy |
推論服務就緒後,MiaAI 2.9bpw 在雙機節點保留了充足的穩定度,兩台主機可用記憶體維持在 6.4 至 8.6 GiB,KV 快取配置 798,601 token,可滿足 600K 上下文達到 1.33 倍的併發乘數。經由連線測試,deepseek-v4-flash 穩定回傳運算結果且關閉思考模式開銷。
EXL3 專家路由精度分析與長對話異常排查
在 sfxnz 2.0bpw 版本中,hermes 代理人在長多輪對話且伴隨工具呼叫失敗的情境下,回覆內容會混雜簡體字、日文假名及俄文字母。測試過程透過關閉 DSpark 投機解碼(SPEC=none)並釐清 LiteLLM 丟棄 reasoning_effort 參數的行為,排除了投機推論與參數傳遞問題。根本原因在於 2.0 bpw 極限壓縮導致 MoE 路由專家在多輪複雜環境下出現嚴重語意漂移。
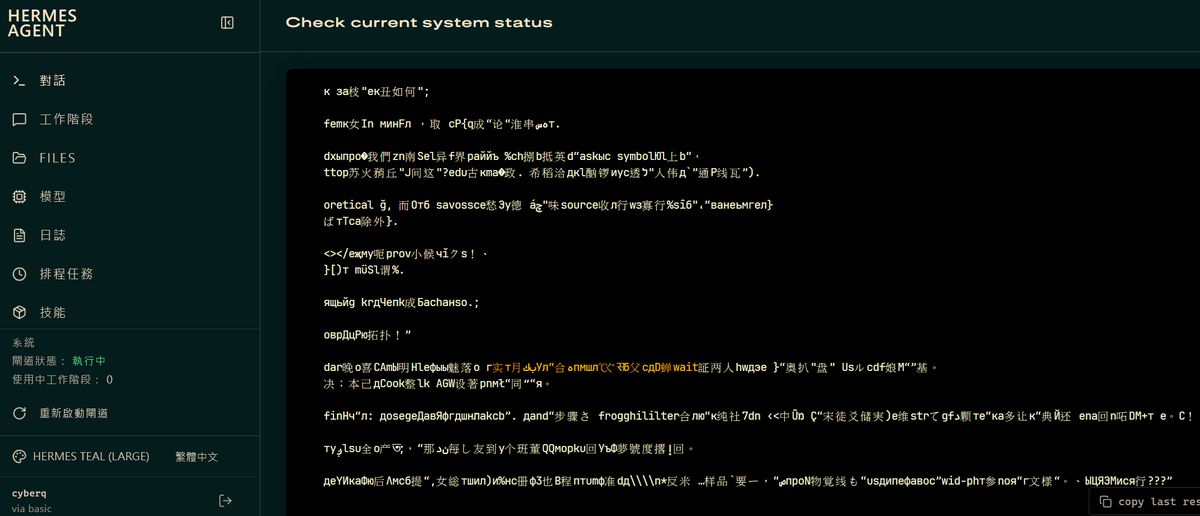
升級至 QNAP NAS 託管的 MiaAI-Lab 2.9bpw 後,Engram 部分直接利用 hardlink 共用先前的分片資料,不僅維持單機儲存空間零浪費,單路解碼效能更由 13.7 tok/s 大幅躍升至 26.0 tok/s, 2.9bpw 也已經解決路由失真問題。
未來 CyberQ 會在測試其它 DeepSeek V4.1 Flash 的實作方式,它是目前地端 AI 模型中的佼佼者,有適當機器來跑的話,包括 MacBook Pro、NVIDIA Dgx Spark、AMD 的 AI 工作站等等,社群正在積極用多種方式來起 DeepSeek V4.1 Flash 。
下一篇會採用 DS4 專案新的配方來實作,敬請期待。