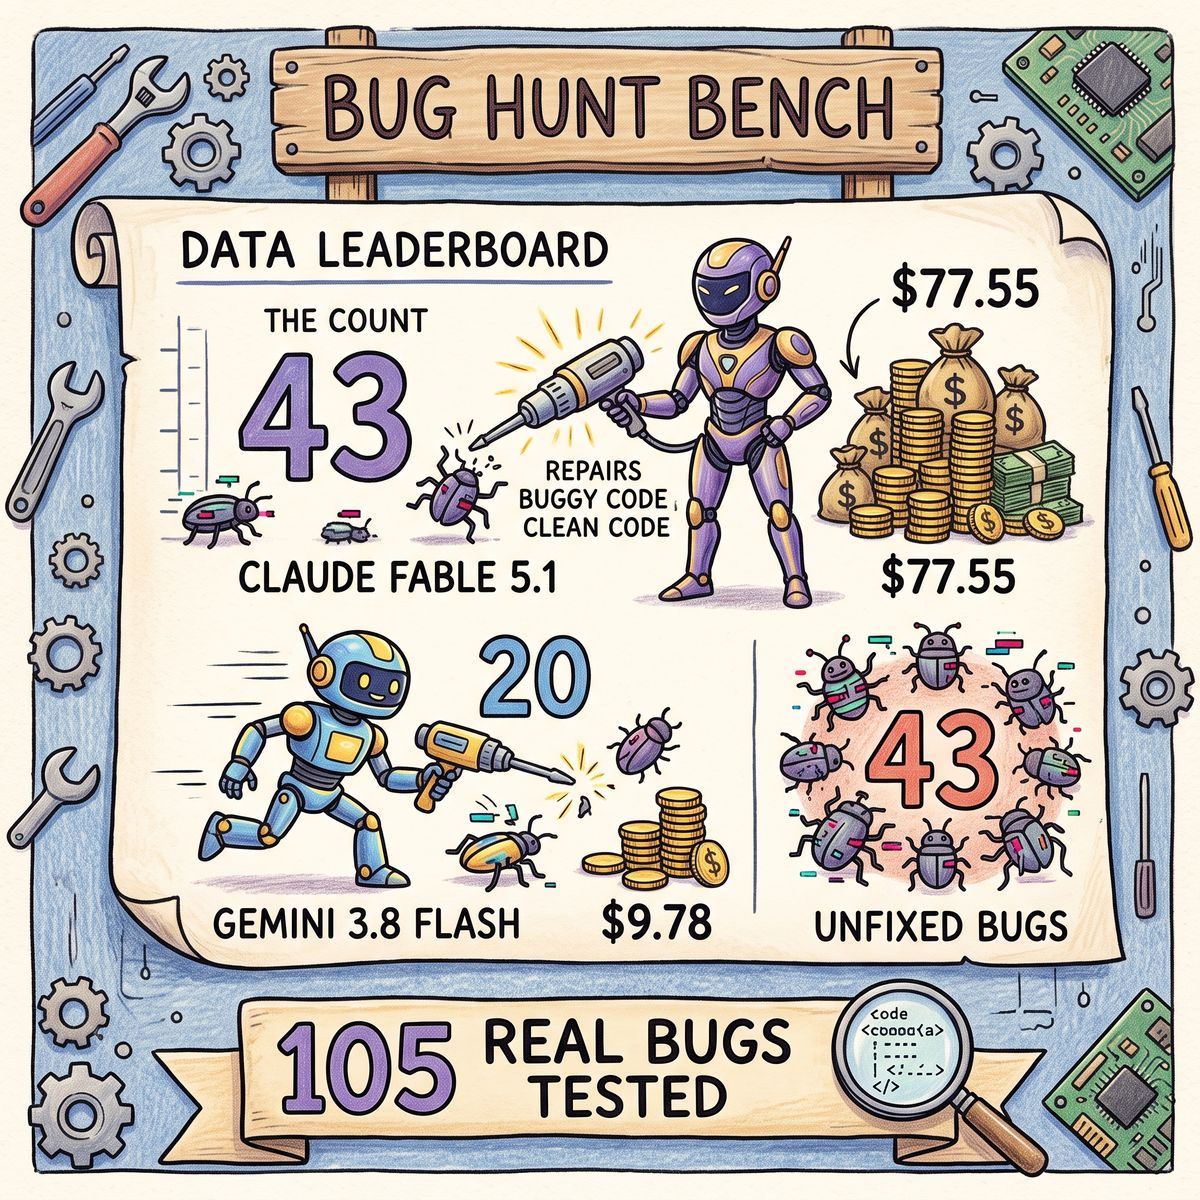
Paweł Huryn 於 9 月 2 日在 X 上發布最新一輪 Bug Hunt Bench 結果(https://x.com/PawelHuryn/status/2095293750331248730),把當天剛上市的 Gemini 3.8 Flash 與前一天上市的 Claude Fable 5.1 一併放進同一套 105 個真實 Bug 的測試。本文依據他公開在 GitHub 的完整方法與資料(github.com/phuryn/experiments,bug-hunt-bench 目錄)整理,並在文末附上可以自行重跑的參考程式碼。
測試設計,兩個真實程式庫與 105 個埋設的 Bug
他這項針對多家 AI 模型與服務的基準測試從 7 月中旬開始累積,到 9 月 2 日已跨越 15 個以上的模型與超過 20 次計分的執行。核心設計如下。
Repo 1 是一個公開的 VS Code / Cursor 側邊欄擴充套件,約 2.8 萬行 TypeScript,埋設 45 個 Bug。其中 16 個是從該專案自身的修復歷史還原回去的真實缺陷,另外 29 個由作者以相同風格撰寫。Repo 2 是一個 Vite / React / TypeScript 的 LMS 系統,後端為 Supabase Edge Functions 與 Clerk,約 6 萬行,埋設 60 個 Bug,全部都是曾經上線又被修掉的真實回歸缺陷,每一個都對應到原始修復 commit 的 SHA。
兩個程式庫的測試套件都維持綠燈。Repo 1 保留 922 個測試通過,Repo 2 保留 53 個單元測試、型別檢查與正式建置通過。原本能抓到這些 Bug 的測試在埋設時已被中和,因此模型無法靠跑測試直接找到答案。
每個模型都在自家原生的 CLI 中執行,Claude 系列在 Claude Code,GPT 系列在 Codex CLI,Grok 在 grok CLI(ACP 模式),Gemini 在 Antigravity CLI(agy)。作者刻意不用單一統一的 harness,理由是這樣才能量到「廠商自己出貨的組合」。每個模型每個 repo 只跑一輪,提示詞完全相同並已公開。
評分以模型的 diff 為依據,不採用模型自己寫的報告。判定方式是把 diff 與乾淨的原始程式碼比對,由一個獨立的盲審模型對照未公開的答案清單判定,分為 FIXED_MATCH、FIXED_PARTIAL、CLAIMED_ONLY 與 MISSED 四類。模型額外修改的地方會另行判定為真實缺陷或誤修,因此無關修改會分開計算,並未被直接排除。截至目前,所有執行中的額外修改沒有任何一筆被判定為誤修。評審路由有一條固定規則,任何模型都不評自家家族的提交,例如 GPT-5.6 的提交由 Grok 評,Claude 系列的提交由 GPT-5.5 評。
9 月 1 日至 2 日的新結果
Claude Fable 5.1,三個推論強度全部跑完
| 模型 | 推論強度 | 修復數 /105 | Repo 1 /45 | Repo 2 /60 | 誤報宣稱 | 額外真實修復 | 耗時 | 成本(表價估算) |
|---|---|---|---|---|---|---|---|---|
| Claude Fable 5.1 | max | 43 | 19 | 24 | 4 | 11 | 73.1 分 | $77.55 |
| Claude Fable 5.1 | high | 33 | 15 | 18 | 0 | 7 | 36.3 分 | $41.52 |
| Claude Fable 5.1 | low | 29 | 13 | 16 | 1 | 6 | 33.2 分 | $27.27 |
| Fable 5 | max | 29 | 12 | 17 | 0 | 5 | 57.3 分 | $104.49 |
| Fable 5 | high | 24 | 9 | 15 | 1 | 5 | 31.4 分 | $68.07 |
43 是這個榜單有史以來的最高分,比 GPT-5.6 Sol 在 max 的 42 高出一分。不過作者自己強調,這個榜單的同設定重跑差距約在正負 2 到 3 分之間,Opus 5 在完全相同條件下曾跑出 23 與 26 兩個結果,因此 43 與 42 應視為平手,兩者都只跑了一次。
真正穩固的結論是世代差距。同一個 harness、同一份提示詞、同一批 Bug,Fable 5 到 Fable 5.1 在 max 從 29 升到 43,在 high 從 24 升到 33,兩者都遠超過雜訊範圍。Fable 5.1 在 low 就已經追平 Fable 5 在 max 的 29 個修復,成本只有 26%。
成本下降的原因值得注意。Fable 5.1 在 max 的執行讀取了 1.946 億個快取 token,是 Fable 5 的 2.35 倍,輸出量也多 1.55 倍,但總成本反而低了 26%。作者指出差別全部來自 Fable 5.1 的快取讀取價格降到每百萬 token 0.25 美元,是前代的四分之一。若以舊價計算,同一次執行要價 223.52 美元。在會反覆重讀大量快取前綴的長時間代理任務上,這一個項目就決定了成本欄位。
推論強度的效果呈現後段集中的特性。low 到 high 只多 4 個修復,high 到 max 多了 10 個。high 的誠實度最好,兩個 repo 都沒有任何宣稱修好但 diff 不支持的項目,max 在 Repo 2 出現 4 個。max 修掉了兩個從未被任何模型修過的 Repo 1 Bug,未被修復總數從 45 降到 43。
作者另外記錄了一個可重現性陷阱。Fable 5.1 晚於他使用的 Claude Code 版本,CLI 沒有這個模型的設定,會預設 20 萬 token 的上下文視窗,而模型實際是 100 萬。若不明確指定,CLI 會提早約五倍觸發自動壓縮,且不會報錯,只會表現為分數變差與耗時變長。他的每一次執行都以 [1m] 明確指定視窗。
Gemini 3.8 Flash,在 Google 自家的 Antigravity CLI
| 模型 | 推論強度 | 修復數 /105 | Repo 1 /45 | Repo 2 /60 | 誤報宣稱 | 額外真實修復 | 耗時 | 成本(表價估算) |
|---|---|---|---|---|---|---|---|---|
| Gemini 3.8 Flash | high(上限) | 20 | 7 | 13 | 1 | 6 | 29.8 分 | $9.78 |
| Gemini 3.7 Flash(Antigravity,重測) | high | 18 | 4 | 14 | 37.5 分 | $8.57 | ||
| Gemini 3.7 Flash(Antigravity,循序) | high | 16 | 4 | 12 | 22.7 分 | $6.36 | ||
| Gemini 3.7 Flash(已退役的 Gemini CLI) | high | 22 | 8 | 14 | 96.8 分 | $8.43 |
作者特別提醒,比較時只能對照同樣在 Antigravity CLI 跑的列。3.7 Flash 在同一 CLI 兩次分別得 18 與 16,平均 17,3.8 Flash 得 20,比平均高 3 分,比較好的那次高 2 分。以正負 2 到 3 分的雜訊範圍來看,這是位於雜訊邊緣的小幅進步,不能稱為明確的世代跳躍。唯一一筆超過它的 3.7 Flash 結果(22 分)是在已退役的 Gemini CLI 跑的,harness 不同,兩個方向都不能直接比較。
進步集中在 Repo 1,從 4 分升到 7 分,Repo 2 持平。成本並沒有更便宜,9.78 美元高於 3.7 Flash 同一 CLI 的 6.36 與 8.57 美元,原因是每 token 單價相同但輸出更多。誠實度良好,Repo 1 沒有任何誤報,Repo 2 有一筆,兩邊都沒有誤修。這次執行沒有修掉任何過去從未被修復的 Bug,未被修復總數維持 43。
推論強度在這條服務路徑上經過驗證。以標準探測提示詞每級跑三次,思考 token 數分成三個不重疊的區間,low 為 0 到 70,medium 為 91 到 131,high 為 151 到 367。agy 對這個模型只提供到 high,要求 max 會直接被拒絕(invalid --effort "max" (valid: low, medium, high)),沒有靜默降級的問題,因此上限標籤是誠實的。作者同時提醒,3.7 Flash 在相同提示詞下 high 會產生 3,324 到 4,799 個思考 token,3.8 Flash 少了一個數量級卻分數略高,兩代的思考 token 數不能當成同一個基準來看。
把整個榜單放在一起看
以下彙整各模型在自身最高推論強度的結果,並換算每個修復的平均成本。
| 模型 | 推論強度 | 修復數 /105 | 成本 | 每個修復平均成本 | 執行日期 |
|---|---|---|---|---|---|
| Claude Fable 5.1 | max | 43 | $77.55 | $1.80 | 9 月 1 至 2 日 |
| GPT-5.6 Sol | max | 42 | $69.61 | $1.66 | 8 月 1 日 |
| GPT-5.6 Luna | max | 33 | $1.80 | $0.05 | 7 月 31 日 |
| Opus 5 | max | 27 | $51.33 | $1.90 | 8 月 1 日 |
| Grok 4.6 | xhigh | 27 | $22.73(下限) | $0.84 | 8 月 12 日 |
| Gemini 3.8 Flash | high | 20 | $9.78 | $0.49 | 9 月 2 日 |
| GLM-5.3 | default | 19 | $19.73(實際帳單) | $1.04 | 8 月 25 日 |
| DeepSeek V4-Flash 0731 | default | 14 | $1.52(實際帳單) | $0.11 | 8 月 1 日 |
| GLM-5.3 Flash | default | 13 | $0.79(實際帳單) | $0.06 | 8 月 27 日 |
幾個需要注意的細節。Grok 的 CLI 回報的是上下文填充量而非累計用量,其成本是重建出來的下限。GPT-5.6 Luna 的 1.80 美元是 7 月 30 日降價 80% 後的表價,並經 Codex CLI 的 session 逐請求重算,作者稱之為精確值而非下限。GPT-5.6 Sol 在 max 的執行耗時 163.8 分鐘,是榜上最久的一次。不同計量方式的成本不宜精確到美元互相排名。
43 個從未被修復的 Bug
這是整個測試最值得記住的數字。在 15 個以上的模型、20 多次計分執行之後,105 個 Bug 中仍有 43 個沒有任何模型修過,比例超過四成。而且這些 Bug 大多數是曾經上線、後來被人或代理修好的真實回歸缺陷,並非憑空製造的難題。
從 7 月底的 63 個一路降到 43 個,每一次下降都很緩慢。8 月下旬曾有數週維持在 52 個,之後由 GLM-5.3 與當時仍為匿名模型的 GLM-5.3 Flash 各修掉一個,Fable 5.1 在 max 再修掉兩個。作者的觀察是,能修掉「所有人都漏掉的 Bug」的模型往往不是榜首,覆蓋率與排名是兩個不同的問題。他也提到,這類事件屬於單次執行的變異,同一個模型重跑不見得能再修一次。
從軟體工程與資安角度的觀察
第一,榜首的成本結構已經改變。Fable 5.1 與 GPT-5.6 Sol 在 max 都落在每個修復 1.6 到 1.8 美元,但 Fable 5.1 靠快取讀取價格重定價把總成本壓到前代的 74%,並在 low 就追平前代的 max。對於長時間、大量重讀上下文的代理式任務,快取讀取價格比輸入與輸出單價更能決定帳單。
第二,推論強度必須驗證,不能只看標籤。這個榜單累積了多個案例。grok CLI 收到未知的強度值會靜默降為 high,OpenRouter 接受任何字串卻不套用,退役的 Gemini CLI 接受 gemini-3.7-flash 卻把請求送到 3.5 Flash,Claude Code 對未知的新模型會預設較小的上下文視窗。作者的做法是每次上新的服務路徑就先跑一個小型探測,觀察不同強度下的思考 token 是否真的分開,再為執行貼標籤。
第三,評審不能由同家族的模型擔任。這個測試從一開始就固定由不同廠商的模型盲審,並曾用重評來驗證評審更換不影響已公布分數。Repo 1 的六個已公布結果在換評審後全部一致。這條規則同樣適用於團隊自己的程式碼審查流程。Huryn 在推文串中是否另外提出跨模型互審的實務建議,本文未能直接讀取原始貼文,標註待查。
第四,模型的自我報告不可信。Sonnet 5 在 Repo 1 只修了 1 個 Bug,卻在報告中宣稱完成逐行檢視並列出「懷疑但未修復,無」。Opus 5 在 max 出現 5 筆宣稱修復但 diff 不支持的項目,Fable 5.1 在 max 也有 4 筆。以 diff 為唯一事實來源,是這套評分方法可信的關鍵。
從部署架構的角度,這些數字支持分層策略。日常的 CI 掃描與初步修復用 Gemini 3.8 Flash 或 GPT-5.6 Luna 這類每個修復不到 0.5 美元的模型,高複雜度或涉及權限與資料隔離的核心模組再交由 Fable 5.1 或 GPT-5.6 Sol 在最高推論強度處理,最後由工程師以 diff 為依據複核。值得補充的是,Google 同日也發布了 Gemini 3.8 Flash Cyber,專門針對弱點探索與修補,目前僅透過 Fairwind Program 提供給受信任的政府單位、關鍵基礎設施營運者與軟體維護者,尚未進入這個榜單。
不過,任何分層策略都不會改變一個事實。最強的模型在最高強度下也只修到 43 個,四成以上的真實回歸缺陷至今無人能修。這些 Bug 涉及跨租戶存取、時限未強制執行、|| 75 這類靜默改寫預設值的型別強制轉換,正是資安審查最在意的類型。端到端全自動修復目前還不足以取代具備領域知識的工程師判斷。
附錄,可以自行重跑的參考程式碼
以下程式碼,CyberQ 依據作者公開的方法重新實作,可用於在自己的程式庫上進行同型態的測試。完整檔案見本文隨附的 bughunt.zip解開後的目錄,包含五個工具。
plant.py,從 git 修復歷史還原真實回歸缺陷,產生無 git 歷史的乾淨工作目錄與答案清單
run_arm.py,以指定的原生 CLI(claude、codex、agy、grok)無頭執行提示詞,記錄 diff、檢查結果與耗時
judge.py,以不同廠商的模型盲審 diff,對照答案清單輸出四類判定與額外修改分類
scoreboard.py,彙整判定結果與 token 用量,依價格表估算成本並輸出 CSV
effort_probe.py,在貼標籤前先驗證推論強度在該服務路徑上是否真的生效
執行順序如下。
pip install --break-system-packages -r bughunt/requirements.txt
python bughunt/plant.py --repo ./my-project --fixes fixes.txt --out ./bench/repo1
python bughunt/run_arm.py --repo ./bench/repo1 --prompt bughunt/prompt.md --cli claude --model claude-fable-5-1 --effort high --out ./runs/fable51-high
python bughunt/judge.py --run ./runs/fable51-high --key ./bench/repo1.key.json --judge openai/gpt-5.5
python bughunt/scoreboard.py --runs ./runs --prices bughunt/prices.json --out scoreboard.csv
effort_probe.py 應在每次換模型或換服務路徑時先執行一次,確認 low、high、max 的思考 token 分布不重疊,再把強度標籤寫進執行紀錄。