ChatGPT、Claude、Grok 同晚大規模異常事件整理(2026 年 9 月 3 日)
本文初稿完成於台灣時間 9 月 4 日 00:15,並於 9 月 4 日上午依各家後續說明更新。文中所有時間已換算為台灣時間(UTC+8),並附上 UTC 原始時間供比對。
摘要
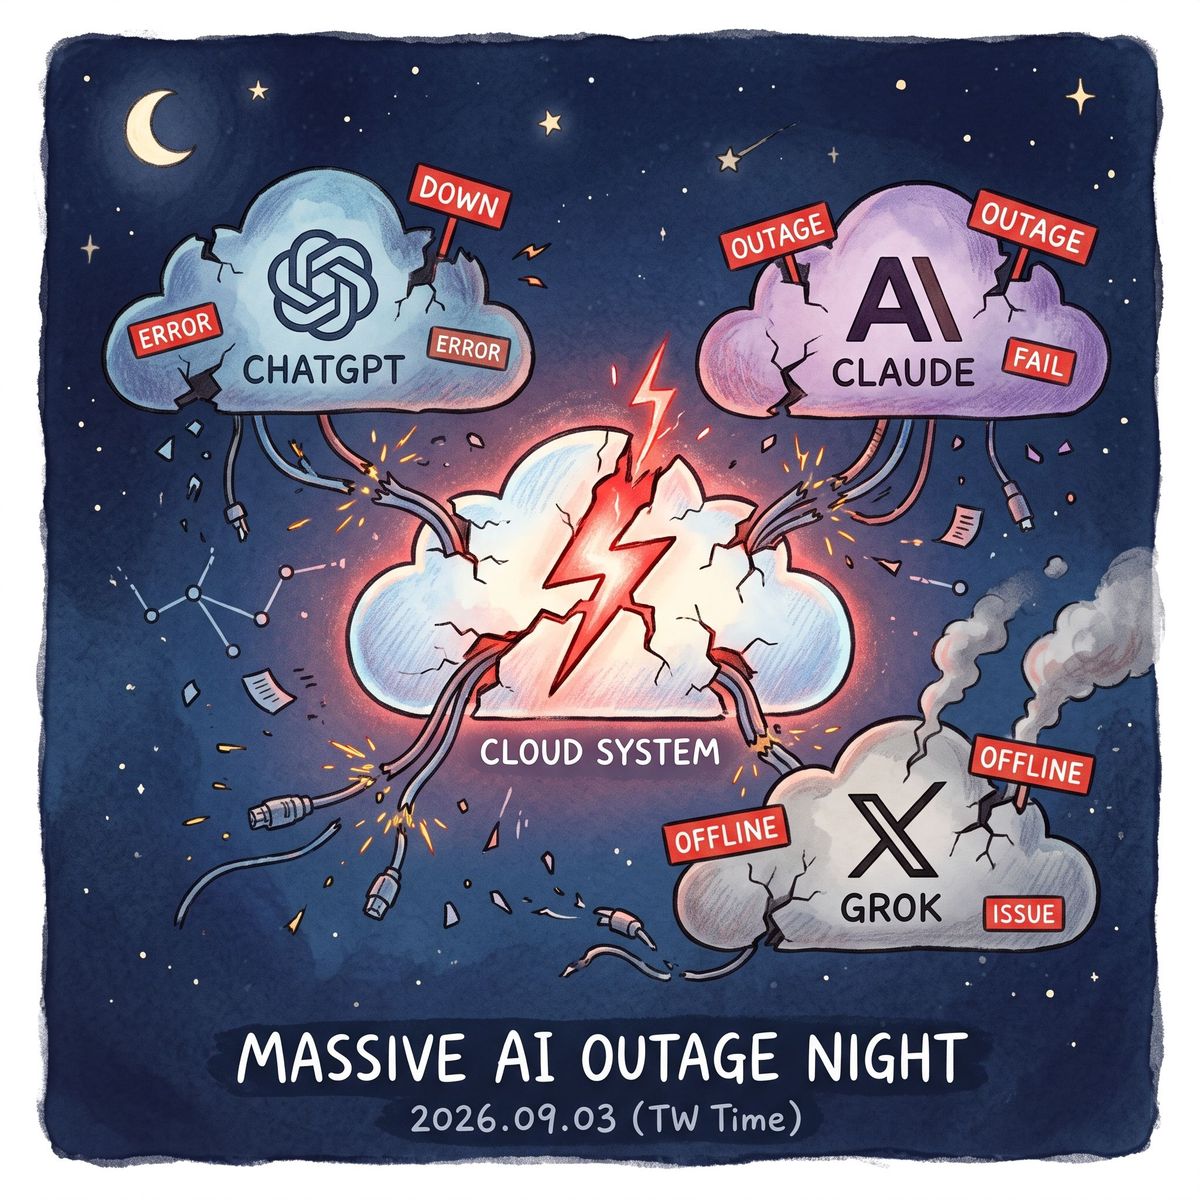
台灣時間 9 月 3 日晚間 21 時至 9 月 4 日凌晨 1 時之間,SpaceXAI(原 xAI)的 Grok、Anthropic 的 Claude 與 OpenAI 的 ChatGPT 先後出現大範圍錯誤,三家廠商的官方狀態頁均開立事件。Google Gemini 在 Downdetector 上有回報量上升,但 Google 並未開立官方事件。
事後各家說明指向兩起獨立事件在同一時段重疊。SpaceXAI 證實其孟菲斯(Memphis)運算中心發生故障,並向「受影響的運算合作夥伴」致歉。Anthropic 自 2026 年 5 月起租用該處 Colossus 1 資料中心的全部算力,Claude 本次受影響的模型也全部集中在 Opus 與 Mythos/Fable 高階系列,時間點與 Grok 幾乎同步。OpenAI 則說明 ChatGPT 與 Codex 的問題來自自身的路由錯誤(routing error),與孟菲斯事件無關。事件初期媒體推測的「微軟 Azure 共同故障」與「Cloudflare 故障」均已被排除,Cloudflare 更公開否認。
事件時間軸(台灣時間)
| 時間 | UTC | 事件 | 來源 |
|---|---|---|---|
| 20:37 | 12:37 | Anthropic 開立 Claude Sonnet 5 錯誤率升高事件,20:56 宣告解決 | status.claude.com |
| 21:26 | 13:26 | Anthropic 開立「Elevated errors for multiple models」事件,初期影響 Claude Mythos 5.1、Fable 5.1、Opus 5 | status.claude.com |
| 21:30 | 13:30 | SpaceXAI 狀態頁開立 Grok「Models outage」,影響 Grok on X、Web、iOS 與 Android | status.x.ai、Engadget |
| 21:41 | 13:41 | Anthropic 更新為「Identified」 | status.claude.com |
| 21:50 | 13:50 | Anthropic 公布完整受影響清單,計有 Mythos/Fable 5.1、Mythos/Fable 5、Opus 5、Opus 4.8、Opus 4.6 | status.claude.com |
| 22:43 | 14:43 | OpenAI 發言人事後說明的路由錯誤起始時間(7:43 am PT) | The Register |
| 22:58 | 14:58 | OpenAI 狀態頁開立「Elevated errors across ChatGPT and Codex」,ChatGPT 15 個元件與 Codex 4 個元件受影響 | status.openai.com |
| 約 23:00 | 15:00 | Downdetector 美國地區 ChatGPT 回報超過 35,000 筆,Claude 約 1,400 筆,Grok 約 1,200 筆 | Softonic 整理 |
| 23:17 | 15:17 | OpenAI 套用修正(8:17 am PT),進入監控 | The Register |
| 23:25 | 15:25 | Anthropic 更新,僅剩 Opus 4.8 與 Opus 5 仍受影響 | status.claude.com |
| 00:06(9/4) | 16:06 | Anthropic 部署修正,進入監控 | status.claude.com |
| 00:16(9/4) | 16:16 | Anthropic 宣告影響結束(9:16 am PT) | status.claude.com |
| 00:55(9/4) | 16:55 | OpenAI 宣告事件解決(9:55 am PT) | Engadget |
| 約 01:00(9/4) | 約 17:00 | Grok 恢復,Engadget 依狀態頁計算中斷約 3.5 小時 | Engadget |
| 03:38(9/4) | 19:38 | 9to5Google 更新,三家服務全數恢復正常(12:38 pm PT) | 9to5Google |
| 9/4 上午 | 9/3 下午(美西) | SpaceXAI 於 X 發文,證實孟菲斯運算中心故障並向運算合作夥伴致歉 | SpaceXAI on X |
各廠商公布的原因
SpaceXAI(Grok)
SpaceXAI 在 X 上發文表示,Grok 的問題源於「本公司孟菲斯運算中心今天上午的一次故障」,並向受影響的運算合作夥伴致歉,稱所有系統已恢復並正常運作(SpaceXAI on X)。Elon Musk 另外發文表示公司正採取矯正措施以確保不再發生(Engadget 引述)。
SpaceXAI 沒有說明故障的技術性質,例如是電力、冷卻、網路或軟體層面,也沒有點名哪些合作夥伴受影響。這是目前三家廠商中唯一明確指出實體地點的說明。
孟菲斯運算中心即 Colossus 叢集所在地。Colossus 1 位於南孟菲斯的前 Electrolux 廠房,Colossus 2 位於 Whitehaven 區,兩者合計於 2026 年中已達約 1 GW 的 AI 算力規模(Wikipedia 整理)。SpaceXAI 的說法並未指明是哪一座設施。
Anthropic(Claude)
Anthropic 發言人向 The Register 表示,Claude 已完全恢復,此前一項「基礎設施問題」造成 Claude.ai、Claude Code、Claude Cowork 與 Claude API 的部分中斷,服務於 UTC 16:16 恢復(The Register)。狀態頁的最終更新與此一致,但同樣沒有說明基礎設施問題的內容。
Anthropic 沒有證實本次事件與 SpaceXAI 孟菲斯故障有關,Engadget 亦指出 Anthropic 未回應此點(Engadget)。不過以下公開事實使兩者的關聯成為目前最合理的解釋。
Anthropic 於 2026 年 5 月 6 日宣布與 SpaceX 簽約,使用 Colossus 1 資料中心的全部算力,規模超過 300 MW、逾 220,000 顆 NVIDIA GPU(Anthropic 官方公告)。Bloomberg 於 6 月報導,SpaceX 因自家 Grok 團隊在跨站點延遲上遇到困難,才決定將 Colossus 1 整座出租給 Anthropic,Grok 的訓練則移往 Colossus 2(Bloomberg)。TechTimes 引述的合約條件為每月 12.5 億美元,效期至 2029 年 5 月(TechTimes),這條依賴關係的規模與期間,足以讓 Colossus 1 成為 Claude 高階模型算力的重要組成。
Claude 與 Grok 開立事件的時間僅相差 4 分鐘(UTC 13:26 與 13:30)。
Claude 本次受影響的模型全部是 Opus 4.6、4.8、5 與 Mythos/Fable 5、5.1 等高階系列,Sonnet 5 的問題在事件前 30 分鐘就已獨立解決。Anthropic 公開表示 Claude 同時運行於 AWS Trainium、Google TPU 與 NVIDIA GPU 三種硬體(Anthropic 官方公告),Colossus 1 則配置 H100、H200 與 GB200 等 NVIDIA GPU(DCD)。若高階模型的推理叢集有相當比例落在 Colossus 1,故障影響範圍會與本次觀察到的模型清單吻合。此為本文推論,待 Anthropic 公布事後檢討報告驗證。
值得補充的是,Anthropic 本週已是第四次開立多模型或多平台事件,8 月 24 日、8 月 28 日、9 月 1 日與 9 月 3 日各有一次,其中 8 月 28 日明確歸因於上游雲端供應商(status.claude.com)。8 月 24 日與 9 月 3 日兩次受影響的都是 Opus 與 Mythos/Fable 高階模型,是否指向同一批基礎設施,同樣列為待查。
社群上另有兩種流傳說法,本文查證後均無公開資料支持。一是 ChatGPT 也大量使用 Colossus 1,此說與 OpenAI 自行說明的路由錯誤不符,也找不到 OpenAI 與 SpaceXAI 的算力合約紀錄。二是孟菲斯故障為蓄意破壞,目前僅見於社群留言,沒有任何來源,不宜採信。
OpenAI(ChatGPT 與 Codex)
OpenAI 發言人向 The Register 說明,美西時間 9 月 3 日上午 7:43 開始的一次路由錯誤,使 ChatGPT 與 Codex 對部分用戶在各平台上無法使用,約 8:17 已成功套用解決方案並持續監控(The Register)。Engadget 補充 OpenAI 於 9:55 am PT 宣告事件解決,但未進一步說明原因(Engadget)。
OpenAI 的說明沒有提到任何外部供應商,路由錯誤的起始時間也比孟菲斯事件晚了 73 分鐘。以現有資訊判斷,ChatGPT 的故障與 Grok、Claude 屬於不同來源,只是時段重疊。
當天稍晚 OpenAI 正式發表新一代模型 Astra,並透過 Trusted Access Program 分批開放(The Register)。社群猜測發表前的部署變更與路由錯誤有關,OpenAI 並未證實,列為待查。
被排除的假設
事件初期最多人討論的兩個共同故障點,經查證都不成立。
Cloudflare 發言人向 The Register 明確表示 Cloudflare 沒有任何重大服務中斷,系統運作正常,任何與此不符的報導都是錯誤的(The Register)。Cloudflare 狀態頁上 9 月 3 日新增的僅有香港 5xx、西雅圖 522 與 R2 北美西部 503 等區域性小型事件,且均已解決(Cloudflare Status)。
微軟 Azure 的推測來自 9to5Google 的一句「might」,指出 Azure 在 Downdetector 上的回報量同步上升(9to5Google),Axios 隨後引述了這個說法(Axios)。The Register 查核 AWS、Google Cloud 與 Azure 三家的官方狀態頁,均無對應時段的相關事件(The Register)。第三方監測 StatusGator 於 UTC 15:13 檢查 Azure 時也記錄為 operational(StatusGator)。
需要說明的是,「三家都依賴 Azure」並非完全沒有根據。ChatGPT 大量使用 Azure 是公開事實,Anthropic 與微軟、NVIDIA 的策略合作也包含 300 億美元的 Azure 算力(Anthropic 官方公告)。但依賴關係存在與當天 Azure 發生故障是兩件事,目前沒有任何證據支持後者。
各服務實際受影響範圍
ChatGPT 與 Codex
OpenAI 狀態頁列出的受影響元件包含 Conversations、Login、ChatGPT Work、Codex in ChatGPT Desktop、Compliance API、Search、File uploads、Voice mode、GPTs、Image Generation、Deep Research、Agent、ChatGPT Atlas、Sites 以及 Connectors/Apps(LADbible 引述狀態頁)。9to5Mac 觀察到網頁版、行動版與桌面版都受影響(9to5Mac)。
Claude
受影響模型為 Mythos/Fable 5.1、Mythos/Fable 5、Opus 5、Opus 4.8 與 Opus 4.6,Sonnet 5 與 Haiku 系列不在清單內。事件期間 claude.ai、Claude API、Claude Code 與 Claude Cowork 均標示為 Partial Outage,Claude Console 與 Claude for Government 維持正常(status.claude.com)。
Grok
Engadget 依 SpaceXAI 狀態頁計算,Grok 自 6:30 am PT 起中斷約 3.5 小時,影響 Grok on X 以及 iOS、Android 應用程式(Engadget)。撰稿時 SpaceXAI 狀態頁首頁已顯示「No incidents declared」。
Gemini
Google 未開立任何官方事件。多家媒體均指出 Gemini 實際可用,MacTrast 記者更以 Gemini 產出當篇報導的配圖來佐證(MacTrast)。台灣用戶回報的「時好時壞」現象,比較可能是用戶在其他服務故障後湧入 Gemini 造成的負載波動,此推論待查。
下游服務
9to5Google 報導 AI 編輯器 Cursor 因 Grok 與 Claude 異常而宣告事件(9to5Google)。DCD 曾報導 xAI 於 4 月宣布 Colossus 算力將供 Cursor 使用(DCD),這使 Cursor 成為孟菲斯故障的另一個可能受影響對象。但本文查閱 Cursor 狀態頁時,9 月 3 日顯示「No incidents reported today」(status.cursor.com),Cursor 是否曾開立事件後移除,列為待查。
社群回報的災情
Downdetector 顯示所有主要 AI 服務在同一時段出現回報尖峰(Yahoo Tech)。Softonic 整理的高峰數字為美國地區 ChatGPT 逾 35,000 筆、Claude 約 1,400 筆、Grok 約 1,200 筆,印度地區分別為 2,800、170 與 40 筆(Softonic)。Pulsetic 統計 Claude 的用戶回報中,歐洲佔 50%、北美佔 20%、亞洲佔 18%(Pulsetic),反映事件發生時段正值歐洲下午與美國上午的高峰用量。
社群反應主要集中在三個面向。第一,同時依賴多家模型的開發者發現多模型備援失效。第二,用戶回報包括提示失敗、對話卡住與 API 錯誤(Sunday Guardian)。第三,DeepSeek 與 Perplexity 在事件期間維持可用,成為部分用戶的臨時替代方案(Time News)。
對企業用戶的實務觀察
本次事件揭露的風險比「多雲備援」更深一層。Claude 與 Grok 表面上是兩家互相競爭的模型供應商,實際上共用同一座資料中心園區的算力。企業在 API 層做的模型切換,如果兩個目標模型的推理叢集恰好落在同一個實體設施,備援設計形同虛設。
對於已將 LLM 納入營運流程的組織,有幾件事值得在事後檢視。
備援設計除了切換模型供應商,是否也考慮供應商之間的算力租賃關係。這類關係通常會出現在供應商的公開公告或財報中,例如 Anthropic 租用 Colossus 1、Google 租用 SpaceX 約 110,000 顆 GPU(Wikipedia 整理),值得納入供應鏈風險評估。
是否有降級模式,例如在模型不可用時切換到自建或地端推理,或退回無 AI 的人工流程。
監控是否直接訂閱各供應商狀態頁的 RSS 或 webhook,而非依賴 Downdetector 這類延遲較大的間接訊號。
對外服務的 SLA 是否已明確排除上游 AI 供應商故障,或者已備妥對客戶的溝通範本。
延伸閱讀
SpaceXAI 於 X 的致歉聲明 https://x.com/SpaceXAI/status/2095597264043717014
Anthropic 狀態頁與事件頁 https://status.claude.com/ 、https://status.claude.com/incidents/461yvfrzpwtt
OpenAI 狀態頁與事件頁 https://status.openai.com/ 、https://status.openai.com/incidents/01M1KWEDH417T2CF44YYHZDFCR
SpaceXAI 狀態頁與事件頁 https://status.x.ai/ 、https://status.x.ai/grok-com/INC25664c15
Cloudflare 狀態頁 https://www.cloudflarestatus.com/
Cursor 狀態頁 https://status.cursor.com/
9to5Google https://9to5google.com/2026/09/03/chatgpt-claude-grok-outages/
9to5Mac https://9to5mac.com/2026/09/03/chatgpt-and-codex-are-experiencing-an-outage-for-many-users/
LADbible https://www.ladbible.com/technology/ai-chatgpt-gemini-grok-claude-down-921448-20260903
MacTrast https://www.mactrast.com/2026/09/chatgpt-claude-and-grok-are-all-currently-having-issues/
Time News https://time.news/chatgpt-claude-and-grok-suffer-rare-simultaneous-global-outage/
Ground News https://ground.news/article/ai-outage-claude-chatgpt-and-grok-are-currently-down-for-many-users
Pulsetic Claude 監測 https://pulsetic.com/status/claude/
StatusGator Azure 監測 https://statusgator.com/services/azure/microsoft-azure-portal