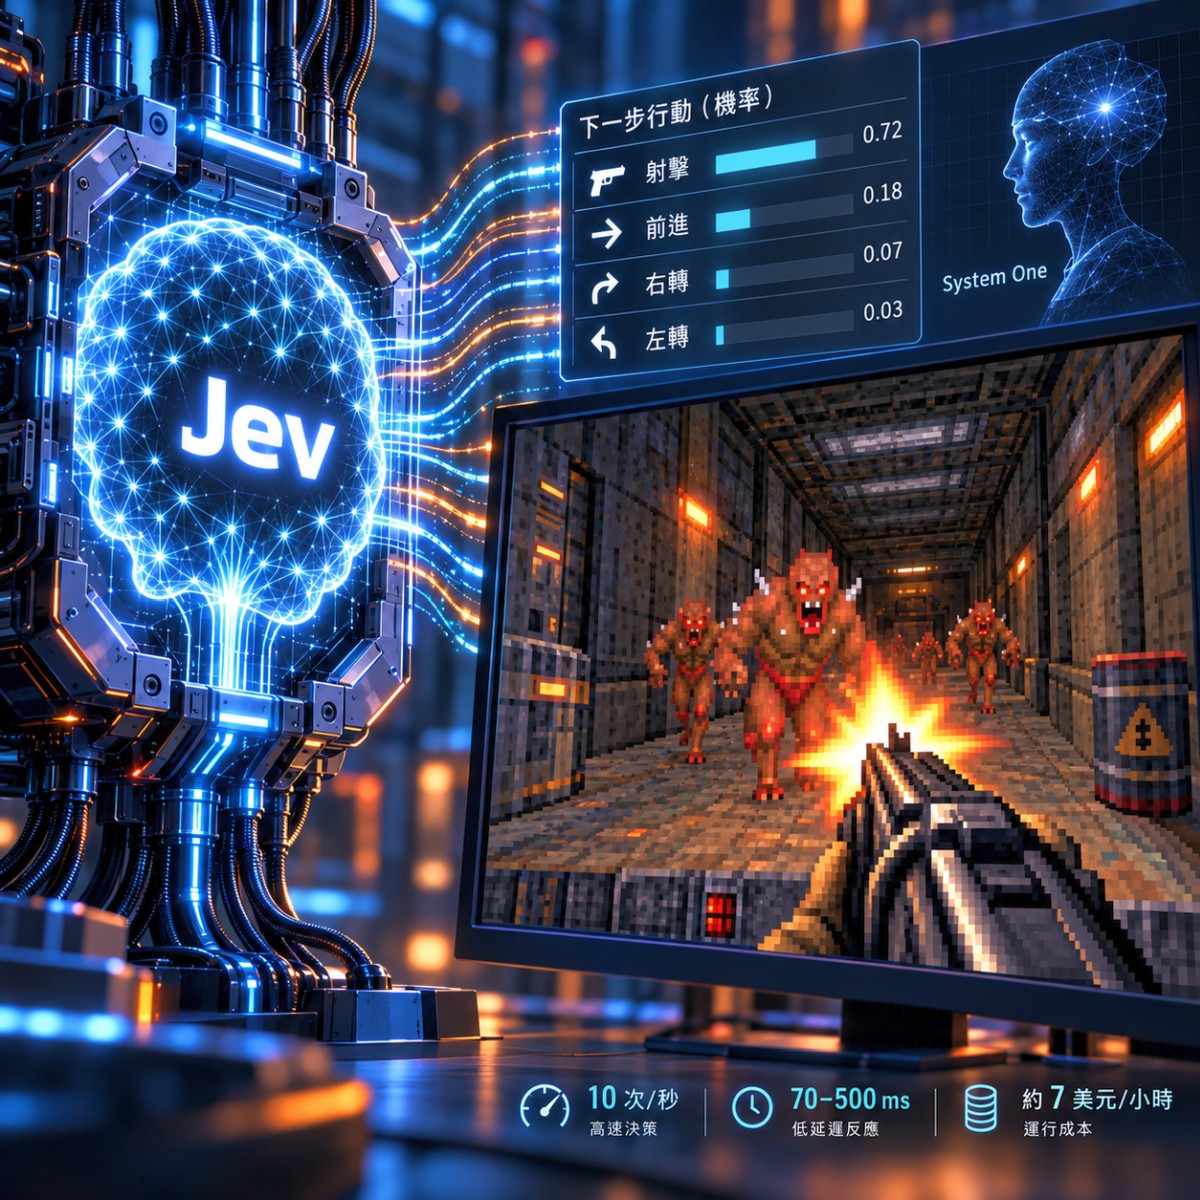
Ziwen 近日在 X 平台轉貼一段 AI 即時遊玩 Doom 的影片,他形容畫面看起來像真人玩家,並引用開發商的數字,速度快 20 至 200 倍,成本低 40 至 400 倍,輸出 token 免費。他在貼文中推測兩種可能的發展,其一是未來遊戲裡的對手可能是即時 AI,其二是助教這類原本需要聘請真人的工作可以改由這類模型執行。他也計算出來,每秒 10 次呼叫等於每小時 36,000 次,費用約 7 美元。影片中的主角是新創公司 TypeSafe AI 於 9 月 15 日發表的模型 Jev。
Jev 的定位
TypeSafe AI 已取得 4,000 萬美元資金 (TypeSafe AI debuts model for machines that plays Doom),Jev 的設計目的在於與機器互動,模型不回傳自然語言,改為回傳具型別的機率式決策,供其他軟體或 AI 模型使用。共同創辦人暨執行長 Diogo Almeida 曾任 OpenAI 研究員,為 RLHF 與 ChatGPT 的共同發明人之一。另外兩位共同創辦人為曾任職 Meta 與 FAIR 的研究工程師 Sasha Sheng,以及曾創辦基因體 AI 新創 Ravel 的 Erik Gafni。
官方將 Jev 歸類為「System One Model」。此名稱取自康納曼《快思慢想》中快速直覺的系統一思考,Jev 則以提出傑文斯悖論的經濟學家 William Stanley Jevons 命名,團隊預期智慧成本每下降一個數量級,會帶來數個數量級的新用途。
使用方式上,開發者先提供一個狀態值,可以是 JSON 物件或一句文字,再透過 Choice、Score、Noul 三種提問原語取得附帶機率的結構化回應。以客服分流為例,模型可能回傳帳務 0.08、技術 0.85、業務 0.07 的機率分布,並附上 0.82 的信心分數。
速度與價格的數字來源
TypeSafe 表示為此建立了全新技術堆疊,包含新的模型架構、平行取樣器,以及名為 RLCD(Reinforcement Learning for Calibrated Decisions)的訓練方法。一般 LLM 逐一預測下一個 token,屬於循序運算,System One 架構則一次回傳查詢的所有輸出。
官方公布的主要數字如下。端到端回應時間為 70 至 500 毫秒,官方對照的尖端模型回應時間為 3 至 329 秒,在 System One 類型的查詢上約快 40 至 200 倍。官網示範中 Jev 以 0.114 秒回應,OpenAI GPT-5.6 Terra 為 8.566 秒。價格方面,Jev 輸入為每百萬 token 0.042 美元,輸出為 0 美元,GPT-5.6 Terra 則為輸入 2 美元、輸出 12 美元。
需要留意的是,Almeida 在 X 的貼文寫的是快 20 至 200 倍、便宜 40 至 400 倍,與部落格的 40 至 200 倍略有出入。官方說明首頁的 193.6 倍與 444.6 倍出自其自製的工作流程評測,並預期這是實際效益的偏高值。
Doom 示範的實際條件
官方部落格指出,負責的工程師原本擔心每秒 10 次查詢的費用,結果每小時約 7 美元,團隊認為低於預期,後續將發布完整教學並舉辦相關活動。
依官方定價反推,每小時 36,000 次呼叫花費 7 美元,每次呼叫約 0.000194 美元,相當於每次輸入約 4,600 個 token。
官方也主動揭露了幾項限制。示範使用的是以資料結構加文字表示的遊戲狀態,尚未處理影像,而且非 AI 的 Doom 機器人可以玩得更好,團隊想展示的是能對不同遊戲狀態表示做出反應並遵循指令的機器人。因此 Ziwen 所說「看起來像真人玩家」屬於個人觀感,Jev 目前並未像人類一樣透過畫面進行遊戲。
外界的質疑
The Register 指出,TypeSafe 宣稱 Jev 沒有幻覺,這項比較並不公平,因為其輸出本來就不是自然語言,附帶機率的結構化回應仍然可能出錯。
工程師 Sean Goedecke 撰文分析,Jev 的速度主要來自推論策略,也就是針對受限選項只產生單一 token,未必源於全新的模型架構。他在 Qwen2.5-1.5B-Instruct 上以預填回應前綴並限制單一 token 輸出的方式測試,相較一般結構化輸出取得 2 至 3 倍加速,據此認為專用模型未必具備強大的技術護城河。不過他對快速結構化輸出開啟非聊天機器人應用的前景持樂觀態度。
Runtime Wire 則提醒,Jev 目前僅開放候補名單,外界難以全面驗證其效能宣稱,評測數據仍出自 TypeSafe 自身。TypeSafe 也坦承部分限制,例如定價是否有補貼無法由外部證明,工作流程評測由內部模型能力團隊製作,可能存在偏誤。
對即時應用的意義
Ziwen 的核心論點是,過去凡是需要跟上人類反應速度的應用,LLM 都難以勝任,如今延遲降到 500 毫秒以內、每小時成本降到個位數美元,情況可能改變。官方列出的適用場景包含 AI 工作流程中的智慧條件判斷、大規模資料的 map-reduce 分類、重視使用者體驗的即時應用,以及對 LLM 提示、推理軌跡與輸出進行評分、驗證、護欄與越獄偵測。最後一項與資安領域直接相關,若延遲與成本數字經得起獨立驗證,在代理式 AI 的每一次工具呼叫前後加上一層即時檢查,成本上將變得可行。
至於「取代助教或真人職務」的推論,目前缺乏佐證。Jev 無法產生文字,僅能在預先定義的選項中做出判斷,單次選擇的選項上限為 255 個,超過時需採兩階段處理。需要解說、對話的工作仍須搭配傳統 LLM 或既有程式邏輯,Jev 較適合擔任其中的快速決策元件。