中國阿里巴巴 Qwen 團隊於 2026 年 9 月 20 日釋出 Qwen-Image-2.1,權重同步上架 Hugging Face 與 ModelScope。這是一款把文生圖與影像編輯整合在同一組權重內的模型,視覺生成部分僅 7B 參數,採 32 層 Single-Stream DiT。相較於 2025 年 8 月推出的初代 Qwen-Image,當時為 20B 參數的 MMDiT 架構,這次的規模明顯縮小,對本地部署的使用者是實質利多。不過授權條款同步改變,商用情境需要特別留意,我們文章下方會說明。
這次模型將文生圖與圖像編輯兩大功能完全整合在同一個模型內,我們就不用再分開載入兩個獨立模型,大幅降低部署成本與硬體門檻。這次開放下載首日,即獲得 Diffusers、ComfyUI、vLLM-Omni 及 SGLang 的原生支援,本地工作流可以直接部署使用。原生已經支援 2K 圖片以及自帶 Alpha 通道的透明背景圖片(RGBA)生成與編輯。此外,它最高支援同時輸入 10 張參考圖,能夠在保留人像與商品圖片模樣的情況下,進行多圖合成或局部修改。
發布過程
Qwen 開發者帳號在 9 月 17 日預告 2.1 將開源,並透過 ModelScope 開放 50 個搶先體驗名額,條件是入選者須發表至少一篇原創展示或實測評論。官方在倒數貼文中強調這次釋出包含權重與程式碼。
就產品線定位而言,上一個版本 Qwen-Image-2.0 已於 2026 年 2 月 10 日推出,主打文字排版渲染改善與更輕量的架構(AlternativeTo 時間軸)。另有報導指出 3.0-Pro 維持雲端託管產品路線,2.1 則是開放權重路線。
四項官方主打重點
依官方模型卡說明,這次更新聚焦四個面向。
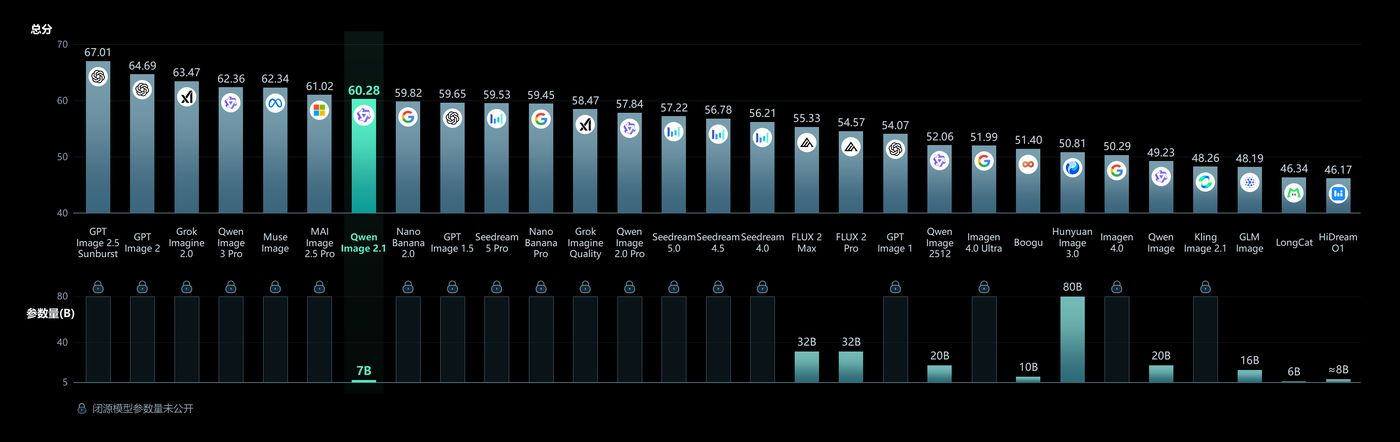
第一是輕量高效率。模型採用混合粒度注意力機制並重複利用前綴 KV 快取,以較低運算成本維持影像品質。CyberQ 實測,出圖速度確實很快,但品質就見仁見智了。
第二是原生透明通道。模型可由文字直接生成一般影像或 RGBA 透明影像,也能編輯透明圖層,或從照片中擷取主體。過去開源生態要取得透明背景素材,多半得外掛去背模型或 LayerDiffuse 這類方案,現在收斂到單一模型內。
第三是多樣化編輯。最多支援 10 張參考圖,可用圈選、塗鴉標註或獨立遮罩指定局部編輯範圍,並維持人物與產品的一致性。官方展示案例包含以六張個人肖像合成團體照,以及用模特兒、服裝、鞋、包、帽五張參考圖組出完整穿搭。
第四是質感與美學。官方表示文字排版、人像光影與細節皆有改善。
架構解析
GitHub 說明文件有提到該模型的架構資訊。
| 元件 | 規格 |
|---|---|
| Transformer | 32 層、7B 參數,單流架構,區塊因果注意力 |
| 文字編碼器 | Qwen3-VL 8B,同時編碼文字指令與條件影像 |
| VAE | 64 通道 RGBA 自編碼器,空間壓縮 16 倍 |
| 排程器 | Flow Matching,Euler 離散排程與動態位移 |
| 預設輸出 | 2048 × 2048,40 步去噪 |
注意力設計上,文字使用 token 層級的因果遮罩,影像則使用區塊層級的雙向遮罩。這個設計是前綴 KV 快取能夠成立的關鍵。輸入影像與文字指令只在第一個去噪步驟計算一次,之後所有步驟直接重複使用快取,官方指出此機制對帶有多張條件影像的編輯任務加速效果特別明顯。
解析度方面,模型原生支援 2K,官方另提供 4:3、3:2、16:9 及其直式版本共七種建議長寬比,16:9 對應 2752 × 1536。
CyberQ 需要提醒讀者的是,「7B」指的僅是生成用的 DiT。加上 8B 的文字編碼器後,完整管線的總參數量約在 15B 上下,記憶體規劃要以整條管線計算。
官方提示詞改寫模型
官方強烈建議搭配提示詞改寫模型使用。這次一併釋出兩個以 Qwen3.5-VL 9B 微調的檢查點,PE-T2I 對應文生圖,PE-I2I 對應影像編輯,共用同一套程式碼並依輸入自動判斷模式。改寫結果除了擴寫後的長提示詞,還會輸出建議長寬比,編輯模式下則可指定沿用某張輸入圖的比例。
這代表若要重現官方展示品質,實際上得再多跑一個 9B 模型。
生態系首日支援
這次的首日整合相當完整,以下依 GitHub 說明文件整理。
| 框架 | 支援內容 |
|---|---|
| Diffusers | QwenImage21Pipeline,單一管線處理文生圖與影像條件生成 |
| ComfyUI | 原生支援,提供相容權重與文生圖、影像編輯兩份範例工作流程 |
| vLLM-Omni | 逐步執行、前綴 KV 快取、CUDA Graph、FP8 量化、TP/Ulysses 平行,OpenAI 相容 images/generations 端點 |
| SGLang | 前綴快取、Cache-DiT、CUDA Graph、多種平行策略、元件卸載 |
| LightX2V | 首日加速方案,支援文生圖與編輯 |
硬體面向,官方提到可透過 ROCm 在 AMD Radeon GPU 執行,並藉由 FlagOS 軟體堆疊釋出 8 種晶片平台的預建映像檔與權重。ModelScope 則以 DiffSynth-Studio 框架提供下載、線上生成與 LoRA 訓練。
檔案大小與硬體門檻
以 Comfy-Org 釋出的檔案為準,各版本體積如下。
| 元件 | 精度 | 檔案大小(GB) |
|---|---|---|
| 擴散模型 | bf16 | 14.2 |
| 擴散模型 | int8_convrot | 7.26 |
| 文字編碼器 Qwen3-VL 8B | bf16 | 17.5 |
| 文字編碼器 Qwen3-VL 8B | int8_convrot | 9.35 |
| 文字編碼器 Qwen3-VL 8B | w4a8 | 6.31 |
依檔案大小粗估,全 bf16 組合的權重約 31.7 GB,最小量化組合(int8 擴散模型搭配 w4a8 文字編碼器)約 13.6 GB。這只是權重體積,2K 解析度下的活化值與 VAE 解碼還會額外佔用記憶體。官方僅建議記憶體有限的 GPU 啟用 enable_model_cpu_offload。
授權條款為最需留意之處
CyberQ 觀察,模型頁面標示的授權為 Qwen Research License Agreement。仔細閱讀授權全文後,有別於過去的商業授權,改採用 Qwen Research License。該協議僅允許非商業的研究與評估,若有商業使用需求,必須另外向千問官方申請授權。詳細如下:
授權範圍限於非商業用途,條文將「非商業」定義為僅供研究或評估目的。
若要商用,須另行向官方申請商業授權。
若使用模型或其輸出結果來訓練、微調或改進其他對外發布的 AI 模型,須在產品文件中顯著標示 Built with Qwen 或 Improved using Qwen。
衍生作品不得以 Qwen 作為主要名稱,但允許「fine-tuned from Qwen Image」這類合理的描述性使用。
準據法為中國法律,管轄法院為杭州市人民法院。
初代 Qwen-Image 採用 Apache 2.0 授權,可自由商用。若屬實,2.1 的授權明顯收緊。對於打算把模型接進商業產線的設計公司、電商或 MSP 客戶而言,現階段只能用於內部評估,正式上線前須取得商業授權。
外界部分報導以「開源」稱呼這次釋出。嚴格來說,這是附帶非商業限制的開放權重,並不符合 OSI 定義的開源授權,CyberQ 本文標題因此採用「開放權重」一詞。
快速上手
CyberQ 建議,安裝需求依官方文件為 torch 2.4.0 以上、transformers 5.17 以上,Diffusers 需從 GitHub 主分支安裝。
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt="一張夜市霓虹招牌,上面寫著「鹽酥雞」,雨夜,地面有倒影",
    width=2048, height=2048,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("t2i.png")
編輯模式只需在同一管線多傳入 image 參數,單張傳 PIL 影像,多張參考圖則傳入串列。透明影像生成請使用官方建議的提示詞格式,開頭註明 This is an RGBA image with transparency,結尾註明 The image has alpha channel and the background is transparent。
Qwen-Image-2.1 部署門檻比前一代更低,AI 產圖模型將再起波瀾
Qwen-Image-2.1 把生成、編輯、透明圖層與多參考圖合成收進一個 7B 的 DiT,配合前綴 KV 快取與首日到位的 ComfyUI、vLLM-Omni、SGLang 支援,本地部署的門檻比初代 20B 模型低了一截。代價是授權轉為非商業研究授權,以及若要達到官方展示品質,實務上還得搭配 8B 文字編碼器與 9B 提示詞改寫模型一起運作。