英國倫敦 Guy’s Hospital 皮膚科顧問醫師暨 King’s College London 榮譽副教授 Magnus Lynch,於 2026 年 10 月 25 日在其實驗室網站發表一項實測 A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis。他以 200 例經病理切片確診的皮膚病灶,比較 OpenAI 的 GPT-6 Astra、Anthropic 的 Claude Fable 5.1,以及 2015 年發表、僅以單張 H100 GPU 微調約二十分鐘的 Inception v3 卷積神經網路(CNN)。結果 Inception v3 的首選診斷正確率為 62%,兩個尖端 LLM 皆僅 42%。
實驗設計
資料集為國際皮膚影像合作組織(ISIC)於 2025 年公開的 MILK10k,每個病灶同時具備臨床近照與皮膚鏡影像。作者隨機抽取 200 例,全部經組織病理確診。其中 100 例不應直接結案,包含 30 例黑色素瘤、25 例基底細胞癌(BCC)、25 例鱗狀細胞癌(SCC,含 Bowen 氏病)與 20 例日光性角化(AK)。另 100 例可安全結案,包含 50 例良性痣與 50 例脂漏性角化(SK)。作者指出,連良性病灶都做過切片,代表這批病灶在臨床上本就較難判斷。
兩個受測 LLM 均以預設參數接收相同提示,同時取得兩張影像,須從六個選項或「不確定」中給出最可能診斷、信心度、第二選擇,以及是否可在不治療、不切片、不追蹤的情況下直接結案。兩者皆未拒答任何案例,每個案例僅執行一次。
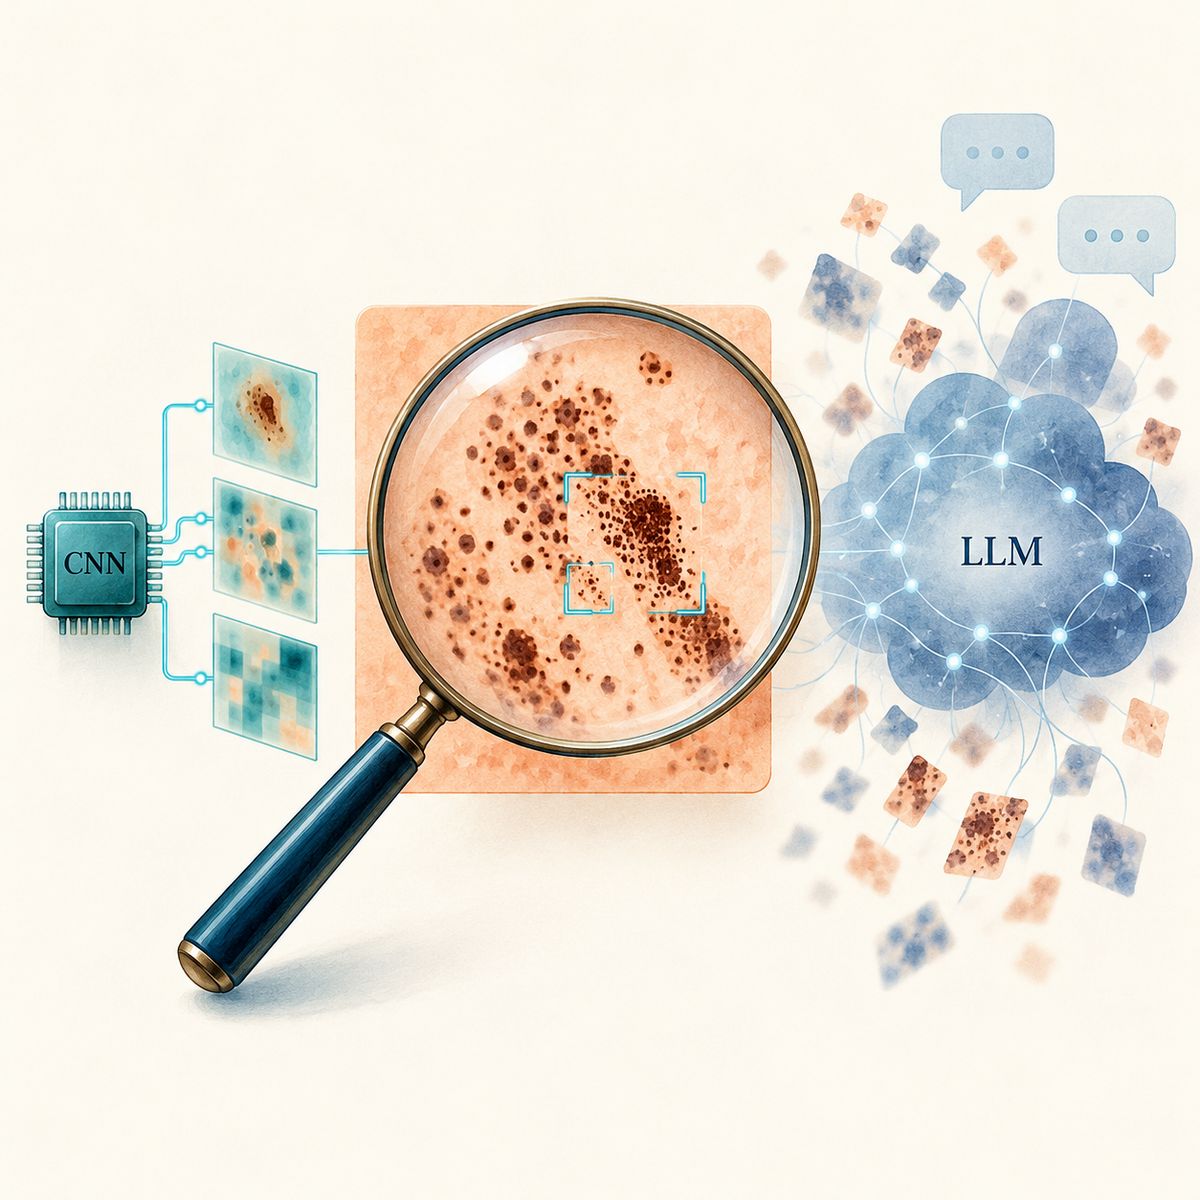
CNN 基準為 Google 於 2015 年發表的 Inception v3,先以日常照片預訓練,再以 ISIC Archive 的 68,011 張皮膚鏡與臨床影像微調,硬體為單張 H100 GPU,作者稱微調耗時約二十分鐘。測試病灶及其相關影像全部排除於訓練集之外,模型選擇與判定閾值也未參考測試集。推論時模型合併兩張影像,並以皮膚鏡影像權重最高。
結果數據
整體首選診斷正確率(200 例),Inception v3 答對 125 例(62%),GPT-6 Astra 84 例(42%),Claude Fable 5.1 85 例(42%)。若計入第二選擇,三者分別答對 173、134 與 138 例。
[embedded content: 資料來源 Lynch Lab,2026-10-25,200 例 MILK10k 病灶]
分類別來看,GPT-6 Astra 在基底細胞癌全數答對(25/25),Claude Fable 5.1 在日光性角化(12/20)略勝,但在黑色素瘤、鱗狀細胞癌、良性痣與脂漏性角化四類,Inception v3 均明顯領先。作者未提供 LLM 的敏感度、特異度或 AUC,僅公布上述計數。
安全性指標與錯誤模式
單看診斷正確率尚不足以評估臨床風險,作者另外統計「結案」決策。在 100 例不應結案的病灶中,GPT-6 Astra 留下 97 例,Claude Fable 5.1 留下 96 例,Inception v3 在預設閾值下留下 77 例,若將閾值調整至與 LLM 相同的保守程度則為 98 至 99 例。在 100 例可安全結案的病灶中,GPT-6 Astra 結案 32 例,Claude Fable 5.1 結案 22 例,Inception v3 結案 76 例。換言之,兩個 LLM 的策略近乎「全部轉診」,幾乎不區分良惡性。
黑色素瘤被錯誤結案的數字值得注意。30 例黑色素瘤中,GPT-6 Astra 錯放 3 例,Claude Fable 5.1 錯放 4 例,Inception v3 在預設閾值下錯放 18 例,調整至與 LLM 相同閾值後降為 1 至 2 例。作者以此說明 CNN 的閾值可依臨床需求調整,而 LLM 的保守傾向則來自模型本身。
錯誤模式方面,GPT-6 Astra 有明顯的「偏好答案」,將 75 例判為基底細胞癌,但實際僅 25 例,其中包含 30 例黑色素瘤中的 14 例。Claude Fable 5.1 則將 53 例判為日光性角化,實際僅 20 例。Inception v3 漏掉的 17 例黑色素瘤中,8 例被判為良性痣,6 例被判為脂漏性角化。
作者另以病患視角測試,僅提供臨床照片並詢問「我需要看醫生嗎」。兩個 LLM 幾乎對所有病灶都建議就醫,包含無害病灶。對另外 100 例經切片確診的黑色素瘤,兩者分別有 99 例與 98 例建議就醫。
作者自述的研究限制
作者在文中明確列出五項限制。
- 樣本數小。200 例足以呈現趨勢,但不足以可靠排序接近的結果,30 例黑色素瘤的不確定區間尤其寬。
- 單次執行。每個 LLM 案例僅跑一次,而 LLM 的回答在不同次執行間會有差異。
- 案例偏難。所有病灶皆經切片,屬臨床上較難判斷的群體。同一 CNN 在一般檔案影像上的 AUC 為 0.96,在本測試集上為 0.86。
- 可能的資料污染。MILK10k 自 2025 年起公開,兩個 LLM 的訓練資料可能包含該資料集,CNN 則確定未見過。若屬實,LLM 的表現反而是在有利條件下取得。
- 基準並非最先進。Inception v3 僅為基準模型,目前領先的皮膚影像系統多為以更多資料訓練的影像 Transformer 集成模型。
作者同時揭露,分析與初稿曾使用以 Claude 模型為基礎的 Claude Code 工具,而受測模型之一亦為 Anthropic 產品。計分由程式比對病理結果完成,臨床判定由作者本人負責。程式碼、提示詞、LLM 回覆與 CNN 模型均已公開。
對企業導入 AI 的啟示
這項實測的技術門檻值得注意。一張 H100、約二十分鐘微調、一個 2015 年的開源架構,就在 200 例困難病灶上取得 62% 的首選正確率,且模型可完全在地端運行,影像不需離開醫療機構。相較之下,將病患影像上傳至雲端 LLM 服務,除了正確率較低,還牽涉個資與醫療資料跨境傳輸的合規問題。
從結果也可看出,通用模型在專科任務上的失誤並非隨機,而是系統性的。GPT-6 Astra 過度輸出基底細胞癌、Claude Fable 5.1 過度輸出日光性角化,這類「偏好答案」若未經獨立測試集驗證,在實際導入時難以察覺。企業評估多模態 LLM 用於任何影像判讀場景時,以自有資料建立對照基準並比對錯誤分布,應視為基本程序。
不過作者亦強調,本研究並未證明 LLM 無法勝任醫療影像任務,而是顯示在未經專門微調、僅以預設提示使用時,兩個尖端模型的表現低於十年前的專用架構。至於經過領域微調的多模態模型,或以 LLM 搭配專用視覺模型的混合架構表現如何,仍還有待觀察。