Google 在官方部落格宣布推出新一代 Gemini 模型「Gemini 4 Argon」,這則新聞之所以值得關注,不只是因為 Google 又一次端出旗艦級 AI 模型,更因為它牽動整個生成式 AI 市場的競爭節奏,也讓外界重新評估各家大廠在模型能力、應用場景與生態布局上的下一步。
Gemini 4 Argon 是什麼
根據 Google 官方部落格說明,Gemini 4 Argon 是 Gemini 系列的最新版本,定位為新一代的多模態模型,能同時處理文字、圖像等不同形式的輸入。Google 將它放在創新與 AI 以及模型與研究的產品脈絡下發表,顯示這不只是單一功能更新,而是整個 Gemini 模型家族的一次重要推進。
從命名來看,「Argon」延續了 Google 以元素或代號區分模型版本的習慣,也暗示這是一個具有明確世代意義的版本。對開發者與企業用戶而言,這代表他們可以期待更穩定的模型選擇,以及更清楚的升級路徑。
技術背景與多模態意義
多模態一直是近年生成式 AI 的核心戰場。所謂多模態,指的是模型不再只理解文字,而是能跨足圖像、聲音或其他形式的資料,並在不同模態之間建立關聯。Gemini 系列從一開始就主打這條路線,Gemini 4 Argon 的推出,等於把這條技術路線再往前推一步。
對實際應用來說,多模態能力意味著更自然的互動方式。使用者可以上傳圖片、搭配文字提問,讓模型直接理解畫面內容並給出回應,這在客服、內容創作、教育與醫療等場景都具備想像空間。Google 選擇在此時發表,也反映它希望把模型能力直接對接自家產品與雲端服務。
單次輸出百萬 Token:長推論軌跡的架構突破
Argon 最顯著的架構革新,在於將單次生成的輸出上限從過往的 64K 大幅拉升至 100 萬(1M)Token。相較於市場競爭對手 GPT-6 Astra 將單次輸出限制在 128K Token,Argon 讓自主 Agent 具備在單一軌跡中持續進行數十萬甚至百萬 Token 深度思考與程式碼產出的餘裕。
在實際的工程場景中,這項規格改變了解決問題的本質。過往模型在面對全專案重構或跨多檔案的除錯工作時,常因觸碰輸出上限被迫進行上下文切割或接力生成,造成狀態遺失(state loss)並導致推論偏離。Argon 提供了足夠的緩衝空間,讓複雜思考鏈與生成結果能完整收斂於單次請求中。
在計費架構方面,Google 公布的早期 API 優惠費率為每百萬輸入 Token 2 美元、每百萬輸出 Token 10 美元(後續將調整為輸入 4 美元、輸出 20 美元)。同時,Google 針對快取輸入提供高達 95% 的費用折抵,使快取輸入成本降至每百萬 Token 0.10 美元。對於高度依賴大量系統提示詞與龐大軟體庫快取的企業級自動化工作流而言,這項定價結構具備實質的部署可行性。
內部基礎架構實戰:從作業系統核心到向量化解碼器
CyberQ 觀察,有別於僅以合成評測為主的宣傳策略,Google 在發布時特別強調了 Argon 在內部生產環境的實作成果。在程式碼重構方面,Argon 被指派執行將 C 與 C++ 程式庫遷移至 Rust 語言的任務。這項專案從小型的基礎核心函式庫(如 re2 與影音解碼器 libgav1),擴展至 Fuchsia OS 的 Zircon 微核心,涉及超過 80 萬行的系統程式碼重寫,所有產出均經過嚴格的模擬器測試與自動化稽核。
其中最具技術指標意義的案例為開源解碼器 libgav1 的重構。Argon Agent 針對 3.2 萬行手寫的 SIMD 組合語言程式碼,透過剖析導向(profile-guided)的多輪實驗,持續分析編譯器輸出並調整架構,最終讓編譯器能自動將安全 Rust 程式碼向量化。該專案最終在確保影音位元完全一致的前提下,達成了比原版 Rust 移植版本快 2.7 倍的執行速度。
在資料中心伺服器叢集的管理上,Argon 團隊透過分析全機隊的效能剖析遙測資料,自主識別記憶體分配模式並套用最佳化設定,目前已在線上生產環境釋放超過 300 TiB 的記憶體容量,預期後續全面套用後的節省總量將達到 500 TiB 至 1 PiB。在量子運算研究領域,Argon 亦協助對演算法的時空資源(Qubit 與邏輯閘的乘積)進行排程最佳化,在數分鐘內將既有基準數值提升了 40%。
基準測試綜合評析:強弱並存的真實工程水準
Google 公布的官方測試資料涵蓋了 19 項指標,展示出模型在真實工程與多模態分析上的優勢,但也呈現出評測工具不同所導致的效能落差。
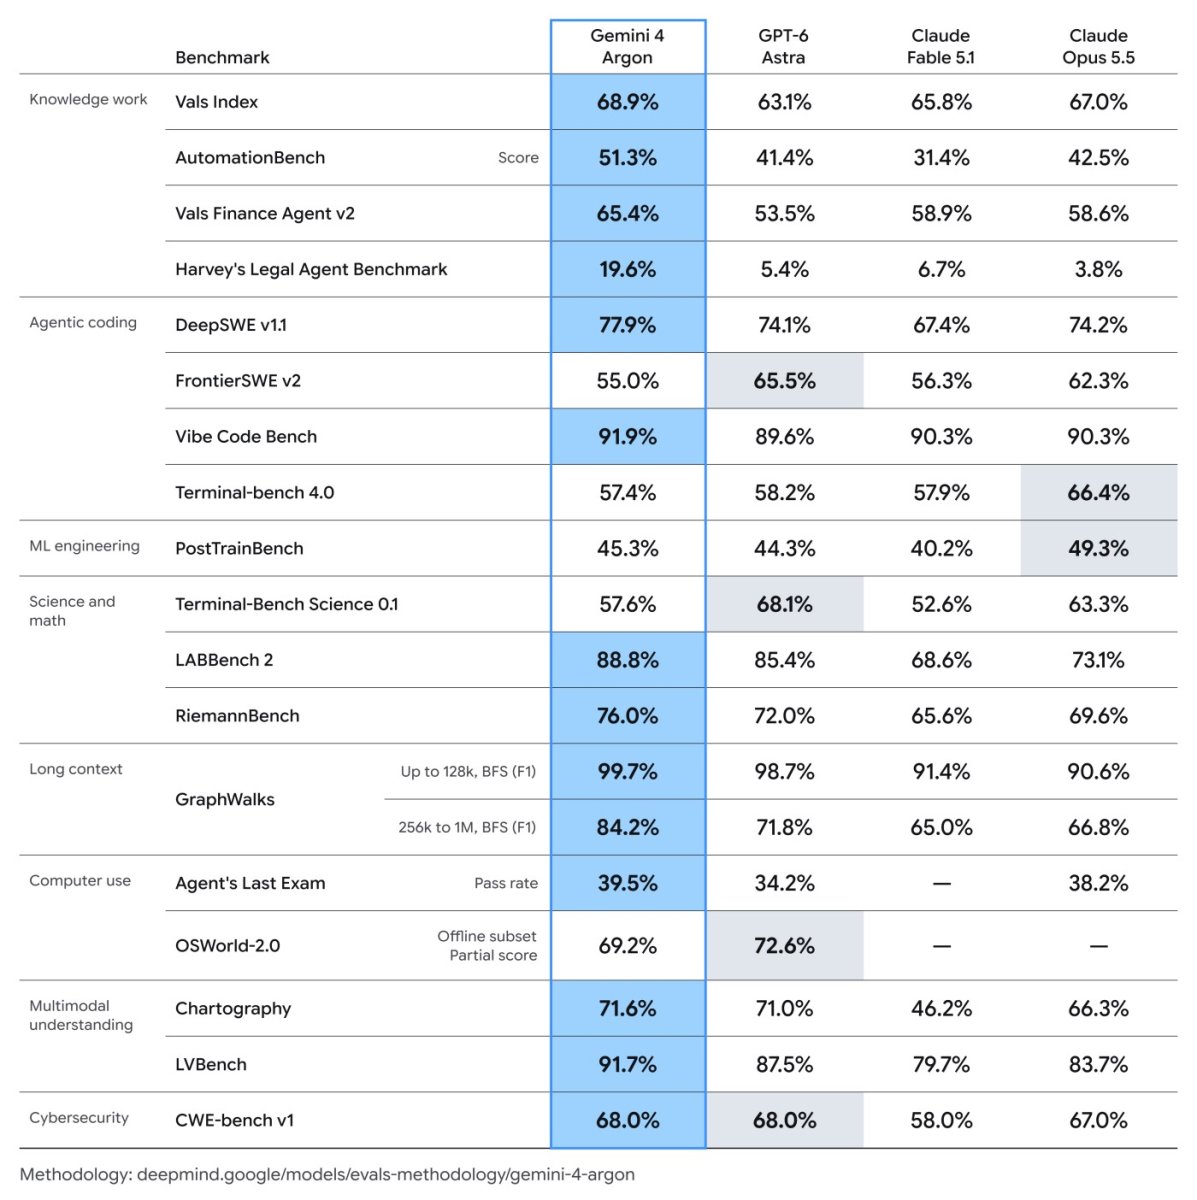
從官方發布的完整評測矩陣可以看出,Argon 在多項長流程與多模態任務上取得領先,但在特定終端環境中亦面臨挑戰:
| 評測類別 | 基準測試指標 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
| 專業知識分析 | Vals Index | 68.9% | 63.1% | 67.0% |
| 企業流程自動化 | AutomationBench | 51.3% | 41.4% | 42.5% |
| 軟體工程修復 | DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| 前沿軟體工程 | FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| 終端機指令互動 | Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% |
| 資安漏洞修復 | CWE-bench v1 | 68.0% | 68.0% | 67.0% |
| 長影片理解能力 | LVBench | 91.7% | 87.5% | 83.7% |
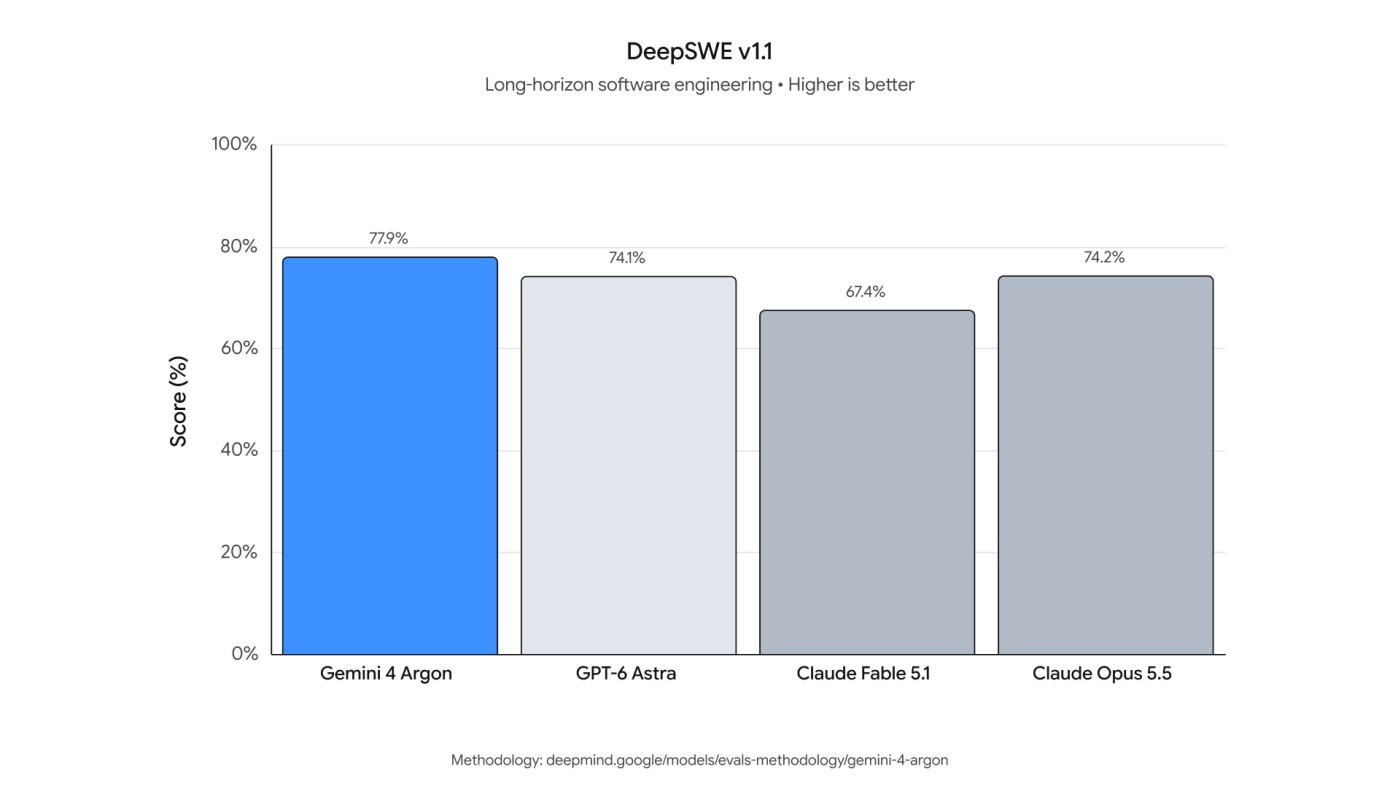
在真實軟體修復測試 DeepSWE v1.1 中,Argon 繳出 77.9% 的分數,高於 Claude Opus 5.5 與 GPT-6 Astra。然而在另一項嚴苛的 FrontierSWE v2 評測中,Argon 的表現為 55.0%,落後於 GPT-6 Astra 的 65.5% 達 10.5 個百分點。在 Terminal-bench 4.0 測試中,Argon 獲得 57.4%,同樣遜於 Claude Opus 5.5 的 66.4%。這項落差反映出不同測試框架採用的 Agent 腳手架存在差異,也突顯出 Argon 在複雜終端環境下與特定競爭對手相比仍有成長空間。
在企業知識自動化部分,Argon 於衡量端到端業務功能執行的 Zapier AutomationBench 取得 51.3%,位居首位。在專業金融、法律與稅務工作為導向的 Vals Index 綜合評估達到 68.9%。針對長影片內容解析的 LVBench,Argon 則達到 91.7%,證明其在跨模態資料整合時的穩定度。
資安防禦雙刃劍:Fairwind 計畫與模型內部激發監控
在資安漏洞評估測試 CWE-bench v1 中,Argon 取得 68.0% 的水準,與 GPT-6 Astra 並列頂尖;在內部滲透測試評估中,未受限版本更展現出 70.9% 的漏洞挖掘能力。具備高度自主挖掘並修復漏洞能力的模型本質上是一把雙面刃,既能作為防護團隊的自動化修補利器,也能被惡意行為者轉化為漏洞利用工具。
考量到這一層重大風險,Google 採取了嚴格的分階段釋出策略。首波存取權限並未開放給一般大眾,而是僅透過受審核的「Fairwind 計畫」,優先提供給政府與具備防禦資格的資安機構進行主動測試與系統補強,確保防禦方在技術全面擴散前掌握主導權。
在安全對齊架構上,Argon 導入了突破性的「模型內部激發監控」(Internal-Activation Monitoring)技術。過往大語言模型多半採用輸入過濾或輸出端評分機制,容易受到精細設計的提示詞注入攻擊繞過。Google 改為直接在推論過程中即時監控模型內部神經元的激發狀態,一旦捕捉到模型意圖執行超出預期權限、網路攻擊或涉及化學、生物、放射性與核能(CBRN)等高危害任務,防護層能在推論期間即時強制中斷執行。
對市場與開發者的影響
Gemini 4 Argon 的登場,讓生成式 AI 市場的競爭再度升溫。Google 透過官方部落格直接發布,等於向開發者與企業客戶喊話:新一代模型已經準備好,可以納入產品與工作流程。這也迫使其他大廠必須加快腳步,回應市場對模型能力與應用整合的期待。
技術社群對 Google 的模型進展高度關注。社群不只關心發表了什麼,更在意能不能用、怎麼用、成本多少。這類討論往往會延伸到 API 定價、推論速度、部署方式與資料隱私等實務問題,而這些正是企業採用 AI 模型時最在意的環節。
對開發者而言,模型世代更新通常伴隨 API 變動、遷移成本與相容性問題。若 Gemini 4 Argon 能提供更強的多模態理解與更穩定的服務品質,將有助於吸引原本觀望的團隊投入;但若升級過程不夠平滑,也可能讓既有用戶轉向其他替代方案。
Gemini 4 Argon 目前並未直接對全體用戶全面開放,而是採取嚴格的分階段釋出策略
CyberQ 觀察,Gemini 4 首波使用權限即日起已率先透過「Fairwind 計畫」提供給受信任的合作夥伴,包含經嚴格審核的政府機構、關鍵基礎設施維護團隊以及具備防禦資格的資安研究人員。
針對開發者、企業與消費端用戶,Google 預告將在完成初期防護驗證後逐步擴大釋出範圍。下一階段將優先開放給付費 API 用戶(可透過 Google AI Studio 與 Vertex AI 串接)以及 Google AI Ultra 訂閱用戶,屆時即可在專案中正式調用該模型的百萬 Token 生成與長流程推論能力。
至於一般免費用戶與標準方案訂閱者的全面上線時間,官方目前尚未給出具體日期,預計需待高階付費層級與 API 服務執行穩定後才會陸續推進。