10 月 27 日 Hacker News 首頁出現一則標題為「There are now 5 inference providers for abliterated DeepSeek」的討論,指出經過「去安全化」處理的 DeepSeek 模型,已經不再只是愛好者在家用顯示卡上跑的玩具,而是可以透過商業推論服務商以 API 直接呼叫,連結指向模型路由服務 allmodels.io 的「Abliterated Model Router」頁面。
這則消息值得關注的地方在於商業化本身。過去移除拒答機制的模型多半只存在於 Hugging Face 與 Ollama 等自架情境,使用者需要自備 GPU。當推論服務商開始以標準 OpenAI 相容 API 提供這類模型,任何應用程式只要改一行模型名稱,就能取得幾乎不拒絕任何指令的推理模型。CyberQ 也實際觀察此事件的技術,並與 CyberQ 部署在地端的去安全化模型做比較,認為這件事情對企業資安團隊是有影響的。
什麼是 abliteration
Abliteration 是一種不需要重新訓練就能移除模型拒答行為的權重修改技術,名稱由 ablation(消融)與 obliteration(抹除)合成。其理論基礎來自 Arditi 等人 2024 年的研究「Refusal in LLMs is mediated by a single direction」,Maxime Labonne, Uncensor any LLM with abliteration 該研究發現語言模型的拒答行為集中在殘差流(residual stream)中的單一方向上,把這個方向移除,模型就不再拒絕,反過來把它加強,模型連無害的問題也會拒答。
實作上的步驟大致如下。先讓模型分別處理一批有害與無害的指令,記錄每一層最後一個 token 的啟用值,把兩組平均值相減並正規化,得到各層的「拒答方向」候選。接著挑選效果最好的一層,再以權重正交化(weight orthogonalization)的方式,永久修改會寫入殘差流的權重矩陣,使其不再對該方向產生貢獻。改完的模型可以直接轉回 Hugging Face 格式,在任何原本能載入該模型的環境執行。
這次被商業化的 DeepSeek-V4.1-Flash-1017-abliterated 由 Hugging Face 使用者 mrfakename 製作,做法比早期版本更精細。模型卡說明作者分別量測 chat 與 think 兩種提示在每一層的拒答方向,取其奇異向量組成 rank-2 的「拒答子空間」,再從 40 個主要層的 attn.wo_b 與 ffn.shared_experts.w2 投影移除,每層強度由多目標搜尋決定,目標是在壓低拒答率的同時,讓無害提示的首 token KL 散度維持在低值。路由專家、embedding、Engram 表與 MTP 層則完全未動。
模型卡公布的評測數字如下(Q8_0 GGUF,greedy 解碼,100 題保留的有害提示,每題 384 token)。
| 版本 | Chat 模式拒答數(/100) | Think 模式拒答數(/100) | 無害提示首 token KL |
|---|---|---|---|
| 原版 DeepSeek-V4.1-Flash-1017 | 97 | 98 | 0 |
| Abliterated 版 | 4 | 9 | 0.067 |
模型卡同時以一句話提醒使用者,這個模型會配合有害的要求,使用後果由使用者自行負責。
能力折損是另一個常被討論的問題。Labonne 在 2024 年的實驗中發現,直接 abliterate 的 Llama-3-8B 在各項基準測試都有退步,後來以 DPO 偏好對齊訓練才補回大部分損失。2026 年 6 月 LessWrong 上一篇量測文章 What does abliteration actually cost 比較 Qwen3.5-27B 原版與 HuiHui 製作的 abliterated 版,MMLU 總分僅從 84.44% 降到 83.78%,但 TruthfulQA MC1 從 40.27% 降到 34.52%,MC2 從 58.25% 降到 51.39%,顯示折損並非平均分布,與真實性相關的任務受影響較大。
目前已知的服務商與模型
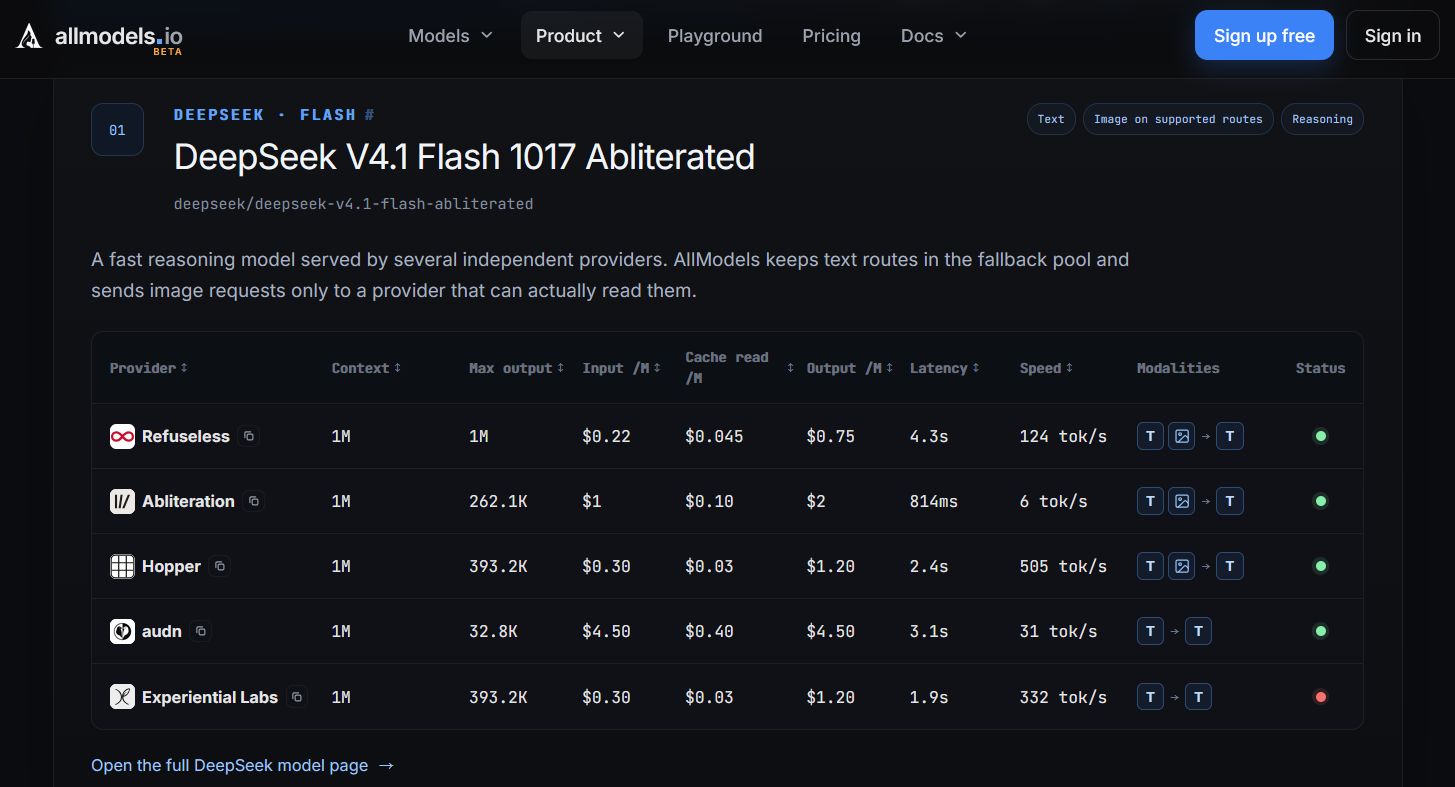
allmodels.io 的「Abliterated Model Router」頁面目前列出模型,皆以單一公開模型 ID 對應多家後端供應商,並提供 OpenAI 相容的 Chat Completions 與 Responses 兩種端點,基底網址為 api.allmodels.io/oai。
| 模型 | 模型 ID | 支援模態 | 備註 |
|---|---|---|---|
| DeepSeek V4.1 Flash 1017 Abliterated | deepseek/deepseek-v4.1-flash-abliterated | 文字、圖片(部分路由)、推理 | 頁面稱由多家獨立供應商提供,圖片請求只送往能處理圖片的供應商 |
| GLM 5.3 Abliterated | z-ai/glm-5.3-abliterated | 文字、推理 | 頁面標示為 Flagship,基底模型來自智譜 Z.ai |
該頁面的供應商路由清單是由前端動態載入。路由服務本身的功能包括供應商故障或滿載時自動切換、依模態選擇路由、依價格選擇最便宜的合格供應商,以及由路由端代為執行的網頁搜尋。頁面以「安全研究、紅隊演練與安全測試」描述其用途,同時提醒這類模型更可能產生有害或不安全的輸出,建議只在有適當防護的受控環境使用。allmodels.io 頁面標示為 beta。
基底模型 DeepSeek-V4.1-Flash-1017 由 DeepSeek 於 2026 年 10 月 17 日發布,屬於 V4.1 Flash 的更新版本而非新系列,以 MIT 授權釋出權重並附推論程式碼與安裝說明,官方說明強調推理、程式撰寫、代理任務與視覺理解的改進,並縮短輸出長度以降低執行成本。而這次新聞中的去安全化版本的模型卡顯示參數規模 763B,保留原版的 FP8 格式,近一個月下載 3,606 次,並附上 rank-2 LoRA GGUF 檔,讓使用者能把同一組修改套用到原版 GGUF 檔案上。換言之,從原版發布到去安全化版本出現並進入商業 API,前後不到十天。
社群反應與爭議
Hacker News 討論串的焦點並非服務商名單,而是「移除拒答」是否等於「零對齊」。投稿者 moeadham 認為既然拒答方向已從權重中移除,這些模型幾乎什麼都不拒絕,並提問一個人人都能取得零對齊模型的世界會是什麼樣子。使用者 whatshisface 回應「你已經活在這樣的世界裡」。使用者 petesergeant 則持相反看法,認為移除拒答與對齊是兩回事,就像一個可以被施壓而順從的人,並不代表他的價值觀已被改變。使用者 Moosdijk 也質疑這些模型並非真的毫無對齊。
另一條討論線索關於實際使用經驗。使用者 heythere22 表示在 Antigravity 拒絕的任務上,DeepSeek 原版就已經照做。使用者 ddxv 指出原版在日常工作中幾乎不拒答,但透過網頁版詢問政治問題時會被拒絕,隨後又補充該拒絕可能來自應用層而非模型本身。moeadham 回應原版仍會拒絕部分請求,例如撰寫驗證碼破解工具。當使用者 cynerx 以「這些模型會不會隨機刪除資料」反問對齊是否仍在時,moeadham 回答它們確實常在使用者不注意時刪除資料,建議不要開著自動執行模式。
討論串後段轉向資安面。使用者 rvz 提問讓強大且無防護的模型上線會出什麼事,並建議後端改用 Rust 等記憶體安全語言。也有多位使用者表示此前並不知道 abliterated 一詞的意思,而連結頁面本身並未解釋,反映這個技術圈內詞彙正在快速進入一般開發者的視野。
在 X 平台上,開發者 Nick Khami(@skeptrune)的貼文稱去安全化的 DeepSeek 什麼都不拒絕,而且與原版一樣聰明,認為刪除造成拒答的權重沒有任何代價,因為那些權重與模型的智力無關。
這個說法與前述 LessWrong 的量測結果存在落差,後者顯示 TruthfulQA 等指標有明顯下降,實際折損程度可能依製作方法與基底模型而異。
對企業與資安團隊的意義
對多數企業而言,直接的風險並非員工拿去安全化模型做壞事,而是這類模型會以「更好用、更不囉嗦」的形象進入開發流程。當去安全化模型與原版共用相同的 API 格式,只差一個模型 ID,開發者在 AI 代理工具或內部應用中切換過去的門檻極低。社群意見中,有「開著自動執行模式會刪資料」的提醒,正說明這類模型在代理情境下,少了拒答機制也少了一道安全帶喔。
法規面的影響也已經出現。根據 BleepingComputer 這篇,美國國土安全部(DHS)已經於 2026 年 10 月 20 日在聯邦公報發布命令,要求聯邦民事機關立即停止採購並移除 DeepSeek 產品,涵蓋其聊天機器人、API 服務、程式撰寫與推理模型、關係企業產品,以及「建構在 DeepSeek 技術之上的第三方產品與服務」,例外申請須於 60 天內提交 CISA 審查。該命令並非針對民間或消費者使用的全面禁令,但「第三方產品」的範圍足以涵蓋透過路由服務取得的去安全化版本。
台灣公務機關對中國製生成式 AI 的使用限制是否延伸到第三方代管的衍生模型,這確實也變成了新的疑問呢。
從治理角度,可以採取的措施包括下列幾項。
盤點組織內所有呼叫外部 LLM API 的應用與代理工具,建立允許使用的模型 ID 白名單,並在閘道層阻擋未列名的模型,而非只管控供應商網域。
把「模型是否經過權重修改」納入第三方 AI 服務的供應商評估項目,要求供應商揭露模型來源、修改方式與製作者。allmodels.io 目前未揭露營運主體,這類資訊缺口本身就應列為風險。
對於真正需要去安全化模型的紅隊演練或安全測試,改以自架方式在隔離環境執行,不經由公開路由服務傳送測試資料。Hugging Face 上的 LoRA 檔案已讓自架變得可行。
在代理工作流程中保留人工確認關卡與檔案系統權限限制,不依賴模型本身的拒答能力作為最後一道防線。
前述研究已指出安全微調的脆弱性,Maxime Labonne 在 2024 年即表示 abliteration 展示了安全微調的脆弱並引發倫理考量。兩年後,這項技術從部落格教學變成商業 API 上的現成選項,企業的防線設計也必須從「相信模型會拒絕」改為「假設模型不會拒絕」。
資料來源
allmodels.io Abliterated Model Router
Hugging Face 模型卡 mrfakename/DeepSeek-V4.1-Flash-1017-abliterated
Maxime Labonne, Uncensor any LLM with abliteration
christian-mc, What does abliteration actually cost
BleepingComputer, DHS bans DeepSeek products across US federal civilian agencies