QNAP 宣布推出 AI Service Center Beta(以下簡稱 AISC),定位為 NAS 上「單一入口、全域調度」的 AI 管理中樞。過去 NAS 上的應用程式各自串接 AI,各自保管模型與 API 金鑰;AISC 把地端模型、雲端供應商、應用程式授權與使用紀錄集中到同一個介面。
新聞稿列出四項主要功能:
地端模型庫:從 QNAP 驗證過的清單挑選模型,指定 CPU、GPU、內顯或 NPU,背景自動下載與載入。
雲端供應商:以自有 API 金鑰連接 OpenAI、Azure OpenAI、Gemini、Claude 與 OpenAI 相容端點,可設定每月預算與警示門檻,金鑰只存在 NAS 本機。
應用程式串接:應用程式安裝時自動註冊,管理者在單一頁面為各項能力指定模型、決定是否開放雲端,設定一次即同步套用。
活動紀錄:記錄每次呼叫的時間、應用程式、模型、能力、Token 數、成本與延遲,可匯出 CSV 供稽核。
系統需求為 QTS 6.1.0 或 QuTS hero h6.1.0 以上。雲端供應商功能 x86 與 ARM64 機種都能用,不需要 GPU;地端模型庫則只支援 x86 機種,而且需要通過相容性驗證的 GPU,並安裝對應的執行環境與模型套件。
CyberQ 在 h6.1 Beta 釋出後就已經在一台 TVS-h877AX 上試用過 AISC。這次趁新聞稿發布,針對新聞稿強調、但先前沒有驗證的四件事補做實測,幫大家測試看看預算上限是否真的會擋 ? 活動紀錄與 CSV 是否完整、「設定一次即同步」是否成立,以及使用地端模型時資料是否真的不離開 NAS。
測試環境
| 項目 | 規格 |
|---|---|
| 主機 | TVS-h877AX,AMD Ryzen 5 7645,16 GB 記憶體 |
| 顯示卡 | 12 GB 的 NVIDIA 顯示卡(Container Station 模式) |
| 作業系統 | QuTS hero h6.1.0.3640 build 20261007 Public Beta |
| AI 相關套件 | AI Service Center 1.0.0.842、Nvidia AI Runtime 1.0.0.53、LLM Core 2.0.0.67、Qsirch 8.0.0.2 |
| 雲端端點 | 機房內另一台 GPU 伺服器的 OpenAI 相容閘道,模擬雲端供應商 |
以上套件版本在測試當天(10 月 21 日)都是 App Center 目錄上的最新版,目錄日期為 10 月 8 日。
一、架構:AISC 是管理層,推論引擎另外安裝
AISC 本身只負責管理與排程。實際拆開來看,地端 AI 分成三層:
AI Service Center:管理介面、應用程式授權、預算與紀錄,也是應用程式呼叫 AI 的統一閘道(OpenAI 相容 API)。
Nvidia AI Runtime:真正的推論引擎套件(約 7.1 GB),內含 Ollama(GPU 與 CPU 各一個容器)、ONNX 嵌入服務與 Whisper 語音辨識服務。
LLM Core 2.0:一包預先下載的模型,包括 Gemma 4 12B(QAT 量化,約 7 GB)、Harrier-OSS 270M 文字嵌入、FG-CLIP2 影像嵌入與 Whisper large-v3-turbo。
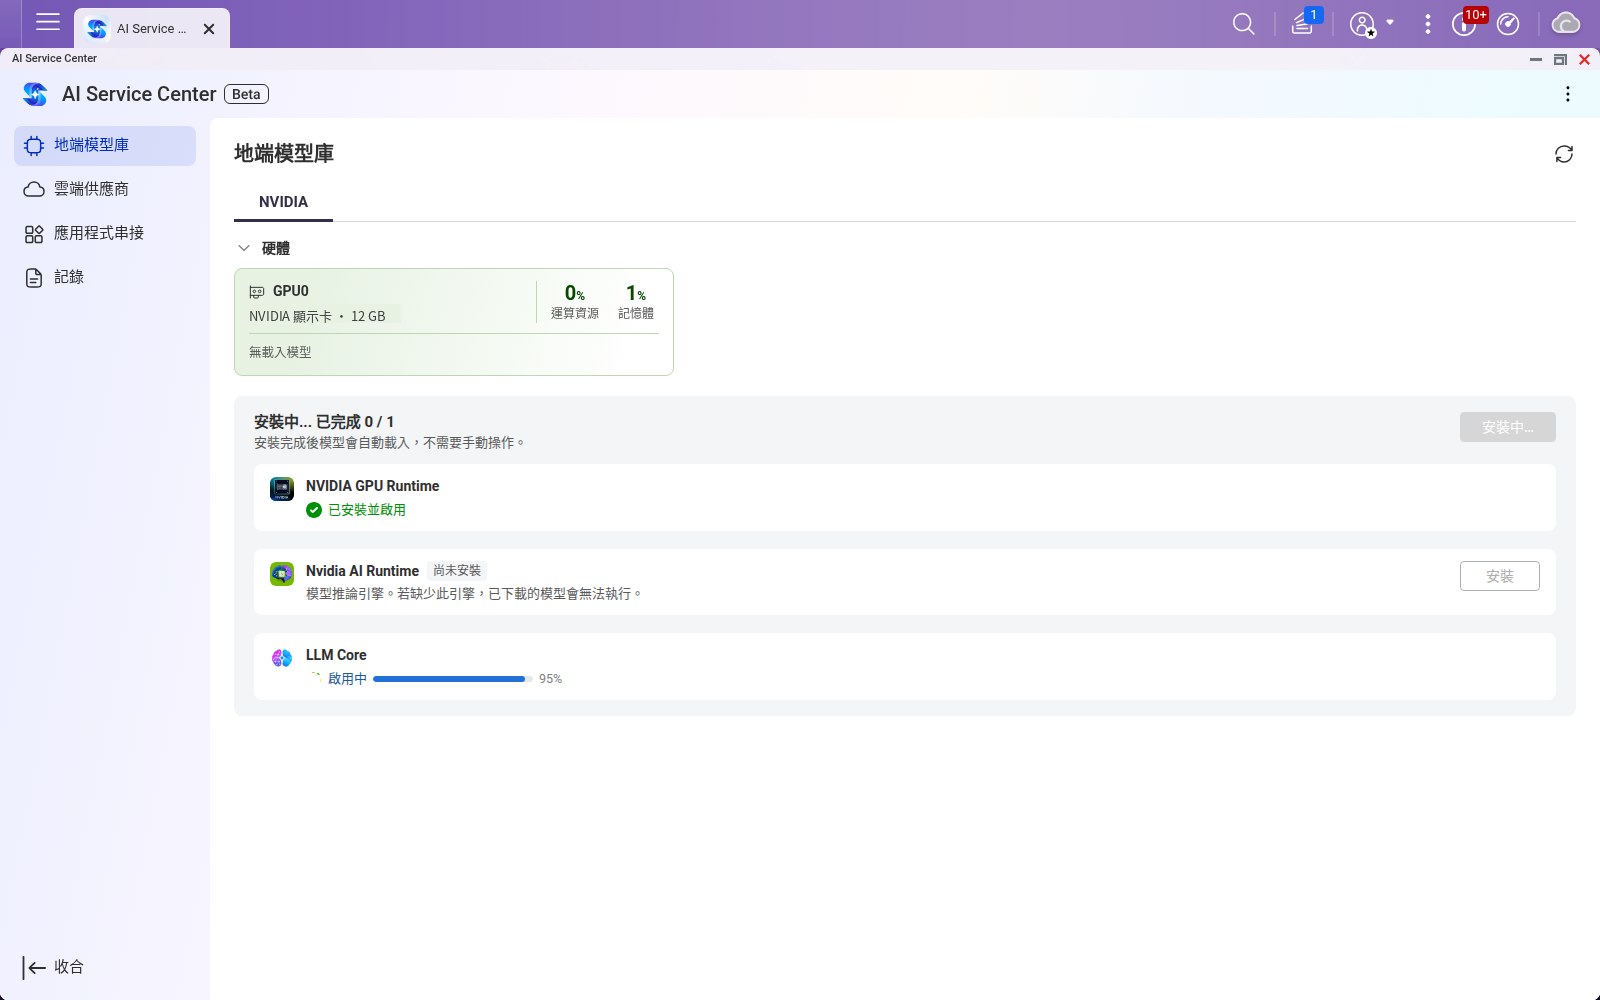
新聞稿說系統會「在背景自動完成下載與載入」,這點大致成立,Runtime 裝好後,Qsirch 需要的三個預載模型(FG-CLIP2、Harrier、Whisper)會自動放上 GPU。不過筆者第一次安裝 Runtime 時出現解壓縮失敗,重新安裝才成功。
二、地端模型庫:裝置只能選 GPU,12B 模型在 12 GB 卡上偏緊
模型清單與裝置選擇
目前的地端模型庫提供 Gemma4 12B、26B、31B,Qwen3.5 9B,Qwen3.6 27B、35B,以及上述三個預載模型。每個模型都標示檔案大小與預估需要的記憶體,例如 Gemma4 12B 檔案 6.7 GB、記憶體需求 12.1 GB。
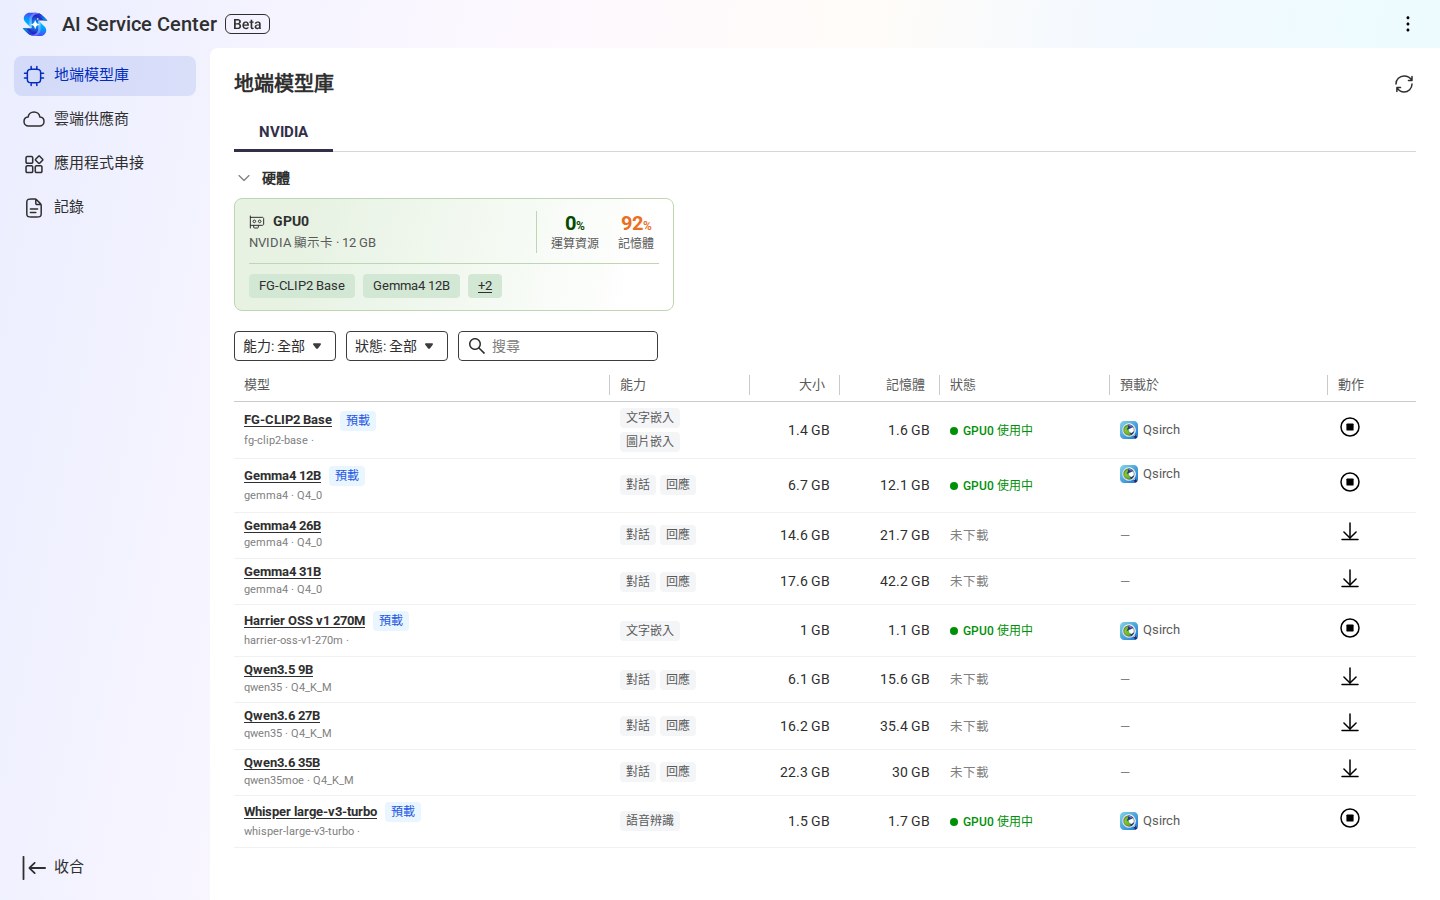
新聞稿提到可以指定 CPU、GPU、內顯或 NPU。在這台機器上,按下載入後的「選擇裝置」視窗只有 GPU0 一個選項。Ryzen 5 7645 有內建顯示晶片,Runtime 裡也有一個 CPU 版的 Ollama 容器,但介面上都無法選擇。推測可選裝置取決於已安裝的執行環境(這台只裝了 Nvidia AI Runtime),新聞稿列出的四種裝置應是指整個產品線,而不是每台機器都有。
記憶體不足時仍可強制載入
開機時 AISC 會先載入三個預載模型(約佔 GPU 記憶體 48%),剩下約 6.3 GB,不足以放下 Gemma4 12B,所以 Gemma 預設不會自動載入。手動載入時,AISC 會先跳出「記憶體可能不足」的提醒,但仍允許「仍要載入」。
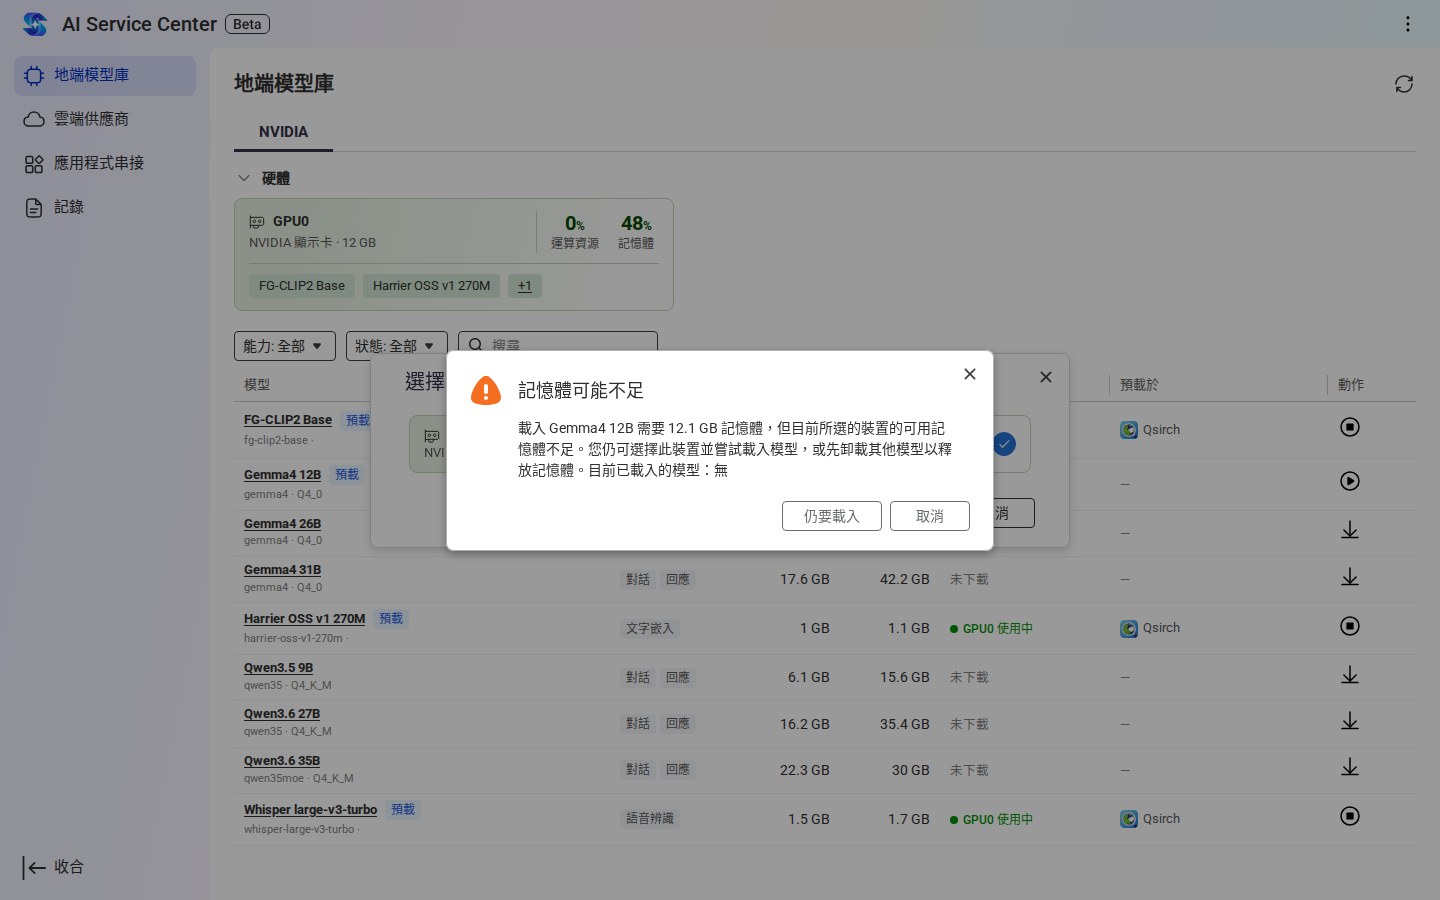
強制載入後 GPU 記憶體用量升到 92%,模型會有一部分落到 CPU 執行。實測直接以 API 對話,Gemma4 12B 約每秒 8 個 token,放進 Qsirch 的 RAG 知識搜尋,回答一題要 75 到 109 秒。另外 Gemma4 12B 被標記為預載模型,一旦載入就不能從介面卸載,按下卸載會出現「必須至少保留一份在運行中」的提示,介面上沒有其他方式把記憶體還給其他模型。
結論與先前 CyberQ 實測文相同,12 GB 顯示卡可以讓嵌入與語音模型常駐,但 12B 級的對話模型會很吃緊。若主要需求是地端對話與 RAG,16 GB 以上的顯示卡會從容許多。
三、雲端供應商:預算上限會擋,但不是即時的
金鑰與供應商類型
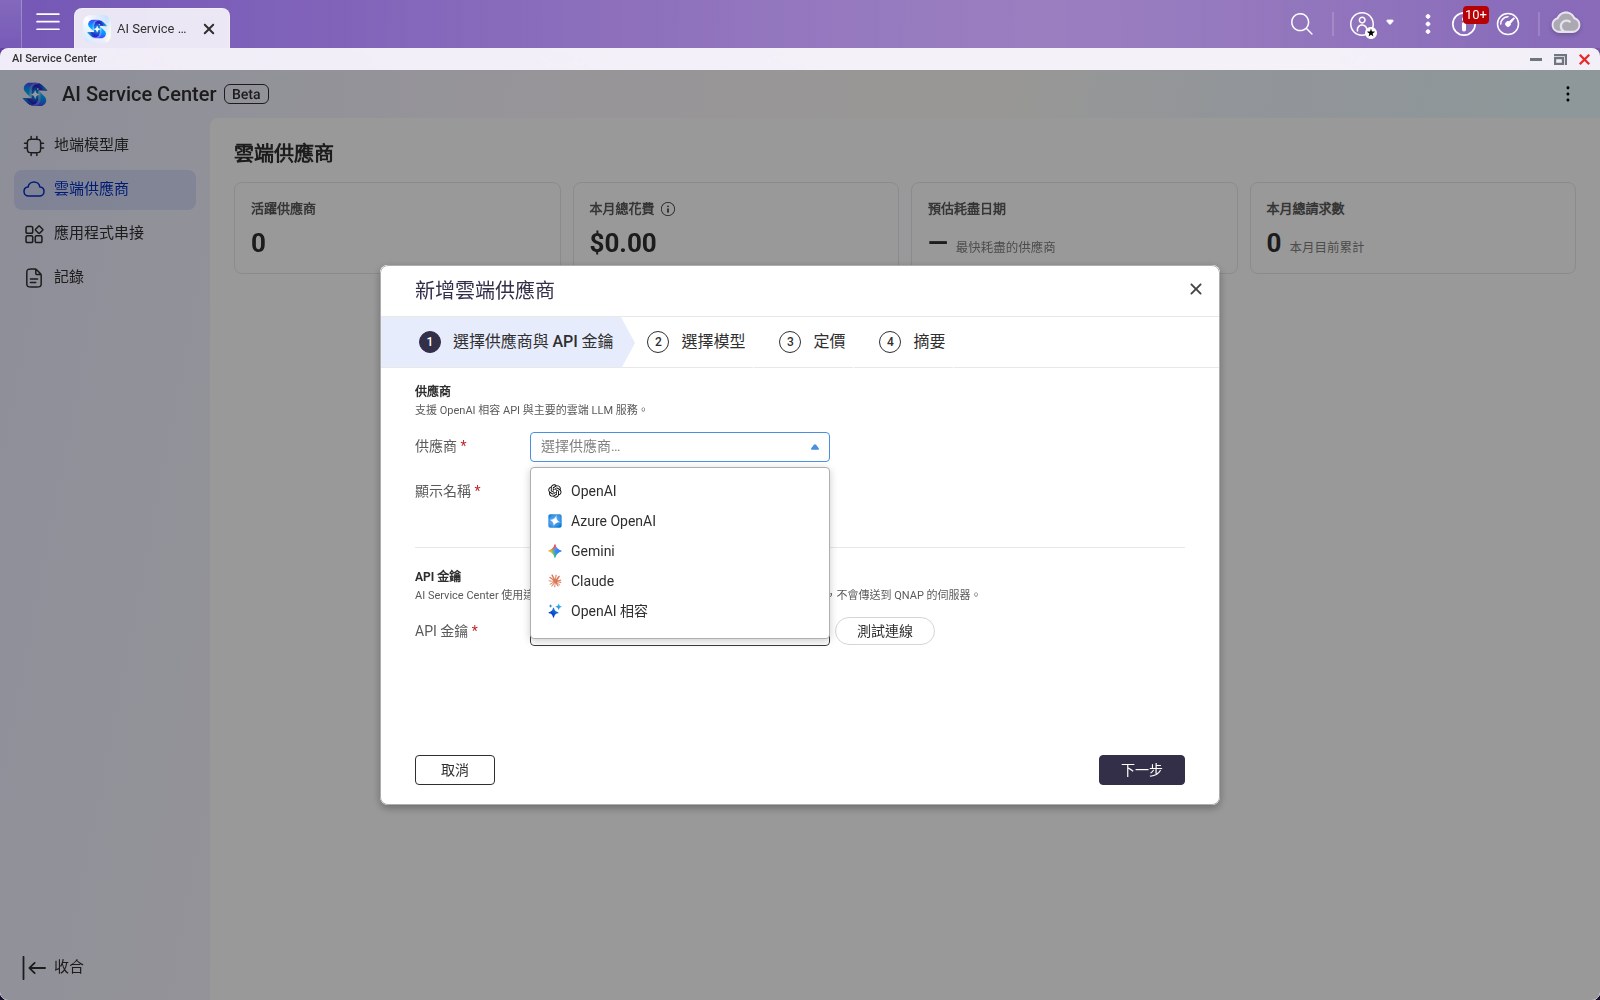
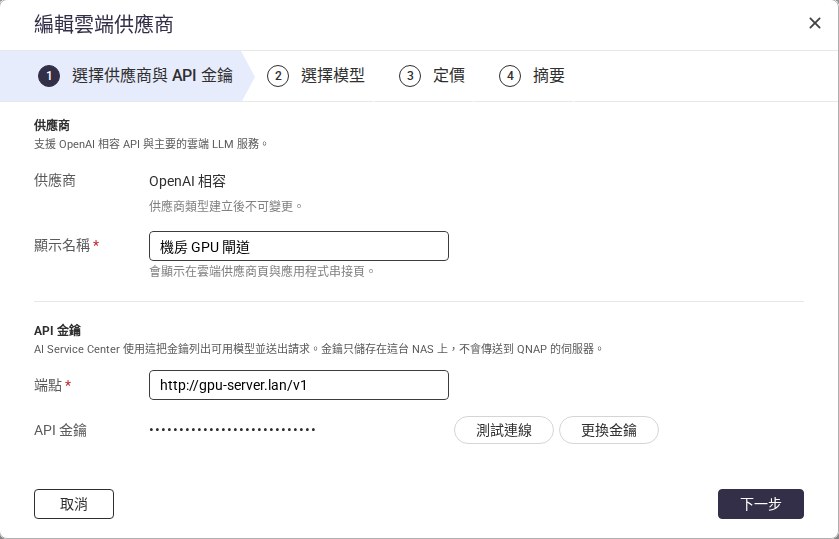
新增供應商時可選 OpenAI、Azure OpenAI、Gemini、Claude 與「OpenAI 相容」。OpenAI 相容可以填自訂端點,筆者用它接上機房內的 GPU 伺服器,測試連線一次通過,並能列出遠端提供的模型。
編輯畫面上明確寫著「金鑰只儲存在這台 NAS 上,不會傳送到 QNAP 的伺服器」。建立後金鑰以遮罩顯示,只能「更換金鑰」,無法再看到原值。
預算上限實測
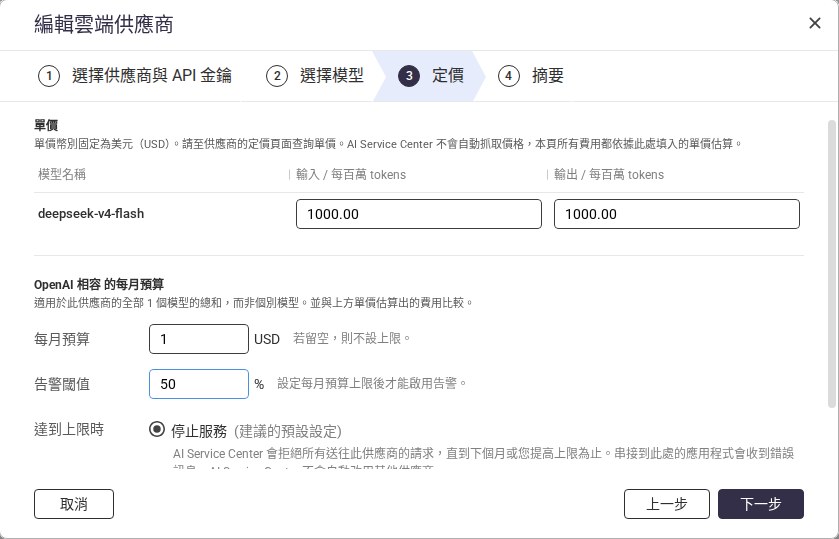
精靈的「定價」步驟要自行填入每個模型的輸入與輸出單價(美元,每百萬 tokens),AISC 不會自動抓價格,所有費用都是依此估算。下方可設定每月預算、告警門檻,以及達到上限時「停止服務」或「僅通知」。
為了在幾次呼叫內就觸發上限,筆者刻意把單價設為每百萬 tokens 1,000 美元,每月預算 1 美元,告警門檻 50%,超額時停止服務。每次呼叫約 80 到 110 個 tokens,估計費用約 0.08 到 0.11 美元。
| 階段 | 結果 |
|---|---|
| 前 10 次連續呼叫(約 15 秒內完成) | 全部成功;期間查詢供應商的已用金額一直是 0 |
| 約 30 秒後 | 已用金額一次更新為 0.91 美元,同時發出第一筆告警事件 |
| 第 11、12 次 | 成功 |
| 第 13 次 | 被拒絕,HTTP 429,錯誤碼 budget_exceeded,訊息寫明目前估計 1.02 美元、上限 1 美元、11 月 1 日重置 |
| 實際累計 | 1.13 美元,超出上限 13% |
| 改為「僅通知」後 | 超額的請求照常放行 |
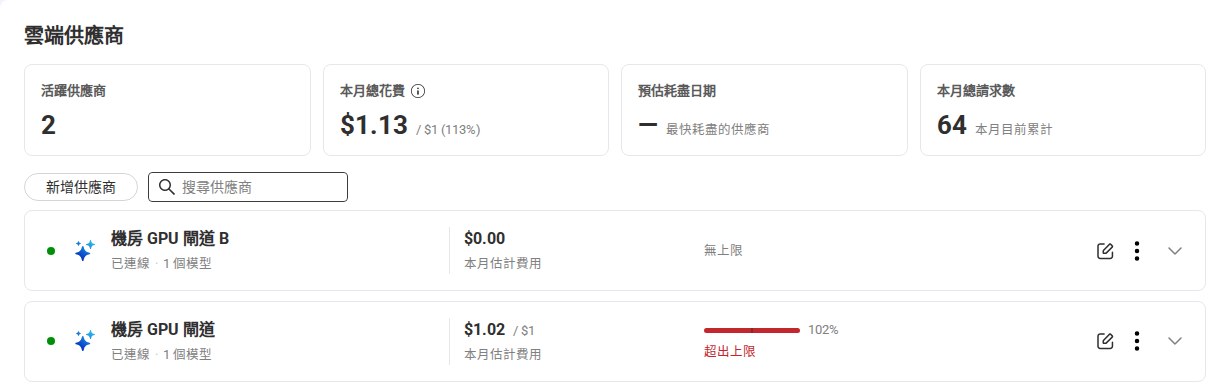
停止服務確實有效,錯誤訊息也清楚。但實測可以看出兩個特性:
用量是批次累計的
呼叫完成後約 30 秒,已用金額才會更新。在這段空窗內的請求都會放行,所以最後的實際花費會超過上限。本次超出 13%,請求越密集,超出越多。
告警不一定在門檻當下發出
告警門檻設 50%,但第一筆告警出現時已經是 91%,因為金額是一口氣從 0 跳到 0.91 美元。
因此預算上限適合當作防止費用失控的保險,而不是精確的額度控制。設定時建議預留餘裕,例如實際可接受 100 美元,就把上限設在 80 到 90 美元。介面上也提醒得很清楚,超額時 AISC 不會自動改用其他供應商,串接的應用程式會直接收到錯誤。實測 Qsirch 的 RAG 在超額時也是直接回應 429,不會退回地端模型。
供應商選單另有「本月費用歸零」,可以提前做一次月初重置,請求紀錄會完整保留。
四、應用程式串接:「設定一次即同步」成立,而且在閘道端強制
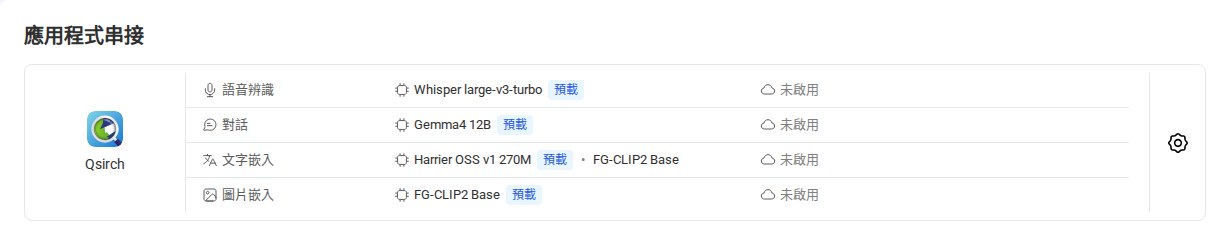
「應用程式串接」頁列出每個應用程式需要的能力(語音辨識、對話、文字嵌入、圖片嵌入),以及目前由哪個地端或雲端模型提供。按下齒輪可以為每項能力決定是否「允許使用雲端模型」,並指定可用的雲端模型。語音辨識與圖片嵌入的地端模型由應用程式指定,不可替換。
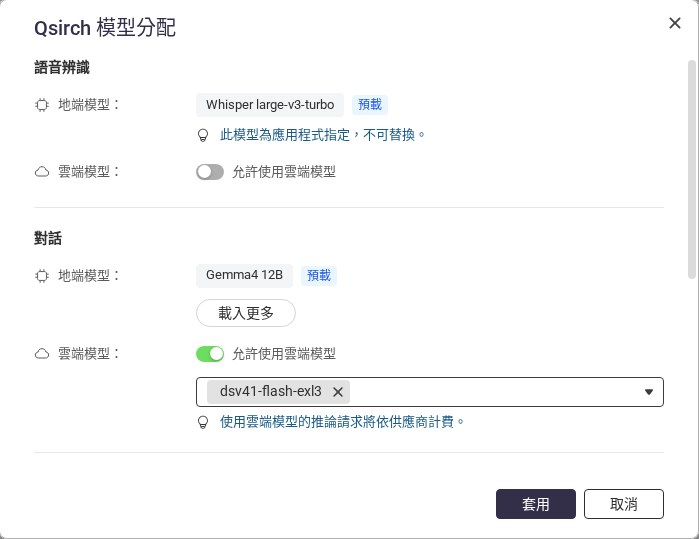
CyberQ 對此做了三個驗證:
地端模型載入後,Qsirch 的 RAG 模型清單立即多出 Gemma4 12B,並自動成為預設模型,不需要到 Qsirch 另外設定。
關閉對話的雲端選項並套用後,Qsirch 的模型清單立即只剩地端模型。
如果刻意用 Qsirch 的身分硬指定雲端模型:直接呼叫 AISC 的 API 會被拒絕,HTTP 403,錯誤碼 model_not_authorized_for_application,透過 Qsirch 建立 RAG 對話則回應 400,這樣是合理與安全的,因為上一步我們已經把雲端模型關閉。
第三點最重要:權限是在 AISC 閘道端強制,而不是只靠應用程式自律。對企業來說,「哪些應用程式可以把資料送上雲端」終於有一個可以統一管理、而且確實生效的開關。
五、活動紀錄與 CSV 匯出
「記錄」頁分為存取記錄與系統記錄。存取記錄每一筆都有操作狀態、時間、模型與供應商、能力、應用程式、Tokens、費用與延遲,可依應用程式、狀態與能力篩選。
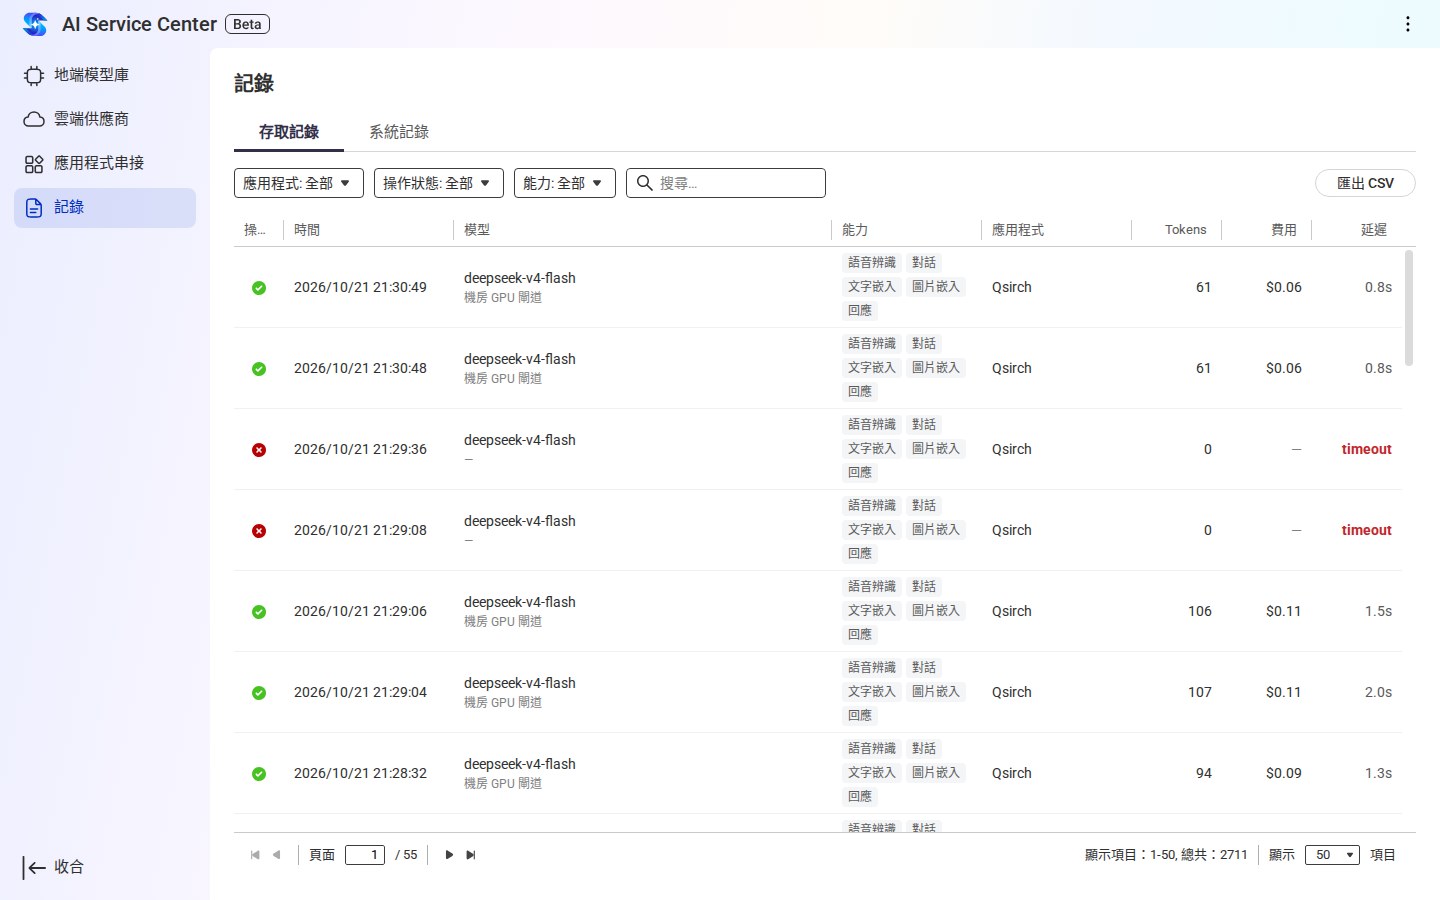
筆者把紀錄與實際呼叫逐筆比對:
- Token 數與 API 回應中的 usage 完全一致(例如 83、103、86)。
- 費用依自填單價計算,例如 103 tokens 記為 0.10 美元;地端模型一律顯示「不計費」。
- 延遲與用戶端自己量到的時間差在 0.1 秒內;地端 RAG 的回答也如實記錄為 74.7 秒、108 秒。
- Qsirch 在背景建立索引的嵌入請求也會記錄,使用者欄顯示為 internal。
匯出的 CSV 為 UTF-8(含 BOM,Excel 可直接開啟),共 13 個欄位:Request ID、時間(含時區)、狀態、應用程式、使用者、能力、模型、實際路由、延遲、Tokens、每秒 Tokens、結束原因與費用(小數六位)。匯出時會包含全部紀錄,這台機器累積了 2,711 筆。
需要改善的是失敗紀錄。因預算超額被拒絕(429)、因未開放雲端被拒絕(403)的請求,在介面上的延遲欄一律顯示紅字「timeout」,CSV 只寫「Client Error」,沒有錯誤碼。稽核時看到 timeout 很容易誤判為網路問題。此外,雲端模型那幾筆的能力欄列出的是該模型被指派的全部能力,而不是那次呼叫實際使用的能力。
系統記錄則會寫入 QTS 的事件記錄,包括管理者修改供應商、預算告警與達到上限等事件,可以接上 QTS 原有的通知機制。
六、「地端模型資料不出 NAS」:側錄驗證
新聞稿強調使用地端模型時,請求與回應都留在 NAS 本機。為了驗證,CyberQ 在 NAS 的對外網路介面側錄所有往區網以外的流量(以及所有 DNS 查詢),分成四個時段比較:
| 時段 | 內容 | 區網以外的連線 |
|---|---|---|
| 閒置基準(10 分鐘) | 不做任何 AI 操作 | myQNAPcloud 相關的常駐連線與定期連線檢查 |
| 地端 AI(10 分鐘) | 直接呼叫 AISC 的對話 3 次、文字嵌入 2 次、Whisper 轉錄 1 次,Qsirch RAG 3 題、AI 語意搜尋 1 次 | 同基準 |
| 應用程式串接切換 | 開關雲端、嘗試硬指定雲端模型 | 同基準 |
| 雲端與預算測試 | 呼叫機房 GPU 閘道(區網內) | 同基準,另有一次 download.qnap.com 的下載(約 280 KB,推測為系統例行的目錄更新) |
直接呼叫 AISC 的對話、嵌入與 Whisper 的那段時間,對外只有平常就存在的三條常駐連線,沒有任何新的連線,也沒有 DNS 查詢。就 AISC 本身而言,地端推論確實沒有把資料送出 NAS。
七、Whisper 與 Qsirch AI 搜尋
AISC 的 OpenAI 相容 API 同樣提供 Whisper 語音轉文字(/v1/audio/transcriptions),呼叫時要帶入已在 AISC 註冊的應用程式 ID。這次以一段 140 秒的會議錄音實測,轉錄 10.5 秒完成,約為即時速度的 13 倍。要注意兩點:直接上傳 m4a 會被拒絕,需先轉成 16 kHz 單聲道 WAV;繁簡體也不固定,這段錄音即使在提示詞加入「繁體中文。」仍輸出簡體,自行串接時建議再做一次繁簡轉換。
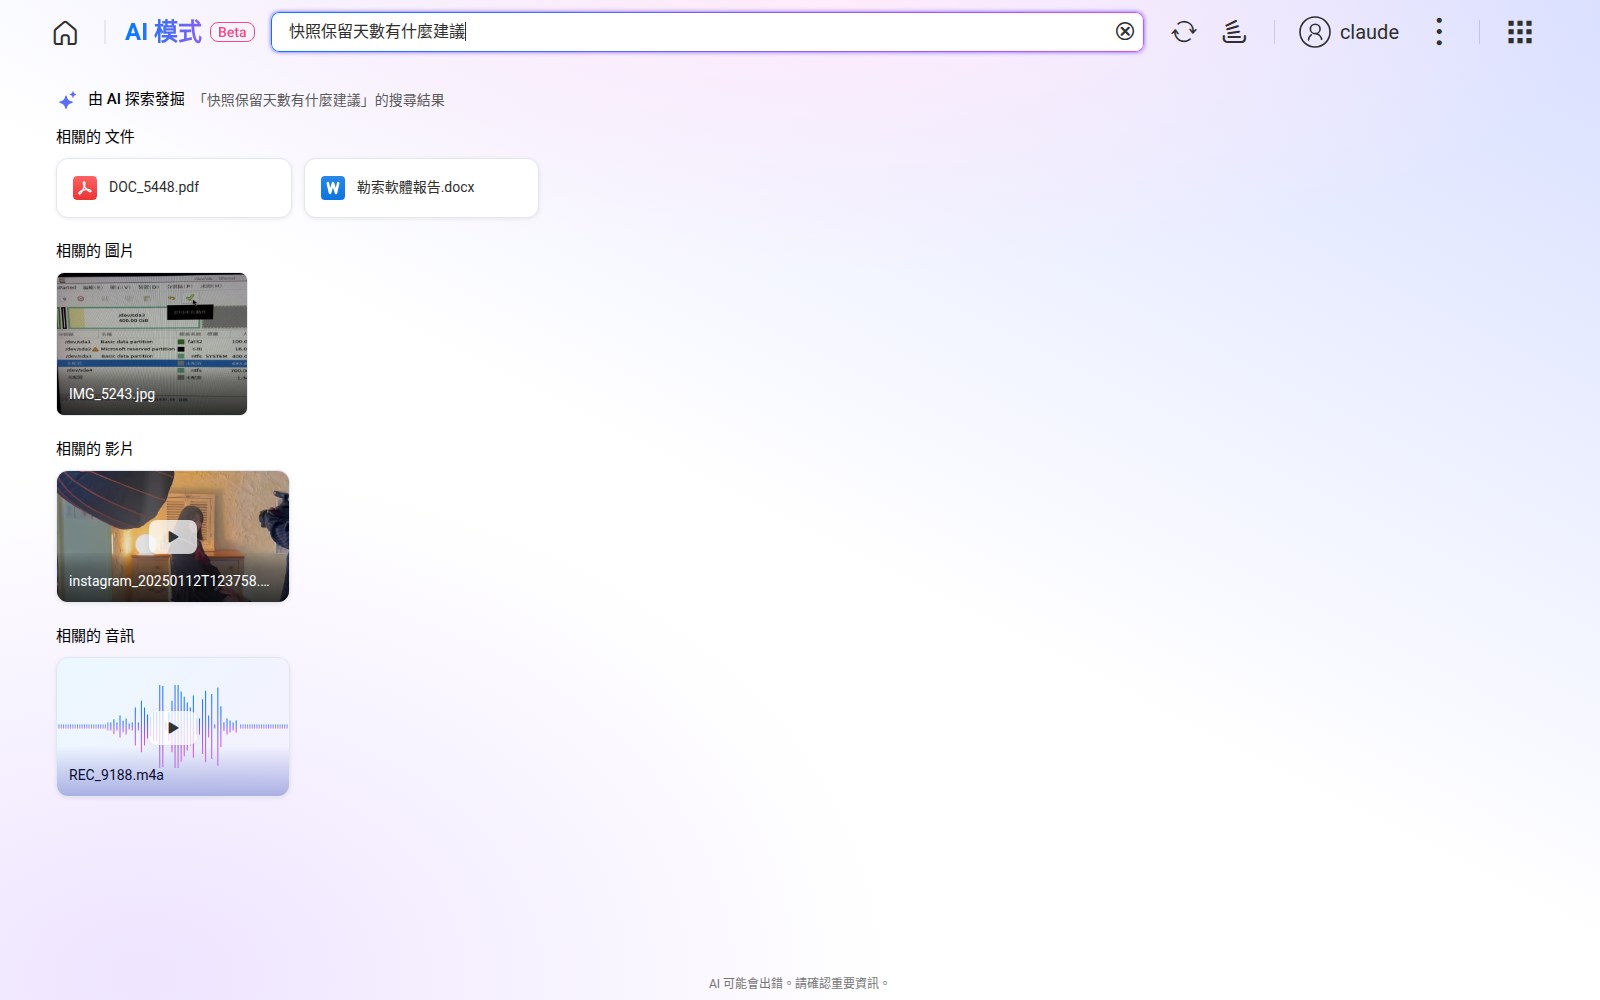
Qsirch 8.0 的 AI 語意搜尋與 RAG 知識搜尋都改由 AISC 提供模型。AI 語意搜尋的系統需求是 AISC 就緒、三個預設模型已載入,以及 CAYIN Media Viewer 授權。這次以自然語言查詢「備份失敗時要通知誰」,語料中其實沒有直接回答這個問題的文件,AI 語意搜尋列出的第一筆是「韌體更新前檢查清單」,內容同時談到備份狀態與通知使用者,屬於語意相近的文件。語意搜尋的定位是找相關檔案,答案仍要靠 RAG 知識搜尋或人工判讀。
RAG 方面,先前以 15 份自製文件、14 題測試,地端 Gemma4 12B 與經 AISC 串接的遠端模型都答對 11 題,檢索到的來源完全相同,差別在速度:遠端模型完整回答中位數 7.6 秒,地端 Gemma4 12B 約 96 秒。這次重跑三題(含一題文件中沒有答案的負向題),Gemma 全部答對,負向題也誠實回答沒有資料,但回答中偶爾夾雜其他語言的字詞。
結論
AISC 把 NAS 上原本各自為政的 AI 串接收攏到一個入口,方向正確,而且這次逐項驗證的結果大多名實相符:
- 應用程式串接:開關雲端後立即同步到 Qsirch,權限在閘道端強制,硬闖會被 403 擋下。這是本次最有價值的功能。
- 活動紀錄與 CSV:Token、費用、延遲都與實際呼叫吻合,欄位完整,適合稽核;失敗紀錄一律標成 timeout 是需要修正的瑕疵。
- 預算上限:停止服務確實有效,但用量約 30 秒才累計一次,實測超出上限 13%,告警也延後到 91% 才發出,設定時應預留餘裕。
- 資料不出 NAS:AISC 的地端推論行為,基本上沒有其他對外連線。
至於硬體,12 GB 顯示卡足以跑嵌入、語音與 Qsirch 的 AI 語意搜尋,12B 級的對話模型則相當吃緊。把對話交給雲端或機房內的 GPU 伺服器,再由 AISC 統一控管預算與權限,是目前最實際的組合,或者是至少裝 16GB、24GB 或更大 VRAM 的顯示卡,這也是 AI NAS 伺服器的綜合價值。
h6.1 Beta 的介面改版、快照與 PQC 等其他實測,請見 CyberQ 另一篇稍早的 QuTS hero h6.1.0 Public Beta 實測。