從失業到錄取,作者用自己的求職驗證框架
ai-job-search 是一套建構於 Claude Code 之上的求職申請框架。作者 Mads Lorentzen 原本是地球物理學家,2025 年底職位遭到裁撤後,自行打造這套工具跑自己的求職流程。依照專案 README 的說法,他以每週使用的頻率投出 69 份客製化申請,取得 20 次第一輪面試,最終於 2026 年 6 月以 AI 工程師身分就職。他並表示在每一次面談中都主動向雇主說明使用此工具,多數情況反而引發技術層面的對話。
截至本文撰寫時,專案在 GitHub 上累計 52.4k 顆星與 17.2k 個分支,採用 MIT 授權。分支數對星數的比例遠高於一般開源專案,主要的原因是它需要「fork and own」的使用方式,使用者必須先複製一份到自己的儲存庫才能開始使用,自然推升 fork 數。
三個核心指令串起完整流程
框架以 Claude Code 的自訂指令與技能檔組成,核心流程由三個指令構成。
/setup 負責建立候選人檔案。使用者可以把現有的 CV、LinkedIn 匯出檔、學位證明、推薦信放進 documents/ 資料夾讓它讀取,也可以直接貼上一份履歷,或透過問答方式逐步建檔。產出的檔案包含結構化經歷、行為特質、寫作風格、職缺評估標準與 STAR 面試範例。
/scrape 搜尋多個求職平台並依契合度排序。內建的平台搜尋工具以丹麥市場為主,另附兩個不限國家的來源,分別是 LinkedIn 公開職缺端點與 freehire.me 的 REST API。其他市場的使用者可用 /add-portal 指令,讓代理自行調查目標平台的搜尋網址格式、結果結構與 robots.txt 規則,產生對應的搜尋技能。
/apply 是整個框架最完整的環節。流程依序為解析職缺、對照個人檔案評估契合度、以 LaTeX 草擬履歷與求職信、另外啟動一個全新上下文的審閱代理研究該公司並批評草稿、依意見修訂、編譯 PDF 並逐頁檢視版面,直到履歷恰好兩頁且無孤行標題、求職信恰好一頁且簽名可見為止。最後一步會抽取 PDF 文字層,模擬 ATS 系統的解析結果,確認聯絡資訊是文字而非圖示字型,並檢查職缺關鍵字覆蓋率。專案明文規定個人檔案不支持的技能不得硬塞,只能列為落差。
面試準備、進度追蹤與技能補強
核心流程之外另有十個延伸指令。/interview 會從已投遞申請的封存檔案中取出當時面試官實際讀到的履歷與求職信,研究公司與面試官,對應可能問題到 STAR 範例,並提供模擬面試。/outcome 記錄每份申請的後續狀態,並能草擬追蹤信與感謝信,但僅產生草稿不代為寄送。/rank 以平行代理批次評分大量職缺,/upskill 比對個人檔案與目標職缺的技能落差並產出學習計畫,/html-report 則產生可離線開啟的申請追蹤儀表板。
「本機執行」的實際邊界為何 ?
專案標語為「The job search that runs on your machine」,CyberQ 認為,這句話需要準確理解。所有個人資料檔案、職缺紀錄、產出的 PDF 與申請封存,確實都留在使用者本機的 git 儲存庫內,沒有任何第三方 SaaS 持有這些資料。
不過 Claude Code 本身的模型推論是透過 Anthropic 的 API 進行,個人檔案內容在每次指令執行時會隨提示詞送出。這點 README 並未特別強調,使用者在高度敏感情境下應自行評估。
專案文件對資料安全有幾項值得注意的設計。
第一,README 明確警告 GitHub 不允許公開專案的私有分支,而 /setup 會把姓名、聯絡方式、工作經歷與薪資期望寫進受版本控制的檔案,因此建議自用者建立私有儲存庫並將原專案設為 upstream,只有打算回饋貢獻時才使用 fork。
第二,職缺內容一律視為不可信輸入,工作流程不會執行職缺內嵌的任何指令,也不會抓取其內文連結,但文件同時坦承這類防護屬於指令層級而非沙箱隔離,建議在不熟悉的求職平台上送出前先檢視抓取與產出的內容。
第三,平台搜尋工具在 .claude/settings.json 中預先授權執行,專案因此刻意不提供從其他分支自動安裝搜尋技能的功能,要求使用者手動複製並先閱讀程式碼,確認網路請求只指向宣稱的求職平台,且 package.json 無相依套件與生命週期腳本。
代理應用在敏感場景的參考樣板
CyberQ 認為,求職資料涵蓋個人履歷、薪資期望與職涯規劃,屬於高度敏感的個人資訊。這個專案把個人檔案、評估標準與產出全部放在使用者自己的儲存庫,把框架邏輯與個人資料分離,並以版本控制的方式讓使用者追蹤每一次更新對個人化檔案的影響。
對於企業評估導入代理式 AI 工具的資安人員而言,其職缺視為不可信輸入、工具執行需先審閱程式碼、推論端點邊界需自行認知的這三項原則,具有跨領域的參考價值。
使用前提包含 Claude Code 訂閱或 API 額度、Python 3.10 以上、Bun 執行環境,以及含 lualatex 與 xelatex 的 LaTeX 發行版。
改接地端 AI 推論的路線一 保留 Claude Code,把推論端點改指向地端模型
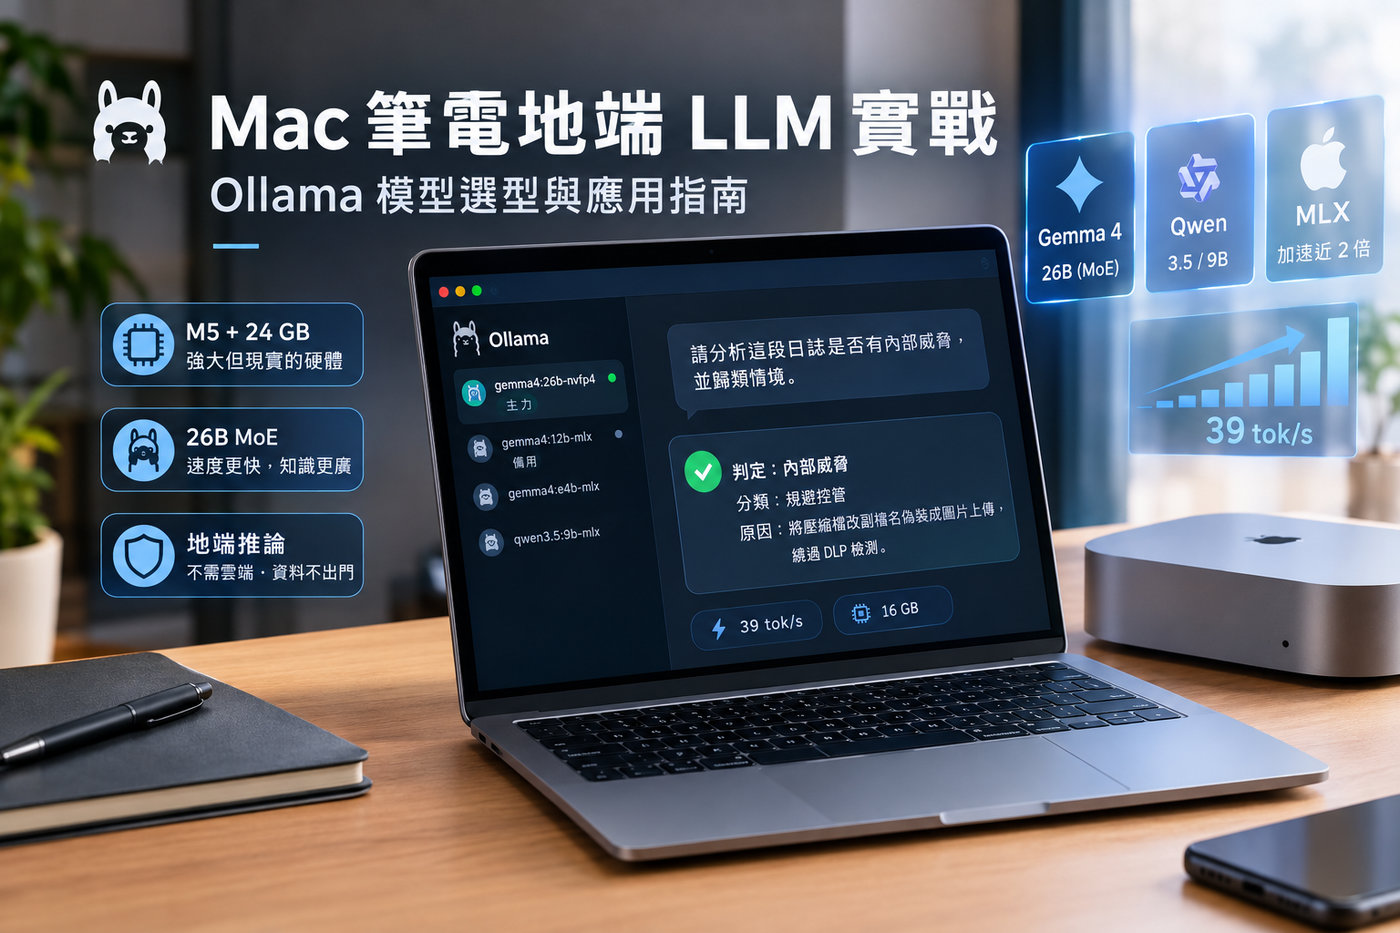
CyberQ 測試,由於 Claude Code 支援透過環境變數改接任何實作 Anthropic Messages API 的伺服器。Ollama 已支援 Anthropic Messages API,因此也可以讓 Claude Code 使用本機開源模型。設定方式是 ollama launch claude 會自動設定 ANTHROPIC_AUTH_TOKEN、ANTHROPIC_BASE_URL 與 ANTHROPIC_API_KEY,然後啟動指向本機 Ollama 的 Claude Code,手動設定則是把 ANTHROPIC_BASE_URL 指到 http://localhost:11434。此外 Claude Code 內部會依任務需求呼叫不同模型層級,需要用 ANTHROPIC_DEFAULT_SONNET_MODEL、ANTHROPIC_DEFAULT_HAIKU_MODEL、ANTHROPIC_DEFAULT_OPUS_MODEL 三個變數把各層級對應到本機模型名稱,否則 Claude Code 會向本機伺服器請求不存在的 Claude 模型而被拒絕。LM Studio 與 llama.cpp 也可以透過 LiteLLM 這類代理層轉換 API 格式接入
這條路線的優點是專案的 .claude/commands/ 與 .claude/skills/ 完全不必修改,/setup、/scrape、/apply 等指令照常可用。
接地端 AI 路線二,改用其他代理工具
專案的 AGENTS.md 採用「thin-pointer」單一事實來源設計,目的是避免在 Claude Code、Google Antigravity、Codex、Cursor、Gemini CLI 等不同代理框架之間重複設定與產生漂移,所有代理執行環境都應從同一組檔案載入規格與候選人檔案。求職平台搜尋 CLI 位於 .agents/skills/ 之下,採用可攜的 Agent Skills 格式,Codex 與 Antigravity 會自動發現。README 則說明完整工作流程的移植由社群分支處理,可在 Discussions #78 找到。換言之搜尋平台的部分可直接沿用,但 /apply 這類依賴 Claude Code 指令格式與子代理機制的流程需要改寫。
改接地端前必須評估的限制
上下文長度
Claude Code 需要較大的上下文視窗才能正常運作。/apply 會同時載入候選人檔案全部七個方法論檔案、職缺全文、LaTeX 模板與審閱回饋,Ollama 預設的上下文長度通常不足,需要以 Modelfile 另建拉長上下文的模型版本。
輸出品質
專案的核心價值在於「不捏造經歷」與「關鍵字落差誠實呈現」等規則,以及草擬者與審閱者分離的多輪批評修訂。這些都高度依賴模型的指令遵循能力,本機模型在複雜任務上的表現普遍不如 Claude Sonnet 或 Opus。
小結
以具備 DGX Spark 或 NVIDIA Pro 6000 等較大 VRAM 設備的單位來看,跑 30B 到 70B 等級、具備原生工具呼叫與視覺能力的開源模型,走路線一是最省事的做法,專案本身不必改動。真正需要驗證的是模型在收到大量工具定義後能否穩定輸出 tool_use,以及拉長上下文後的推論速度。如果目標只是求職平台搜尋與職缺評分,不需要產出 PDF,門檻會低很多。
參考資料
MadsLorentzen/ai-job-search GitHub 專案頁面與 README https://github.com/MadsLorentzen/ai-job-search
專案 SECURITY.md https://github.com/MadsLorentzen/ai-job-search/blob/master/SECURITY.md
專案 SETUP.md https://github.com/MadsLorentzen/ai-job-search/blob/master/SETUP.md