Black Forest Labs 日前釋出 FLUX 3 Image Klein,這是 FLUX 3 家族第一個開放權重的模型,主模型 5.6B,文字編碼器是 Qwen3-VL-4B,同一顆模型就能做文生圖、單圖編輯和最多 10 張參考圖的合成,還能用版面框指定物件位置。隔天官方又放出 ComfyUI 專用的打包版本,ComfyUI 0.41 也在同一週加入原生支援。這篇用一台 16 GB 顯示卡的桌機實測它,並拿 DGX Spark 做對照。
CyberQ 測試發現,一張 1024×1024 的圖,RTX 5060 Ti 在模型常駐後只要 16 秒左右,比 DGX Spark 還快一點。但官方附的 prompt 擴寫器(prompt upsampler)一定要開,關掉之後畫面品質掉得很明顯。平常跑圖用 int8 版模型就好,nvfp4 版模型在這兩台上都沒有比較快。
一、三個 repo 該下載哪一個
Hugging Face 上有三個名字很像的 repo,用途不同:
| repo | 內容 | 適合誰 |
|---|---|---|
flux-3-image-klein | 蒸餾版原始權重(diffusers 格式),16 步、不用 CFG | 寫程式自己呼叫的人 |
flux-3-image-klein-base | 未蒸餾的 Base 版,50 步、CFG 3.5 | 要訓練 LoRA 或微調的人 |
flux-3-image-klein-comfy | 上面兩者的 ComfyUI 單檔版,另含文字編碼器、prompt upsampler、VAE 和官方 workflow | 用 ComfyUI 出圖的人 |
用 ComfyUI 的話直接選 -comfy,裡面的「蒸餾版 Klein」就是官方 API 背後那一顆。三個 repo 都要先登入 Hugging Face、按同意授權條款才能下載,按下去會立刻開通。
二、要下載的檔案
-comfy 裡每個元件都有好幾種精度。這次在 16 GB 顯示卡上用的組合如下,合計約 26 GB:
| 元件 | 檔案 | 大小 |
|---|---|---|
| 主模型 | flux3-image-klein-int8-convrot.safetensors | 5.8 GB |
| 主模型(對照用) | flux3-image-klein-nvfp4.safetensors,限 Blackwell | 5.3 GB |
| 文字編碼器 | qwen3vl_4b_int8_convrot.safetensors | 4.9 GB |
| prompt upsampler | qwen3.5_9b_flux3_prompt_upsampler_int8_convrot.safetensors | 9.8 GB |
| VAE | vae/flux2-vae.safetensors | 0.3 GB |
有兩點要注意:
- VAE 的檔名是
flux2-vae.safetensors,但它和 FLUX.2 那顆同名檔案的內容並不相同(兩者差 2,264 位元組)。如果你的模型資料夾裡已經有 FLUX.2 的 VAE,ComfyUI 的選單只會顯示一個名字,你沒辦法確定載入的是哪一顆。我把新的這顆改名成flux3-vae.safetensors,在 workflow 裡另外指定。 - 官方 workflow 預設的 upsampler 是 w4a8 版(6.7 GB),但 README 的下載指令寫的是 int8 版。 兩者擇一即可,只是載入官方 workflow 後要記得確認選單裡選的是你手上那一顆。
三、ComfyUI 版本與工作流
ComfyUI 在 0.41.0 加入 FLUX 3 Image 的原生支援,不需要裝任何自訂節點。我把桌機和 DGX Spark 都更新到 0.42.1,這一版修正了 TextGenerate 節點用完沒有釋放記憶體的問題,也加快了 Qwen 3.x 系列的推論。prompt upsampler 跑在 TextGenerate 上,16 GB 的卡要在 upsampler 和主模型之間來回換進換出,這個修正剛好用得到。
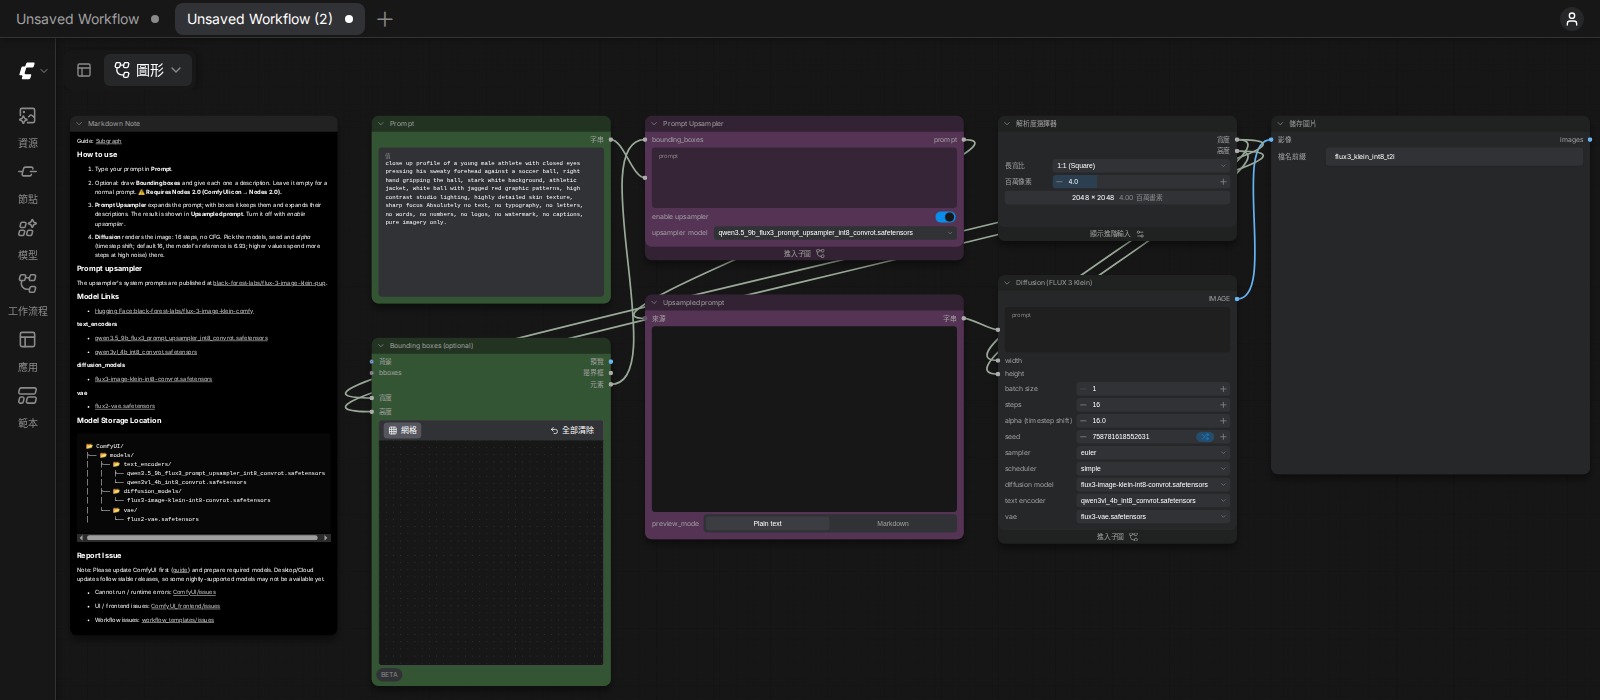
官方 workflow 把流程包成兩個子圖。第一個是 Prompt Upsampler:用一顆 Qwen3.5 9B 微調出來的模型,把你輸入的一句話擴寫成一整段完整的場景描述,包括構圖、人物、光線和背景。第二個是 Diffusion,裡面是很標準的鏈:載入主模型、文字編碼、空白 latent、時間步偏移、KSampler(16 步、cfg 1、euler/simple),最後是 VAE 解碼。
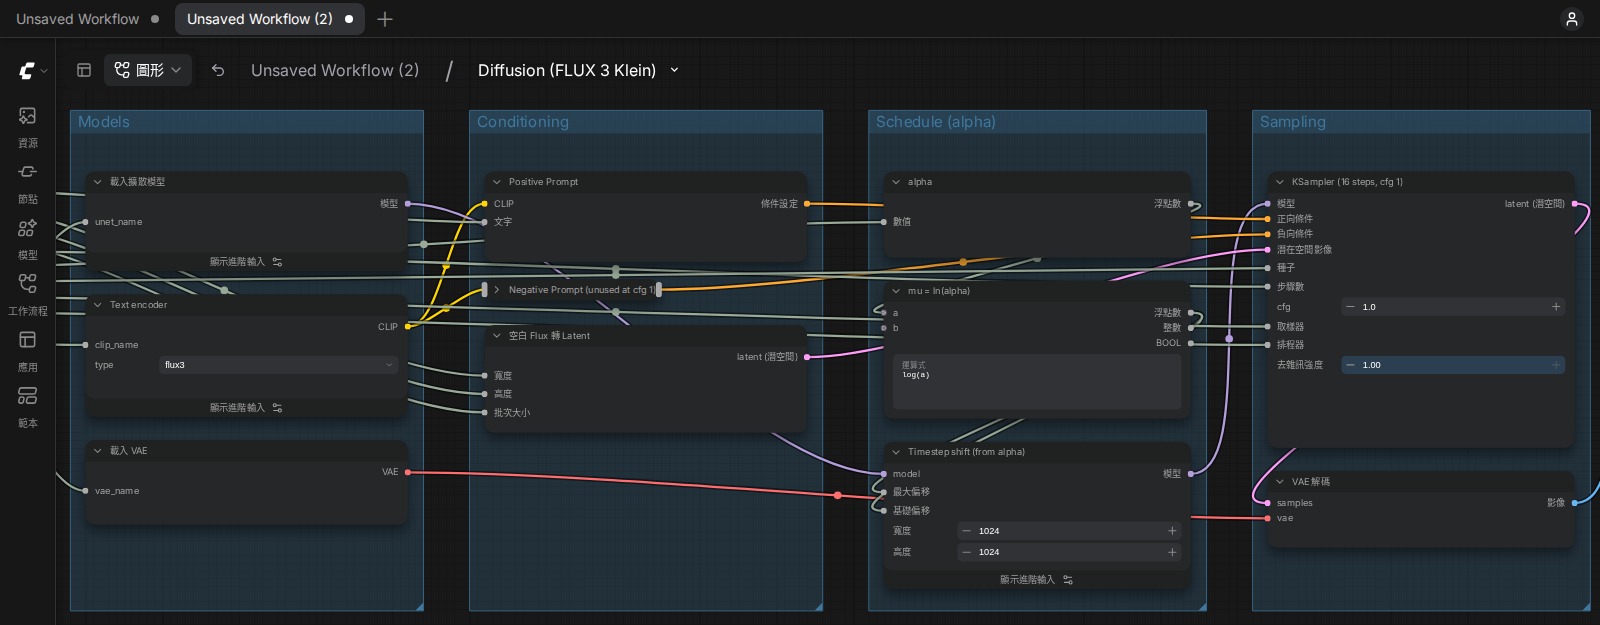
還有一個容易忽略的預設值:官方 workflow 預設輸出 4 MP(2048×2048)。本文的速度數字除非另外註明,都是改成 1 MP(1024×1024)去跑的。
四、速度:RTX 5060 Ti 對 DGX Spark
測試機器:
- 桌機:Intel Core i5-12400F、128 GB 記憶體、RTX 5060 Ti 16 GB,Windows 版 ComfyUI 免安裝版
- 對照:DGX Spark 單機(GB10,128 GB 統一記憶體)
- 兩台都是 ComfyUI 0.42.1,模型都從同一台 NAS 讀取
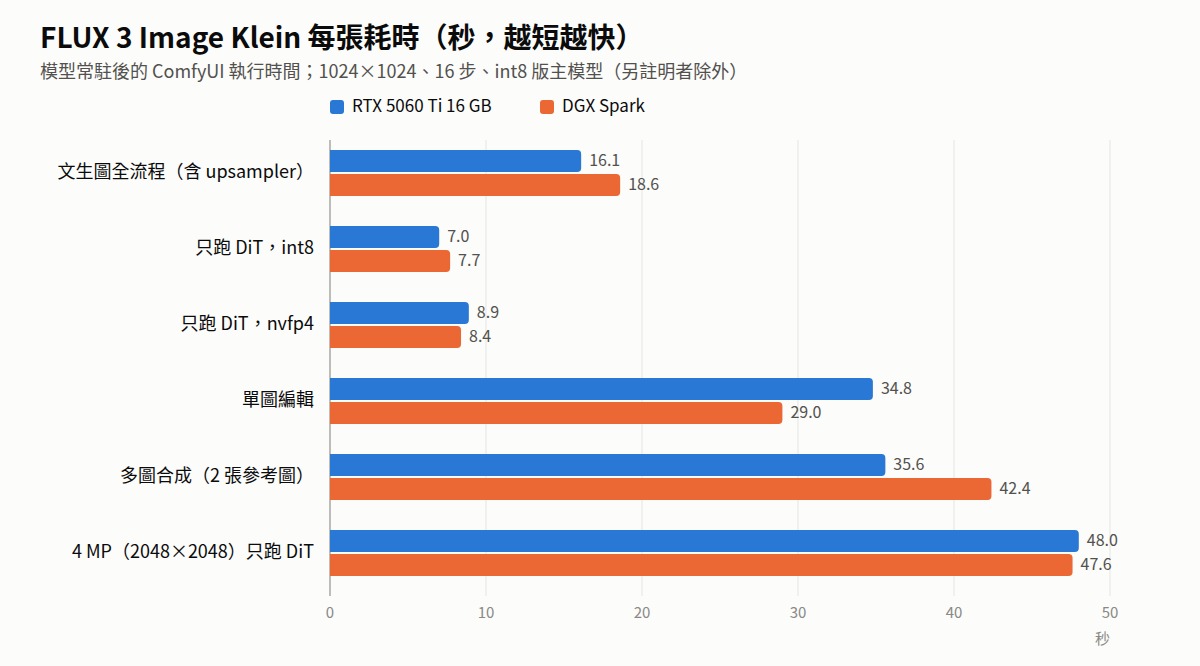
| 項目(1024×1024,16 步) | RTX 5060 Ti | DGX Spark |
|---|---|---|
| 文生圖全流程(含 upsampler),常駐後 4 張平均 | 16.1 秒 | 18.6 秒 |
| 只跑主模型(直接給完整描述),int8 | 7.0 秒 | 7.7 秒 |
| 只跑主模型,nvfp4 | 8.9 秒 | 8.4 秒 |
| 單圖編輯(第 2 次) | 34.8 秒 | 29.0 秒 |
| 多圖合成,2 張參考圖(第 2 次) | 35.6 秒 | 42.4 秒 |
| 4 MP(2048×2048),只跑主模型 | 48.0 秒 | 47.6 秒 |
| 第一次冷載入(全流程) | 79.4 秒 | 70.3 秒 |
幾個觀察:
- 一張 16 GB 的消費級顯示卡就夠用。 5060 Ti 全流程時顯示記憶體峰值 15.5 到 15.8 GB,剛好塞得下,只跑主模型時是 11.0 到 13.4 GB。
- 全流程大約一半的時間花在 upsampler。 全流程 16.1 秒、只跑主模型 7.0 秒,相差的 9 秒左右就是擴寫 prompt,加上 upsampler 和主模型在顯示卡上換進換出的成本。
- 編輯比文生圖慢一倍以上,因為 upsampler 要先看參考圖再寫描述,主模型也要多編碼參考圖。5060 Ti 第一次做單圖編輯花了 67.8 秒,第二次才降到 34.8 秒。
- 冷載入那一列包含從 NAS 讀進 26 GB 模型檔的時間,只適合當作參考。
五、選 int8 還是 nvfp4 ?
nvfp4 是 Blackwell 架構專屬的 4 位元格式,照理應該比較快。實測結果相反,5060 Ti 上 nvfp4 比 int8 慢約 26%(8.9 對 7.0 秒),DGX Spark 上也慢約 9%(8.4 對 7.7 秒)。 兩者的檔案大小只差 0.5 GB,畫面幾乎看不出差別。
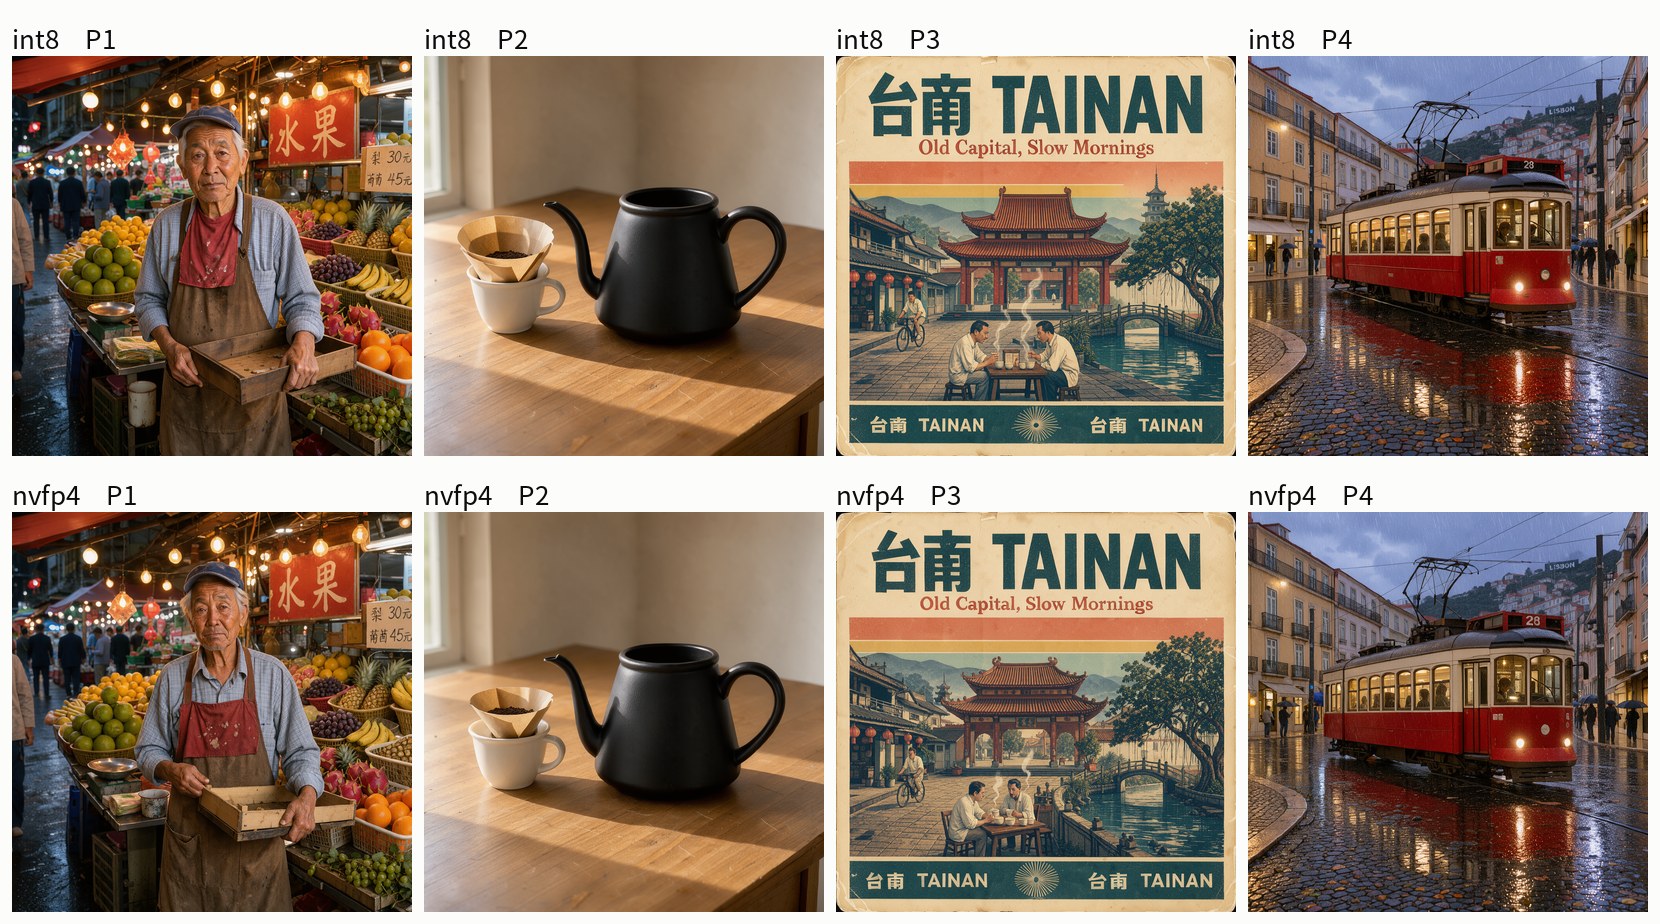
所以目前的建議是直接用 int8。它的另一個好處是不挑卡,官方說明 int8 版在 8 GB 的 RTX 3070 和不支援 FP8 的 30 系列上也能跑。
六、prompt upsampler 的作用
官方模型卡寫得很直接,不要在沒有 prompt upsampler 的情況下使用這個模型。FLUX 3 Klein 是用完整的場景描述訓練的,短短一句話直接送進去,只會得到很普通的畫面。
CyberQ 用同一句短 prompt、同一個種子,各跑一次開與關:
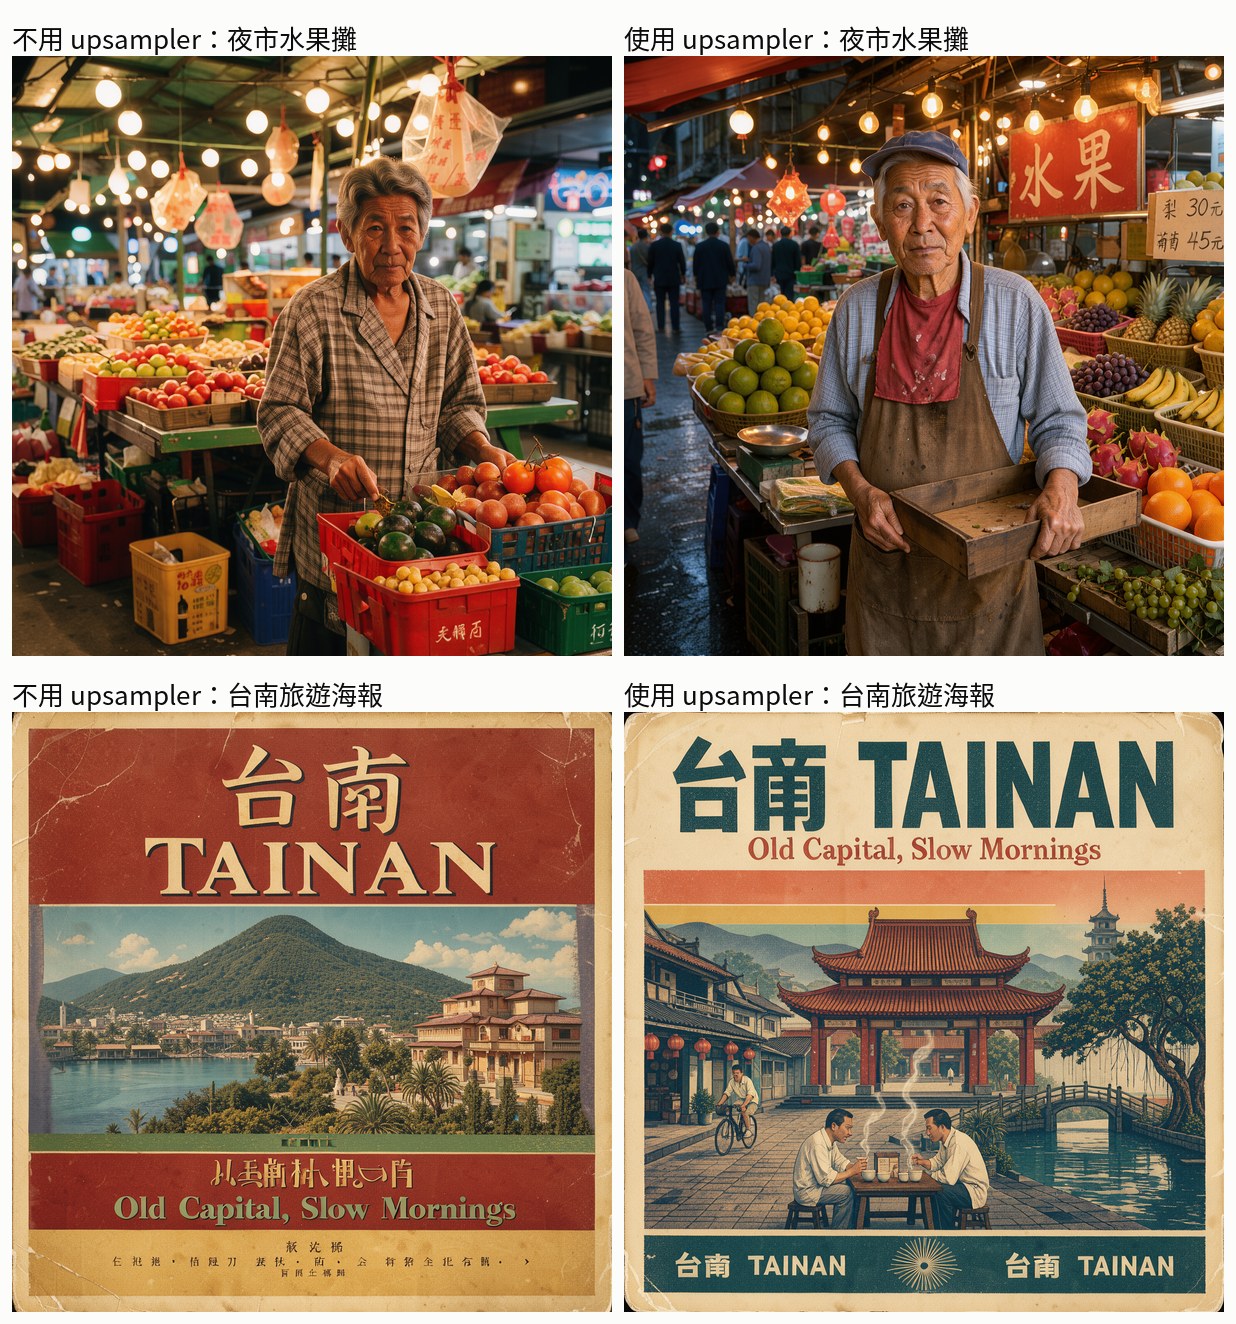
差異最明顯的是台南海報,沒有 upsampler 時,台南被畫成了歐洲的湖畔小鎮,英文副標上方還多出一行看不懂的假中文字,開了 upsampler 之後,畫面變成台式廟宇與運河,標題「台南 TAINAN」和英文副標都正確。 upsampler 會先替模型把「台南長什麼樣子」寫清楚,模型只要照著畫。雖然這都不是真正的台南,但這個測試只是說明 upsampler 的實際使用差異。
如果你習慣自己寫很長的 prompt,也可以把 upsampler 關掉,或改用自己的 LLM。官方在 flux-3-image-klein-pup repo 裡公開了它的系統提示,可以拿去給其他模型用。
七、文字、版面框與編輯
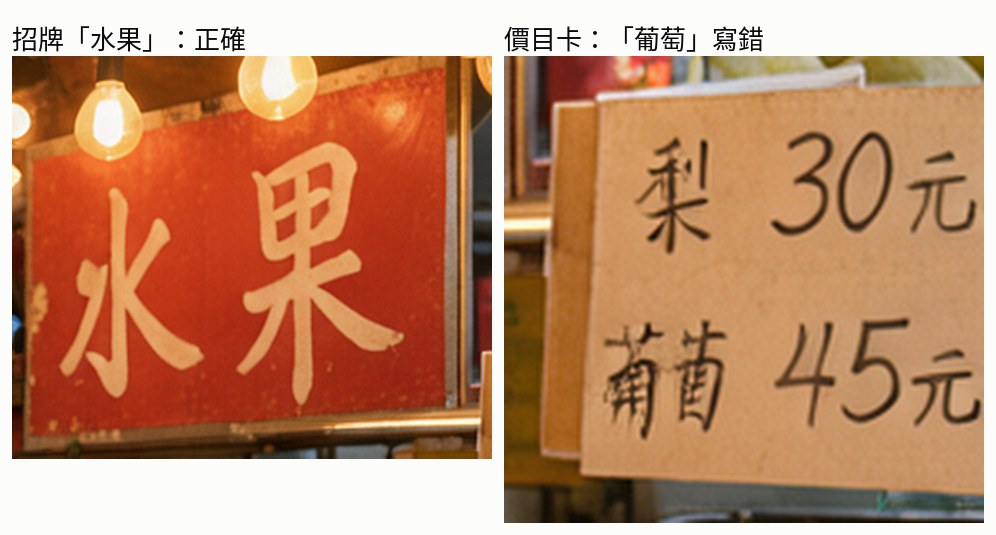
文字渲染:大字很穩,招牌「水果」、海報上的「台南 TAINAN」和「Old Capital, Slow Mornings」都寫對了。小字就不一定,同一張圖裡的價目卡,「葡萄」寫錯了。
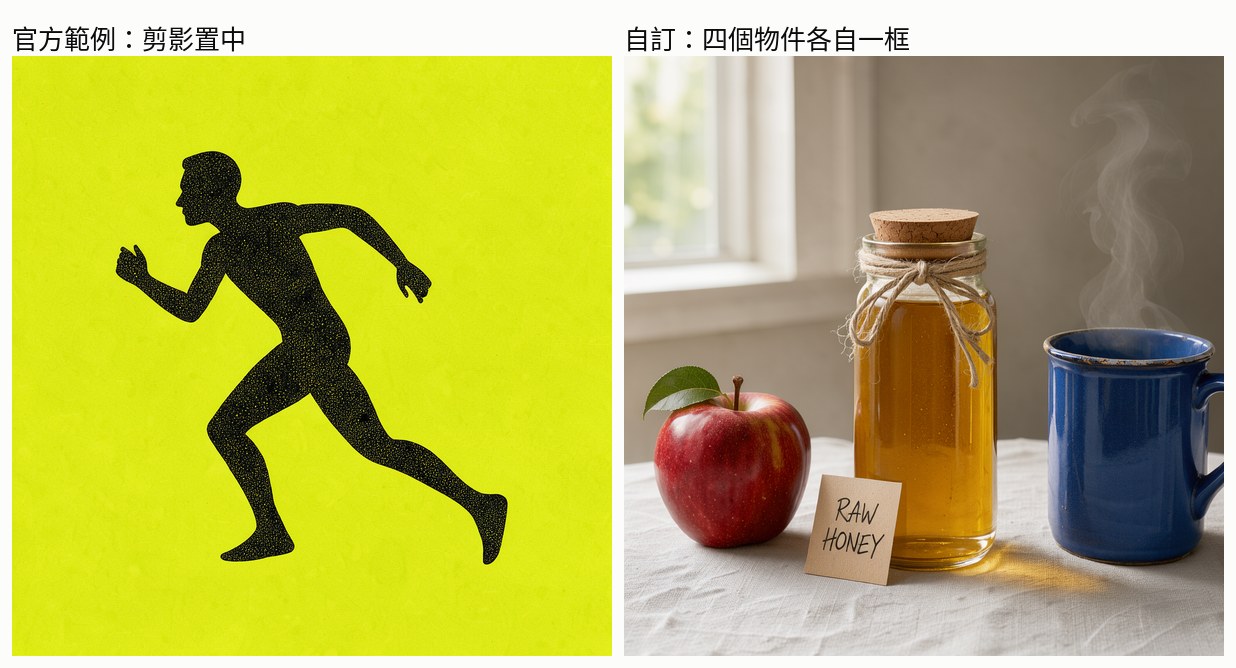
版面框(bounding box):在描述後面接一段 JSON,用 0 到 1000 的座標指定每個物件的位置。官方範例的剪影和本次測試中自訂的四物件桌面(蘋果、蜂蜜罐、馬克杯、手寫標籤)都照框擺放,標籤上的「RAW HONEY」也寫對了。
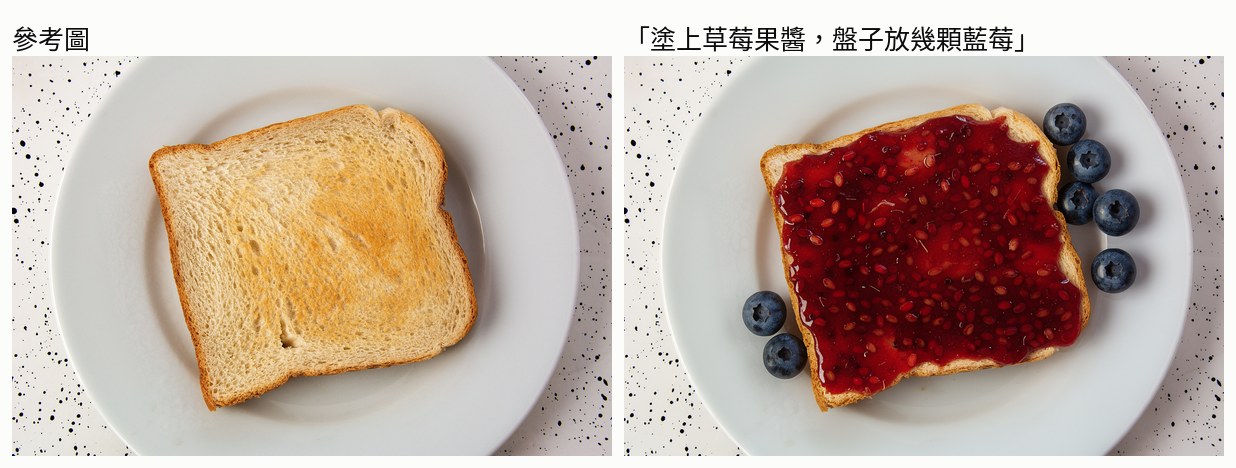
單圖編輯:給一張吐司的照片,指令是「塗上草莓果醬,盤子放幾顆藍莓」。盤子、桌面斑點和吐司的位置都保留下來,只改了指令要求的部分。
多圖合成:第一張是戴帽子的女子,第二張是秋天的森林,指令是「第一張圖的女子站在第二張圖的秋林前方觀景台上」。人物的帽子、衣服和森林的色調都對應到參考圖。
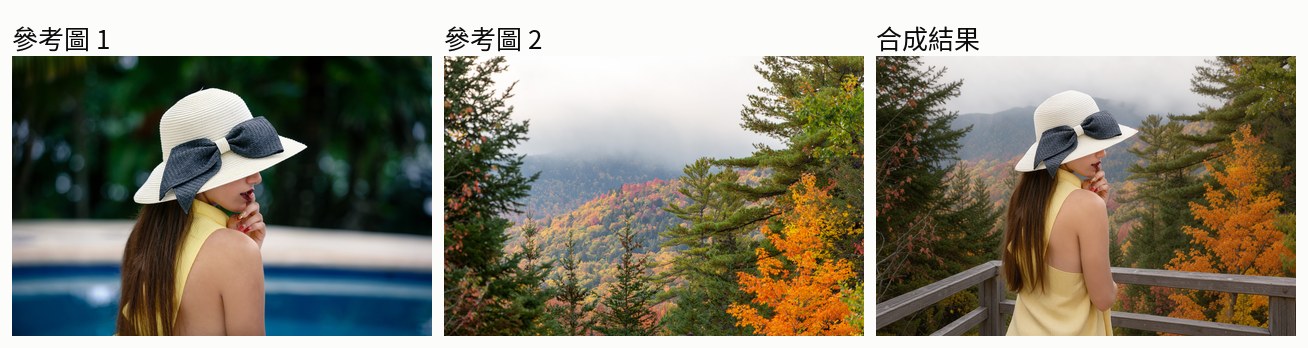
本節用到的參考圖都來自官方 -comfy repo 的 workflows 資料夾(MIT 授權)。
八、拿來當部落格的自動封面
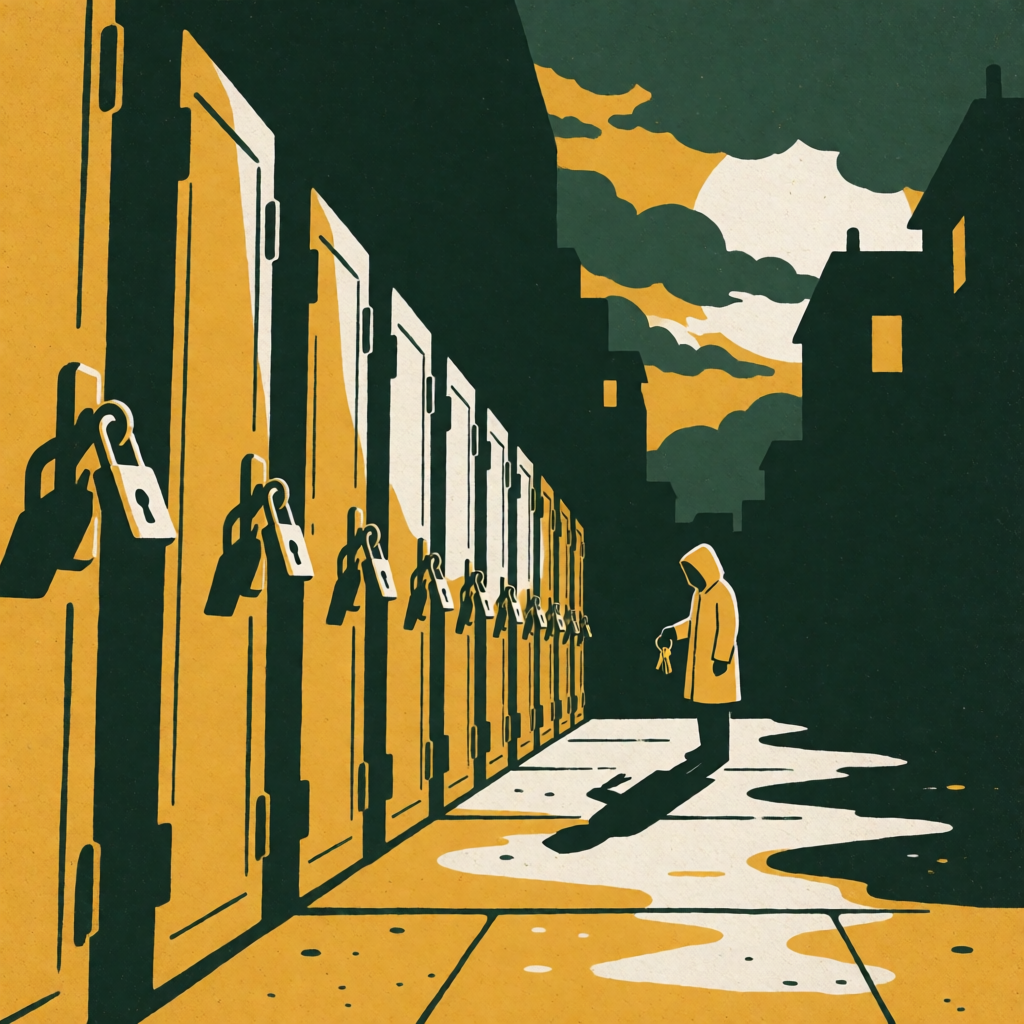
本站的文章封面是自動產生的:先由 LLM 依文章內容寫一段場景,再從十種畫風裡輪流挑一種,最後交給地端的 ComfyUI 出圖。出圖後還會用 Qwen3-VL 檢查畫面裡有沒有任何文字,有字就換種子重畫。這套流程原本用的是 Krea 2 Turbo。
將近期實際用過的 prompt,原封不動交給 FLUX 3 Klein 重畫一次:
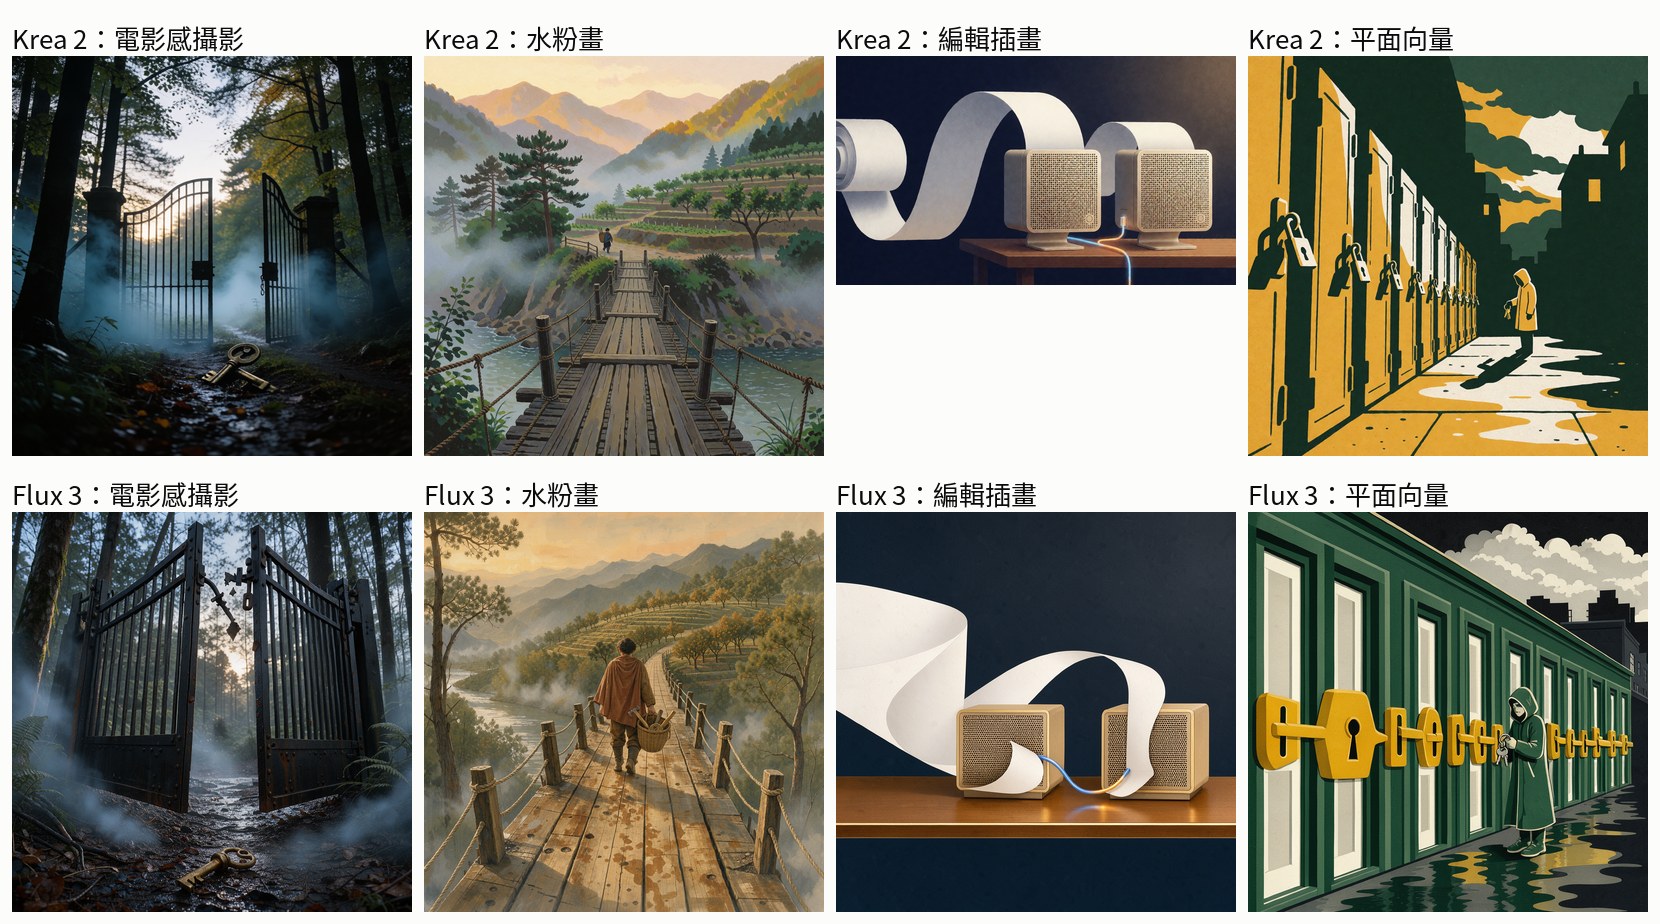
- 無文字檢查全部通過(8 張,包括開與關 upsampler 兩種)。
- 語意貼合度 FLUX 3 比較好。 最右邊那篇的 prompt 是「一把大鎖同時鎖住整排門」,Krea 2 畫成每扇門各掛一把鎖,FLUX 3 照字面畫出一把橫跨所有門的大鎖。
- 平面風格 Krea 2 比較純粹。 同樣指定平面向量插畫,FLUX 3 會帶一點立體陰影。
- 每張多花約 10 秒,對一天幾篇文章的排程來說不是問題。
九、授權
FLUX 3 Image Klein 採用 FLUX Kommunity License v1.0:原則上限非商業使用。但是年營收(含關係企業)低於 500 萬美元的使用者,可以把生成的圖片用在商業用途。超過門檻或要拿模型本身做商業用途,要另外向 Black Forest Labs 取得授權。文字編碼器 Qwen3-VL-4B 和 prompt upsampler 則是 Apache 2.0。
授權第 4 節另外列了禁止用途,包括軍事、監控、生物特徵處理、非自願的私密影像,以及用它的輸出去訓練功能相近的競爭模型。要用在正式場合之前,請自己讀過一次完整條款。
FLUX 家族的出圖門檻降到一張 8GB/16 GB 的消費級顯示卡
FLUX 3 Image Klein 把 FLUX 家族的門檻拉到一張 16 GB 的消費級顯示卡就能順跑,文生圖一張 16 秒左右,編輯與多圖合成三十多秒,大字中文也寫得出來。真正的重點在那顆 prompt upsampler,它讓「一句話出好圖」變成可能,代價是每張多出一半的時間,以及要多下載將近 10 GB 的模型。
如果你要開始用,CyberQ 的建議組合是:-comfy repo 的蒸餾版 int8 主模型、int8 文字編碼器、int8 upsampler,ComfyUI 更新到 0.42.1 以上,VAE 改名避免和 FLUX.2 的撞名。