MiniMax H3 的 ref2va(reference to video and audio)模式可以吃參考圖、參考影片和參考音訊,再生成一段帶聲音的新影片。社群作者 UntMods 在 Civitai 與 Hugging Face 釋出了一款專門換臉的 LoRA,「FaceSwap – MiniMax REF2VA」,宣稱掛上之後,只要給一段參考影片和一張臉,就能把影片裡人物的臉換成那張臉。
CyberQ 實測在單台 DGX Spark 上用 ComfyUI 跑,證實確實換得掉,而且動作、表情、手勢都跟原片逐格對應,聲音節奏也保留下來。連衣服也能一起換成參考圖裡的樣子。
一、這款 LoRA 的特點
| 項目 | 內容 |
|---|---|
| 名稱 | FaceSwap – MiniMax REF2VA(v1.0) |
| 作者 | UntMods |
| 檔案 | SS_FaceSwap_MiniMax_H3_REF2VA.safetensors,約 63 MB,bf16 |
| 授權 | Apache-2.0 |
| 觸發詞 | Faceswap,強度 1 |
| 適用模型 | MiniMax H3 的 ref2va 權重(不是 t2va/i2v 用的 fl2va 權重) |
作者的說明很簡潔,這是把參考影片裡人物的身分換成參考圖的身分,提示詞只要觸發詞,LoRA 已經剪掉低於門檻的區塊,所以檔案小、雜訊少,強度和訓練時相同。
取得方式有一點要注意,Civitai 的下載設定成要登入才能下載,用 API 直接抓會回「Unauthorized」,作者在 Hugging Face 的 UntMods/FaceSwap_MiniMaxH3_REF2VA 放了同一份檔案,不用登入。
二、要多下載一顆 ref2va 主模型
H3 在 ComfyUI 裡有兩套主模型權重:t2va 與 i2v 用的 fl2va,以及參考生成用的 ref2va。這兩套權重不同,換臉一定要用 ref2va。如果你之前只裝過 H3 的文生影片,這裡要再下載一款約 21 GB 大小的主模型。
| 元件 | 檔案 | 來源 |
|---|---|---|
| 主模型 | minimax_h3_ref2va_pruned_int8_convrot.safetensors(約 21 GB) | Comfy-Org/MiniMax-H3 |
| 文字編碼器 | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | Comfy-Org/MiniMax-H3 |
| 影像 VAE | minimax_h3_video_vae_fp16.safetensors | Comfy-Org/MiniMax-H3 |
| 音訊 VAE | minimax_h3_audio_vae_fp32.safetensors | Comfy-Org/MiniMax-H3 |
| 加速 LoRA | minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors | lightx2v/Minimax-h3-Turbo |
| 換臉 LoRA | SS_FaceSwap_MiniMax_H3_REF2VA.safetensors | UntMods/FaceSwap_MiniMaxH3_REF2VA |
加速 LoRA 是作者工作流裡用的那一個,讓取樣只要 8 步。兩顆 LoRA 疊在 int8 的主模型上,ComfyUI 日誌顯示 208 個模組全部掛上,沒有任何「lora key not loaded」的警告。
下載大檔時,這次測試用 curl --http1.1 搭配續傳迴圈,完成後逐一比對 Hugging Face 上的 sha256,全部相符才進行後續測試。
三、工作流不必裝作者的自訂節點
該 LoRA 作者附了兩份工作流。一份用他自己的 CRT-Nodes(作者說 ComfyUI 管理員上的版本停在 2.17.0,要從 GitHub 拿 2.19.0),另一份原生版只多用一個 AI-Toolkit 的參考影片前處理節點。將它的原生版拆開來看,實際接法是:
UNETLoader載入 ref2va 主模型,依序串上加速 LoRA 與換臉 LoRA。MiniMaxH3ReferenceToVideo接收臉部照片(ref_image_0)、參考影片的畫格(ref_video_0)與參考影片的音軌(ref_video_audio_0),提示詞只填Faceswap。KSampler:8 步、cfg 1、取樣器res_multistep、排程simple;負向條件用ConditioningZeroOut。LTXVSeparateAVLatent把結果拆成影像與音訊,各自解碼後用CreateVideo合成 MP4。
那個 AI-Toolkit 節點做的事情其實很單純,檢視它的原始碼會知道如下:
- 依原片的實際影格率重新取樣成 24 fps。
- 畫格數往下對齊到 H3 要求的 17n+5(例如 124 格)。
- 依目標像素面積縮放,長寬對齊 32 的倍數。
- 音軌裁成和畫格同樣的長度。
這些工作其實用 ffmpeg 事先處理好就行,所以本次測試全程只要用 ComfyUI v0.34.3 內建的節點(LoadVideo 加 GetVideoComponents 取出畫格與音軌)來跑就能順利出影片和圖片,沒有額外裝任何自訂節點。
四、測試素材:全部是合成的
換臉技術最直接的風險就是被拿來偽造真人。作者附的範例素材看起來是真人的照片和影片,本次測試因為是公開發表內容,因此沒有真人照片和影片。這次所有素材都是虛擬合成生成的:
- 兩張臉:用 Krea 2 生成的虛構人物大頭照,一位灰髮蓄鬍的中年男性,一位紅色捲髮、戴眼鏡的年輕女性。兩人外觀差異很大,換成功與否一眼就看得出來。
- 參考影片:用 H3 自己的文生影片模式生成一段約 5 秒的片子:一位黑髮、沒有鬍子、穿白 T 恤的年輕男性坐在咖啡店窗邊,對著鏡頭說話並揮手。
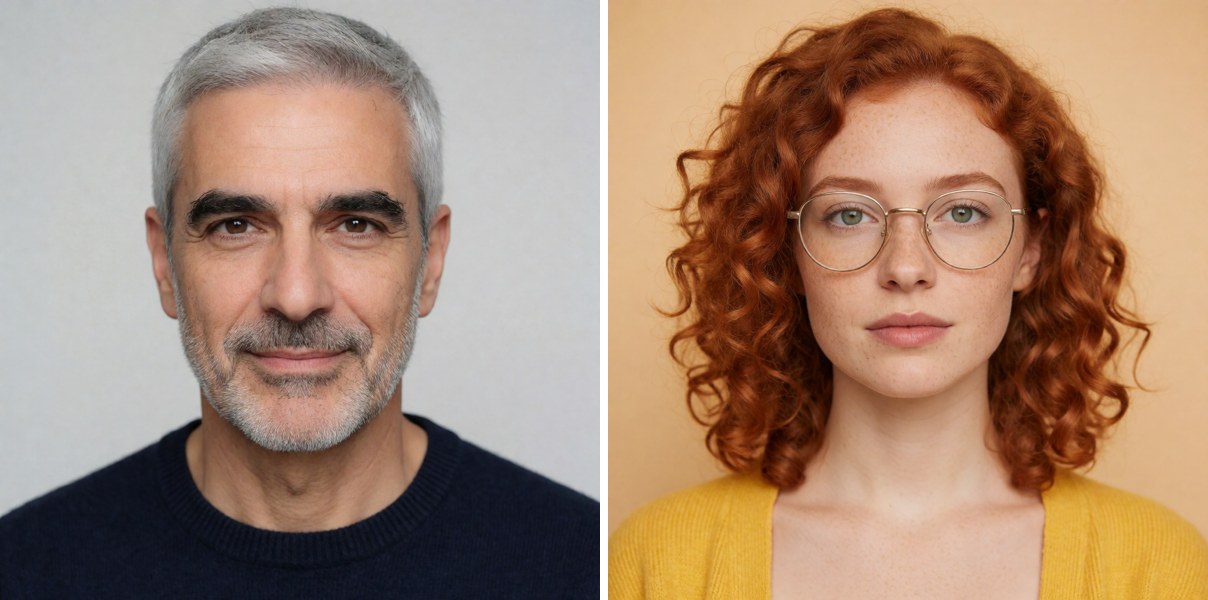
為了控制溫度(原因見第六節),換臉在 672×384、124 格(約 5.2 秒)、24 fps 下進行,種子固定為 42。
五、測試成功
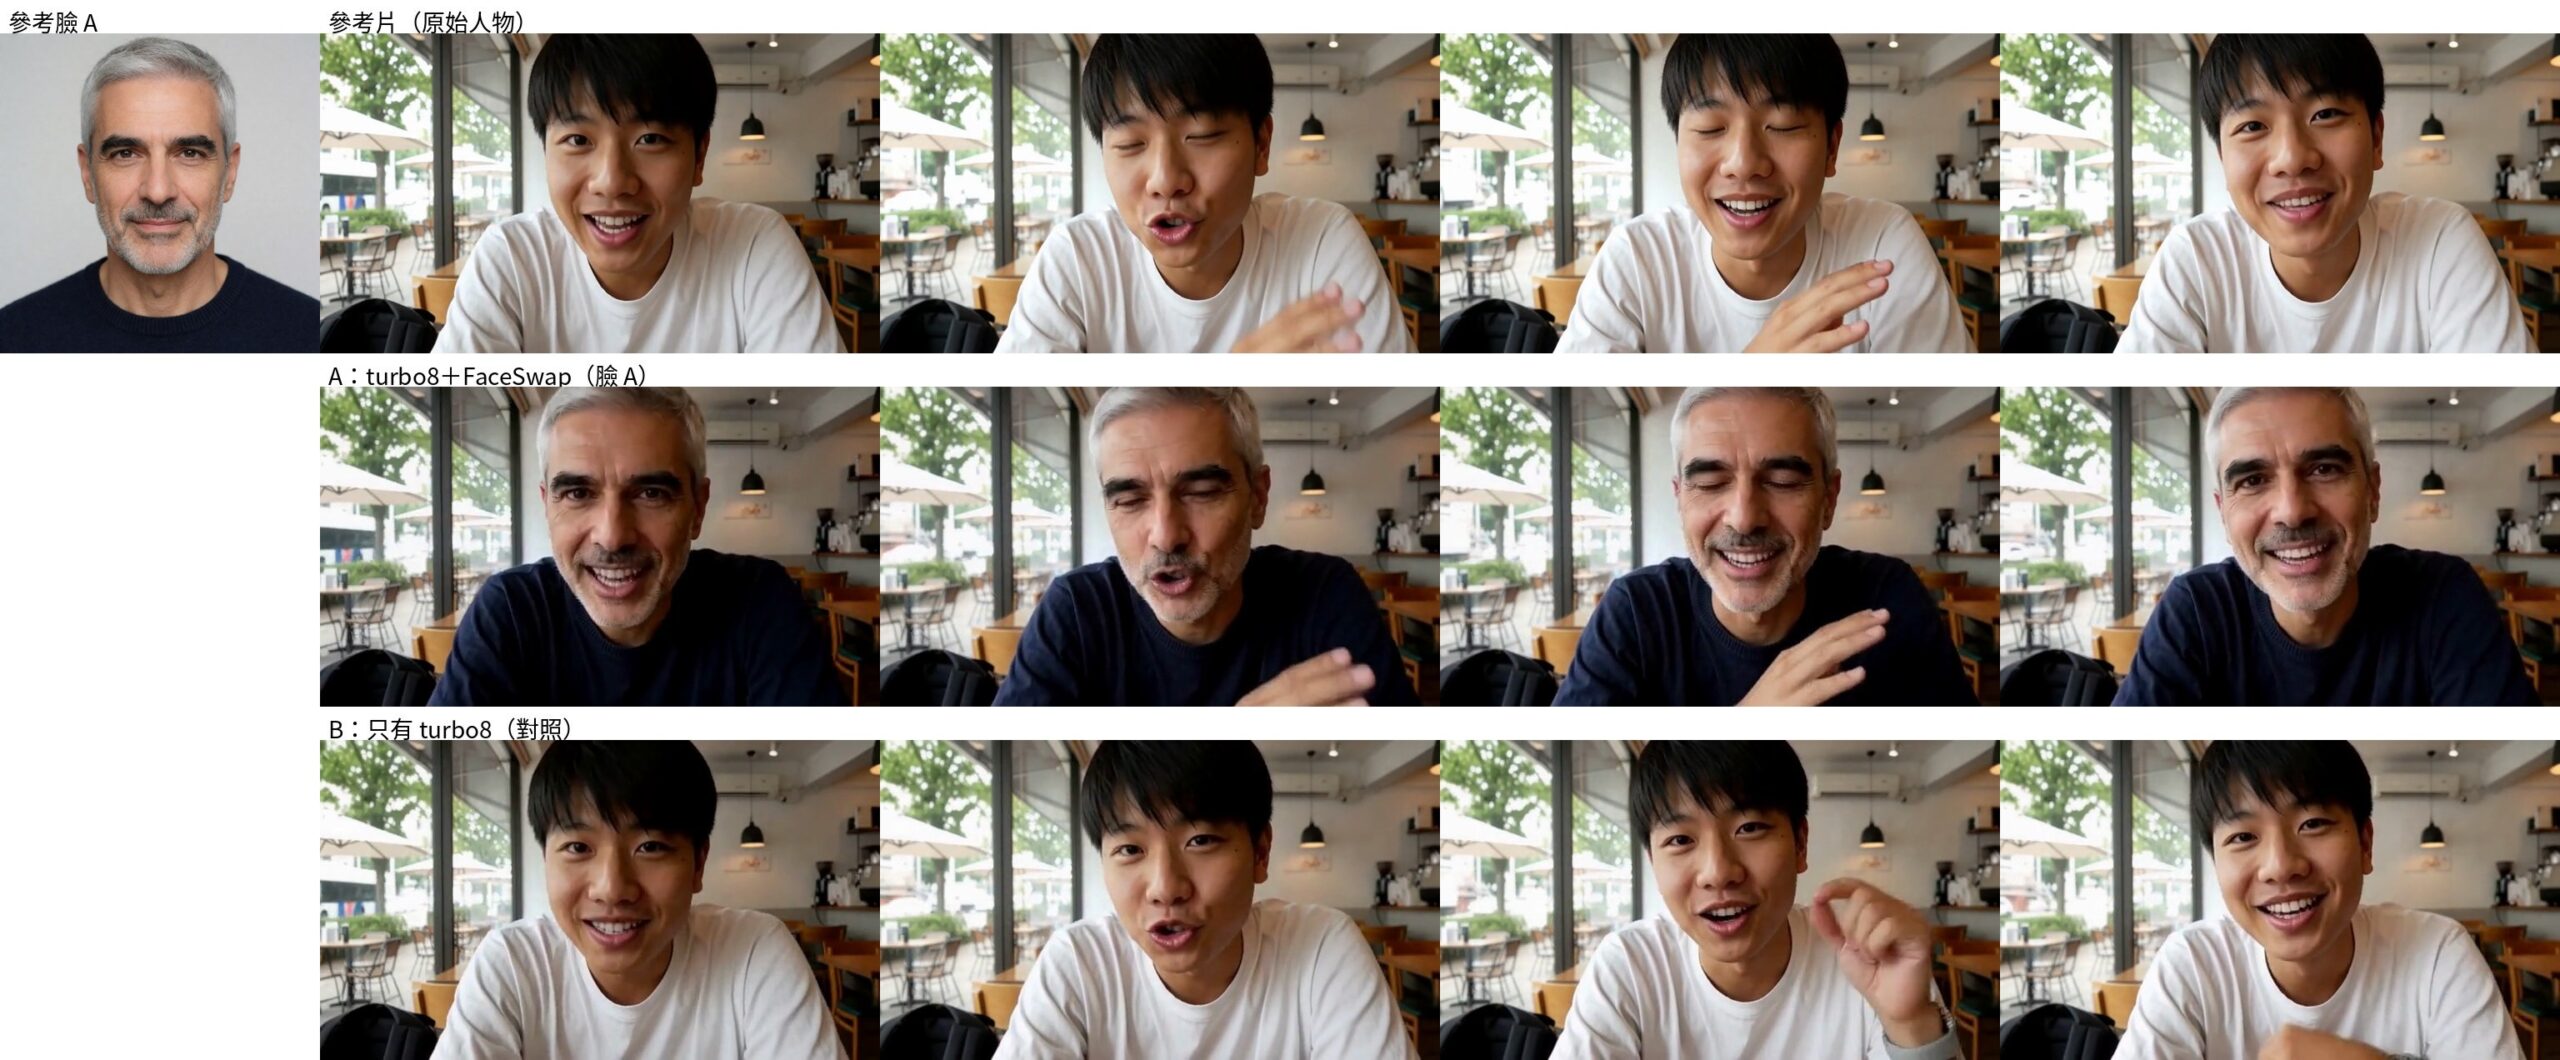
先看結果。左邊是參考影片,右邊是掛上換臉 LoRA 後的輸出,聲音來自右邊的輸出:
為了確認效果真的來自換臉 LoRA,我用完全相同的設定、相同種子,只拿掉換臉 LoRA 再跑一次當對照:
幾個觀察:
- 身分確實換過去了。 灰髮、粗眉、灰鬍和臉型都轉到影片裡,每一格都是同一個人,沒有看到閃爍,臉部邊緣也沒有明顯接縫。
- 動作逐格對應。 張嘴、閉眼笑、揮手的時間點和手的位置,都和參考影片一致。
- 不掛 LoRA 就不會換。 對照組的人物維持原本的年輕男性,而且手勢和參考影片不同。也就是說,單用 ref2va 只會把參考影片當成「風格與內容的參考」重新生成一段,是換臉 LoRA 讓它照著原片的動作走。
- 衣服也被換掉了。 參考影片裡穿白 T 恤,輸出變成第一張臉照片裡的深藍色毛衣。這顆 LoRA 換的是「整個人的外觀」,不只是臉。如果想保留原本的服裝,直覺的做法是把臉部照片裁到只剩臉。
- 聲音節奏保留下來。 將三段影片的音量起伏做比對,換臉輸出和參考影片的相關係數是 0.98,不掛 LoRA 的對照組只有 0.42。換臉輸出的說話節奏與參考影片幾乎相同,口型也對得上。
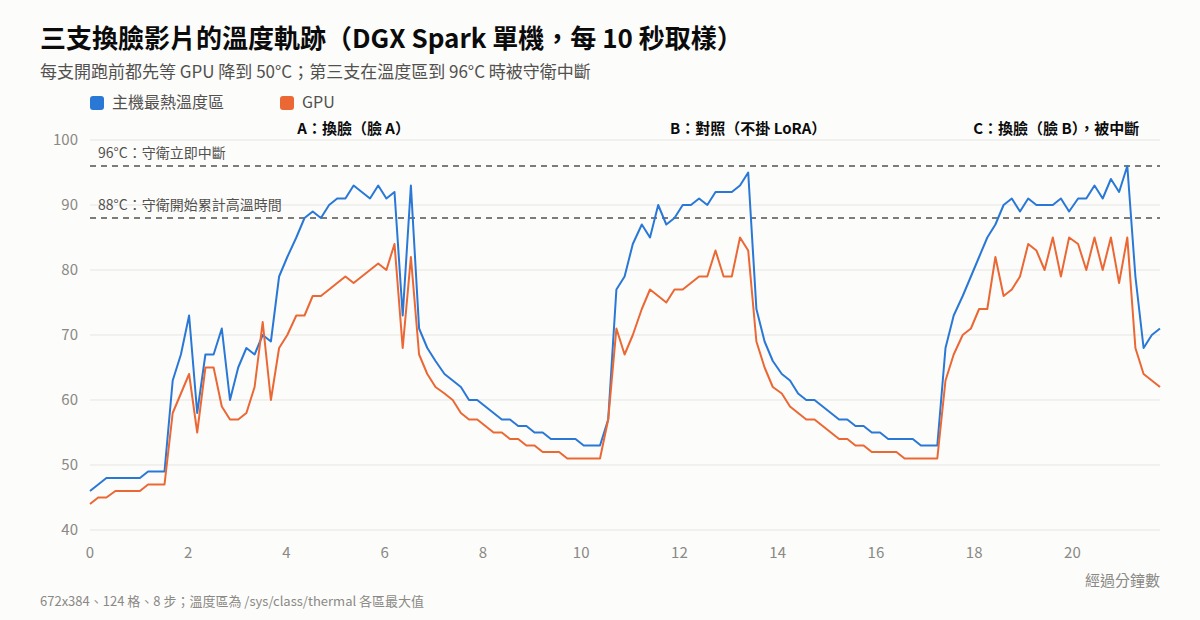
六、速度與溫度:斷電一次,守衛擋下一次
在 DGX Spark 單機上,672×384、124 格、8 步:
| 組別 | 內容 | 取樣時間 | 整體時間 | GPU 最高 | 溫度區最高 |
|---|---|---|---|---|---|
| A | 換臉(第一張臉) | 2 分 45 秒(每步約 20.6 秒) | 347 秒(含首次載入模型) | 84°C | 93°C |
| B | 對照(不掛換臉 LoRA) | 2 分 43 秒 | 178.5 秒 | 85°C | 95°C |
| C | 換臉(第二張臉) | 被守衛中斷 | 85°C | 96°C |
換臉 LoRA 本身幾乎不增加時間,兩組每步都在 20 秒上下。真正的問題是溫度,跑影像模型會比較熱,這點需要較好的空調和散熱。
七、使用上的提醒
這款 LoRA 好用的程度,就是它危險的程度,只要一張照片和一段影片,就能在一般桌上型設備上產生動作自然、聲音同步的換臉影片。
未經同意使用他人的肖像製作或散布這類影片,可能涉及肖像權、個人資料保護,以及針對不實影像的法律規範。自己測試時,建議和這篇一樣使用生成的虛構人物,或取得當事人明確同意的素材。
效果明確的換臉 LoRA
CyberQ 認為,UntMods 的換臉 LoRA 在 MiniMax H3 ref2va 上效果明確,身分換得乾淨、動作和聲音節奏跟著原片走,用 ComfyUI 內建節點就能重現作者的工作流,不必安裝自訂節點。
要注意的是它連服裝一起換,以及相對較高的熱負載。單支短片可以跑,但一定要掛溫度守衛、每支之間冷卻。
延伸閱讀: